 AIREITER
Prima di avere un nome ufficiale, questo modello circolava in forma anonima come Ox Alpha. Ora Z.ai ha svelato la sua identità: GLM-5.3-Flash. Il nome è importante, ma “Flash” non va interpretato come sinonimo di modello leggero: per ogni token vengono attivati 18B di parametri, mentre il checkpoint completo arriva a circa 320B e, in locale, richiede comunque un’infrastruttura di fascia alta.
In breve: Ox Alpha era l’anteprima di GLM-5.3-Flash
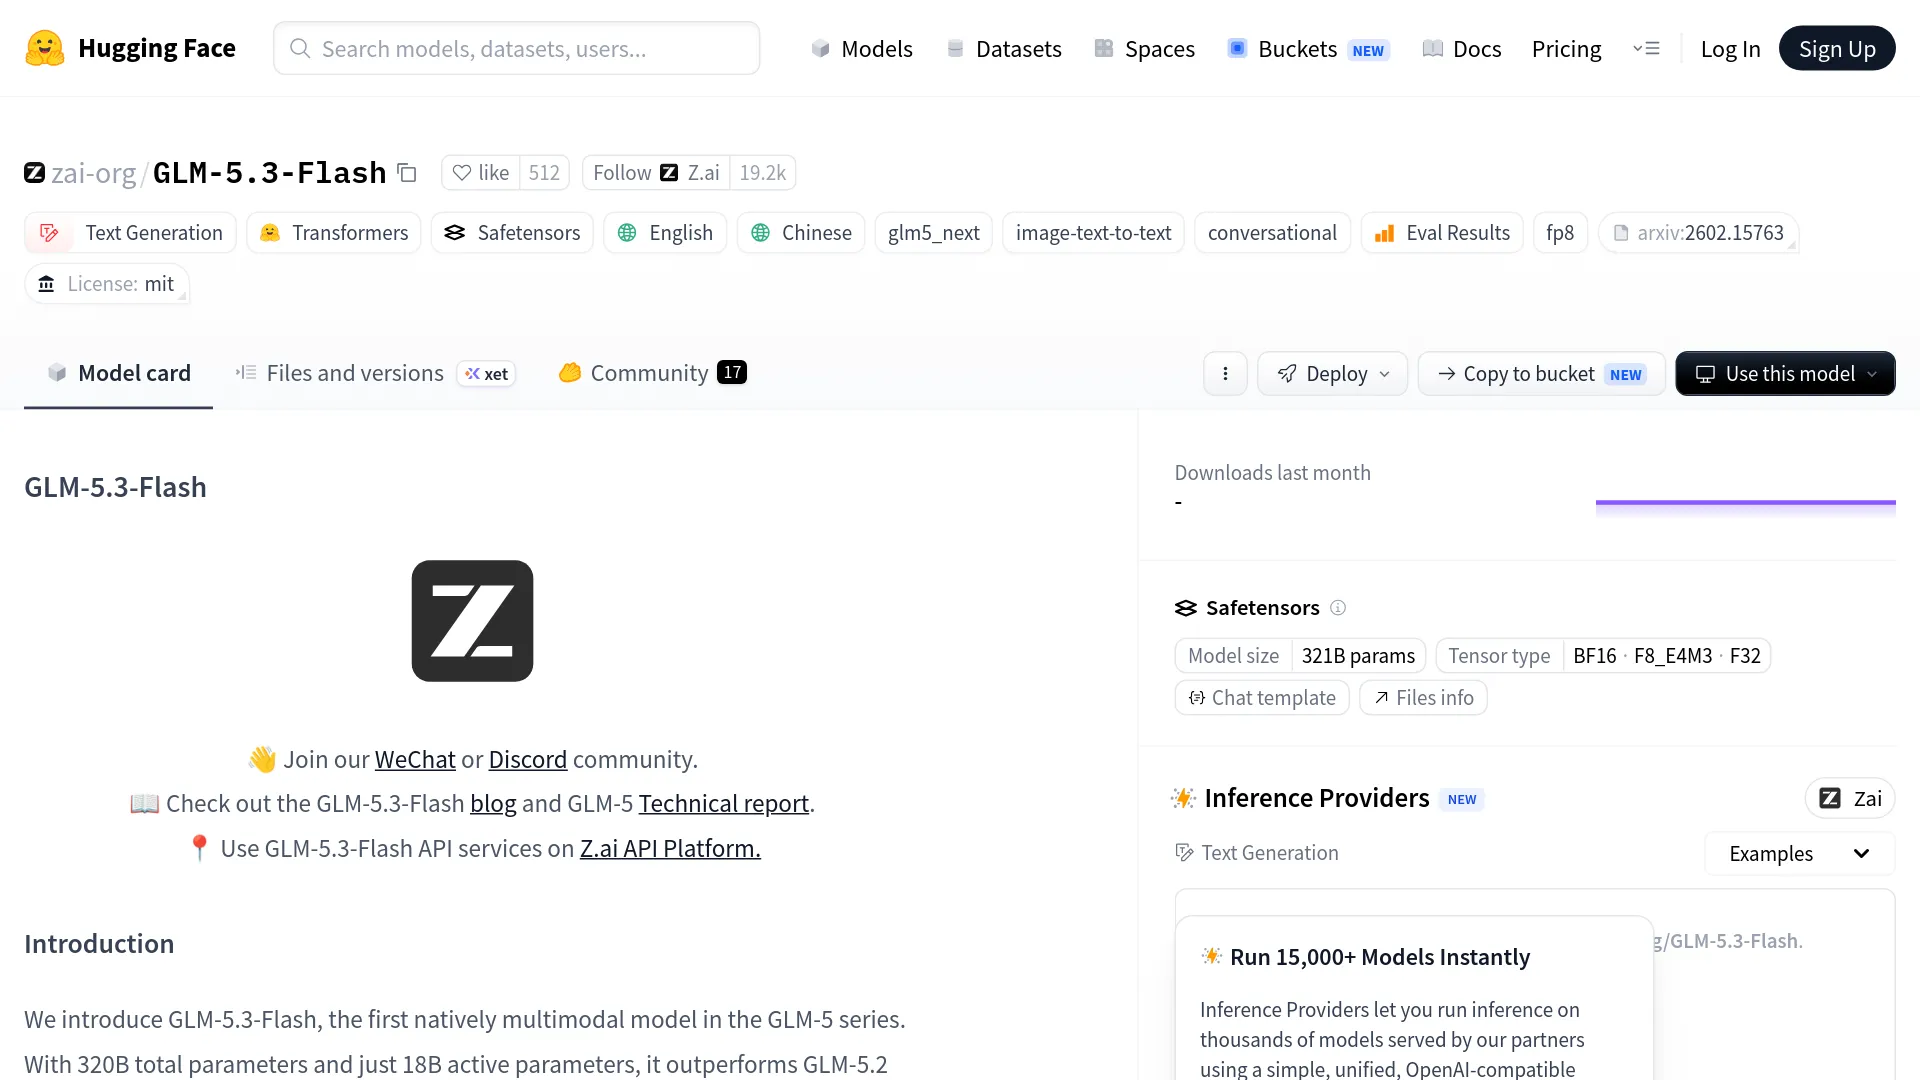
Nell’annuncio del 26 agosto 2026, Z.ai conferma che GLM-5.3-Flash è il modello presentato in precedenza in forma anonima come Ox Alpha su OpenCode e OpenRouter. La scheda ufficiale su Hugging Face riporta ora il checkpoint pubblico, la licenza MIT, gli input multimodali e i riferimenti per l’esecuzione locale.
I resoconti su Ox Alpha vanno quindi letti come segnali raccolti durante l’anteprima, non come specifiche definitive del modello distribuito. Ox Alpha operava con propri sistemi di instradamento, livelli di traffico e condizioni operative: le prime impressioni su velocità, quote e policy potrebbero non valere per ogni endpoint di GLM-5.3-Flash.
«Per me non è cambiato nulla. Entrambi i modelli sono decisamente troppo grandi per il mio sistema con 32 GB di RAM.» — u/dampflokfreund in r/LocalLLaMA
GLM-5.3-Flash in sintesi
| Specifiche | GLM-5.3-Flash |
|---|---|
| Rilascio ufficiale | 26 agosto 2026 |
| Nome dell’anteprima | Ox Alpha / ox-alpha |
| Architettura del modello | 320B di parametri complessivi, 18B attivi per token |
| Finestra di contesto | 1.048.576 token (1M) |
| Input | Testo, immagini e video |
| Output | Testo |
| Licenza | MIT |
| Checkpoint ufficiale | zai-org/GLM-5.3-Flash |
| Prezzo API indicato per l’input | $0.15 per 1M di token |
| Prezzo indicato per l’input memorizzato nella cache | $0.03 per 1M di token |
| Prezzo API indicato per l’output | $0.50 per 1M di token |
La pagina di Hugging Face indica una dimensione del modello di circa 321B di parametri, mentre la descrizione usa la forma abbreviata 320B-A18B. I due valori si riferiscono rispettivamente alla capacità complessiva memorizzata e alla quantità di calcolo attivata per ogni token: 18B di parametri attivi non trasformano il checkpoint in un modello locale da 18B.
Cosa cambia tra Ox Alpha e il modello pubblico
Z.ai spiega di aver eseguito GLM-5.3-Flash in forma anonima come Ox Alpha prima del rilascio pubblico, utilizzando OpenCode e OpenRouter per raccogliere feedback dal mondo reale. La pagina di OpenRouter presentava l’anteprima come un modello multimodale con contesto esteso e prezzo temporaneamente pari a $0; il rilascio pubblico rende ora identificabili il provider, il checkpoint e la licenza.
L’anteprima e il modello distribuito restano comunque due ambienti operativi distinti. La corrispondenza del tokenizer o un errore API nello stile di GLM possono suggerire una discendenza comune, ma non dimostrano che ogni richiesta anonima utilizzasse i pesi finali o lo stesso livello di routing. Per deployment e riproducibilità, il riferimento è ora il checkpoint pubblico.
Cosa c’è davvero dietro il nome “Flash”
GLM-5.3-Flash combina un’architettura sparse mixture-of-experts con modifiche al meccanismo di attenzione pensate per contenere il costo dei contesti molto lunghi. Z.ai indica 320B di parametri totali, 18B attivi, 45 layer, un’attenzione ibrida sparse e lineare, IndexPool per il retrieval e Manifold-Constrained Hyper-Connections (mHC). La scheda del modello attribuisce inoltre l’addestramento a un corpus multimodale da 30T di token.
Secondo Z.ai, rispetto a GLM-5.3 il modello riduce di 3 volte il calcolo dell’attenzione e di 4,4 volte la cache KV con un contesto da 1M. Sono dichiarazioni architetturali del produttore, non una garanzia di latenza valida per qualsiasi hardware: la velocità effettiva dipende ancora dalla lunghezza del contesto, dalla concorrenza, dal preprocessing delle immagini e dallo stack di serving.
La multimodalità nativa è particolarmente interessante per gli agenti, più che per il generico ruolo di “chatbot capace di vedere”. L’idea di Z.ai è permettere a un agente di analizzare interfacce renderizzate, stati del browser, documenti e altri artefatti visivi, per poi correggere il codice o il risultato prodotto. La scheda ufficiale mostra input immagine, mentre la documentazione del modello pubblico e del deployment descrive anche l’input video.
Cosa dimostrano i benchmark e cosa invece no
Il rilascio ufficiale e la scheda del modello riportano risultati solidi, soprattutto nelle attività di coding e agentic. Tra i valori visibili nella model card figurano 84,3 in TerminalBench 2.1, 63,4 in DeepSWE e 55,3 in HLE. Nel materiale di rilascio, Z.ai indica inoltre un punteggio di 57 nell’Artificial Analysis Intelligence Index, 48,8 in AutomationBench e 29,0 in Z.ai Code Bench con il massimo livello di impegno.
| Benchmark | GLM-5.3-Flash | Confronto o riferimento | Fonte e limite |
|---|---|---|---|
| TerminalBench 2.1 | 84,3 | GLM-5.2: 81,0; Claude Opus 4.8: 85,0 | Risultato Z.ai/model card; contano harness e budget |
| DeepSWE v1.1 | 63,4 | GLM-5.2: 46,2 | Valutazione riportata; non va generalizzata a ogni repository |
| AutomationBench | 48,8 | GLM-5.2: 26,2 | Valutazione riportata con una versione specifica del benchmark |
| Z.ai Code Bench, massimo impegno | 29,0 | Claude Opus 4.8: 29,5 | Risultato quasi alla pari nella configurazione di Z.ai |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.ai lo considera comparabile a Claude Opus 4.8 | Indice esterno; il mix di attività non misura solo il coding |
I risultati provengono da harness, limiti di contesto, timeout e giudici differenti. È quindi più corretto usarli per un confronto direzionale che considerarli come posizioni di un’unica classifica universale. La conclusione più equilibrata è che GLM-5.3-Flash offre prove credibili di un netto miglioramento rispetto a GLM-5.2 nelle valutazioni su coding agentico, non che superi ogni modello frontier in qualsiasi scenario.
La stessa prudenza vale per i test della community. @prz_chojecki ha riportato che Ox Alpha ha ottenuto risultati migliori di GLM-5.2 in tutti i 226 problemi di ErdosBench. È un’indicazione utile per costruire casi di test, ma non sostituisce una valutazione controllata sui propri strumenti e sul proprio repository.
I limiti pratici emersi nelle prime prove
“Flash” descrive meglio il calcolo attivo e il posizionamento sul prezzo che non la latenza interattiva. Le discussioni degli utenti in r/opencodeCLI hanno evidenziato sia buoni risultati nel coding sia attese frustranti, soprattutto durante l’anteprima anonima. Si tratta di osservazioni legate al provider e al carico di lavoro, non di benchmark ufficiali sulla latenza.
«Come si può chiamare “Flash” se è molto più lento del modello principale?» — u/ahriad in r/opencodeCLI
Il segnale operativo più utile riguarda l’affidabilità degli agenti durante le esecuzioni prolungate e sotto carico. @solomonneas ha riportato 30 build completate con successo su 49 tentativi in un test di sette giorni, mentre 14 fallimenti sono arrivati sotto forma di timeout. Questo non dimostra un tasso di errore fisso per l’API ufficiale, ma rende consigliabile predisporre un percorso di fallback per i task che possono durare ore.
C’è poi un limite al deployment locale che i titoli dei benchmark tendono a nascondere: il checkpoint ufficiale in FP8 occupa circa 306 GiB, a cui vanno aggiunti runtime e cache KV. Un modello da 320B di parametri complessivi richiede quindi un’infrastruttura con molta memoria anche quando, per ogni token, vengono attivati soltanto 18B di parametri.
API, accesso via cloud e opzioni per l’esecuzione locale
Per l’uso tramite API, la pagina dei prezzi di Z.ai indica per GLM-5.3-Flash $0.15 per 1M di token in input, $0.03 per 1M di token in input memorizzati nella cache e $0.50 per 1M di token in output. Una promozione temporanea del 50% porta i prezzi a $0.075 per l’input, $0.015 per l’input in cache e $0.25 per l’output, con termine alle 24:00 del 9 settembre 2026, UTC+8. Prima di definire il budget, consulta la tabella ufficiale dei prezzi Z.AI, perché la promozione ha una scadenza.
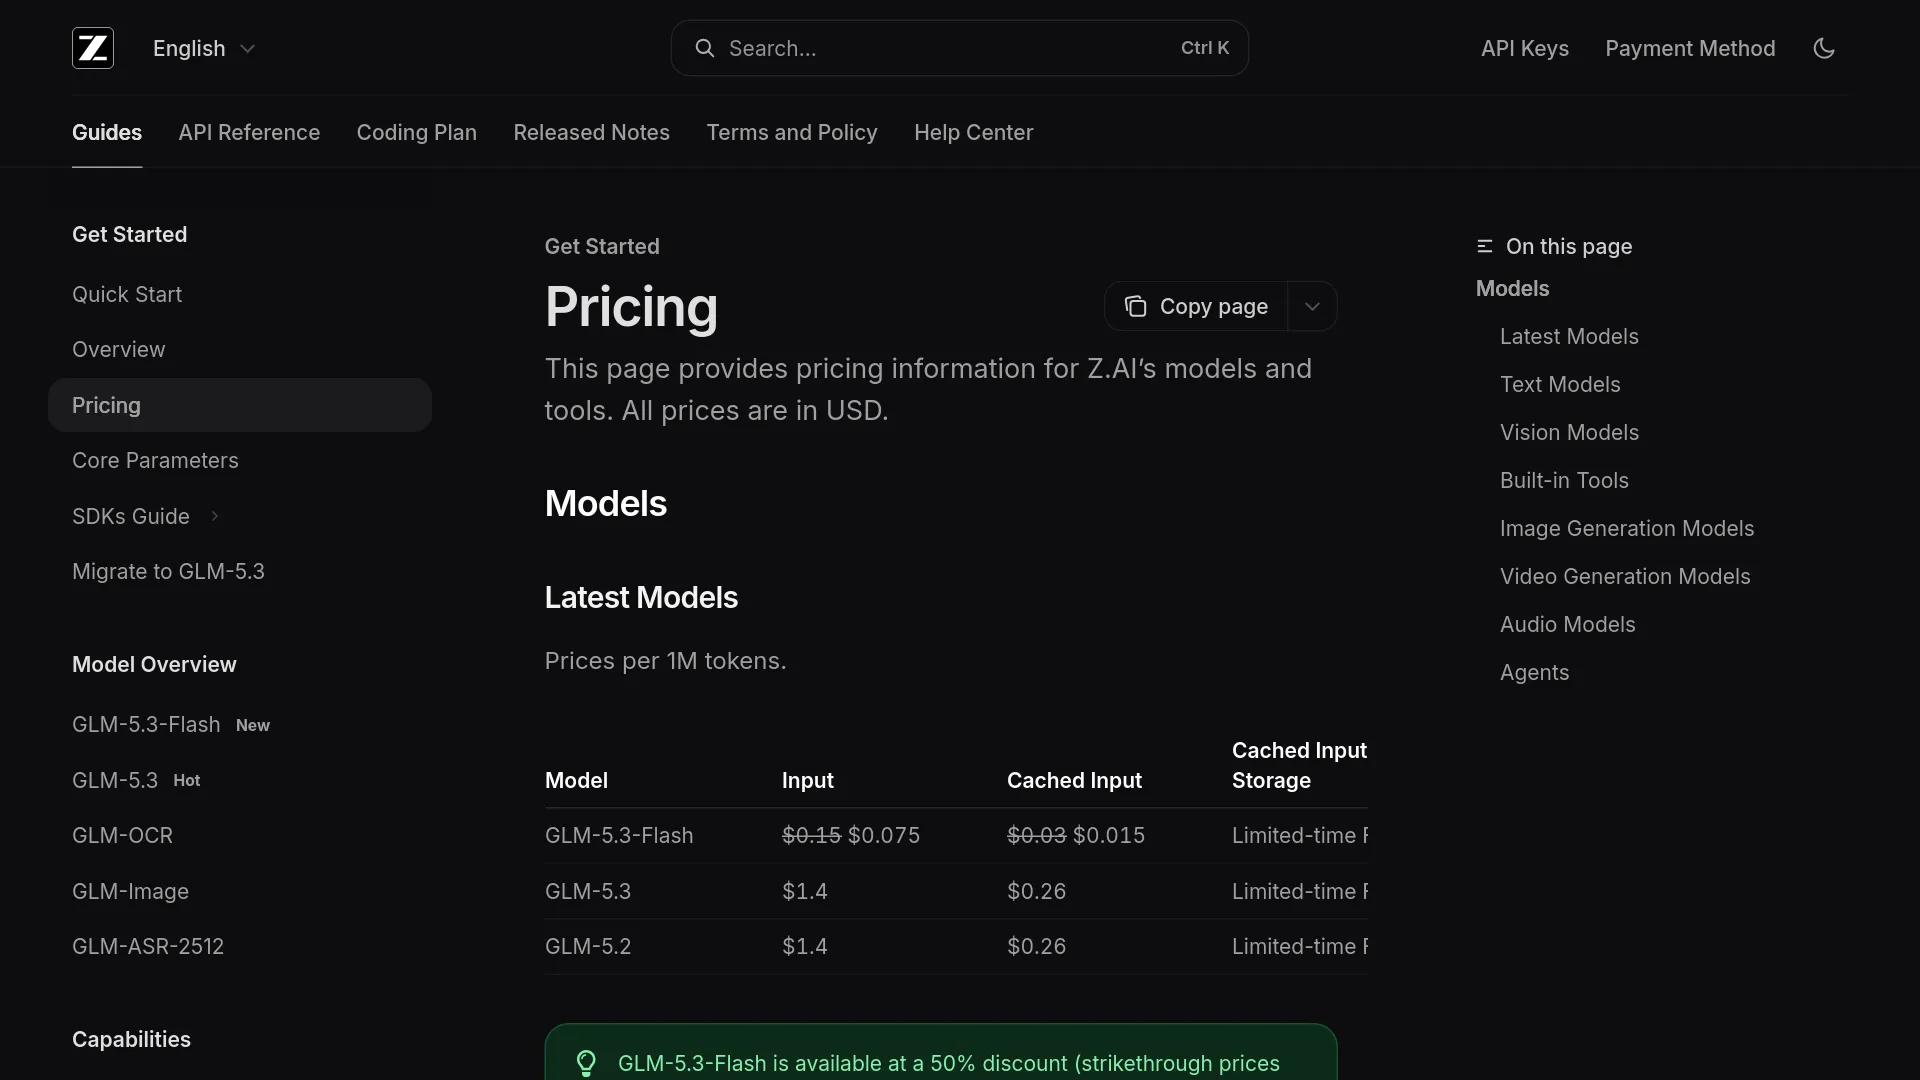
Il prezzo di listino pubblico è distinto dal costo temporaneo dell’anteprima Ox Alpha. In un esempio semplice, 10M di token in input più 2M di token in output costerebbero $2.50 al prezzo standard, prima di eventuali costi aggiuntivi del provider: 10 × $0.15 + 2 × $0.50. La cache può ridurre la componente relativa all’input quando il provider fattura quei token come contenuti memorizzati.
L’esecuzione locale è possibile, ma va considerata un progetto infrastrutturale, non un download da lanciare su un normale laptop. La ricetta vLLM ufficiale indica circa 306 GiB per i pesi FP8 e 386GB di VRAM per il deployment FP8 predefinito; per BF16 sono indicati 772GB. Il percorso supportato richiede attualmente GPU NVIDIA Hopper o successive, una versione recente di FlashInfer e un’immagine vLLM dedicata, mentre l’integrazione è ancora in fase di maturazione.
Il tutorial di KTransformers documenta l’inferenza eterogenea CPU-GPU, l’uso diretto dei pesi FP8 ufficiali e almeno 350GB di memoria di sistema libera. L’esempio con una sola GPU utilizza una configurazione con offload: non significa che una singola GPU consumer possa contenere il modello. Il tutorial usa inoltre un’impostazione con 501.025 token validata e limita ogni richiesta multimodale a otto immagini oppure a un video.
| Modalità di deployment | Cosa supporta la documentazione | Vincolo principale |
|---|---|---|
| API Z.ai | Accesso hosted a consumo; tariffe standard e promozionali pubblicate | Verificare limiti di richieste, condizioni regionali e promozione in corso |
| vLLM | Serving FP8/BF16, endpoint compatibile con OpenAI, tensor parallelism e percorso multimodale | Infrastruttura NVIDIA con molta memoria; la ricetta attuale è pensata per Hopper+ |
| KTransformers | Inferenza eterogenea CPU-GPU e caricamento FP8 | Circa 306 GiB di pesi; raccomandati almeno 350GB di memoria di sistema |
| Ollama/LM Studio/ecosistema llama.cpp | La model card rimanda a distribuzioni quantizzate e strumenti compatibili | Supporto ai modelli quantizzati e velocità dipendono dalla build specifica |
Chi dovrebbe usare GLM-5.3-Flash oggi?
È adatto agli agenti di coding attenti ai costi e ai progetti pilota di engineering con contesti lunghi. Il prezzo di listino contenuto, il contesto da 1M e il miglioramento riportato rispetto a GLM-5.2 lo rendono interessante per analizzare repository, modificare più file, generare test e lanciare chiamate agentiche ripetute. Mantieni test di accettazione e un modello di fallback finché il tasso di successo sul tuo flusso non sarà stabile.
Ha senso per il lavoro tecnico multimodale quando i modelli GLM solo testuali diventano il collo di bottiglia. Gli input immagine e video possono aiutare un agente a esaminare output del browser, layout delle interfacce, diagrammi, documenti e artefatti renderizzati. Non è un generatore video: analizza input visivi e restituisce testo o codice.
Non sceglierlo soltanto perché “18B attivi” sembra indicare un modello da desktop. Il checkpoint complessivo è di circa 320B di parametri e l’esecuzione locale richiede centinaia di gigabyte di memoria o spazio, prima ancora di considerare contesto e overhead del runtime. L’accesso via API è in genere la scelta economicamente più semplice, a meno che tu non disponga già di hardware per l’inferenza con molta memoria.
Non inviare codice riservato a un endpoint di anteprima non verificato. Il rilascio pubblico di GLM-5.3-Flash è riconducibile a Z.ai, ma contano comunque le condizioni del provider, la conservazione dei dati e il routing. In produzione, registra la policy dati attuale dell’endpoint e usa l’API ufficiale oppure un provider con condizioni operative verificabili.
FAQ
Ox Alpha è esattamente lo stesso modello di GLM-5.3-Flash?
Z.ai identifica ufficialmente GLM-5.3-Flash come il modello presentato in precedenza come Ox Alpha. Il comportamento osservato durante l’anteprima resta un riferimento utile, ma routing e limiti di quella fase non vanno trattati come specifiche del modello pubblico.
GLM-5.3-Flash è open source?
Il checkpoint ufficiale su Hugging Face è distribuito con licenza MIT e Z.ai fornisce riferimenti per l’esecuzione locale. La definizione operativa più precisa è “open weights”: i pesi sono disponibili, ma per eseguire il modello completo serve comunque un’infrastruttura consistente.
Quanta memoria serve per eseguire GLM-5.3-Flash in locale?
I pesi ufficiali FP8 occupano circa 306 GiB, esclusi runtime e cache KV. La ricetta vLLM indica 386GB di VRAM per il deployment FP8 predefinito, mentre KTransformers raccomanda almeno 350GB di memoria di sistema per l’inferenza eterogenea.
L’API costa davvero $0.15 per milione di token in input?
Sì. La pagina ufficiale dei prezzi di Z.AI indica $0.15 per l’input, $0.03 per l’input in cache e $0.50 per l’output; la promozione del 50% è indicata fino al 9 settembre 2026, UTC+8.
GLM-5.3-Flash è più veloce degli altri modelli Flash?
Le prove disponibili non stabiliscono una classifica universale della latenza. I primi utenti hanno segnalato sessioni agentiche lente o interrotte da timeout, quindi misura sul tuo percorso e con il tuo provider il tempo al primo token, il tempo di completamento, i retry e il tasso di task accettati.
GLM-5.3-Flash supporta immagini e video?
Sì. Z.ai e la scheda ufficiale descrivono input testuali, immagini e video con output testuale. La documentazione per l’esecuzione locale aggiunge limiti per le richieste, come un massimo di otto immagini oppure un video nella configurazione KTransformers documentata.
Usa l’API hosted se vuoi sfruttare costi e multimodalità di GLM-5.3-Flash senza acquistare un sistema per l’inferenza con centinaia di gigabyte; valuta il deployment locale solo se disponi già dell’infrastruttura necessaria. Per i task agentici più lunghi, mantieni un fallback già testato: le evidenze disponibili sono più solide sul piano delle capacità e del prezzo che su quello dell’affidabilità interattiva prolungata.