 AIREITER
Se stai cercando alternative a GLM-5-3-Flash, probabilmente non ti serve l’ennesima spiegazione della comparsa di Ox Alpha. Ti serve sostituire un percorso agent economico ma a volte lento, evitare un checkpoint locale da 320B parametri oppure continuare a gestire input multimodali senza riscrivere il client API. La scelta giusta dipende dal problema concreto che vuoi risolvere.
In breve: scegli in base al problema da correggere
DeepSeek V4 Flash è la soluzione testuale più flessibile quando contano il prezzo delle cache hit, la modalità opzionale senza reasoning e un’elevata concorrenza. Offre un contesto da 1M token, un limite di concorrenza di 2.500 richieste e, negli orari non di punta, prezzi ufficiali di $0.22 per milione di token di input non memorizzati in cache e $0.66 per milione di token di output.
Qwen3.8-Flash è la strada hosted da provare quando servono input di immagini e video, compatibilità API e strumenti integrati. Il prezzo indicato è di $0.15 per milione di token in input e $0.47 per milione di token in output.
GLM-5.3 è il passaggio naturale all’interno della stessa famiglia se vuoi restare con Z.ai ma ti serve il suo modello testuale flagship. GPT-5.6 Terra e Claude Opus 4.8 sono opzioni premium per i flussi in cui portare a termine un’attività in più vale diversi multipli del costo. Kimi K3 offre un contesto da 1M token, ma non è un sostituto economico.
La domanda non è “quale modello vince?”. Devi capire se stai ottimizzando costo dei token, input visivi, coding su orizzonti lunghi, controllo locale o percentuale di attività completate.
L’endpoint Ox Alpha non c’è più: parti dallo stato della migrazione
L’annuncio ufficiale di Z.ai ha identificato l’anteprima anonima Ox Alpha come GLM-5.3-Flash il 26 agosto 2026. Il rilascio pubblico ha aggiunto un checkpoint con nome, prezzi pubblici, un modello Hugging Face con licenza MIT e l’accesso API documentato. Il vecchio ambiente di anteprima non va considerato un contratto permanente: routing, quote, latenza e comportamento delle policy possono differire da quelli dell’API rilasciata.
Se una configurazione usa ancora stealth/ox-alpha, l’identificativo pubblico su OpenRouter è z-ai/glm-5.3-flash; le richieste dirette a Z.ai utilizzano la base URL generale https://api.z.ai/api/paas/v4. Z.ai documenta anche un endpoint separato per il Coding Plan, https://api.z.ai/api/coding/paas/v4: non dare per scontato che il percorso in abbonamento e l’API generale abbiano gli stessi prezzi o gli stessi limiti.
“Per me non è cambiato nulla. Entrambi i modelli sono decisamente troppo grandi per il mio sistema con 32 GB di RAM.” — u/dampflokfreund, r/LocalLLaMA
Alternative a confronto: prezzi, contesto e modalità di deployment
I prezzi riportati di seguito sono istantanee delle tariffe pubblicate dai provider, verificate il 28 agosto 2026. Non si tratta di un’unica promozione uniforme: DeepSeek applica prezzi diversi nelle fasce di punta e fuori punta, mentre il prezzo Flash di Z.ai include uno sconto temporaneo valido fino al 9 settembre 2026 alle 24:00 UTC+8.
| Modello | Input / 1M token | Output / 1M token | Contesto | Modalità di input | Perché sceglierlo |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | $0.22 fuori punta; $0.44 in punta | $0.66 fuori punta; $1.32 in punta | 1M | Testo | Routing testuale attento alla cache e modalità senza reasoning |
| Qwen3.8-Flash | $0.15 | $0.47 | 1M | Testo, immagini, video | Multimodalità hosted e compatibilità API |
| GLM-5.3 | $1.40 | $4.40 | 1M | Testo | Stesso provider, modello di fascia superiore della famiglia |
| GPT-5.6 Terra | $2.00 | $12.00 | 1.05M | Testo | Attività agent complesse con maggiore affidabilità |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Testo | Coding difficile e revisione di contesti lunghi |
| Kimi K3 | $3.00 | $15.00 | 1M | Testo | Attività avanzate su contesti lunghi |
Attualmente Z.ai indica GLM-5.3-Flash a $0.075 per l’input, $0.015 per l’input in cache e $0.25 per l’output ogni milione di token durante la promozione al 50%. I prezzi di listino sono $0.15, $0.03 per l’input in cache e $0.50. Il grafico di confronto usa il prezzo di listino, non la tariffa promozionale temporanea. (Prezzi Z.ai)
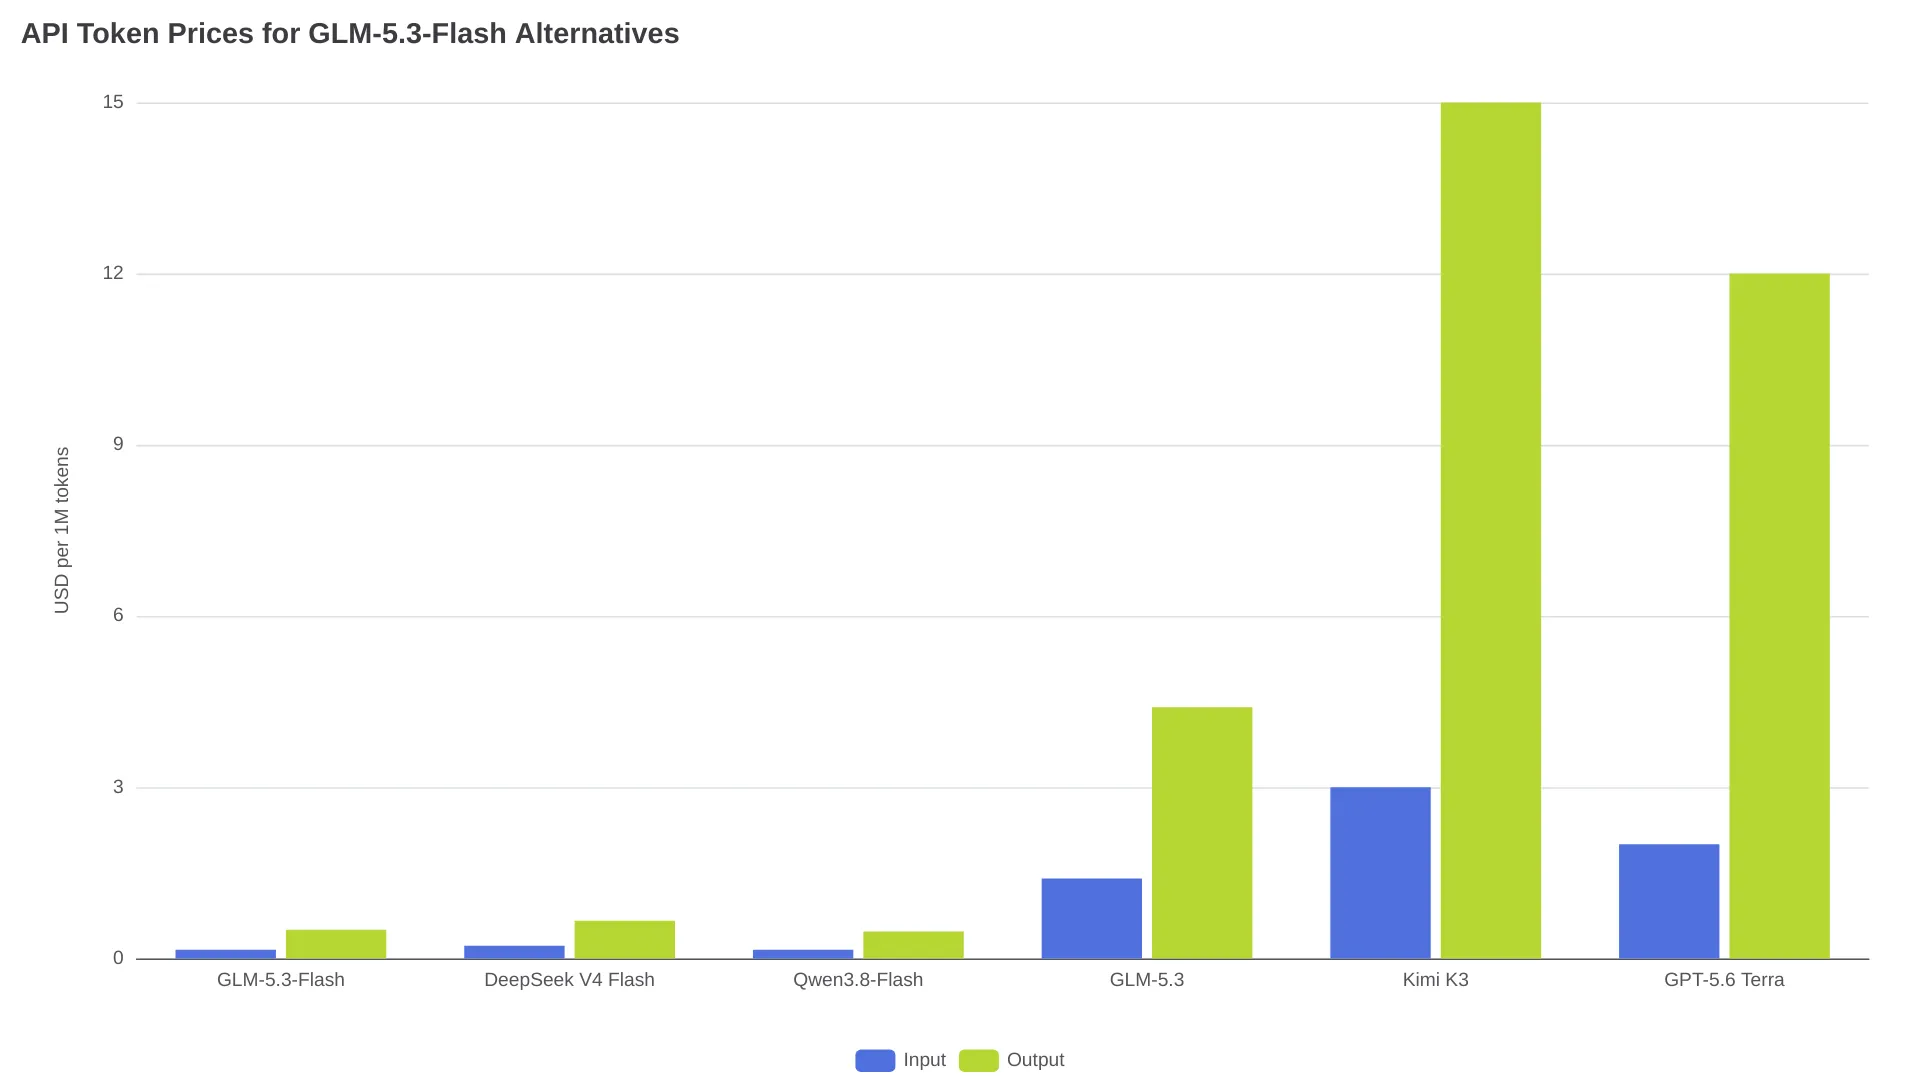
Base del confronto: prezzo di listino di GLM-5.3-Flash, prezzo ufficiale fuori punta di DeepSeek V4 Flash e tariffe attualmente pubblicate dai provider per le altre righe. Il prezzo di punta di DeepSeek è il doppio di quello fuori punta.
Le sei alternative realistiche
DeepSeek V4 Flash: testo e coding con gestione intelligente della cache
DeepSeek V4 Flash è il primo modello da provare quando GLM-5.3-Flash costa troppo per il traffico testuale ordinario. DeepSeek indica un contesto da 1M token, un output massimo di 384K, output JSON, tool calling, Responses API e accesso compatibile con Anthropic. Il limite ufficiale di concorrenza è di 2.500 richieste.
La differenza nella fatturazione è importante. DeepSeek separa i cache hit dai cache miss e raddoppia le tariffe nelle fasce di punta dei giorni feriali, dalle 01:00 alle 04:00 e dalle 06:00 alle 10:00 UTC. Supporta inoltre modalità thinking e non-thinking, mentre la scheda del modello GLM-5.3-Flash documenta livelli di reasoning low, high e max, non una semplice modalità senza thinking.
Scegli DeepSeek V4 Flash per carichi con contesto ripetuto, chat basate sul retrieval e coding testuale in cui contano i cache hit o la possibilità di controllare il reasoning. Qwen3.8-Flash ha tariffe pubblicate più basse sui token nuovi, quindi DeepSeek non è automaticamente la scelta più economica per ogni richiesta testuale. Non è un sostituto diretto per i flussi visivi: l’input di immagini passa dall’endpoint separato deepseek-v4-flash-vision-exp e i token derivati dalle immagini vengono fatturati come input.
Qwen3.8-Flash: il sostituto hosted più vicino per la multimodalità
Qwen3.8-Flash è l’alternativa hosted più vicina da testare se il tuo agent invia screenshot, grafici o video e vuoi mantenere un’integrazione con una singola API. QwenCloud indica input di immagini, testo e video; un contesto da 1M token; un input massimo di 991K; e un output massimo di 131K. Sono supportate API compatibili con OpenAI e Anthropic, strumenti, output strutturato, caching, batch, ricerca web e fine-tuning.
Il compromesso operativo riguarda la struttura della cache. QwenCloud indica $0.016 per milione di token per le letture implicite dalla cache, $0.20 per la creazione esplicita della cache e $0.47 per l’output. I limiti pubblicati sono di 2M token al minuto e 15.000 richieste al minuto, ma la pagina non chiarisce se si applichino a singolo account, chiave, organizzazione o deployment.
Scegli Qwen3.8-Flash quando l’input visivo è indispensabile o il prezzo dei token nuovi è una priorità. La pagina ufficiale del modello non offre una tabella di benchmark nominativa, risultati sulla latenza o uno studio sull’affidabilità delle sessioni lunghe: verifica quindi il modello sulle tracce reali del tuo agent, senza confondere la parità delle funzioni con la parità del comportamento.
GLM-5.3: il passaggio alla fascia superiore della stessa famiglia
GLM-5.3 non è l’alternativa economica. È il passaggio sensato quando il problema è la profondità insufficiente nelle attività testuali, non il prezzo o la multimodalità. Il listino di Z.ai indica $1.40 per milione di token in input, $0.26 per l’input in cache e $4.40 per milione di token in output: circa un ordine di grandezza in più rispetto al prezzo di listino di Flash.
Z.ai presenta GLM-5.3 come il suo modello flagship per il coding, mentre GLM-5.3-Flash è il modello multimodale nativo più economico. Usa GLM-5.3 in modo selettivo per le attività testuali più difficili: il passaggio potrebbe eliminare il flusso visivo che rendeva utile Flash.
GPT-5.6 Terra: quando conta di più portare a termine il lavoro
GPT-5.6 Terra è una soluzione premium per i team che preferiscono completare le attività complesse invece di inseguire il costo minimo per token. OpenAI indica $2 per milione di token in input, $0.20 per l’input in cache e $12 per milione di token in output, con una finestra di contesto di circa 1.05M token. Nella tabella di benchmark pubblicata da Z.ai, GPT-5.6 Terra ottiene 87.4 su Terminal-Bench 2.1 e 69.6 su DeepSWE v1.1, superando i punteggi di GLM-5.3-Flash, rispettivamente 84.3 e 63.4, nelle configurazioni citate.
Questi numeri giustificano un test di Terra quando il costo di un’attività di coding fallita supera quello di una fattura API più alta; non dimostrano però una superiorità universale in produzione. Usalo come livello di escalation per modifiche ad alto valore nei repository o per attività autonome complesse.
Claude Opus 4.8: coding difficile e revisione di contesti lunghi
Claude Opus 4.8 costa $5 per milione di token in input e $25 per milione di token in output secondo i prezzi globali standard di Anthropic. Anthropic indica inoltre $0.50 per milione di token per le letture dalla cache e tariffe batch pari alla metà dei prezzi standard di input e output.
Nella tabella comparativa di Z.ai, Opus 4.8 supera GLM-5.3-Flash su Terminal-Bench 2.1, Agents’ Last Exam, HLE with Tools e NL2Repo, mentre Flash prevale in diverse prove incentrate sugli strumenti e sull’automazione. Questa differenza rende Opus più adatto come modello di escalation da valutare con criterio che come scelta predefinita universale.
Kimi K3: contesti da 1M token, non inferenza economica
Kimi K3 entra in questa lista per un motivo diverso: potresti aver bisogno di un modello con contesto da 1M token per flussi di lavoro lunghi di software engineering o ricerca. Kimi indica $0.30 per milione di token di input in cache, $3 per l’input e $15 per l’output.
Con queste tariffe, scegli Kimi K3 solo se il contesto e il profilo di capacità giustificano il sovrapprezzo. Non è la risposta alla domanda “come posso ridurre la spesa per i token?”.
Scegli in base al carico di lavoro, non alla classifica
| Carico di lavoro o vincolo | Primo modello da testare | Perché |
|---|---|---|
| Classificazione o estrazione di grandi volumi di testo | Qwen3.8-Flash | Tariffe pubblicate più basse per input e output nuovi rispetto a DeepSeek V4 Flash fuori punta |
| Testo lungo con prefissi ripetuti | DeepSeek V4 Flash | Prezzi per i cache hit e modalità opzionale senza thinking |
| Testo lungo con input prevalentemente nuovi | Qwen3.8-Flash | Tariffe pubblicate più basse sui token nuovi |
| Screenshot, grafici o video in un flusso API | Qwen3.8-Flash | Input nativo di immagini e video e protocolli API familiari |
| Stesso ecosistema Z.ai, ma reasoning testuale più difficile | GLM-5.3 | Mantiene il provider e sale di fascia all’interno della famiglia |
| Coding in cui gli errori hanno un costo elevato | GPT-5.6 Terra | Escalation premium con punteggi di coding citati più alti |
| Code review accurata o pianificazione sul repository | Claude Opus 4.8 | Reasoning premium, con opzioni di cache e batch |
| Attività di lunga durata in cui il contesto conta più del prezzo | Kimi K3 | Posizionamento orientato a capacità e contesto da 1M |
| Portatile comune o workstation con 32 GB | Prima un’API hosted | GLM-5.3-Flash è un checkpoint da circa 320B parametri complessivi, non un modello locale da 18B |
Il vincolo del deployment locale è significativo. Il checkpoint ufficiale di GLM-5.3-Flash è descritto come un modello da circa 320B parametri complessivi; la recensione sul deployment di AIReiter rileva un footprint FP8 di circa 306 GiB e un deployment vLLM predefinito che richiede circa 386GB di VRAM. La quantizzazione abbassa il requisito, ma non trasforma il modello in un normale download per laptop.
Una strategia di migrazione più sicura per gli agent
Tieni separati l’adapter del provider e il routing delle attività, poi valuta il sostituto sui lavori che contano davvero.
- Mantieni un’unica interfaccia per le richieste. Conserva il livello compatibile con OpenAI per messaggi, strumenti e output strutturati quando il provider lo supporta. Tratta i controlli del reasoning, i payload visivi, le tool call, gli output strutturati e i limiti di contesto come capability flag, non come campi universali.
- Misura le attività completate, non solo il testo generato. Registra se il codice compila, se la tool call è valida, se il controllo visivo va a buon fine e se l’attività termina senza retry. Una prima risposta economica che richiede poi due retry su un repository di grandi dimensioni potrebbe non essere davvero più conveniente.
- Instrada in base al tipo di errore. Manda il testo con contesto ripetuto a DeepSeek V4 Flash, le richieste multimodali a Qwen3.8-Flash e le attività di coding ad alto rischio a GPT-5.6 Terra, Claude Opus 4.8 o GLM-5.3, in base ai risultati ottenuti nei test di accettazione.
- Conserva un fallback. La recensione di AIReiter registra un test della community durato sette giorni, con 30 build riuscite su 49 tentativi e 14 timeout. Non è un tasso universale di errore del provider, ma basta a sconsigliare un agent di produzione basato su un solo percorso.
- Fai i conti sui prezzi normali. La promozione Flash di Z.ai termina il 9 settembre 2026. Le tariffe di DeepSeek cambiano in base alla fascia oraria. Qwen applica prezzi diversi alla creazione della cache e alle letture dalla cache. Una migrazione che funziona solo durante una tariffa temporanea non è un modello di costo stabile.
Un primo test pratico consiste in dieci richieste ordinarie o incentrate sul testo e dieci attività di coding, uso degli strumenti o analisi visiva. Confronta la percentuale di attività completate, il tempo totale, i retry e la spesa complessiva per i token. Per molti team significa provare DeepSeek V4 Flash per il testo con contesto ripetuto e Qwen3.8-Flash per i flussi multimodali, mantenendo GLM-5.3-Flash come fallback finché i nuovi percorsi non dimostrano di essere affidabili.
Domande frequenti
Qual è la migliore alternativa gratuita a Ox Alpha?
Le fonti ufficiali verificate qui non indicano un sostituto gratuito permanente e indipendente dal provider. I provider possono offrire quote o promozioni variabili, ma una decisione per la produzione dovrebbe basarsi sui prezzi pubblicati e considerare l’accesso gratuito solo come un vantaggio aggiuntivo.
Quale alternativa supporta immagini e video?
Qwen3.8-Flash indica ufficialmente input di immagini, testo e video. L’endpoint standard di DeepSeek V4 Flash è distinto da deepseek-v4-flash-vision-exp, quindi prova l’endpoint esatto prima di migrare un agent visivo.
Quale alternativa posso eseguire in locale?
Tra le opzioni open weight ci sono il checkpoint GLM-5.3-Flash e Qwen3.8-Flash-Next. GLM-5.3-Flash ha circa 320B parametri complessivi, mentre la documentazione di Qwen per Flash-Next descrive un contesto nativo da 262K, estendibile a 1M con YaRN. Non bisogna dare per scontato che nessuno dei due possa essere eseguito su una macchina con 32 GB.
Come posso evitare sorprese dopo aver cambiato provider?
Esegui 20 attività rappresentative su due percorsi e confronta la percentuale di attività completate, il tempo totale, i retry e la spesa complessiva per i token. Mantieni il percorso GLM-5.3-Flash esistente come fallback finché il sostituto non dimostra di essere affidabile con i tuoi strumenti e i tuoi repository.