 AIREITER
Con un prezzo di $2 per milione di token in input e un risultato pubblicato del 70,6% su Terminal-Bench 4.0, Claude Sonnet 5.5 sembra il candidato naturale per i team che costruiscono agenti di coding. Il conto reale, però, può salire rapidamente quando si usano livelli di effort elevati: il costo per modifica accettata può diventare molto più alto. In produzione lo tratterei quindi come il modello predefinito da testare, non come un sostituto automatico di Opus 5.5.
Il verdetto per la produzione: Sonnet 5.5 come corsia predefinita per il coding
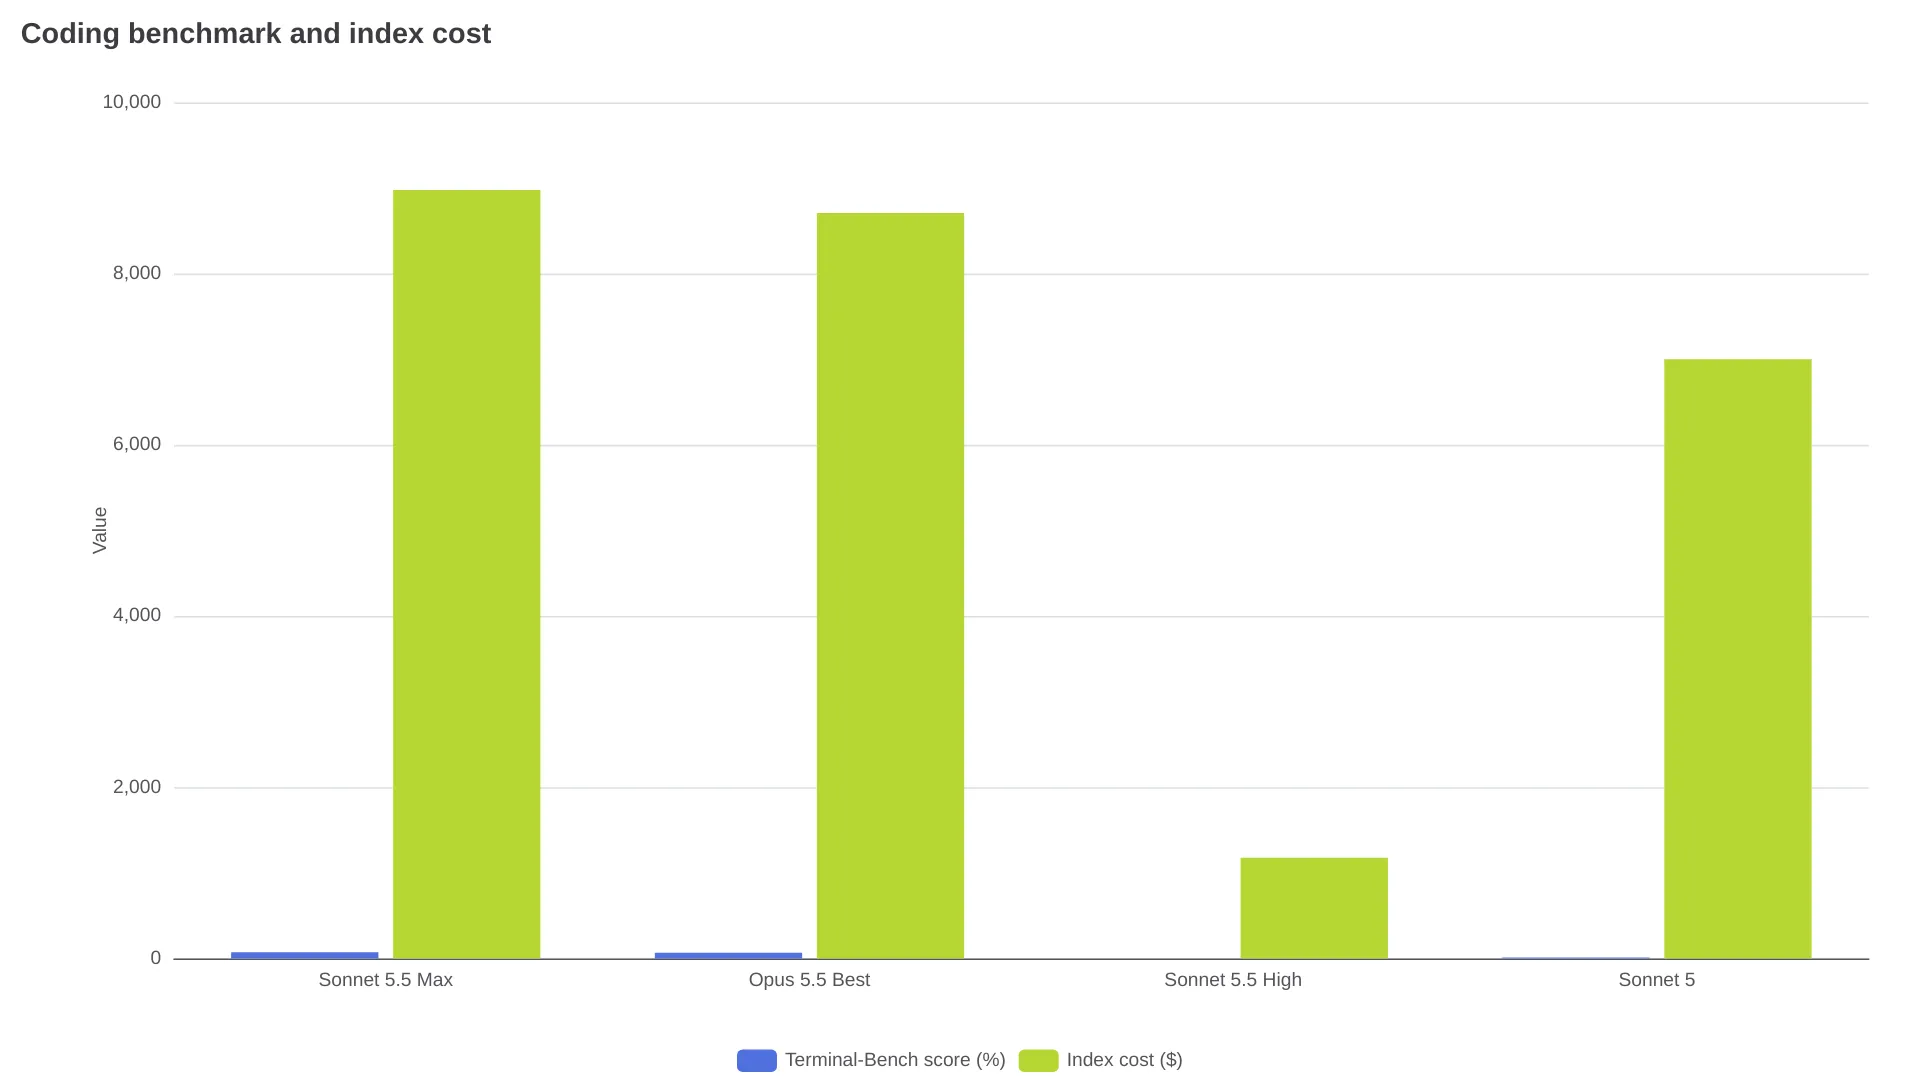
Il primo passo dovrebbe essere un pilot di Claude Sonnet 5.5 su bug fix circoscritti, refactoring, generazione di test e attività di repository che richiedono l’uso di strumenti. Nei risultati pubblicati da Anthropic, Terminal-Bench 4.0 assegna a Sonnet 5.5 il 70,6%, contro il 66,4% di Claude Opus 5.5 e il 10,3% di Claude Sonnet 5 nella stessa comparazione.
Serve però una regola semplice: impostare esplicitamente effort e limiti di output. Analisi indipendenti sui costi indicano che, al livello massimo, Sonnet 5.5 può costare più di Opus 5.5 per singola attività di benchmark, nonostante le tariffe di listino più basse.
Cosa cambia per i team che usano Claude Sonnet 5.5 via API
Claude Sonnet 5.5 è stato lanciato il 28 settembre 2026. La documentazione ufficiale del modello indica il model ID claude-sonnet-5-5, una finestra di contesto da 1 milione di token, un output massimo standard di 128.000 token, il thinking adattivo e un livello di effort predefinito dell’API pari a high.
| Dettaglio per la produzione | Claude Sonnet 5.5 |
|---|---|
| Data di rilascio | September 28, 2026 |
| Model ID | claude-sonnet-5-5 |
| Finestra di contesto | 1M tokens |
| Output massimo standard | 128K tokens |
| Output massimo in batch | 300K tokens con l’header beta documentato |
| Effort predefinito dell’API | high |
Anthropic si impegna a non ritirare il modello prima del 28 settembre 2027. È una garanzia minima sul ciclo di vita, non una data finale di ritiro promessa.
Le impostazioni dell’API che incidono sul conto del coding
Il thinking adattivo è attivo per impostazione predefinita. Chi migra da Sonnet 5 dovrebbe verificare between_tools se ha bisogno di disabilitare il thinking iniziale: la documentazione ufficiale specifica che l’uso forzato degli strumenti ora restituisce un errore e che valori non predefiniti di temperature, top_p o top_k producono errori HTTP 400.
Il testo generato tra una chiamata allo strumento e l’altra può arrivare dentro blocchi thinking. Un client in streaming che presume che ogni messaggio intermedio sia un normale blocco di testo può sembrare improvvisamente inattivo dopo la migrazione. Prima di inserire Sonnet 5.5 in un agente di coding esistente, aggiornate il parser.
Prestazioni su Terminal-Bench: abbastanza solide per la corsia predefinita
Il benchmark più significativo tra quelli citati per gli agenti di coding è Terminal-Bench 4.0, che misura la capacità di gestire attività da riga di comando composte da più passaggi. I risultati riportati da Anthropic assegnano a Sonnet 5.5 il 70,6%, rispetto al 66,4% di Opus 5.5 e al 10,3% di Sonnet 5.
| Modello | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70.6% | 1844 | 55.5% |
| Claude Opus 5.5 | 66.4% | 1846 | 57.8% |
| Claude Sonnet 5 | 10.3% | 1449 | 34.1% |
I dati della tabella sono riportati nel riepilogo dei benchmark di DataCamp, che attribuisce i risultati delle valutazioni ai materiali di lancio di Anthropic. Sonnet 5.5 è in testa nel confronto sul coding da terminale, ma Opus 5.5 resta avanti su CursorBench e su diverse valutazioni più ampie di ragionamento e knowledge work.
La validazione va fatta riproducendo le attività sui repository e misurando test superati, numero di chiamate agli strumenti e modifiche accettate, non limitandosi a confrontare i diff.
Prezzi dell’API Claude Sonnet 5.5 nei carichi di lavoro reali
Il listino Anthropic è semplice da leggere, ma un agente di coding può pagare anche token che non compaiono nel prompt visibile. I token di thinking vengono fatturati come output, mentre il contesto ripetuto del repository può trasformarsi in letture dalla cache tra una chiamata e l’altra.
| Voce API | Prezzo di Claude Sonnet 5.5 |
|---|---|
| Input | $2 per 1M tokens |
| Output, incluso il thinking | $10 per 1M tokens |
| Scrittura in cache per 5 minuti | $2.50 per 1M tokens |
| Scrittura in cache per 1 ora | $4 per 1M tokens |
| Lettura dalla cache | $0.20 per 1M tokens |
| Input in batch | Sconto del 50%, equivalente a $1 per 1M |
| Output in batch | Sconto del 50%, equivalente a $5 per 1M |
La documentazione ufficiale indica un prompt minimo di 512 token per la cache e spiega che Sonnet 5.5 usa il thinking adattivo. Secondo l’analisi indipendente dei prezzi di eesel, Sonnet 5.5 usa lo stesso tokenizer di Sonnet 5: la migrazione non riduce automaticamente il numero di token.
Una richiesta con 4.000 token in input e 700 token in output costa circa $0.015 prima degli altri addebiti: $0.008 per l’input più $0.007 per l’output. Un agente di coding che compie 20 turni, con 3.000 token di input nuovi e 2.000 token di output per turno, consumerebbe all’incirca $0.12 di input nuovo e $0.40 di output, prima di considerare letture e scritture in cache, strumenti o retry. Sono esempi di carico di lavoro, non prezzi universali per attività.
L’effort è la vera leva sul prezzo
L’analisi di TokenCost sui livelli di effort, basata sulle misurazioni dell’Artificial Analysis Intelligence Index, ha riportato questi risultati per Sonnet 5.5:
| Effort | Punteggio | Costo sull’intero indice |
|---|---|---|
| Low | 35.8 | $544 |
| Medium | 40.7 | $701 |
| High | 46.7 | $1,176 |
| Xhigh | 51.9 | $2,738 |
| Max | 56.0 | $8,977 |
Il dato sul livello max è il principale campanello d’allarme. La stessa analisi ha misurato Opus 5.5 max a 57.6 per $8,708, mentre Opus 5.5 xhigh ha raggiunto 56.0 con un costo di $4,057. In quel test, Sonnet 5.5 max ha utilizzato circa 193.000 token di output per attività.
Partite da medium o high, fissate un limite ai token di output e promuovete a un percorso più costoso solo le attività fallite o ad alto rischio. Non copiate una vecchia configurazione Sonnet 5 max in Sonnet 5.5 senza ripetere le valutazioni su costi e qualità.
Checklist per migrare a un modello di coding in produzione
- Fissate
claude-sonnet-5-5nello staging invece di modificare globalmente un alias. - Riproducete bug fix, refactoring, test e modifiche multi-file rappresentativi dei vostri repository.
- Impostate esplicitamente l’effort e registrate token di output, letture dalla cache, chiamate agli strumenti, tempo trascorso e tasso di modifiche accettate.
- Sostituite
thinking: disabledcon il comportamento supportatobetween_toolsdove appropriato. - Eliminate le assunzioni sull’uso forzato degli strumenti e verificate il nuovo comportamento nella scelta degli strumenti.
- Aggiornate il codice di streaming per gestire i blocchi
thinkingtra una chiamata allo strumento e l’altra. - Ricontrollate i parametri di sampling non predefiniti: la documentazione ufficiale indica errori 400 per
temperature,top_petop_knon predefiniti. - Impostate un tetto di spesa e una condizione di interruzione per output fuori controllo o loop ripetuti tra gli strumenti.
- Confrontate il costo per modifica accettata, non il costo per richiesta.
- Distribuite il modello a una piccola percentuale del traffico. Aumentate la quota solo se Sonnet mantiene, entro la tolleranza concordata, il tasso di modifiche accettate del modello attuale riducendo al contempo il costo per modifica accettata.
Il dipendente Anthropic @cjav_dev ha riferito che le richieste con thinking: {"type":"disabled"} hanno iniziato a restituire errori 400 e che andrebbero migrate a between_tools (post su X).
Quando scegliere Sonnet 5.5, Opus 5.5 o un modello più economico
| Carico di lavoro | Prima scelta consigliata | Perché |
|---|---|---|
| Bug fix e refactoring circoscritti | Sonnet 5.5 a medium/high | Risultato solido sul terminale e tariffe token più basse |
| Classificazione del codice ad alto volume o modifiche semplici | Sonnet 5.5 a low/medium, oppure un modello più economico | Evita di pagare ragionamento non necessario |
| Agente di repository a esecuzione prolungata | Sonnet 5.5 con caching e budget rigidi | Sono cache e numero di turni a determinare il conto reale |
| Architettura ambigua o revisione finale | Opus 5.5 | Il giudizio complessivo conta più del listino più economico |
| Analisi del codice offline e non urgente | Claude Sonnet 5.5 Batch API | L’API offre uno sconto del 50% su input e output |
| Esperimento da terminale al massimo effort | Sonnet 5.5 solo dopo un benchmark interno | Terminal-Bench è un punto di forza, ma il livello max può costare molto |
Usate Sonnet per attività ben definite e misurabili; trasferite a Opus il lavoro architetturale ambiguo.
FAQ sull’API Claude Sonnet 5.5
Quali sono i prezzi dell’API Claude Sonnet 5.5?
La tariffa standard è di $2 per milione di token in input e $10 per milione di token in output. Le letture dalla cache costano $0.20 per milione di token, mentre le scritture costano $2.50 per cinque minuti o $4 per un’ora. La Batch API applica uno sconto del 50% a input e output.
Sonnet 5.5 è migliore di Opus 5.5 per il coding?
Sonnet 5.5 è in testa nel confronto pubblicato su Terminal-Bench 4.0, con il 70,6% contro il 66,4% di Opus 5.5. Opus resta avanti in diverse altre valutazioni: il routing dovrebbe quindi dipendere dal tipo di attività, non da una classifica universale basata su un solo risultato di coding.
Qual è il model ID di Sonnet 5.5?
Nella Claude API usate claude-sonnet-5-5. Gli identificativi specifici dei provider sono elencati nella documentazione dei modelli Anthropic.
Sonnet 5.5 supporta una finestra di contesto da 1 milione di token?
Sì. Anthropic indica una finestra di contesto da 1 milione di token e un output massimo standard di 128.000 token. La beta della Message Batches API può supportare 300.000 token di output con l’header beta documentato.
Cosa cambia nella migrazione da Sonnet 5?
Sono cambiati il thinking adattivo e il comportamento dei blocchi nella risposta; l’uso forzato degli strumenti può generare errori, i parametri di sampling non predefiniti possono restituire errori 400 e thinking: disabled deve essere sostituito dal comportamento supportato. Prima del rollout in produzione, ripetete i test dell’agente e dello streaming.
Eseguite un pilot di una settimana con effort medium/high, misurando il costo per modifica accettata e trasferendo a Opus i casi che falliscono.