 AIREITER
Pour les usages visuels natifs, choisissez GLM-5.3-Flash. Pour le texte et le code fortement dépendants du cache, préférez DeepSeek V4 Flash : le workload et le mode de facturation comptent davantage qu’un benchmark isolé.
Tout commence par les bons identifiants de modèle
Cette comparaison oppose GLM-5.3-Flash (glm-5.3-flash) au modèle d’API de production de DeepSeek, deepseek-v4-flash, référencé sur la page tarifaire officielle sous le nom DeepSeek-V4-Flash-0731. DeepSeek V4 Pro et l’endpoint expérimental distinct deepseek-v4-flash-vision-exp ne remplacent pas ici le modèle Flash principal. Pour l’identité Ox Alpha, les limites matérielles et les réserves liées à la préversion, consultez le test de GLM-5.3-Flash par AIReiter.
Le meilleur choix selon le workload
| Si votre priorité est… | Choisissez | Pourquoi |
|---|---|---|
| Transformer une capture d’écran en code, inspecter une interface, traiter des vidéos ou des fichiers | GLM-5.3-Flash | Les images, vidéos et fichiers sont pris en charge nativement par un seul modèle |
| Traiter en masse du texte avec un taux élevé de cache hits | DeepSeek V4 Flash | Un tarif officiel plus bas pour les entrées mises en cache, surtout en heures creuses |
| Gérer un trafic riche en nouvelles entrées et en sorties pendant la promotion de GLM | GLM-5.3-Flash | Les tarifs promotionnels des entrées et des sorties sont inférieurs aux tarifs officiels de DeepSeek pour les cache misses et les sorties |
| Utiliser un agent de code intensif en terminal avec un choix de production prudent | DeepSeek V4 Flash | Une route publique versionnée en bêta et des résultats d’évaluation Flash officiels |
| Faire fonctionner des agents visuels dans un navigateur ou sur un ordinateur | GLM-5.3-Flash | Les retours visuels restent intégrés à la boucle de codage ou d’utilisation des outils |
| Exploiter un contexte texte de 1M tokens | Aucun des deux par défaut | Les deux annoncent un contexte de l’ordre de 1M ; testez la récupération à la taille réelle de vos prompts |
| Utiliser un seul modèle pour mélanger texte, code et images | GLM-5.3-Flash | Le parcours multimodal principal ne nécessite pas d’endpoint de vision séparé |
Ce que disent réellement les spécifications officielles
La documentation des modèles Z.AI et la page tarifaire de Z.AI détaillent le modèle et la facturation de GLM. La documentation Models & Pricing de DeepSeek ainsi que son journal des changements fournissent les informations correspondantes sur la version Flash et ses fonctionnalités.
| Spécification | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| Identifiant du modèle API | glm-5.3-flash | deepseek-v4-flash |
| Version publiée | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| Fenêtre de contexte | 1M tokens | 1M tokens |
| Sortie maximale indiquée par la documentation officielle | 128K tokens | 384K tokens |
| Types d’entrées principaux | Texte, images, vidéos et fichiers | Texte et code ; la vision passe par un modèle expérimental distinct |
| Sortie | Texte | Texte |
| Contrôle du raisonnement | Mode Thinking activé ; reasoning_effort pris en charge | Modes Thinking et non-Thinking ; niveaux d’effort low, high et max |
| Outils et sorties structurées | Appels de fonctions, streaming, mise en cache du contexte et sortie JSON | Appels d’outils, sortie JSON, Responses API et compatibilité avec l’Anthropic API |
| Poids | Poids ouverts publiés par le fournisseur | Poids ouverts publiés par le fournisseur |
Les 320B paramètres totaux et 18B paramètres actifs de GLM décrivent une architecture à experts clairsemés, pas un checkpoint local de 18B ; la page tarifaire officielle de DeepSeek ne publie pas de nombre de paramètres comparable pour Flash.
GLM accepte les entrées visuelles dans le parcours principal du modèle. DeepSeek propose de son côté deepseek-v4-flash-vision-exp séparément, ce qui modifie les hypothèses de routage et de test.
Code et agents : deux tests bien distincts
Les agents de terminal évaluent l’exécution dans un dépôt et l’utilisation des outils. Les agents visuels doivent en plus interpréter des interfaces rendues et des états graphiques.
Travail dans le terminal et les dépôts
Le tableau de lancement de Z.ai et la mise à jour officielle du 31 juillet de DeepSeek rapportent les résultats suivants :
| Benchmark | GLM-5.3-Flash | DeepSeek V4 Flash | Statut des résultats |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | Évaluations rapportées séparément par les fournisseurs |
| DeepSWE | 63.4 | 54.4 | Évaluations rapportées séparément par les fournisseurs |
| Toolathlon Verified | 78.4 | 70.3 | Évaluations rapportées séparément par les fournisseurs |
| AutomationBench | 48.8 | 25.1 | Évaluations rapportées séparément par les fournisseurs |
| Agents’ Last Exam | 26.3 | 25.2 | Évaluations rapportées séparément par les fournisseurs |
GLM arrive en tête de ces benchmarks rapportés par les fournisseurs, mais les différences de harness invitent à s’en servir pour établir une présélection, pas pour trancher définitivement.
Les résultats indépendants rendent le verdict moins catégorique. Dans son test du 27 août portant sur 30 tâches d’agent en plusieurs étapes, Composio indique que 21/30 tâches ont été menées à bien par GLM-5.3-Flash, contre 20/30 pour DeepSeek V4 Flash. DeepSeek a été le plus rapide sur 19 tâches sur 30, avec un coût annoncé par tâche réussie d’environ $0.028 pour DeepSeek contre environ $0.06 pour GLM. Ces chiffres proviennent du test de Composio, et non de l’un ou l’autre fournisseur.
Pour les agents très dépendants du terminal, commencez par DeepSeek V4 Flash si la vitesse, la reproductibilité et une première route de production défendable sont prioritaires. Ajoutez GLM si la qualité de réparation au premier passage ou un comportement plus large avec les outils mérite d’être comparé à ce coût inférieur.
Outils, états du navigateur et retours visuels
GLM est mieux adapté lorsqu’un agent doit inspecter le résultat produit par son propre code. Z.ai décrit une boucle dans laquelle le modèle lit des captures d’écran ou des interfaces rendues, modifie l’implémentation, puis vérifie à nouveau le résultat. Ce fonctionnement couvre notamment le passage de captures d’écran au code, le débogage frontend, l’utilisation d’un navigateur, les documents et certains workflows 3D.
DeepSeek peut gérer les agents de texte et de code via deepseek-v4-flash ; les entrées visuelles nécessitent la route séparée deepseek-v4-flash-vision-exp. Si votre pipeline dispose déjà d’un routage vision, cette séparation peut être acceptable. En revanche, si l’agent alterne entre code source, capture d’écran d’un navigateur et vidéo sans changer d’endpoint, GLM est plus simple à intégrer. Le guide de l’API DeepSeek V4 Flash Vision Exp détaille cette alternative.
Ce que rapportent les utilisateurs après les benchmarks
Les retours de la communauté décrivent plutôt un compromis qu’un vainqueur universel. Un utilisateur ayant testé GLM intensivement pendant deux jours le juge performant sur les contextes plus modestes, mais moins stable à mesure que le prompt s’allonge ; il souligne en revanche la prise en charge des images :
« Quand le contexte grossit, il commence à paniquer et à travailler de façon brouillonne. » — @XBToshi, après deux jours d’utilisation intensive de GLM-5.3-Flash dans une comparaison publiée
Il s’agit d’un témoignage, pas d’un taux d’échec. Il met néanmoins en évidence un comportement que les tableaux de benchmarks ne montrent pas : une grande fenêtre de contexte ne garantit pas la stabilité d’un agent au fil des échanges.
Une petite expérience avec Ollama a également donné l’avantage à DeepSeek sur les unités de quota propres au fournisseur, mais son auteur ne les a pas assimilées à un coût API en dollars.
La latence et les données de serving peuvent changer le verdict
Aucune comparaison p50 de latence ou de débit réalisée avec un harness identique n’est publiée pour ces modèles précis ; ne transposez pas les résultats de Pro, Vision-Exp ou d’autres routes. Composio a trouvé DeepSeek plus rapide sur 19/30 tâches d’agent, ce qui constitue un signal utile, mais pas une mesure de débit. Mesurez le temps nécessaire pour obtenir le premier appel d’outil utile dans les assistants interactifs, puis le temps total jusqu’à l’obtention d’un résultat accepté pour les traitements par lots.
Le prix au token ne dit pas tout du coût par tâche réussie
Les grilles tarifaires officielles livrent un résultat plus nuancé que « DeepSeek est moins cher ». Z.AI affiche une promotion de 50 % sur GLM-5.3-Flash jusqu’au September 9, 2026 at 24:00 UTC+8. DeepSeek distingue de son côté les cache hits et les cache misses, avec des tarifs différents selon les heures pleines et les heures creuses.
Tous les montants ci-dessous sont exprimés en dollars américains par million de tokens.
| Élément facturé | Promotion GLM-5.3-Flash | Tarif catalogue GLM-5.3-Flash | DeepSeek V4 Flash, heures creuses | DeepSeek V4 Flash, heures pleines |
|---|---|---|---|---|
| Entrée nouvelle/cache miss | $0.075 | $0.15 | $0.22 | $0.44 |
| Entrée mise en cache | $0.015 | $0.03 | $0.007 | $0.014 |
| Sortie | $0.25 | $0.50 | $0.66 | $1.32 |
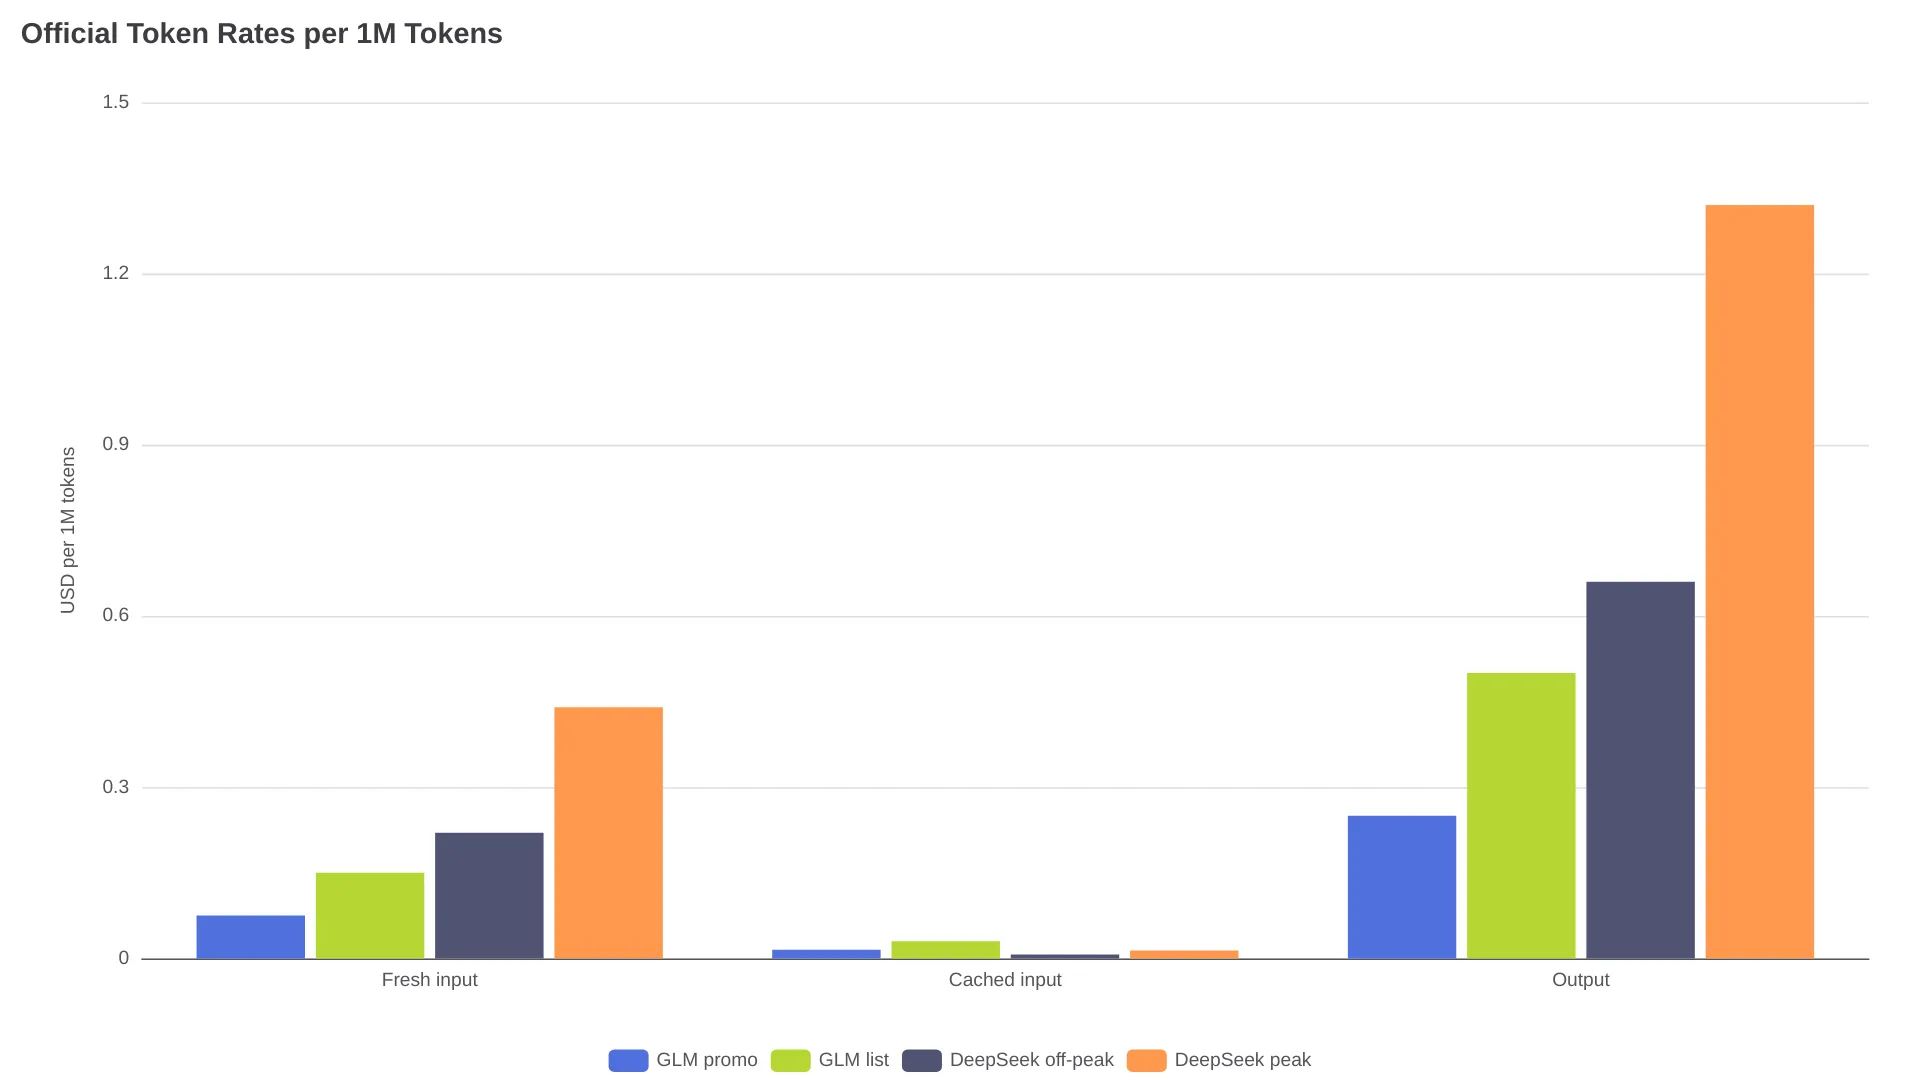
Les créneaux de pointe de DeepSeek sont 01:00–04:00 UTC et 06:00–10:00 UTC, du lundi au vendredi ; tous les autres horaires sont considérés comme creux. Son tableau officiel indique également une capacité de 2,500 requêtes simultanées pour V4 Flash. La page tarifaire de GLM mentionne un stockage des entrées mises en cache temporairement gratuit, mais ne fournit pas de nombre universel de requêtes simultanées.
- DeepSeek est moins cher pour les entrées mises en cache sur chaque période correspondante.
- La promotion de GLM est plus avantageuse pour les nouvelles entrées et les sorties que les tarifs officiels de DeepSeek pour les cache misses et les sorties.
- Une fois la promotion terminée, les tarifs catalogue de GLM pour les nouvelles entrées et les sorties resteront inférieurs aux tarifs de DeepSeek indiqués pour les heures creuses.
- Le meilleur cas de figure tarifaire pour DeepSeek concerne un trafic riche en cache hits, dominé par les entrées et générant peu de sorties, surtout s’il peut être planifié en heures creuses.
Exemple avec 10M tokens en entrée et 2M en sortie
Partons sur 10 millions de tokens d’entrée nouvelle et 2 millions de tokens de sortie, sans frais d’outils ni nouvelles tentatives :
| Modèle et mode de facturation | Calcul | Total |
|---|---|---|
| Promotion GLM | 10 × $0.075 + 2 × $0.25 | $1.25 |
| Tarif catalogue GLM | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek, heures creuses, cache miss | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek, heures pleines, cache miss | 10 × $0.44 + 2 × $1.32 | $7.04 |
Si les 10 millions de tokens d’entrée sont tous des cache hits, le total de DeepSeek en heures creuses passe à $1.39 (10 × $0.007 + 2 × $0.66), tandis que le total promotionnel de GLM devient $0.65 (10 × $0.015 + 2 × $0.25). L’avantage du cache de DeepSeek devient plus important lorsque le ratio entre les entrées et les sorties est nettement plus élevé et que les sorties sont courtes.
Quand la facture plus basse de DeepSeek fait la différence
Choisissez DeepSeek V4 Flash si la plupart des requêtes réutilisent un long préfixe système ou de dépôt stable, produisent des réponses courtes et peuvent être exécutées en dehors des heures pleines. La classification, l’extraction, le résumé et l’automatisation textuelle courante correspondent mieux à ce profil que les agents pilotés par captures d’écran.
Quand les capacités supplémentaires de GLM peuvent réduire le coût global
GLM peut réduire le coût d’un pipeline lorsqu’une image, un document ou une vidéo nécessiterait autrement une requête de vision séparée. Son tarif promotionnel de sortie compte également pour les agents qui génèrent de longs patchs de code. Vérifiez cette hypothèse avec les tokens réellement facturés, le nombre de boucles de correction et le taux de tâches acceptées, plutôt que de supposer un avantage universel sur le coût par tâche.
Un long contexte indique une capacité, pas une garantie de qualité
Les deux documentations officielles annoncent une fenêtre de contexte de 1M tokens : sur ce seul critère, égalité. DeepSeek indique une sortie maximale de 384K ; la documentation de Z.AI mentionne une sortie maximale de 128K pour GLM-5.3-Flash. Cette différence ne compte que pour les applications qui autorisent des générations exceptionnellement longues.
Z.ai annonce une réduction de 3.01× du calcul d’attention et une réduction de 4.44× de la taille du KV-cache par rapport à GLM-5.3, tout en précisant que le KV-cache de GLM reste légèrement supérieur à celui de DeepSeek V4 Flash. Ces affirmations du fournisseur ne suffisent pas à établir un avantage de latence ou de qualité de récupération face à DeepSeek.
Testez la récupération, l’exécution des outils et le taux de tâches acceptées à 50K, 200K et à la taille maximale réelle de vos prompts, en appliquant la règle d’acceptation définie dans la procédure ci-dessous.
Choisir un modèle par défaut ou répartir les workloads
| Workload | Premier modèle à tester | Solution de repli ou escalade |
|---|---|---|
| Classification et extraction textuelles | DeepSeek V4 Flash | GLM si le formatage ou la qualité ne suivent pas |
| Chat sur dépôt avec un cache très sollicité | DeepSeek V4 Flash | GLM pour les corrections difficiles |
| Agent de code dans le terminal | DeepSeek V4 Flash | GLM lorsque la réussite au premier passage est prioritaire |
| Passage d’une capture d’écran au code | GLM-5.3-Flash | DeepSeek pour les étapes de suivi uniquement textuelles |
| Agent de navigation ou d’utilisation d’un ordinateur | GLM-5.3-Flash | DeepSeek pour les étapes de planification non visuelles |
| Analyse fondée sur des vidéos, images ou fichiers | GLM-5.3-Flash | DeepSeek Vision Exp si une route séparée est acceptable |
| Texte long avec sortie courte | DeepSeek V4 Flash | GLM si la récupération se dégrade |
| Génération de code longue pendant la promotion | GLM-5.3-Flash | DeepSeek si l’économie liée aux cache hits domine |
Avant de basculer un workload de production, effectuez un petit test avec un harness identique :
- Figez les identifiants exacts :
glm-5.3-flashetdeepseek-v4-flash; empêchez le routeur de remplacer silencieusement ces modèles par Pro ou Vision-Exp. - Utilisez 20–50 tâches réelles couvrant à la fois les jobs réussis et les échecs récents. Ajoutez au moins cinq tâches faisant appel à des outils si le produit fonctionne comme un agent.
- Mesurez le taux de réussite, les boucles de correction, les appels d’outils manquants, le temps avant la première action utile, le volume total de tokens en entrée et en sortie ainsi que le taux de cache hits.
- Comparez le coût par tâche acceptée, puis conservez l’autre modèle en solution de repli jusqu’à stabilisation des taux d’expiration et d’échec.
Le guide de démarrage rapide de Z.AI et le guide du premier appel API de DeepSeek documentent l’accès compatible avec OpenAI ; leurs contrôles de raisonnement, routes de vision et règles de facturation ne sont pas identiques.
Les questions que se posent encore les acheteurs
GLM-5.3-Flash est-il le même modèle qu’Ox Alpha ?
Z.ai a officiellement identifié GLM-5.3-Flash comme le modèle testé anonymement sous le nom Ox Alpha. Le routage, les quotas et le comportement des endpoints en préversion ne doivent pas être considérés comme les spécifications définitives du modèle public.
Utilisez le tableau de routage, puis validez votre choix par défaut avec des identifiants épinglés, de vrais cas d’échec et un harness identique. Le test de GLM-5.3-Flash revient sur l’identité du modèle et les éléments de déploiement ; le guide de l’API DeepSeek V4 Flash Vision Exp détaille la route visuelle séparée.