 AIREITER
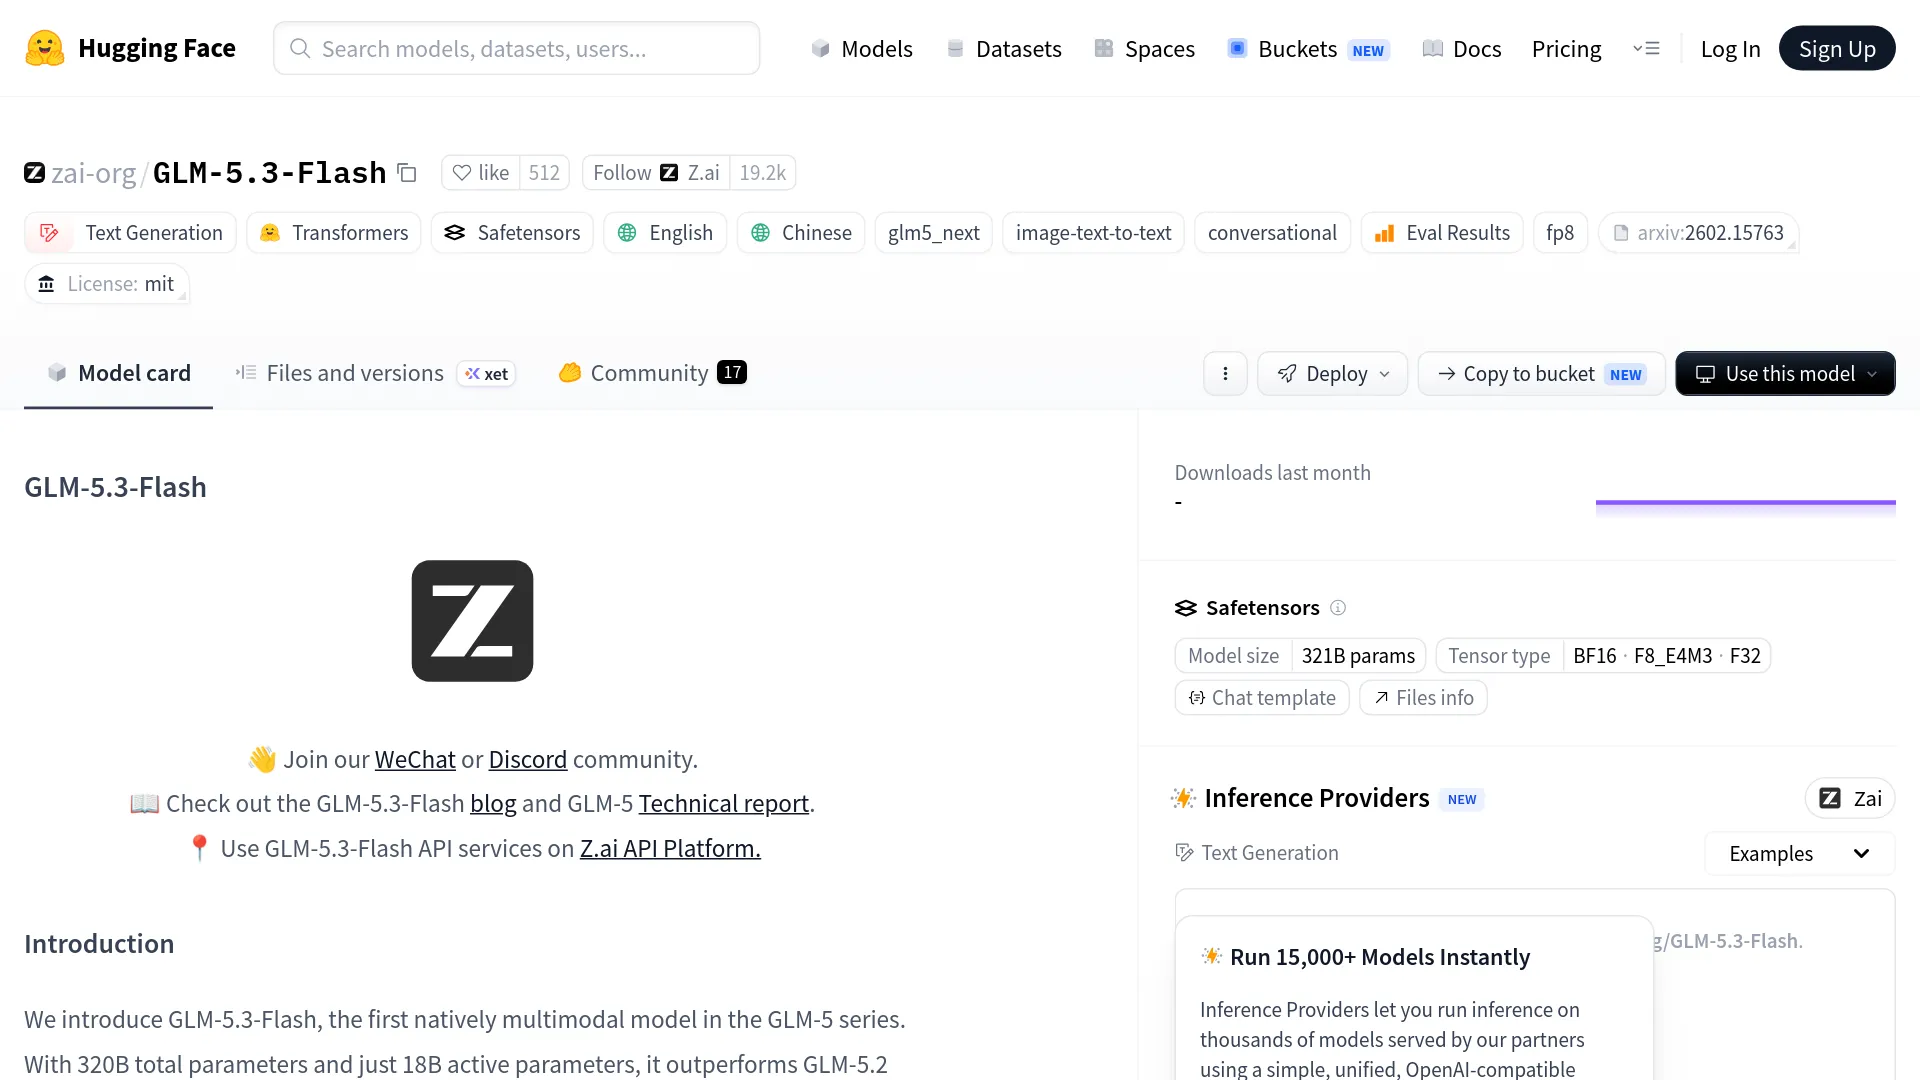
Avant son lancement officiel, un modèle anonyme circulait sous le nom d’Ox Alpha. Z.ai vient de lever le voile : il s’agit de GLM-5.3-Flash. Le nom est désormais clair, mais son suffixe « Flash » mérite quelques précautions : le modèle n’active que 18B paramètres par token, alors que le checkpoint complet atteint environ 320B paramètres et reste très exigeant à faire tourner en local.
En bref : Ox Alpha était l’aperçu de GLM-5.3-Flash
Dans son annonce du 26 août 2026, Z.ai confirme que GLM-5.3-Flash est le modèle qui avait été présenté anonymement sous le nom d’Ox Alpha sur OpenCode et OpenRouter. La fiche officielle sur Hugging Face référence désormais le checkpoint public, sa licence MIT, les entrées multimodales et les solutions de déploiement local.
Les retours concernant Ox Alpha doivent donc être considérés comme des indices issus d’une préversion, et non comme les spécifications définitives du modèle commercialisé. Ox Alpha disposait de son propre routage, de ses propres conditions de trafic et de son environnement opérationnel. Les premières observations sur la vitesse, les quotas ou les règles d’utilisation ne s’appliquent donc pas forcément à tous les endpoints GLM-5.3-Flash.
« Pour moi, ça ne change rien. Les deux modèles sont bien trop gros pour mon système équipé de 32 Go de RAM. » — u/dampflokfreund sur r/LocalLLaMA
GLM-5.3-Flash en un coup d’œil
| Caractéristique | GLM-5.3-Flash |
|---|---|
| Sortie officielle | 26 août 2026 |
| Nom de la préversion | Ox Alpha / ox-alpha |
| Architecture | 320B paramètres au total, 18B actifs par token |
| Fenêtre de contexte | 1 048 576 tokens (1M) |
| Entrées | Texte, images et vidéo |
| Sorties | Texte |
| Licence | MIT |
| Checkpoint officiel | zai-org/GLM-5.3-Flash |
| Tarif API affiché, entrée | 0,15 $ par million de tokens |
| Tarif API affiché, entrée mise en cache | 0,03 $ par million de tokens |
| Tarif API affiché, sortie | 0,50 $ par million de tokens |
La page Hugging Face indique une taille stockée d’environ 321B paramètres, tandis que la description du modèle utilise l’appellation abrégée 320B-A18B. Ces chiffres ne parlent pas de la même chose : le premier décrit la capacité totale stockée, le second le volume de calcul activé pour chaque token. Les 18B paramètres actifs ne transforment donc pas le checkpoint en modèle local de 18B.
Ce qui change entre Ox Alpha et le modèle public
Z.ai explique avoir fait fonctionner GLM-5.3-Flash de manière anonyme sous le nom d’Ox Alpha avant sa sortie publique, notamment via OpenCode et OpenRouter, afin de recueillir des retours en conditions réelles. La fiche OpenRouter présentait alors une préversion multimodale dotée d’un long contexte et temporairement gratuite. La version publique permet désormais d’identifier clairement le fournisseur, le checkpoint et la licence.
La préversion et le modèle final restent toutefois deux environnements opérationnels distincts. Une correspondance de tokenizer ou une erreur d’API caractéristique de GLM peut suggérer une filiation, mais ne permet pas d’affirmer que chaque requête anonyme utilisait les poids finaux ou la même couche de routage. Pour le déploiement et la reproductibilité, le checkpoint public constitue désormais la référence.
Ce que cache l’appellation « Flash »
GLM-5.3-Flash associe une architecture sparse mixture-of-experts à des évolutions de l’attention destinées à réduire le coût des contextes très longs. Z.ai annonce 320B paramètres au total, 18B paramètres actifs, 45 couches, une attention hybride sparse et linéaire, IndexPool pour la recherche, ainsi que les Manifold-Constrained Hyper-Connections (mHC). La fiche du modèle attribue également son entraînement à un corpus multimodal de préentraînement de 30T tokens.
Par rapport à GLM-5.3, Z.ai revendique 3 fois moins de calcul d’attention et un cache KV réduit de 4,4 fois avec un contexte de 1M. Il s’agit de caractéristiques annoncées par le fournisseur, pas d’une garantie de latence indépendante du matériel : la vitesse réelle dépend toujours de la longueur du contexte, du niveau de concurrence, du prétraitement visuel et de la pile de serving utilisée.
La multimodalité native du modèle prend surtout son sens dans les agents, plutôt que dans la simple promesse d’un « chatbot avec vision ». L’idée de Z.ai est de permettre à un agent d’examiner des interfaces rendues, des états de navigateur, des documents ou d’autres éléments visuels, puis d’ajuster son code ou sa production. La fiche officielle montre l’utilisation d’images, tandis que la documentation publique du modèle et du déploiement décrit également la prise en charge de la vidéo.
Ce que les benchmarks permettent vraiment de conclure
La sortie officielle et la fiche du modèle affichent de solides résultats, en particulier sur le code et les tâches d’agent. Parmi les scores visibles sur la fiche figurent 84,3 à TerminalBench 2.1, 63,4 à DeepSWE et 55,3 à HLE. Le communiqué de Z.ai mentionne aussi un score de 57 à l’Artificial Analysis Intelligence Index, 48,8 à AutomationBench et 29,0 à Z.ai Code Bench en mode d’effort maximal.
| Benchmark | GLM-5.3-Flash | Comparaison ou référence | Source et limite |
|---|---|---|---|
| TerminalBench 2.1 | 84,3 | GLM-5.2 : 81,0 ; Claude Opus 4.8 : 85,0 | Résultat Z.ai/fiche du modèle ; les harnais et budgets de calcul comptent |
| DeepSWE v1.1 | 63,4 | GLM-5.2 : 46,2 | Évaluation rapportée ; ne pas généraliser à tous les dépôts |
| AutomationBench | 48,8 | GLM-5.2 : 26,2 | Évaluation rapportée avec une version précise du benchmark |
| Z.ai Code Bench, effort maximal | 29,0 | Claude Opus 4.8 : 29,5 | Quasi-parité revendiquée dans les conditions de Z.ai |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.ai le juge comparable à Claude Opus 4.8 | Indice externe ; le mélange de tâches ne mesure pas uniquement le code |
Les résultats publiés reposent sur des harnais, limites de contexte, délais d’expiration et systèmes d’évaluation différents. Il vaut mieux les comparer comme des tendances que comme les positions d’un classement universel. La conclusion la plus solide est que GLM-5.3-Flash montre une amélioration crédible et importante par rapport à GLM-5.2 sur les évaluations d’agents de programmation, pas qu’il domine tous les modèles de pointe.
La même prudence s’impose pour les premiers tests de la communauté. @prz_chojecki a indiqué qu’Ox Alpha avait obtenu de meilleurs résultats que GLM-5.2 sur les 226 problèmes d’ErdosBench. C’est un signal intéressant pour construire des cas de test, mais pas un remplacement à une évaluation contrôlée avec vos propres outils et votre propre dépôt.
Les limites concrètes relevées par les premiers utilisateurs
« Flash » décrit plus sûrement le volume de calcul actif et le positionnement tarifaire que la latence ressentie. Dans les discussions de r/opencodeCLI, des utilisateurs ont fait état de très bons résultats en programmation, mais aussi d’attentes frustrantes, notamment pendant la préversion anonyme. Ces témoignages dépendent du fournisseur et de la charge de travail ; ils ne constituent pas des benchmarks officiels de latence.
« Comment peut-on l’appeler “Flash” s’il est beaucoup plus lent que le modèle principal ? » — u/ahriad sur r/opencodeCLI
Le signal opérationnel le plus intéressant concerne la fiabilité des agents sur de longues exécutions et sous charge. @solomonneas rapporte 30 compilations réussies sur 49 tentatives lors d’un test de sept jours, avec 14 échecs prenant la forme de délais d’expiration. Cela ne permet pas de déduire un taux d’échec fixe pour l’API officielle, mais justifie de prévoir une route de secours pour les tâches susceptibles de durer plusieurs heures.
Le déploiement local impose une autre limite que les gros titres des benchmarks passent facilement sous silence : le checkpoint officiel en FP8 pèse environ 306 GiB, avant même de compter le runtime et le cache KV. Un modèle de 320B paramètres nécessite donc une infrastructure dotée d’une mémoire importante, même si seuls 18B paramètres sont actifs pour chaque token.
API, accès hébergé et options de déploiement local
Pour l’utilisation hébergée, la page tarifaire de Z.ai affiche GLM-5.3-Flash à 0,15 $ par million de tokens en entrée, 0,03 $ par million de tokens d’entrée mis en cache et 0,50 $ par million de tokens en sortie. Une promotion temporaire de 50 % ramène ces tarifs à 0,075 $ en entrée, 0,015 $ pour l’entrée mise en cache et 0,25 $ en sortie, jusqu’au 9 septembre 2026 à 24 h 00, UTC+8. Consultez le tableau tarifaire officiel de Z.AI avant de prévoir votre budget, car cette promotion a une date de fin.
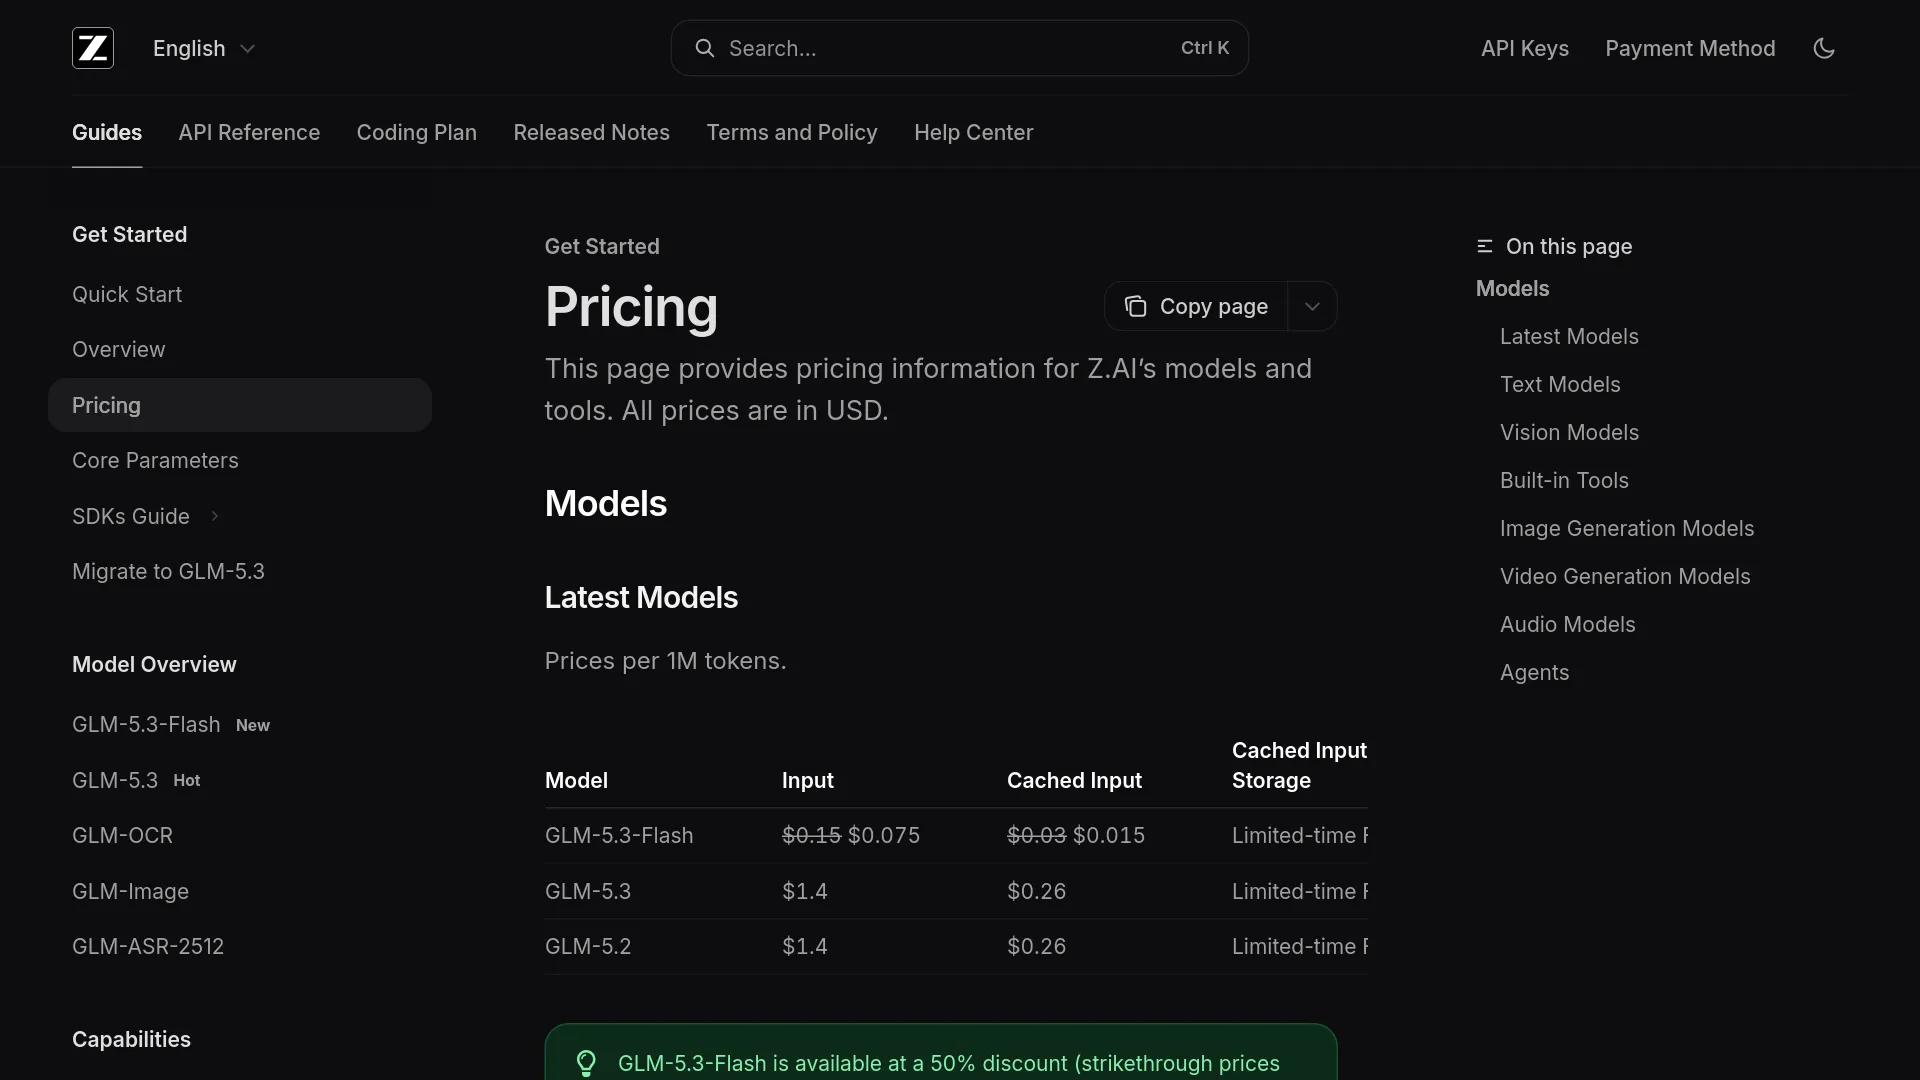
Le tarif public ne doit pas être confondu avec le prix temporaire de la préversion Ox Alpha. À titre d’exemple, 10M tokens en entrée et 2M tokens en sortie coûteraient 2,50 $ au tarif standard, avant d’éventuels frais supplémentaires du fournisseur : 10 × 0,15 $ + 2 × 0,50 $. La mise en cache peut réduire le coût de la partie entrée lorsque le fournisseur facture ces tokens comme des tokens déjà mis en cache.
Le déploiement local est possible, mais il relève davantage du projet d’infrastructure que du simple téléchargement sur un ordinateur portable. La recette vLLM officielle indique environ 306 GiB pour les poids FP8 et 386GB de VRAM pour le déploiement FP8 par défaut ; le BF16 est donné à 772GB. Le parcours officiellement pris en charge nécessite actuellement des GPU NVIDIA Hopper ou plus récents, une version récente de FlashInfer et une image vLLM dédiée, le temps que l’intégration arrive à maturité.
Le tutoriel KTransformers documente l’inférence hétérogène CPU-GPU, l’utilisation directe des poids FP8 officiels et un minimum de 350GB de mémoire système disponible. Son exemple avec un seul GPU repose sur une configuration avec déport, et ne signifie pas qu’un GPU grand public peut contenir le modèle à lui seul. Le tutoriel utilise également un réglage validé à 501 025 tokens et limite chaque requête multimodale à huit images ou une vidéo.
| Option de déploiement | Ce que la documentation prend en charge | Principale contrainte |
|---|---|---|
| API Z.ai | Accès hébergé facturé à l’usage ; tarifs standards et promotionnels publiés | Vérifier les limites de débit, les conditions régionales et la promotion en cours |
| vLLM | Serving FP8/BF16, endpoint compatible OpenAI, parallélisme tensoriel et parcours multimodal | Infrastructure NVIDIA à forte capacité mémoire ; la recette actuelle cible Hopper+ |
| KTransformers | Inférence hétérogène CPU-GPU et chargement FP8 | Environ 306 GiB de poids ; au moins 350GB de mémoire système recommandés |
| Écosystème Ollama/LM Studio/llama.cpp | La fiche du modèle renvoie vers des distributions quantifiées et des outils compatibles | La prise en charge des versions quantifiées et la vitesse dépendent du build utilisé |
À qui s’adresse GLM-5.3-Flash aujourd’hui ?
Pour les agents de programmation sensibles au coût et les projets pilotes d’ingénierie avec long contexte. Son tarif public bas, son contexte de 1M et les progrès annoncés par rapport à GLM-5.2 en font un candidat intéressant pour analyser des dépôts, modifier plusieurs fichiers, générer des tests et multiplier les appels d’agents. Conservez des tests d’acceptation et un modèle de secours tant que votre taux de réussite n’est pas stabilisé sur vos propres tâches.
Pour les usages techniques multimodaux lorsque les modèles GLM textuels atteignent leurs limites. Les entrées image et vidéo peuvent aider un agent à examiner le rendu d’un navigateur, des interfaces, des diagrammes, des documents ou d’autres artefacts visuels. Le modèle ne génère pas de vidéos : il raisonne sur des entrées visuelles et renvoie du texte ou du code.
Ne le choisissez pas simplement parce que « 18B actifs » évoque un modèle de bureau. Le checkpoint total représente environ 320B paramètres et le déploiement local nécessite des centaines de gigaoctets de stockage ou de mémoire, avant même le contexte et les coûts du runtime. L’API hébergée est généralement le choix économique le plus simple, sauf si vous disposez déjà d’une infrastructure d’inférence à forte capacité mémoire.
N’envoyez pas de code confidentiel à un endpoint de préversion non vérifié. La sortie publique de GLM-5.3-Flash est bien attribuée à Z.ai, mais les conditions du fournisseur, la conservation des données et le routage restent déterminants. Pour un trafic de production, consignez la politique actuelle de l’endpoint et utilisez l’API officielle ou un fournisseur dont les conditions d’exploitation peuvent être auditées.
FAQ
Ox Alpha est-il exactement le même modèle que GLM-5.3-Flash ?
Z.ai identifie officiellement GLM-5.3-Flash comme le modèle qui avait été proposé en préversion sous le nom d’Ox Alpha. Le comportement observé sur Ox Alpha reste un élément de contexte utile, mais le routage et les limites de la préversion ne doivent pas être considérés comme les spécifications du modèle public.
GLM-5.3-Flash est-il open source ?
Le checkpoint officiel publié sur Hugging Face est distribué sous licence MIT, et Z.ai fournit des références pour le déploiement local. « Poids ouverts » est la description opérationnelle la plus précise : les poids sont disponibles, mais faire fonctionner le modèle complet nécessite toujours une infrastructure conséquente.
De combien de mémoire GLM-5.3-Flash a-t-il besoin en local ?
Les poids officiels FP8 occupent environ 306 GiB, sans compter le runtime ni le cache KV. La recette vLLM indique 386GB de VRAM pour son déploiement FP8 par défaut, tandis que KTransformers recommande au moins 350GB de mémoire système pour l’inférence hétérogène.
L’API coûte-t-elle vraiment 0,15 $ par million de tokens en entrée ?
Oui. La page tarifaire officielle de Z.AI indique 0,15 $ pour l’entrée, 0,03 $ pour l’entrée mise en cache et 0,50 $ pour la sortie ; la promotion de 50 % est annoncée jusqu’au 9 septembre 2026, UTC+8.
GLM-5.3-Flash est-il plus rapide que les autres modèles Flash ?
Les éléments disponibles ne permettent pas d’établir un classement universel de la latence. Des utilisateurs ont signalé des sessions d’agents lentes ou interrompues par un délai d’expiration. Mesurez donc le délai avant le premier token, le temps total d’exécution, le nombre de relances et le taux de tâches acceptées sur votre propre route fournisseur.
GLM-5.3-Flash prend-il en charge les images et la vidéo ?
Oui. Z.ai et la fiche officielle du modèle décrivent des entrées texte, image et vidéo, avec une sortie textuelle. La documentation de déploiement local précise aussi certaines limites, comme huit images ou une vidéo au maximum dans la configuration KTransformers documentée.
Privilégiez l’API hébergée si vous voulez profiter du coût et de la multimodalité de GLM-5.3-Flash sans acheter une machine d’inférence équipée de plusieurs centaines de gigaoctets de mémoire. Le déploiement local ne mérite d’être testé que si cette infrastructure existe déjà. Pour les tâches d’agents longues, gardez un modèle de secours éprouvé : les éléments publics sont plus convaincants sur les capacités et le prix que sur la fiabilité interactive dans la durée.