 AIREITER
Vous cherchez une alternative à GLM-5-3-Flash ? Le sujet n’est probablement plus de décortiquer la révélation d’Ox Alpha, mais de remplacer une route d’agent peu coûteuse, parfois lente, d’éviter un checkpoint local de 320B ou de conserver vos usages multimodaux sans réécrire votre client API. Le bon choix dépend surtout du problème à résoudre.
En bref : choisissez selon le défaut à corriger
DeepSeek V4 Flash est la route texte polyvalente à privilégier lorsque le prix des tokens en cache, le mode non-réflexif optionnel et une forte concurrence sont importants. Le modèle offre un contexte de 1M tokens, une limite de concurrence de 2 500 requêtes et, en heures creuses, un tarif officiel de $0.22 par million de tokens d’entrée non mis en cache et $0.66 par million de tokens de sortie.
Qwen3.8-Flash est la solution hébergée à tester si vous avez besoin d’entrées image et vidéo, d’une compatibilité API et d’outils intégrés. Son tarif affiché est de $0.15 par million de tokens d’entrée et $0.47 par million de tokens de sortie.
GLM-5.3 constitue l’escalade logique au sein de la même famille si vous souhaitez rester chez Z.ai tout en passant à son modèle texte haut de gamme. GPT-5.6 Terra et Claude Opus 4.8 sont des options premium pour les tâches où obtenir un résultat correct justifie de payer plusieurs fois plus cher. Kimi K3 apporte une capacité de contexte de 1M, mais ne constitue pas un remplacement économique.
La vraie question n’est pas « quel modèle gagne ? », mais ce que vous cherchez à optimiser : le coût des tokens, les entrées visuelles, le développement sur de longues séquences, le contrôle local ou le taux de tâches acceptées.
L’endpoint Ox Alpha a disparu : commencez par identifier votre situation de migration
L’annonce officielle de Z.ai a identifié l’aperçu anonyme Ox Alpha comme étant GLM-5.3-Flash le 26 août 2026. La sortie publique a ajouté un checkpoint nommé, une tarification publiée, un modèle Hugging Face sous licence MIT et un accès API documenté. L’ancien environnement de prévisualisation ne doit pas être considéré comme un contrat modèle permanent : le routage, les quotas, la latence et le comportement en matière de politiques peuvent différer de ceux de l’API commercialisée.
Si une configuration appelle encore stealth/ox-alpha, l’identifiant public sur OpenRouter est z-ai/glm-5.3-flash ; les requêtes directes vers Z.ai utilisent l’URL de base générale https://api.z.ai/api/paas/v4. Z.ai documente aussi un endpoint distinct pour son Coding Plan, https://api.z.ai/api/coding/paas/v4 : ne partez donc pas du principe que cet abonnement et l’API générale appliquent exactement la même facturation ou les mêmes limites.
L’article d’AIReiter consacré à GLM-5.3-Flash détaille la base de comparaison, notamment la différence entre les 18B paramètres actifs et le checkpoint total d’environ 320B paramètres. Ici, la question est la suivante : par quoi le remplacer lorsque son coût, sa vitesse, le matériel requis ou sa fiabilité ne correspondent plus à vos besoins ?
« Pour moi, ça ne change rien. Les deux modèles sont bien trop gros pour mon système doté de 32 Go de RAM. » — u/dampflokfreund, r/LocalLLaMA
Comparatif des alternatives : prix, contexte et mode de déploiement
Les tarifs ci-dessous correspondent aux prix affichés par les fournisseurs et vérifiés le 28 août 2026. Il ne s’agit pas d’une promotion uniforme : DeepSeek fait varier ses tarifs entre les heures pleines et creuses, tandis que le prix Flash de Z.ai intègre une remise temporaire valable jusqu’au 9 septembre 2026 à 24:00 UTC+8.
| Modèle | Entrée / 1M tokens | Sortie / 1M tokens | Contexte | Modalités d’entrée | Raison principale pour le choisir |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | $0.22 heures creuses ; $0.44 heures pleines | $0.66 heures creuses ; $1.32 heures pleines | 1M | Texte | Routage texte sensible au cache et mode non-réflexif |
| Qwen3.8-Flash | $0.15 | $0.47 | 1M | Texte, image, vidéo | Multimodalité hébergée et compatibilité API |
| GLM-5.3 | $1.40 | $4.40 | 1M | Texte | Même fournisseur, modèle plus capable dans la gamme |
| GPT-5.6 Terra | $2.00 | $12.00 | 1.05M | Texte | Travail d’agent complexe nécessitant davantage de fiabilité |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Texte | Développement exigeant et analyse de longs contextes |
| Kimi K3 | $3.00 | $15.00 | 1M | Texte | Tâches nécessitant de longues fenêtres de contexte |
Z.ai affiche actuellement GLM-5.3-Flash à $0.075 en entrée, $0.015 pour l’entrée mise en cache et $0.25 en sortie par million de tokens pendant sa promotion de 50 %. Les tarifs catalogue sont de $0.15, $0.03 pour l’entrée en cache et $0.50. Le graphique comparatif utilise le tarif catalogue, et non le prix promotionnel temporaire. (Tarifs Z.ai)
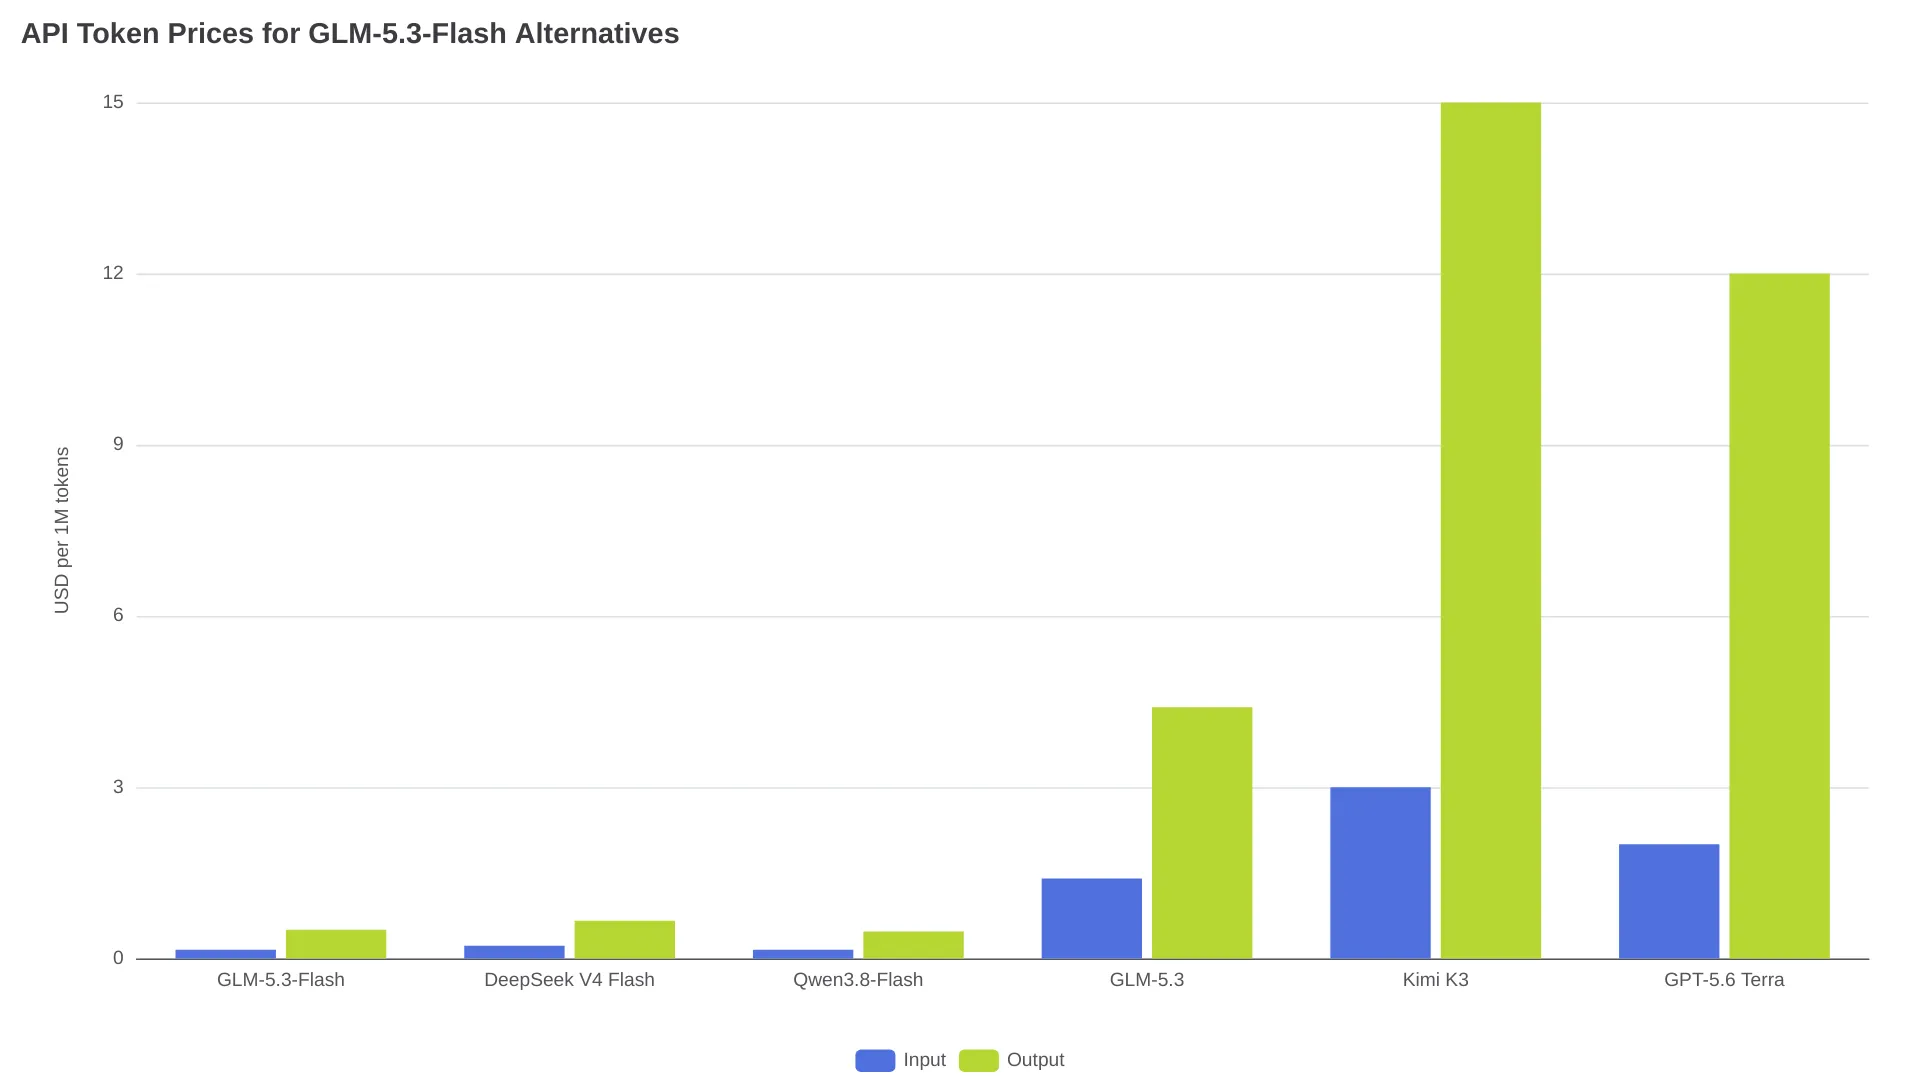
Base de comparaison : tarif catalogue de GLM-5.3-Flash, tarif officiel de DeepSeek V4 Flash en heures creuses et tarifs actuellement affichés par les fournisseurs pour les autres modèles. Le tarif de DeepSeek en heures pleines est deux fois supérieur à celui des heures creuses.
Les six remplaçants réellement pertinents
DeepSeek V4 Flash : la route texte et code qui exploite le cache
DeepSeek V4 Flash est le premier modèle à tester si GLM-5.3-Flash coûte trop cher pour votre trafic texte courant. DeepSeek annonce un contexte de 1M tokens, une sortie maximale de 384K, la sortie JSON, les appels d’outils, l’API Responses et un accès compatible avec Anthropic. Sa limite officielle de concurrence est de 2 500 requêtes.
La différence de facturation est importante. DeepSeek distingue les accès au cache des requêtes sans cache et double ses tarifs pendant les créneaux de pointe en semaine, de 01:00–04:00 et de 06:00–10:00 UTC. Le modèle propose également des modes réflexif et non-réflexif, alors que la fiche du modèle GLM-5.3-Flash documente des niveaux d’effort de raisonnement low, high et max, sans véritable mode simple dépourvu de réflexion.
Choisissez DeepSeek V4 Flash pour les charges à contexte répétitif, les conversations fortement basées sur la récupération d’informations et le code texte où le cache ou le contrôle du raisonnement ont de la valeur. Qwen3.8-Flash affiche des tarifs inférieurs sur les tokens frais : DeepSeek n’est donc pas automatiquement le choix le moins cher pour chaque requête texte. Ce n’est pas non plus un remplaçant visuel direct : les entrées image passent par la route DeepSeek distincte deepseek-v4-flash-vision-exp, et les tokens issus des images sont facturés comme des tokens d’entrée.
Qwen3.8-Flash : le substitut multimodal hébergé le plus proche
Qwen3.8-Flash est l’alternative hébergée la plus proche à tester si votre agent envoie des captures d’écran, des graphiques ou des vidéos et que vous souhaitez conserver une intégration structurée comme une API classique. QwenCloud annonce des entrées image, texte et vidéo, un contexte de 1M tokens, un maximum de 991K tokens en entrée et de 131K en sortie. Le modèle prend en charge les API compatibles OpenAI et Anthropic, les outils, les sorties structurées, le cache, les traitements par lots, la recherche web et le fine-tuning.
Le compromis opérationnel concerne sa gestion du cache. QwenCloud affiche les lectures de cache implicite à $0.016 par million de tokens, la création de cache explicite à $0.20 et la sortie à $0.47. Les limites publiées sont de 2M tokens par minute et 15 000 requêtes par minute, mais la page ne précise pas si elles s’appliquent au compte, à la clé, à l’organisation ou au déploiement.
Retenez Qwen3.8-Flash lorsque les entrées visuelles sont essentielles ou que le prix des tokens frais compte. La page officielle du modèle ne fournit ni tableau de benchmarks nommé, ni mesure de latence, ni étude de fiabilité sur de longues sessions. Validez donc ses performances sur vos propres traces d’agents au lieu de supposer qu’une parité fonctionnelle garantit une parité comportementale.
GLM-5.3 : l’escalade dans la même famille lorsque Flash atteint ses limites
GLM-5.3 n’est pas l’alternative économique. C’est l’escalade logique lorsque le problème vient d’un manque de profondeur sur des tâches texte, et non du prix ou de la multimodalité. La grille tarifaire de Z.ai affiche $1.40 par million de tokens d’entrée, $0.26 pour l’entrée mise en cache et $4.40 par million de tokens de sortie, soit environ un ordre de grandeur de plus que le tarif catalogue de Flash.
Z.ai présente GLM-5.3 comme son modèle de pointe pour le code, tandis que GLM-5.3-Flash est le modèle multimodal natif à moindre coût. Utilisez GLM-5.3 de manière ciblée pour les tâches texte difficiles ; ce changement peut vous faire perdre le flux visuel qui rendait Flash intéressant.
GPT-5.6 Terra : pour des agents plus fiables dans l’exécution
GPT-5.6 Terra est une option premium destinée aux équipes qui privilégient la réussite des tâches complexes au faible coût des tokens. OpenAI affiche $2 par million de tokens d’entrée, $0.20 pour l’entrée mise en cache et $12 par million de tokens de sortie, avec une fenêtre de contexte d’environ 1.05M tokens. Dans le tableau de benchmarks publié par Z.ai, GPT-5.6 Terra obtient 87.4 sur Terminal-Bench 2.1 et 69.6 sur DeepSWE v1.1, contre 84.3 et 63.4 pour GLM-5.3-Flash dans les configurations citées.
Ces résultats justifient de tester Terra lorsqu’un échec de tâche de code coûte plus cher qu’une facture API élevée ; ils ne démontrent pas une supériorité universelle en production. Utilisez-le comme niveau d’escalade pour les modifications de dépôts à forte valeur ou les travaux autonomes complexes.
Claude Opus 4.8 : pour le code difficile et l’analyse de longs contextes
Claude Opus 4.8 coûte $5 par million de tokens d’entrée et $25 par million de tokens de sortie selon la tarification mondiale standard d’Anthropic. Anthropic affiche également les lectures de cache à $0.50 par million de tokens et les tarifs batch à la moitié du prix standard, en entrée comme en sortie.
Dans le tableau comparatif de Z.ai, Opus 4.8 devance GLM-5.3-Flash sur Terminal-Bench 2.1, Agents’ Last Exam, HLE with Tools et NL2Repo, tandis que Flash prend l’avantage sur plusieurs lignes axées sur les outils et l’automatisation. Cette répartition fait d’Opus un modèle d’escalade à évaluer au cas par cas, plutôt qu’un choix universel par défaut.
Kimi K3 : pour les tâches nécessitant 1M de contexte, pas pour réduire les coûts
Kimi K3 mérite sa place ici pour une autre raison de changer de modèle : vous pouvez avoir besoin d’une route avec 1M de contexte pour de longs workflows de développement logiciel ou de recherche. Kimi affiche $0.30 par million de tokens d’entrée mis en cache, $3 en entrée et $15 en sortie.
À ces tarifs, choisissez Kimi K3 uniquement si son contexte et son profil de capacités justifient le surcoût. Ce n’est pas la réponse à la question « comment réduire ma facture de tokens ? »
Choisissez selon votre charge de travail, pas selon le classement des benchmarks
| Charge de travail ou contrainte | Premier modèle à tester | Pourquoi |
|---|---|---|
| Classification ou extraction de texte en volume | Qwen3.8-Flash | Tarifs affichés inférieurs en entrée et en sortie sur les tokens frais par rapport à DeepSeek V4 Flash en heures creuses |
| Longs textes avec préfixes répétés | DeepSeek V4 Flash | Tarification des accès au cache et mode non-réflexif optionnel |
| Longs textes avec surtout des entrées fraîches | Qwen3.8-Flash | Tarifs affichés inférieurs sur les tokens frais |
| Captures d’écran, graphiques ou vidéos dans un workflow API | Qwen3.8-Flash | Entrées image et vidéo natives, avec des protocoles API familiers |
| Même écosystème Z.ai, mais raisonnement texte plus exigeant | GLM-5.3 | Conserve le fournisseur tout en passant au niveau supérieur de la gamme |
| Code pour lequel l’échec coûte cher | GPT-5.6 Terra | Escalade premium avec de meilleurs scores de code dans les résultats cités |
| Revue de code minutieuse ou planification de dépôt | Claude Opus 4.8 | Raisonnement premium, avec options de cache et de traitement par lots |
| Travail au long cours où le contexte prime sur le prix | Kimi K3 | Positionnement axé sur une capacité de contexte de 1M |
| Ordinateur portable courant ou station de travail avec 32 Go de RAM | API hébergée en premier | GLM-5.3-Flash est un checkpoint d’environ 320B paramètres au total, pas un modèle local de 18B |
La contrainte du déploiement local est importante. Le checkpoint officiel de GLM-5.3-Flash est décrit comme totalisant environ 320B paramètres ; la revue de déploiement d’AIReiter relève une empreinte FP8 d’environ 306 Gio et un déploiement vLLM par défaut nécessitant environ 386 Go de VRAM. La quantification réduit la configuration nécessaire, mais ne transforme pas ce modèle en téléchargement adapté à un ordinateur portable classique.
Une méthode de migration plus sûre pour les agents
Séparez l’adaptateur fournisseur du routage des tâches, puis évaluez le remplaçant sur les usages qui comptent réellement.
- Conservez une interface de requête unique. Préservez la couche compatible OpenAI pour les messages, les outils et les sorties structurées lorsque le fournisseur la prend en charge. Traitez les contrôles de raisonnement, les charges utiles visuelles, les appels d’outils, les sorties structurées et les limites de contexte comme des indicateurs de capacité, pas comme des champs universels.
- Testez les tâches validées, pas seulement le texte généré. Notez si le code se compile, si l’appel d’outil est valide, si le contrôle visuel réussit et si la tâche se termine sans nouvelle tentative. Une première réponse bon marché qui nécessite ensuite deux nouvelles tentatives sur un dépôt de taille réelle n’est peut-être pas plus économique.
- Routage selon le mode d’échec. Envoyez les textes à contexte répétitif vers DeepSeek V4 Flash, les requêtes multimodales vers Qwen3.8-Flash et les tâches de code à haut risque vers GPT-5.6 Terra, Claude Opus 4.8 ou GLM-5.3, en fonction de vos résultats d’acceptation.
- Gardez une solution de secours. La revue d’AIReiter rapporte un test communautaire de sept jours avec 30 compilations réussies sur 49 tentatives et 14 échecs pour cause de délai d’attente. Ce chiffre ne constitue pas un taux d’échec universel du fournisseur, mais il suffit à déconseiller l’utilisation d’une seule route pour un agent en production.
- Établissez votre budget sur les tarifs normaux. La promotion Flash de Z.ai se termine le 9 septembre 2026. Les tarifs de DeepSeek varient selon les créneaux de pointe. Chez Qwen, la création du cache et les lectures du cache ont des prix différents. Une migration qui ne fonctionne qu’avec un tarif temporaire ne constitue pas un modèle de coût stable.
Un premier test pratique peut consister à exécuter dix requêtes courantes ou fortement orientées texte, puis dix tâches de code, d’utilisation d’outils ou de traitement visuel. Comparez le taux de tâches acceptées, le temps total d’exécution, le nombre de nouvelles tentatives et la dépense totale en tokens. Pour beaucoup d’équipes, cela signifie tester DeepSeek V4 Flash pour les textes à contexte répétitif et Qwen3.8-Flash pour les tâches multimodales, tout en conservant GLM-5.3-Flash comme solution de secours jusqu’à ce que les nouvelles routes aient démontré leur fiabilité.
FAQ
Quelle est la meilleure alternative gratuite à Ox Alpha ?
Aucun remplacement gratuit, permanent et indépendant d’un fournisseur n’est établi par les sources officielles consultées ici. Les fournisseurs peuvent proposer des quotas ou des promotions variables, mais une décision de production doit s’appuyer sur les tarifs payants publiés et considérer l’accès gratuit comme un bonus.
Quelle alternative prend en charge les images et la vidéo ?
Qwen3.8-Flash liste officiellement les entrées image, texte et vidéo. La route standard DeepSeek V4 Flash est distincte de sa route deepseek-v4-flash-vision-exp : testez donc l’endpoint exact avant de migrer un agent visuel.
Quelle alternative puis-je exécuter localement ?
Parmi les options à poids ouverts figurent le checkpoint GLM-5.3-Flash et Qwen3.8-Flash-Next. GLM-5.3-Flash totalise environ 320B paramètres, tandis que la documentation de Qwen pour Flash-Next indique un contexte natif de 262K extensible à 1M avec YaRN. Dans les deux cas, ne supposez pas que le modèle tiendra sur une machine de 32 Go.
Comment éviter les mauvaises surprises après un changement de fournisseur ?
Exécutez 20 tâches représentatives sur deux routes, puis comparez le taux de tâches acceptées, le temps total d’exécution, le nombre de nouvelles tentatives et la dépense totale en tokens. Conservez la route GLM-5.3-Flash existante comme solution de secours jusqu’à ce que le remplaçant ait démontré sa fiabilité avec vos propres outils et dépôts.