 AIREITER
Le bon choix dépend avant tout de la charge de travail. Claude Opus 5 est le point de départ le plus sûr pour la plupart des tâches cadrées et fortement orientées production, tandis que Claude Fable 5.1 est le spécialiste à tester pour les agents qui travaillent sur de longues séquences et les contextes particulièrement vastes et réutilisables. Les économies mises en avant pour Fable 5.1 viennent surtout des lectures du cache, et non de tarifs d’entrée ou de sortie plus bas.
Fable 5.1 ou Opus 5 : commencez par regarder votre charge de travail
Pour la plupart des équipes, mieux vaut commencer avec Opus 5, augmenter son niveau d’effort lorsque la tâche demande davantage de raisonnement, puis réserver Fable 5.1 aux cas difficiles qui ont déjà fait leurs preuves dans vos évaluations. La documentation Anthropic consacrée à Fable 5.1 donne globalement le même conseil : démarrer avec Opus 5 pour la majorité des usages et passer à Fable 5.1 lorsque les évaluations d’Opus 5 avec un niveau d’effort supérieur ne suffisent pas.
| Si votre principale contrainte est… | Commencez avec… | Pourquoi |
|---|---|---|
| Des requêtes courtes ou bien délimitées | Opus 5 | Ses tarifs d’entrée et de sortie représentent la moitié de ceux de Fable 5.1. |
| Un trafic de production riche en sorties | Opus 5 | Le tarif inférieur des lectures du cache chez Fable ne réduit pas le prix des tokens générés. |
| Du code réparti sur plusieurs fichiers avec une spécification claire | Opus 5 | Son coût inférieur permet d’absorber plus facilement les nouvelles tentatives et un niveau d’effort supérieur. |
| Des agents qui utilisent des outils sur de longues séquences | Fable 5.1—après évaluation | Fable arrive en tête des comparaisons publiées par Anthropic sur les agents et l’utilisation d’outils. |
| Un vaste contexte réutilisé plusieurs fois au fil des échanges | Fable 5.1—après modélisation des coûts | Le prix de ses lectures du cache est deux fois inférieur à celui d’Opus 5. |
| Un routeur de production sensible aux mécanismes de repli | Opus 5 d’abord | Fable 5.1 modifie le comportement des blocs de réflexion et de l’historique des conversations. |
La vraie comparaison oppose Opus 5 utilisé avec le bon niveau d’effort et au bon coût à Fable 5.1 utilisé avec la bonne structure de contexte et le niveau de fiabilité requis.
Qu’est-ce qui distingue vraiment Fable 5.1 d’Opus 5 ?
Claude Fable 5.1 est le modèle haut de gamme d’Anthropic pour les raisonnements exigeants et le travail agentique sur de longues séquences. Claude Opus 5 se présente plutôt comme un modèle moins coûteux, destiné au développement sérieux, aux agents et aux usages professionnels. Les deux modèles disposent d’une fenêtre de contexte de 1 million de tokens et peuvent générer jusqu’à 128 000 tokens. Fable ne se distingue donc pas par une limite de contexte publiée plus élevée, mais par son orientation vers l’exécution sur de longues séquences.
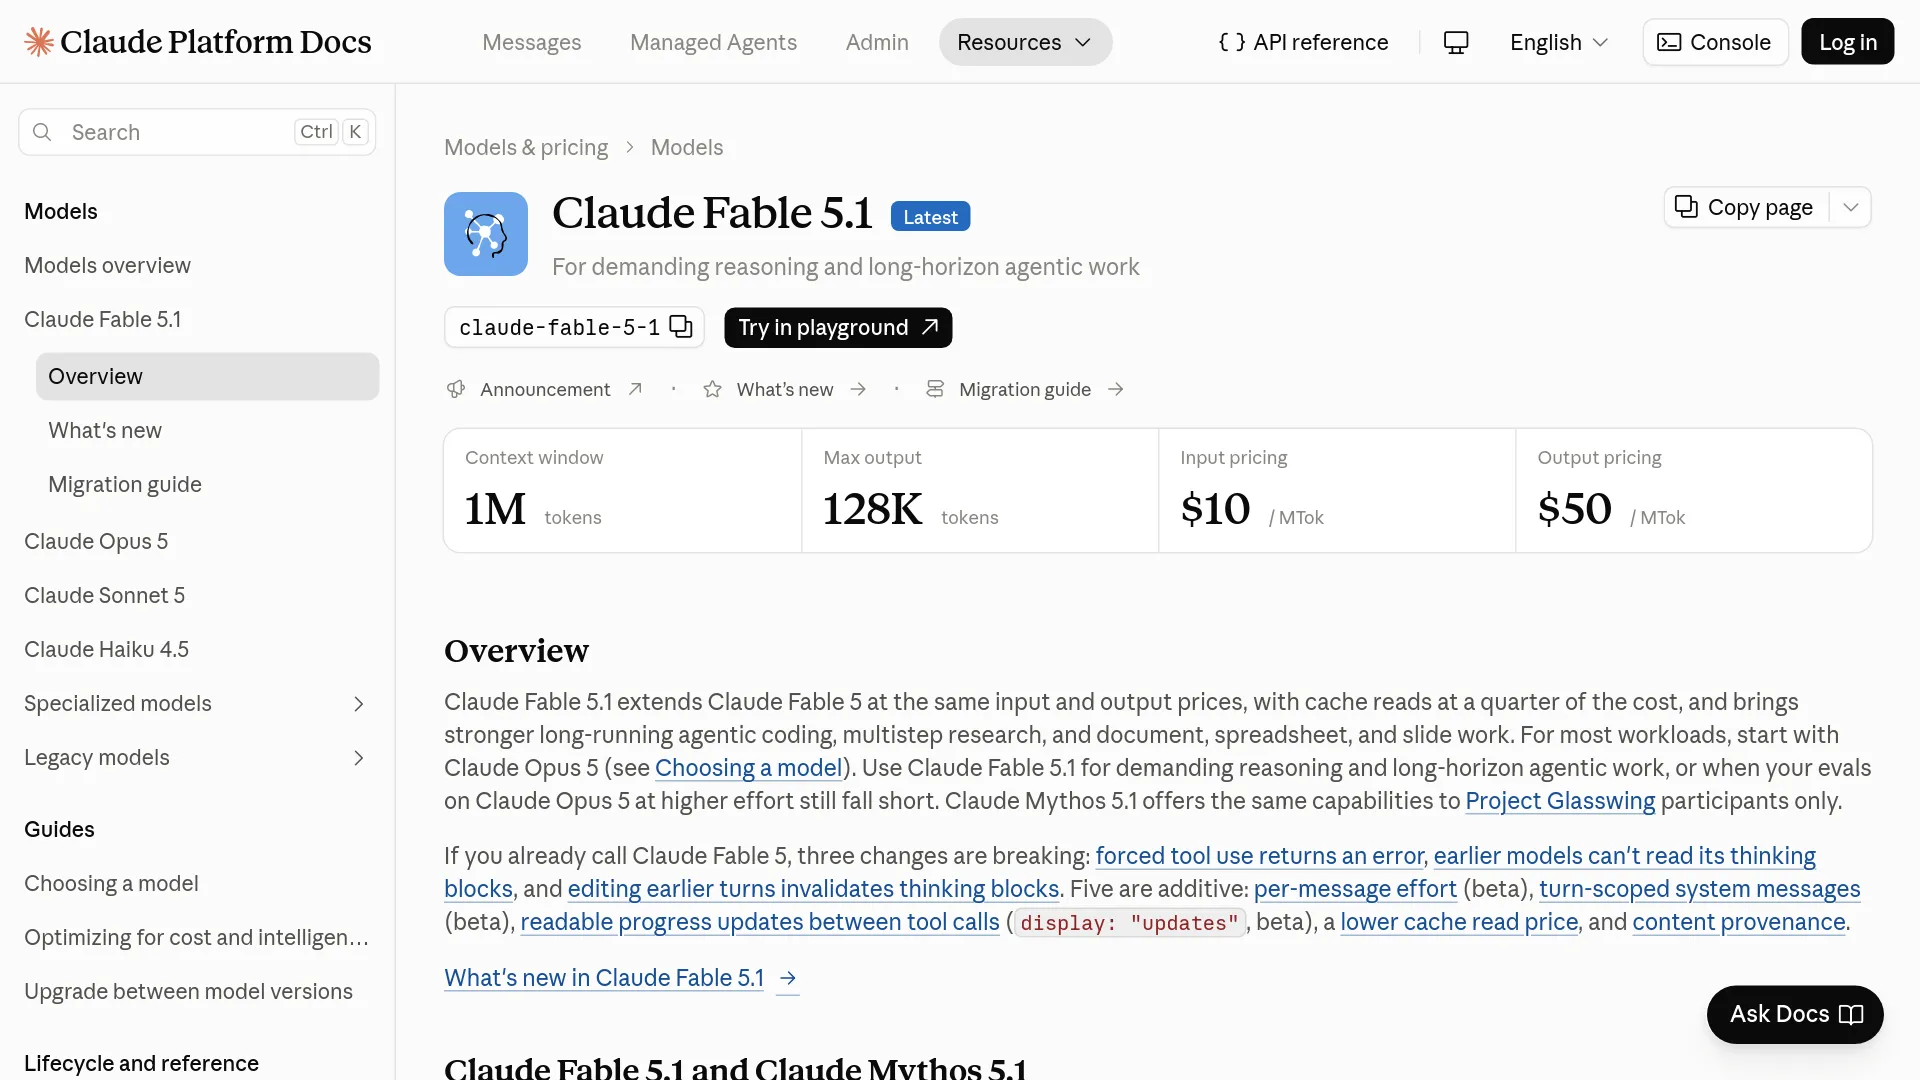
| Caractéristique | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Identifiant du modèle API | claude-fable-5-1 | claude-opus-5 |
| Fenêtre de contexte | 1 million de tokens | 1 million de tokens |
| Sortie maximale | 128 000 tokens | 128 000 tokens |
| Modalités d’entrée | Texte et images | Texte et images |
| Modalité de sortie | Texte | Texte |
| Réflexion | Adaptative, toujours activée | Raisonnement contrôlé par le niveau d’effort |
| Contrôles du niveau d’effort | low, medium, high, xhigh, max | Niveaux d’effort configurables |
| Positionnement selon Anthropic | Raisonnement exigeant et agents opérant sur de longues séquences | La plupart des usages et développement sérieux |
| Statut de sortie | Actif/dernier modèle ; sorti le 1er septembre 2026 | Modèle Opus actif ; sorti le 24 juillet 2026 |
Pour connaître les identifiants de modèle et la disponibilité selon votre environnement de déploiement, consultez la page du modèle Fable 5.1 et la page produit de Claude Opus 5.
Fable 5.1 affiche de meilleurs résultats, mais pas partout
Le tableau de benchmarks publié par Anthropic place Fable 5.1 devant Opus 5 sur chaque ligne où les deux modèles sont évalués. Ces résultats ont été obtenus par le fournisseur lui-même : ils constituent donc un indicateur utile de l’évaluation réalisée au lancement, pas une garantie de performance en production.
| Évaluation Anthropic | Fable 5.1 | Opus 5 | Avance de Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6 % | 29,0 % | 23,6 points |
| Terminal-Bench 4.0 | 55,8 % | 52,3 % | 3,5 points |
| GDPval-AA v2 | 1 853 Elo | 1 824 Elo | 29 Elo |
| OSWorld 2.0, strict | 41,7 % | 39,6 % | 2,1 points |
| Humanity’s Last Exam, avec outils | 65,0 % | 63,6 % | 1,4 point |
| AutomationBench | 31,4 % | 26,9 % | 4,5 points |
| CursorBench 3.2.0 | 73,4 % | 70,0 % | 3,4 points |
Anthropic précise que les garde-fous de production étaient activés et que certaines interventions pouvaient produire des scores nuls ou envoyer la tâche vers un modèle de repli. L’entreprise indique également une erreur standard d’environ 3,5 à 4,5 points de pourcentage par modèle sur Terminal-Bench-Science 0.1. Un écart de 23,6 points est donc plus significatif qu’une différence de 1,4 point sur Humanity’s Last Exam.
Une évaluation réalisée par CodeRabbit sur 45 tâches comprenant 105 problèmes connus a mesuré un rappel de 61,0 % et une précision de 37,3 % pour Fable 5.1, contre un rappel de 55,2 % et une précision de 39,3 % pour Opus 5. Les deux modèles ont produit 166 commentaires traités, mais les auteurs précisent que les configurations n’étaient pas identiques.
« Fable 5.1 est un spécialiste de la revue de code. » — Description par CodeRabbit du résultat de son évaluation (CodeRabbit)
Les tarifs API changent la donne
Pour les entrées et sorties non mises en cache, Fable 5.1 coûte deux fois plus cher qu’Opus 5. En revanche, ses lectures du cache coûtent deux fois moins cher. Cette différence peut faire basculer le calcul pour les sessions agentiques longues et répétitives, mais elle ne rend pas toutes les requêtes Fable 5.1 moins coûteuses.
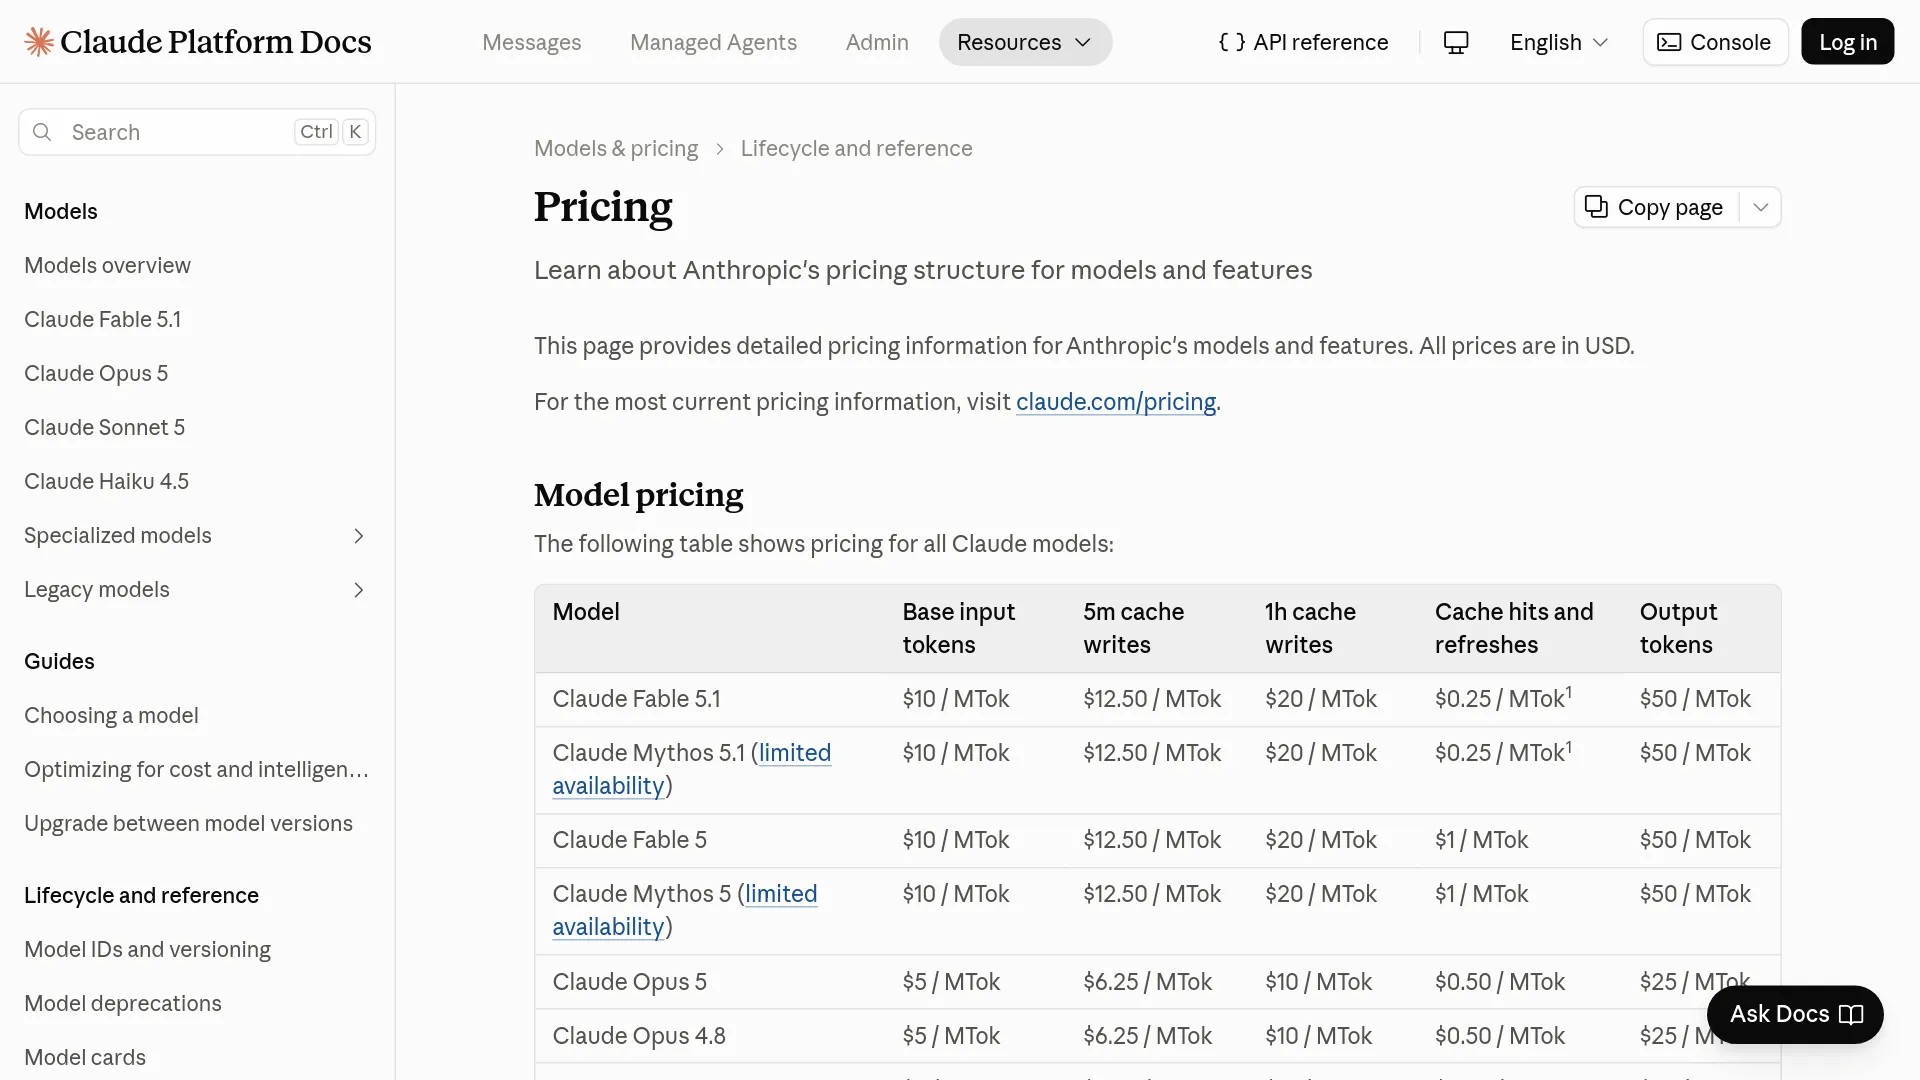
Les tarifs ci-dessous proviennent de la documentation actuelle d’Anthropic sur les tarifs API, en dollars américains par million de tokens.
| Élément facturé | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Entrée de base | $10.00 | $5.00 |
| Écriture du cache de 5 minutes | $12.50 | $6.25 |
| Écriture du cache d’1 heure | $20.00 | $10.00 |
| Lecture du cache | $0.25 | $0.50 |
| Sortie | $50.00 | $25.00 |
| Entrée / sortie en traitement par lots | $5.00 / $25.00 | $2.50 / $12.50 |
Les tarifs d’entrée et de sortie de Fable 5.1 sont identiques à ceux de Fable 5. L’élément à l’origine des économies annoncées est le tarif des lectures du cache : $0.25 par million de tokens, contre $1.00 pour Fable 5. Anthropic estime une baisse d’environ 25 % du coût sur une charge de travail typique, et jusqu’à environ 45 % sur les usages très agentiques. Il s’agit toutefois d’estimations liées à certains usages, pas d’une remise universelle.
Un calcul simple par tour permet de mieux visualiser l’arbitrage. Supposons que C désigne le contexte mis en cache, I les nouvelles entrées et O la sortie, chacun étant exprimé en millions de tokens. En ignorant les frais d’écriture du cache, Fable 5.1 coûte 10I + 0.25C + 50O, tandis qu’Opus 5 coûte 5I + 0.50C + 25O.
Le coût inférieur des lectures du cache chez Fable compense ses tarifs plus élevés pour les nouvelles entrées et les sorties uniquement lorsque :
0.25C > 5I + 25O
Pour un prompt de 2 000 tokens suivi d’une réponse de 1 000 tokens, I = 0.002 et O = 0.001. Le contexte mis en cache doit dépasser environ 140 000 tokens avant que le calcul, en ne tenant compte que des lectures, ne devienne favorable à Fable. Les frais d’écriture du cache repoussent encore ce seuil.
C’est pourquoi il n’est pas pertinent de passer à Fable 5.1 pour des extractions courtes, de la classification, de la réécriture ou des appels de code ponctuels au seul motif du prix. Le préfixe réutilisable est faible, voire inexistant, et chaque token généré est facturé deux fois plus cher qu’avec Opus 5.
Quel modèle pour quels workflows ?
La distinction opérationnelle oppose l’exécution cadrée à la persistance sur de longues séquences. Opus 5 est plus facile à justifier lorsque la tâche est clairement spécifiée ou génère beaucoup de contenu. Fable 5.1 devient plus intéressant lorsqu’un agent doit conserver un plan, utiliser des outils à répétition, se remettre d’erreurs et transporter un contexte volumineux sur de nombreux tours.
Agents de code : mesurez le travail terminé, pas seulement la place dans les benchmarks
Opus 5 est le premier modèle à tester pour les tâches classiques sur un dépôt : corrections de bugs ciblées, refactorings définis, revue de code et missions pour lesquelles un coût inférieur permet de relancer l’opération ou d’augmenter l’effort. Fable 5.1 mérite un pilote pour les modifications réparties sur plusieurs fichiers, les migrations, le débogage au niveau système et les sessions de développement asynchrones où un échec tardif coûte davantage qu’une réponse plus lente.
Les retours de la communauté font apparaître deux types de risques opérationnels. Dans une vaste discussion sur r/ClaudeCode, l’utilisateur u/CyCoCyCo écrivait :
« La seule méthode qui m’a permis d’obtenir de bons résultats consiste à lui faire générer des prompts d’objectif, puis à tout exécuter de bout en bout. » — u/CyCoCyCo sur Reddit
Ce témoignage pointe un problème de prompting et de workflow ; il ne prouve pas qu’Opus 5 échoue sur toutes les bases de code. D’autres utilisateurs de la même discussion ont évoqué des difficultés lors de tâches longues et fortement dépendantes du contexte, notamment une dérive des instructions et des corrections qui introduisaient de nouveaux défauts.
Fable 5.1 présente un autre profil de plaintes. Dans une discussion consacrée à sa sortie, des utilisateurs ont signalé une consommation inhabituellement rapide des tokens ou du quota. Ce retour reste anecdotique et ne permet pas d’établir une limite universelle pour les abonnements, mais il justifie un suivi de l’usage pendant le pilote au lieu d’évaluer le modèle uniquement sur la qualité de ses réponses.
Un pilote sérieux pour un agent de code doit mesurer :
- Les tâches terminées sans intervention humaine.
- Les bugs rouverts ou les régressions découvertes après que le modèle a annoncé la réussite.
- Le nombre total de tokens d’entrée, d’entrée mise en cache et de sortie.
- Le temps réel d’exécution et le nombre d’appels d’outils.
- Le temps consacré aux corrections humaines et le coût des exécutions tardives qui échouent.
Recherche et documents volumineux : Fable présente un dossier plus convaincant
Fable 5.1 est le candidat le plus intéressant lorsque la tâche porte sur un très vaste corpus documentaire, des appels d’outils répétés, des graphiques visuels, une recherche en plusieurs étapes ou un livrable appelé à traverser plusieurs cycles de révision. Anthropic le positionne explicitement pour les documents, feuilles de calcul, présentations, diagrammes, tableaux et travaux de recherche prolongés.
Opus 5 dispose de la même capacité de contexte de 1 million de tokens et Anthropic le décrit également comme capable de traiter des documents complexes et des agents sophistiqués. Si le travail consiste en une seule analyse avec une sortie importante, le tarif inférieur d’Opus peut compter davantage que l’avantage de Fable sur le cache. Testez un échantillon représentatif avant de considérer l’avance de Fable dans les benchmarks comme une exigence de production.
Utilisation d’un ordinateur et automatisation métier : testez toute la trajectoire
Fable 5.1 devance Opus 5 dans les résultats OSWorld et AutomationBench publiés par Anthropic, mais ces tâches évaluent une suite d’actions plutôt qu’une réponse isolée. Pour un agent de navigateur ou d’automatisation métier, vérifiez que le modèle atteint bien l’état final attendu, la fréquence à laquelle il doit récupérer une erreur et l’impact d’une action ratée sur la suite de l’exécution.
L’unité pertinente est le coût par résultat obtenu, et non le seul coût par million de tokens. Un modèle qui évite des relances répétées sur un workflow long peut rester économique malgré un tarif supérieur. À l’inverse, un modèle qui consomme le budget d’utilisation avant d’atteindre l’état final ne l’est pas.
Les détails d’intégration à vérifier avant de migrer
La documentation de migration de Fable 5.1 décrit des changements concernant l’utilisation forcée des outils, les blocs de réflexion et la validation de l’historique des conversations. Les équipes qui s’appuient sur leur propre routeur de messages doivent les tester avant de changer de modèle par défaut.
| Changement | Ce qui peut se produire | Action de migration |
|---|---|---|
| Utilisation forcée des outils | tool_choice: {"type":"any"} ou le choix d’un outil nommé peut renvoyer une erreur HTTP 400. | Utilisez auto avec des instructions claires pour les outils, ou des sorties structurées lorsque c’est pertinent. |
| Portabilité des blocs de réflexion | Les anciens modèles ne peuvent pas lire les blocs de réflexion de Fable 5.1 ; les tours de repli peuvent les supprimer. | Auditez les changements de modèle et les chemins de repli. |
| Modification des conversations | Modifier un message antérieur, le prompt système ou la liste d’outils peut invalider les blocs de réflexion suivants. | Traitez l’historique comme un flux en ajout uniquement, ou utilisez les contrôles pris en charge au niveau du tour. |
| Configuration de la réflexion | Fable 5.1 utilise une réflexion adaptative et ne permet pas de désactiver la réflexion de la même manière qu’Opus 5. | Maîtrisez les dépenses avec les paramètres d’effort et mesurez à nouveau l’utilisation des tokens. |
Le comportement en cas de repli est particulièrement important dans les routeurs qui mélangent plusieurs modèles. Une requête Fable 5.1 peut poursuivre son exécution avec son contexte de raisonnement, mais un repli vers Opus 5 ne peut pas exploiter les blocs de réflexion de Fable 5.1. Si le routeur les supprime silencieusement, le modèle de repli peut devoir refaire son plan, ce qui ajoute de la latence et des tokens. Testez le parcours nominal comme le parcours d’échec avec des historiques proches de ceux de la production.
Une petite évaluation vaut mieux qu’une grande promesse de modèle
Utilisez les mêmes prompts, outils, contextes, règles d’effort et tests d’acceptation pour les deux modèles. Sinon, vous risquez de comparer les harnais d’évaluation plutôt que les modèles eux-mêmes.
- Volet cadré : exécutez des corrections de bugs ciblées, de l’extraction, de la rédaction structurée et de la revue de code. Mesurez la qualité utile de la sortie, le temps de correction et le coût.
- Volet longue séquence : lancez une fonctionnalité répartie sur plusieurs fichiers, une migration, une tâche de recherche ou un workflow dans un navigateur. Mesurez la réussite de l’état final, la récupération après erreur, les régressions et le temps réel d’exécution.
- Volet fortement mis en cache : répétez une consigne système stable, un jeu d’outils identique et un préfixe de dépôt ou de document récurrent. Suivez le taux de cache utilisé et la facture totale, y compris les écritures du cache et les sorties.
Commencez avec Opus 5 au niveau d’effort que vous déploieriez réellement. Testez ensuite un niveau d’effort supérieur sur Opus avant de transférer la tâche vers Fable 5.1. Pour Fable, testez au moins medium et high ; ne supposez pas qu’un même nom de niveau d’effort produira le même comportement d’un modèle à l’autre. Anthropic indique que ces paramètres contrôlent l’arbitrage entre profondeur de raisonnement et coût, tandis que des tests tiers ont constaté qu’un raisonnement plus poussé n’améliorait pas automatiquement les résultats agrégés en revue de code.
Fable 5.1 ou Opus 5 : la FAQ
Quel modèle choisir pour le développement ?
Fable 5.1 devance Opus 5 dans les résultats publiés par Anthropic pour Terminal-Bench et CursorBench, mais Opus 5 constitue le meilleur point de départ pour la plupart des tâches de développement cadrées et sensibles au coût. Une évaluation sur un dépôt représentatif permettra de déterminer si la meilleure qualité d’exécution de Fable compense son prix et sa latence.
Fable 5.1 vaut-il deux fois le prix de l’API ?
Pas par défaut. Ses tarifs d’entrée et de sortie sont deux fois supérieurs à ceux d’Opus 5, tandis que ses lectures du cache coûtent moitié moins cher. Fable devient financièrement intéressant lorsque la charge de travail réutilise régulièrement un contexte volumineux et génère relativement peu de contenu.
Fable 5.1 dispose-t-il d’une fenêtre de contexte plus grande ?
Non. Anthropic indique une fenêtre de contexte de 1 million de tokens et une sortie maximale de 128 000 tokens pour les deux modèles. La particularité de Fable tient à son orientation vers le raisonnement sur de longues séquences et les trajectoires agentiques, pas à une fenêtre publiée plus vaste.
Faut-il augmenter le niveau d’effort d’Opus 5 avant de changer de modèle ?
Oui. Les recommandations d’Anthropic invitent à évaluer Opus 5 avec un niveau d’effort supérieur avant de passer à Fable 5.1. Comparez le coût supplémentaire en tokens avec le gain de qualité au lieu d’exécuter chaque requête au niveau maximal.
Peut-on basculer proprement de Fable 5.1 vers Opus 5 en cas de problème ?
Vous pouvez mettre en place ce mécanisme de repli, mais ne partez pas du principe que l’état de la conversation sera portable. Les anciens modèles ne peuvent pas lire les blocs de réflexion de Fable 5.1, et la validation de l’historique de Fable 5.1 peut révéler les faiblesses des routeurs qui modifient les tours précédents. Testez le repli avec vos véritables schémas d’outils et historiques de messages.
Où les développeurs peuvent-ils accéder à Fable 5.1 et Opus 5 ?
Anthropic répertorie les deux modèles pour les abonnements Claude ainsi que pour l’accès développeur via sa plateforme et ses intégrations avec les marketplaces cloud. Les identifiants exacts et la disponibilité peuvent varier selon le fournisseur. Vérifiez donc l’identifiant propre à votre déploiement dans la documentation de Fable 5.1 ou sur la page produit d’Opus 5.
Le choix pratique tient à une règle de routage, pas à une migration définitive
| Décision | Utiliser Opus 5 | Utiliser Fable 5.1 |
|---|---|---|
| Modèle par défaut pour un trafic varié | Oui | Uniquement après évaluation |
| Appels courts et ponctuels | Oui | Pas d’intérêt économique |
| Génération riche en sorties | Oui | Généralement non |
| Préfixes volumineux mis en cache | À comparer attentivement | Intérêt économique possible |
| Développement autonome sur de longues séquences | À tester en premier | Candidat solide |
| Refactorings strictement cadrés | Généralement | Si Opus échoue aux tests d’acceptation |
| Automatisation dans un navigateur ou en plusieurs étapes | À tester en premier | Avantage marqué dans les benchmarks |
| Routeur de repli personnalisé | Référence plus simple | Nécessite des tests de migration |
Conservez Opus 5 comme référence, exécutez les deux modèles sur le même jeu de tâches cadrées et de tâches longues, puis routez vers Fable 5.1 uniquement lorsqu’il améliore le volume de travail terminé par dollar dépensé.
Pour les détails tarifaires propres à chaque modèle, consultez les tarifs API de Claude Fable 5.1 ; pour une présentation plus générale du modèle, consultez Claude Opus 5.