 AIREITER
Avec un tarif de 2 $ par million de tokens en entrée et un score publié de 70,6 % à Terminal-Bench 4.0, Claude Sonnet 5.5 semble taillé pour devenir le modèle de référence des équipes de développement. Mais les agents configurés avec un niveau d’effort élevé peuvent faire grimper fortement le coût réel de chaque modification acceptée. Pour une équipe qui choisit un modèle de production, Sonnet 5.5 est donc le premier candidat à tester, pas un remplacement automatique d’Opus 5.5.
Le verdict pour la production : faire de Sonnet 5.5 le modèle par défaut
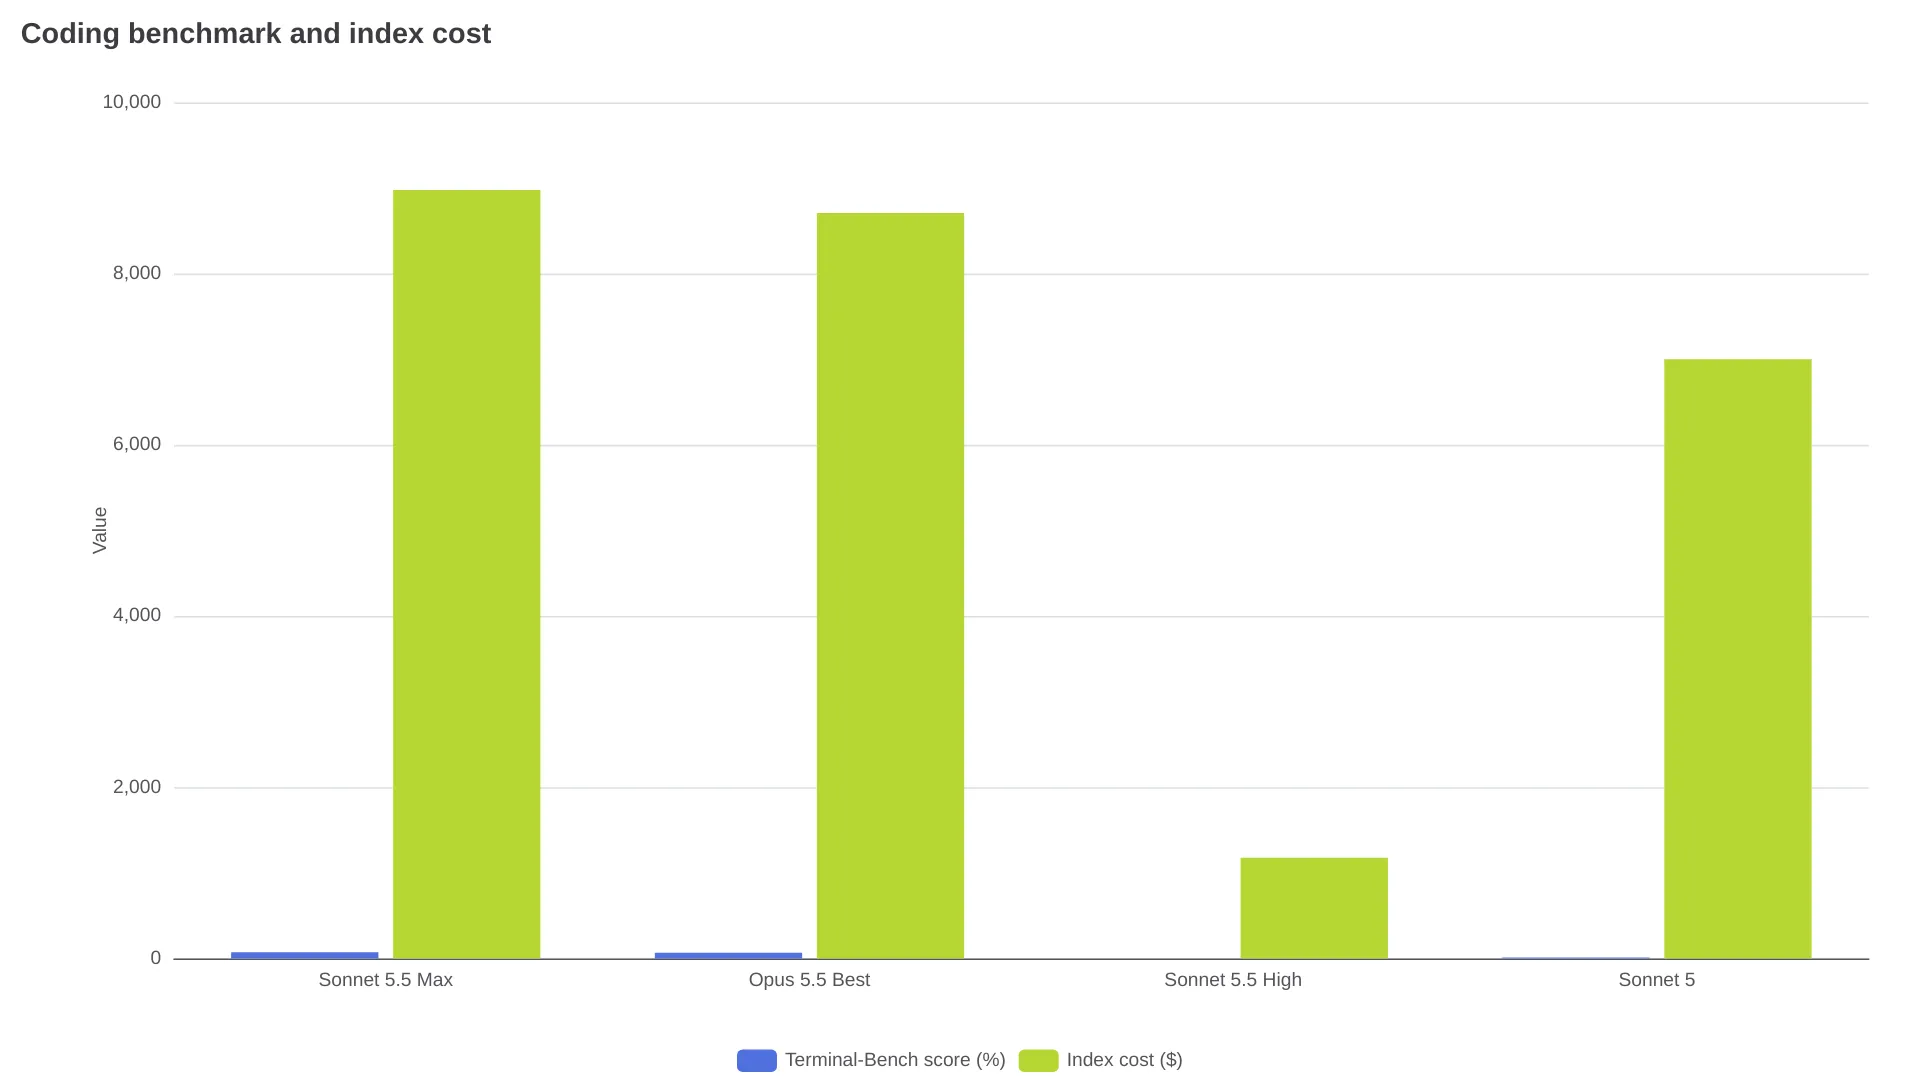
Commencez par piloter Claude Sonnet 5.5 sur des corrections ciblées, des refactorings, de la génération de tests et des tâches de dépôt nécessitant l’utilisation d’outils. Dans les résultats publiés par Anthropic, Sonnet 5.5 atteint 70,6 % à Terminal-Bench 4.0, contre 66,4 % pour Claude Opus 5.5 et 10,3 % pour Claude Sonnet 5 dans la même comparaison.
Une règle de prudence s’impose toutefois : définissez explicitement le niveau d’effort et les limites de sortie. Des analyses indépendantes indiquent qu’en effort maximal, Sonnet 5.5 peut coûter plus cher par tâche de benchmark qu’Opus 5.5, malgré un tarif facial inférieur.
Ce que Claude Sonnet 5.5 change pour les équipes qui utilisent l’API
Claude Sonnet 5.5 a été lancé le 28 septembre 2026. La documentation officielle du modèle indique l’identifiant claude-sonnet-5-5, une fenêtre de contexte de 1 million de tokens, une sortie maximale standard de 128 000 tokens, une réflexion adaptative et un niveau d’effort API défini par défaut sur high.
| Détail de production | Claude Sonnet 5.5 |
|---|---|
| Date de sortie | 28 septembre 2026 |
| Identifiant du modèle | claude-sonnet-5-5 |
| Fenêtre de contexte | 1 million de tokens |
| Sortie maximale standard | 128 000 tokens |
| Sortie maximale en batch | 300 000 tokens avec l’en-tête bêta indiqué dans la documentation |
| Niveau d’effort API par défaut | high |
Anthropic s’engage dans sa documentation à ne pas retirer le modèle avant le 28 septembre 2027. Il s’agit d’une durée minimale de disponibilité, et non d’une date définitive de retrait garantie.
Les paramètres par défaut qui font varier la facture
La réflexion adaptative est activée par défaut. Les équipes qui migrent depuis Sonnet 5 doivent tester between_tools si elles veulent désactiver la réflexion préalable aux appels d’outils. La documentation officielle précise aussi que l’utilisation forcée d’un outil renvoie désormais une erreur, tandis que les valeurs non par défaut de temperature, top_p ou top_k provoquent des erreurs HTTP 400.
Le texte généré entre deux appels d’outils peut être renvoyé dans des blocs thinking. Un client de streaming qui suppose que chaque message intermédiaire est un bloc de texte classique peut sembler ne plus rien recevoir après la migration. Mettez donc le parseur à jour avant d’intégrer Sonnet 5.5 à un agent de développement existant.
Performances à Terminal-Bench : suffisamment solides pour le modèle par défaut
Le benchmark d’agents de développement le plus mis en avant ici est Terminal-Bench 4.0, qui évalue des tâches en plusieurs étapes réalisées en ligne de commande. Selon les résultats communiqués par Anthropic, Sonnet 5.5 atteint 70,6 %, contre 66,4 % pour Opus 5.5 et 10,3 % pour Sonnet 5.
| Modèle | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70,6 % | 1844 | 55,5 % |
| Claude Opus 5.5 | 66,4 % | 1846 | 57,8 % |
| Claude Sonnet 5 | 10,3 % | 1449 | 34,1 % |
Les chiffres ci-dessus proviennent du récapitulatif des benchmarks publié par DataCamp, qui attribue les résultats d’évaluation aux documents de lancement d’Anthropic. Sonnet 5.5 domine la comparaison sur le développement en terminal, mais Opus 5.5 reste devant sur CursorBench ainsi que dans plusieurs évaluations plus générales du raisonnement et du travail intellectuel.
Validez vos choix sur des rejoués de dépôts réels en mesurant les tests réussis, le nombre de tours d’outils et les modifications acceptées, plutôt qu’en vous fiant aux seuls diffs.
Tarifs de l’API Claude Sonnet 5.5 en conditions réelles
La grille tarifaire d’Anthropic est simple à lire, mais un agent de développement peut facturer davantage que ce que laisse voir le prompt. Les tokens de réflexion sont facturés comme des tokens de sortie, tandis que le contexte répété du dépôt peut être comptabilisé en lectures du cache au fil des tours.
| Élément de l’API | Tarif de Claude Sonnet 5.5 |
|---|---|
| Entrée | 2 $ pour 1 million de tokens |
| Sortie, réflexion comprise | 10 $ pour 1 million de tokens |
| Écriture du cache de 5 minutes | 2,50 $ pour 1 million de tokens |
| Écriture du cache d’une heure | 4 $ pour 1 million de tokens |
| Lecture du cache | 0,20 $ pour 1 million de tokens |
| Entrée en batch | Réduction de 50 %, soit 1 $ pour 1 million |
| Sortie en batch | Réduction de 50 %, soit 5 $ pour 1 million |
La documentation officielle indique un minimum de 512 tokens pour qu’un prompt puisse être mis en cache et précise que Sonnet 5.5 utilise une réflexion adaptative. D’après l’analyse tarifaire indépendante d’eesel, Sonnet 5.5 emploie le même tokenizer que Sonnet 5 : une migration ne réduit donc pas automatiquement le nombre de tokens.
Une requête contenant 4 000 tokens en entrée et 700 tokens en sortie coûte environ 0,015 $ avant les autres frais : 0,008 $ pour l’entrée et 0,007 $ pour la sortie. Un agent de développement qui effectue 20 tours, avec 3 000 tokens d’entrée nouveaux et 2 000 tokens de sortie par tour, consommerait environ 0,12 $ en entrée nouvelle et 0,40 $ en sortie, avant les lectures et écritures du cache, les outils ou les nouvelles tentatives. Ces exemples illustrent un type de charge de travail ; ils ne constituent pas un tarif universel par tâche.
Le niveau d’effort, véritable levier de coût
L’analyse de TokenCost consacrée au niveau d’effort, fondée sur les mesures de l’Artificial Analysis Intelligence Index, a obtenu les résultats suivants pour Sonnet 5.5 :
| Niveau d’effort | Score | Coût de l’index complet |
|---|---|---|
| Faible | 35,8 | 544 $ |
| Moyen | 40,7 | 701 $ |
| Élevé | 46,7 | 1 176 $ |
| Xhigh | 51,9 | 2 738 $ |
| Maximal | 56,0 | 8 977 $ |
Le résultat en effort maximal doit servir d’avertissement. La même analyse donne à Opus 5.5 un score de 57,6 pour 8 708 $ en mode max, tandis que le mode xhigh atteint 56,0 pour 4 057 $. Lors de ce test, Sonnet 5.5 en mode max a utilisé environ 193 000 tokens de sortie par tâche.
Commencez en mode moyen ou élevé, plafonnez le nombre de tokens de sortie et ne basculez vers une route plus coûteuse que les tâches qui échouent ou présentent un risque élevé. Ne recopiez pas un ancien réglage max de Sonnet 5 dans Sonnet 5.5 sans refaire les évaluations de coût et de qualité.
Checklist de migration pour un modèle de développement en production
- Épinglez
claude-sonnet-5-5en staging au lieu de modifier globalement un alias. - Rejouez des corrections de bugs, refactorings, tests et modifications multi-fichiers représentatifs issus de vos dépôts.
- Définissez explicitement le niveau d’effort et consignez les tokens de sortie, les lectures du cache, les tours d’outils, le temps écoulé et le taux de modifications acceptées.
- Remplacez
thinking: disabledpar le comportement pris en chargebetween_toolslorsque c’est pertinent. - Supprimez les hypothèses liées à l’utilisation forcée des outils et testez le nouveau comportement de sélection des outils.
- Mettez le code de streaming à jour pour gérer les blocs
thinkingentre les appels d’outils. - Revérifiez les paramètres d’échantillonnage non par défaut : la documentation officielle indique des erreurs 400 pour
temperature,top_pettop_klorsqu’ils ne conservent pas leur valeur par défaut. - Ajoutez un plafond de dépenses et une condition d’arrêt en cas de sortie excessive ou de boucles répétées entre les outils.
- Comparez le coût par modification acceptée, et non le coût par requête.
- Déployez le modèle sur un faible pourcentage du trafic. Augmentez sa part uniquement si Sonnet atteint le taux de modifications acceptées du modèle en place dans la marge de tolérance définie, tout en réduisant le coût par modification acceptée.
L’employé d’Anthropic @cjav_dev a indiqué que les requêtes utilisant thinking: {"type":"disabled"} commençaient à renvoyer des erreurs 400 et qu’il fallait passer à between_tools (publication sur X).
Quand choisir Sonnet 5.5, Opus 5.5 ou un modèle moins cher
| Charge de travail | Premier choix recommandé | Pourquoi |
|---|---|---|
| Corrections ciblées et refactorings | Sonnet 5.5 en mode moyen/élevé | Un score solide en terminal et un tarif inférieur par token |
| Classification de code à grande échelle ou modifications simples | Sonnet 5.5 en mode faible/moyen, ou un modèle moins cher | Éviter de payer pour une réflexion superflue |
| Agent opérant longtemps sur un dépôt | Sonnet 5.5 avec cache et budgets stricts | Le cache et le nombre de tours déterminent la facture réelle |
| Architecture ambiguë ou revue finale | Opus 5.5 | La capacité de jugement globale compte davantage que le tarif le plus bas |
| Analyse de code hors ligne et non urgente | Sonnet 5.5 Batch API | L’API offre une réduction de 50 % sur l’entrée et la sortie |
| Expérience en terminal avec effort maximal | Sonnet 5.5 uniquement après un benchmark interne | Terminal-Bench est un point fort relatif, mais le mode max peut coûter cher |
Réservez Sonnet aux tâches bien définies et mesurables ; faites remonter les sujets d’architecture ambigus vers Opus.
FAQ sur l’API Claude Sonnet 5.5
Quels sont les tarifs de l’API Claude Sonnet 5.5 ?
Le tarif standard est de 2 $ par million de tokens en entrée et de 10 $ par million de tokens en sortie. Les lectures du cache coûtent 0,20 $ par million de tokens, les écritures 2,50 $ pour cinq minutes ou 4 $ pour une heure, et la Batch API réduit de 50 % le prix de l’entrée et de la sortie.
Sonnet 5.5 est-il meilleur qu’Opus 5.5 pour développer ?
Sonnet 5.5 domine la comparaison publiée à Terminal-Bench 4.0 avec 70,6 %, contre 66,4 % pour Opus 5.5. Opus reste devant dans plusieurs autres évaluations : les équipes doivent donc choisir le modèle selon le type de tâche, plutôt que de considérer le résultat de ce benchmark comme un classement universel.
Quel est l’identifiant du modèle Sonnet 5.5 ?
Utilisez claude-sonnet-5-5 avec l’API Claude. Les identifiants propres au fournisseur sont indiqués dans la documentation des modèles d’Anthropic.
Sonnet 5.5 prend-il en charge une fenêtre de contexte de 1 million de tokens ?
Oui. Anthropic indique une fenêtre de contexte de 1 million de tokens et une sortie maximale standard de 128 000 tokens. La version bêta de l’API Message Batches peut prendre en charge 300 000 tokens en sortie avec l’en-tête bêta indiqué dans la documentation.
Qu’est-ce qui change lors d’une migration depuis Sonnet 5 ?
La réflexion adaptative et le comportement des blocs de réponse ont évolué, l’utilisation forcée des outils peut provoquer une erreur, les paramètres d’échantillonnage non par défaut peuvent renvoyer des erreurs 400, et thinking: disabled doit être remplacé par le comportement pris en charge. Rejouez les tests de l’agent et du streaming avant le déploiement en production.
Lancez un pilote d’une semaine avec un niveau d’effort moyen ou élevé, mesurez le coût par modification acceptée et faites remonter les cas d’échec vers Opus.