 AIREITER
Seed Audio 1.0 merece una prueba si produces audio breve en inglés o chino, aunque de momento conviene hacerlo a través de una pasarela de terceros y no de la API oficial. El modelo de ByteDance puede crear una escena de audio completa —diálogos, música de fondo y efectos— a partir de un único prompt. Su capacidad para combinar conversaciones entre varias voces con música ya mezclada lo distingue de las herramientas centradas solo en TTS o en música. A cambio, tiene tres límites claros: cada generación llega como máximo a dos minutos, solo habla inglés y chino, y la API oficial sigue siendo solo por invitación y sin tarifas publicadas.
Qué puede hacer Seed Audio 1.0
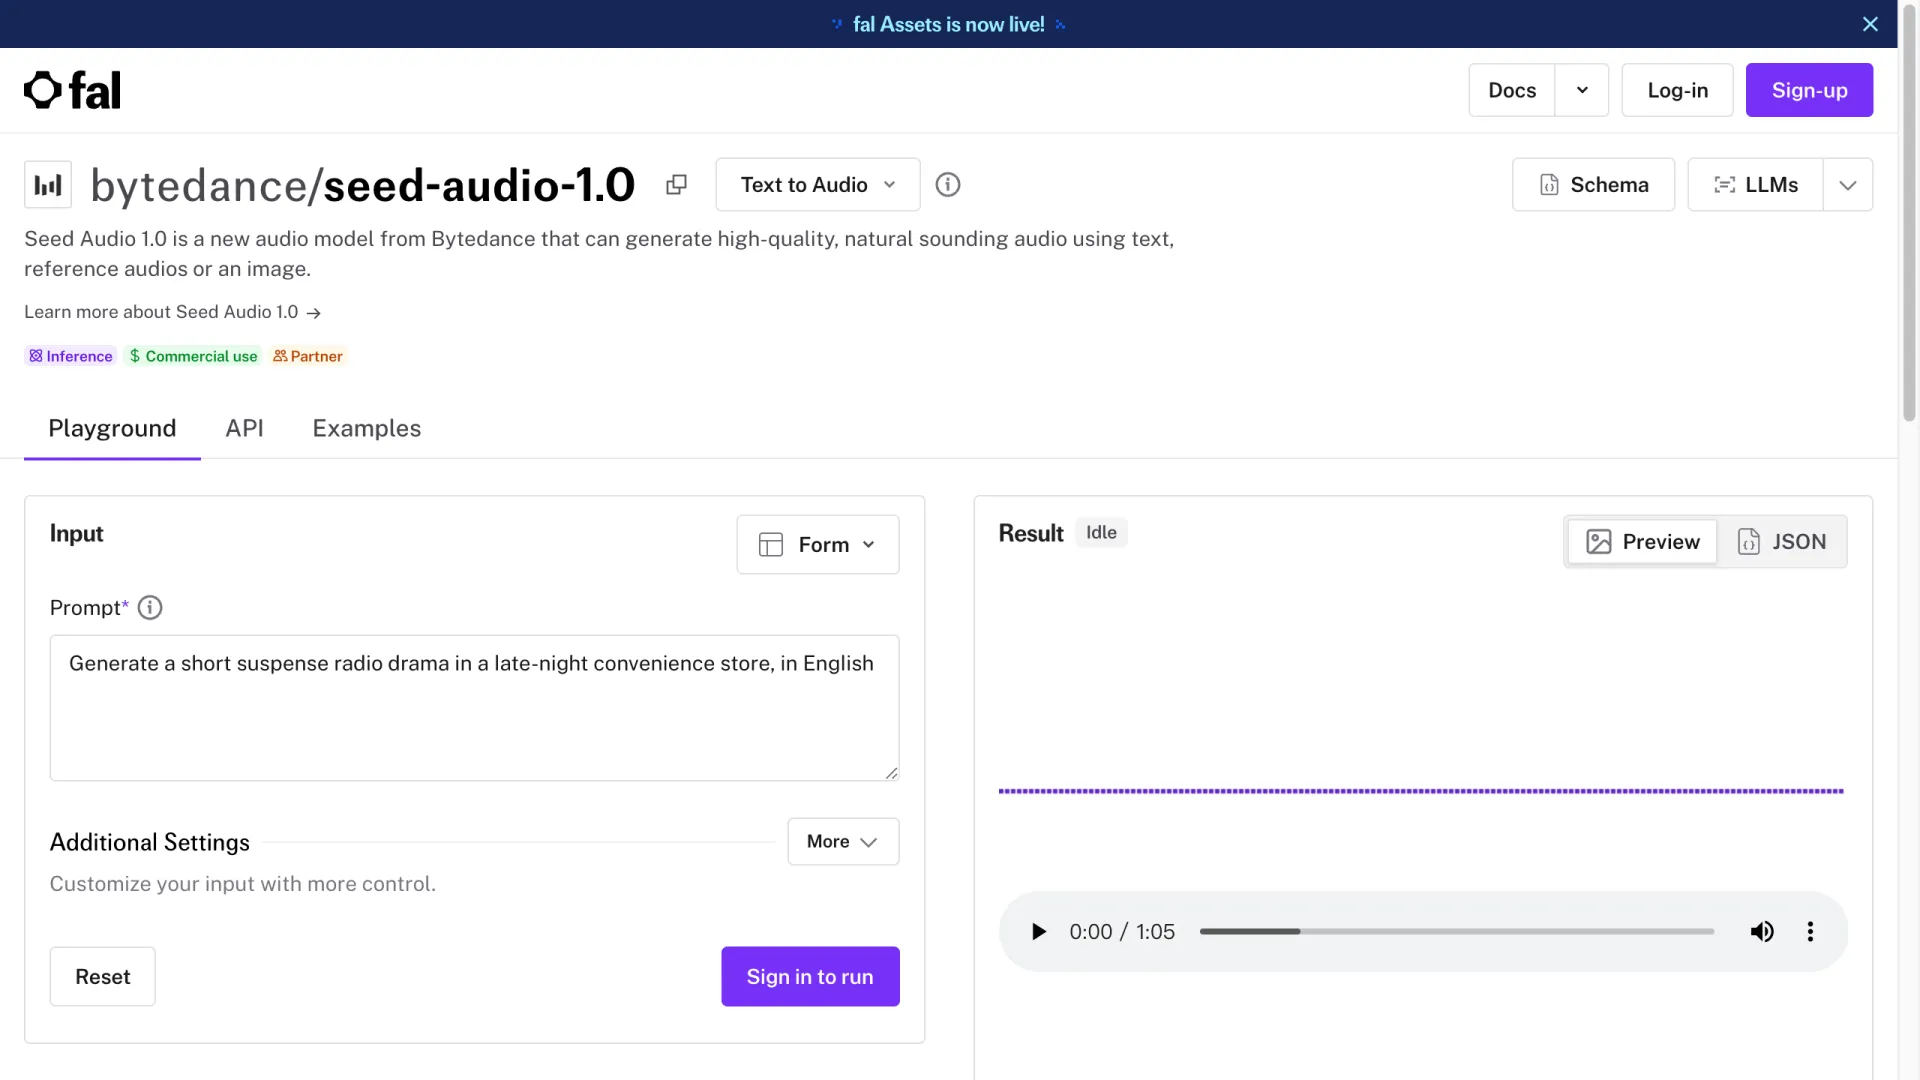
La mayoría de las herramientas de audio se especializan en una tarea: voz a partir de texto, música o efectos. Seed Audio 1.0, cuyo nombre completo es Doubao-Seed-Audio 1.0, reúne las tres en una misma línea de tiempo y las genera de una sola vez. Basta con un prompt como "un radiodrama de suspense en una tienda de conveniencia a altas horas de la noche" para obtener un audio terminado, con voces, ambiente y base musical ya mezclados.
El modelo funciona en tres modalidades. Texto a audio (T2A) crea una escena desde una descripción escrita. Texto y audio a audio (TA2A) combina clips de referencia con texto para orientar la voz y el estilo. También incluye TTS convencional para narraciones sencillas cuando solo necesitas una locución limpia. La modalidad depende de los datos que le proporciones.
Conviene aclarar una cuestión: ¿es una herramienta de clonación de voz? Seed Audio 1.0 puede hacer que una voz interprete varios papeles e imitar el tono de un clip de referencia, pero el resultado es sintético y no queda vinculado a la identidad de una persona real concreta. Es más preciso entenderlo como estilización de voz zero-shot, no como un clon sin consentimiento de alguien identificable. Se apoya en las investigaciones previas de ByteDance, Seed-TTS y Seed-Music, de ahí que reúna en un mismo modelo expresividad vocal y generación musical.
Especificaciones clave antes de usarlo
Antes de nada, comprueba si tu caso de uso encaja con sus límites duros. Estas son las cifras relevantes, contrastadas entre las fichas de modelo de fal y EvoLink:
| Especificación | Valor |
|---|---|
| Máximo de salida por generación | 120 segundos (2 minutos) |
| Límite del prompt de texto | ~1.500–2.000 caracteres (las fuentes difieren; confírmalo en la consola) |
| Audio de referencia | Hasta 3 clips, de ≤30 segundos cada uno |
| Idiomas | Solo inglés y chino |
| Formatos de salida | WAV, MP3, PCM, OGG Opus |
| Frecuencias de muestreo | 48K / 24K / 16K / 8K |
| Controles | Velocidad, tono, volumen (sin SSML) |
| Modelo de facturación | Basado en la duración de salida |
El límite de dos minutos es el que más condiciona el uso. Para un episodio completo de pódcast o una narración extensa tendrás que dividir el guion y unir los segmentos, con el riesgo de que el tono cambie entre fragmentos. Las notas del modelo de fal adelantan una actualización que ampliaría la duración por generación hacia los diez minutos, con control explícito de longitud y más idiomas. Si trabajas con formato largo, puede valer la pena esperar.
Precio de Seed Audio 1.0
Todavía no hay un precio oficial. En julio de 2026, Volcengine no ha publicado una tarifa por segundo para Seed Audio 1.0: el modelo continúa siendo solo por invitación en Volcano Ark, y las tarifas oficiales suelen llegar con la disponibilidad general. Las pasarelas como fal y EvoLink tampoco fijan una tarifa cerrada; cobran según la duración generada (coste = segundos generados × tarifa), por lo que los reintentos también cuentan. Desconfía de las cifras basadas en tokens que puedan circular: ese sistema no encaja con un modelo de audio facturado por duración.
Cómo acceder a Seed Audio 1.0 ahora mismo
Hay dos vías, y en la práctica son bastante distintas.
La opción oficial es Volcano Ark, donde Seed Audio 1.0 solo está disponible por invitación. Debes solicitar acceso, esperar la aprobación y utilizar la consola de ByteDance. Será la referencia cuando lleguen la disponibilidad general y los precios oficiales.
La alternativa práctica es una pasarela de terceros. fal aloja el modelo como bytedance/seed-audio-1.0 sin lista blanca: puedes llamar al endpoint desde su API con una clave estándar. EvoLink ofrece un acceso similar. Para la mayoría, esta es hoy la forma de generar con el modelo sin esperar una invitación.
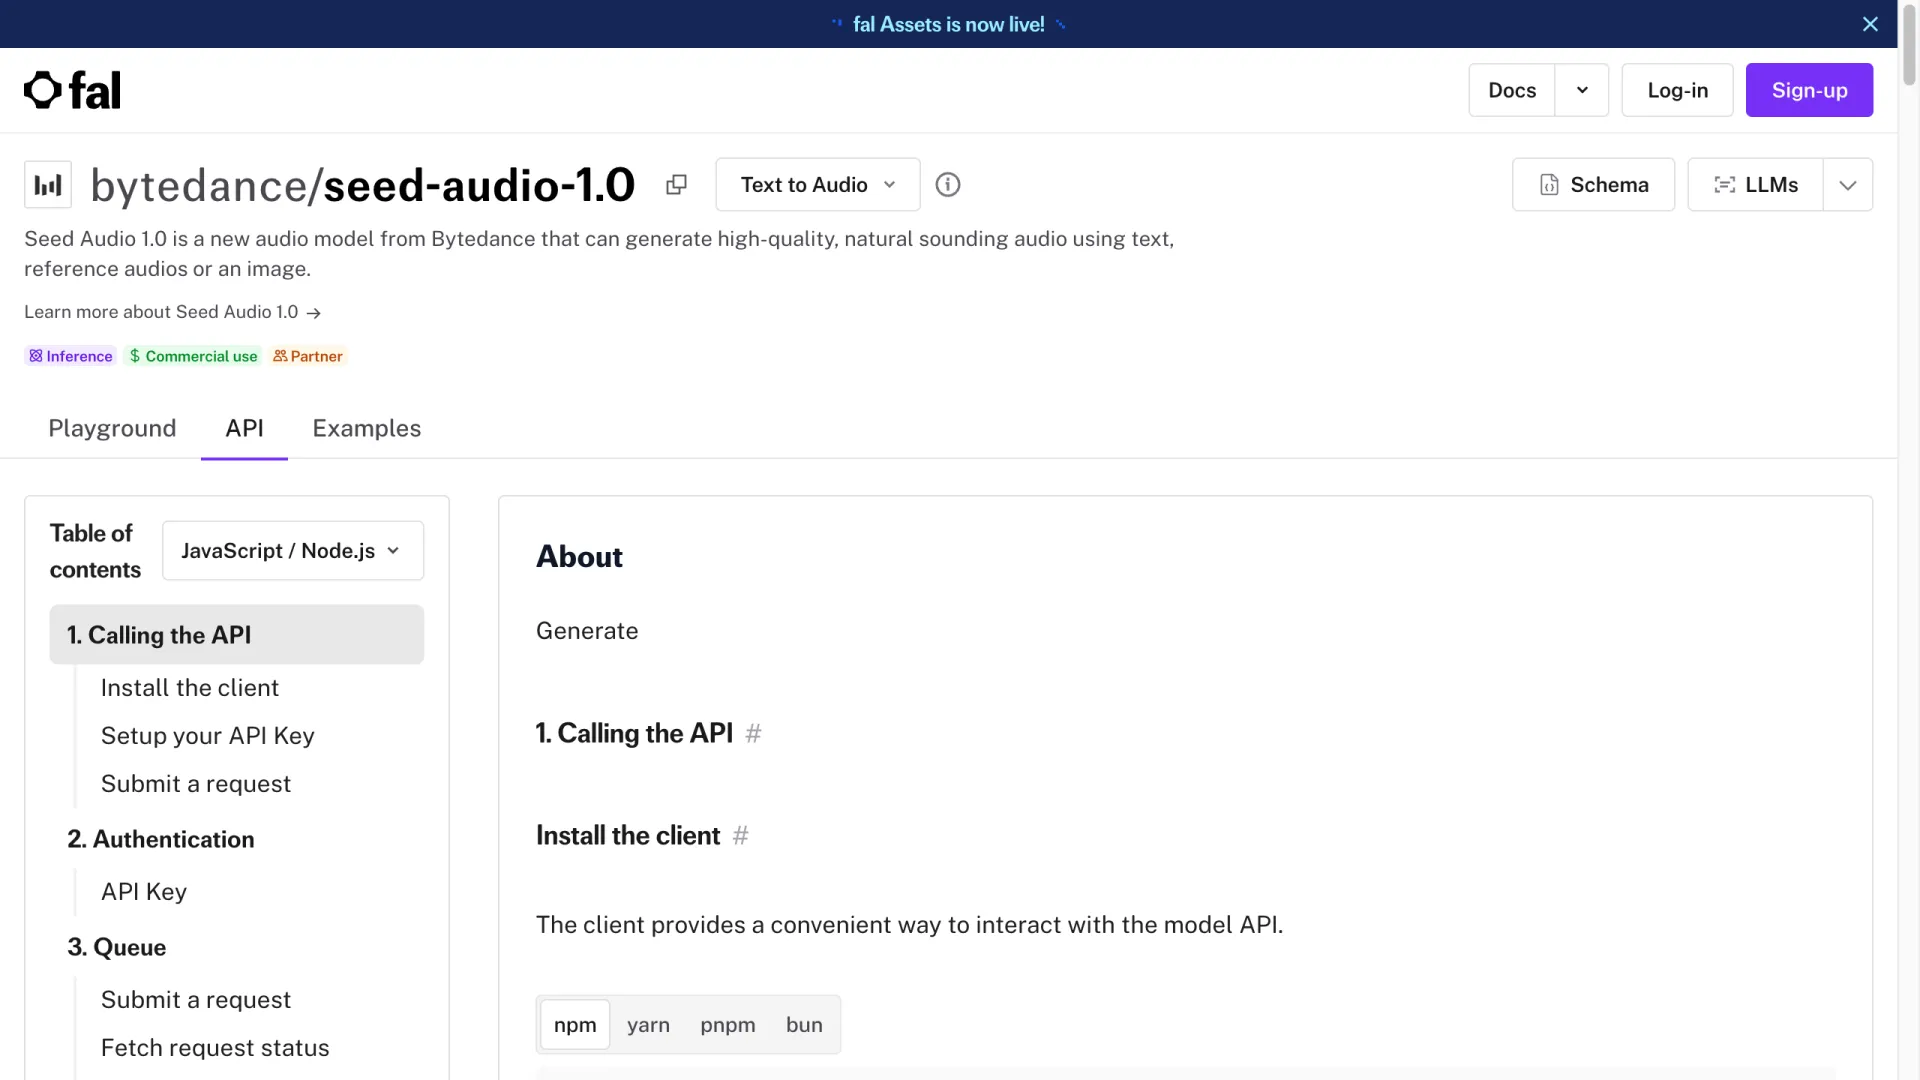
El patrón de uso es el habitual en una API basada en cola: instala el cliente, configura tu clave, envía el prompt y consulta el resultado. Si ya has integrado algún modelo generativo alojado de esta forma, no tendrás que aprender nada especial; nuestro análisis de fal.ai profundiza en la experiencia para desarrolladores.
Como primera prueba, resulta útil crear una escena breve con varias voces que ponga a prueba diálogo, ambiente y ritmo a la vez; por ejemplo: "un radiodrama de suspense de 30 segundos en una tienda de conveniencia a altas horas de la noche, en inglés". Mantén el primer clip por debajo de 30 segundos: así, si el resultado falla, el coste será bajo mientras aprendes cómo interpreta el modelo tus prompts.
Seed Audio 1.0 frente a ElevenLabs, Stable Audio y AudioCraft
La comparación importante no consiste en medir la calidad de cada clip, sino en entender para qué está diseñado cada producto.
| Herramienta | Punto fuerte | Mezcla de escenas | Idiomas | Control de voz |
|---|---|---|---|---|
| Seed Audio 1.0 | Escenas de audio completas (voz + música + SFX) | Sí, en una sola pasada | EN, CN | Estilización zero-shot |
| ElevenLabs | Voz y clonación de voz | Solo voz | 30+ | La clonación más sólida |
| Stable Audio | Generación de música y sonidos | Pista única | N/A (música) | Basado en prompts |
| AudioCraft | Música/SFX open source | Pista única | N/A (música) | Basado en prompts |
Si necesitas la mejor voz pura o clonación de voz precisa en muchos idiomas, ElevenLabs sigue ganando. Si buscas música independiente, Stable Audio o AudioCraft de Meta están concebidos para ello. La ventaja de Seed Audio 1.0 es reunir diálogo, música y efectos en una escena coherente y editable: ninguna de las otras herramientas de esta comparativa lo hace en una sola llamada.
Sus puntos fuertes y sus carencias
Donde destaca: Los diálogos con varias voces y la mezcla de música y efectos en una sola pasada son su principal atractivo. Además, los flujos de edición documentados —extender un clip, retocar una sección mediante in-painting y unir tomas, según la guía de uso de fal— lo convierten en una herramienta de producción y no en un generador de resultados aislados.
Donde se queda corto: El límite de dos minutos obliga a unir segmentos en cualquier proyecto largo. La restricción a inglés y chino deja fuera buena parte del trabajo vocal global. Es un modelo de generación offline, por lo que no sirve para agentes de voz en tiempo real. Y el acceso oficial sigue restringido por invitación.
¿Merece la pena usarlo ya?
Si tu contenido está en inglés o chino y se mueve en formato corto —doblaje, fragmentos de audiolibros, bandas sonoras para vídeos cortos o prototipos de radiodramas—, merece la pena probar Seed Audio 1.0 mediante una pasarela. Generar toda la escena de una vez elimina el trabajo manual de superponer voz, música y efectos.
Si necesitas interacción en tiempo real, un idioma no compatible o audio largo sin interrupciones, espera. La disponibilidad general y la actualización prevista de duración cambiarán el panorama. Mientras tanto, para casos de uso en directo encaja mejor un modelo en tiempo real como Qwen Audio 3. Para el resto, este es un momento de "probarlo en una pasarela y mantener activo el stack actual", no de sustituirlo todo.
Preguntas frecuentes
¿Seed Audio 1.0 es gratis?
No. No existe un nivel gratuito oficial: la API de Volcano Ark es solo por invitación y se factura por duración de salida una vez que tienes acceso. Las pasarelas de terceros aplican sus propias tarifas medidas por uso.
¿Seed Audio 1.0 puede clonar mi voz?
Puede imitar el estilo de un clip de referencia y dar voz a varios papeles, pero genera habla sintética en lugar de un clon fijo de una persona real concreta. No debe considerarse una herramienta de clonación de identidad lista para sustituir a otras.
¿Qué idiomas admite Seed Audio 1.0?
En su lanzamiento, solo inglés y chino. Según las notas del modelo de fal, una actualización prevista incorporará soporte multilingüe más amplio.
¿Cuánto puede durar el audio generado?
Actualmente, hasta 120 segundos por generación. La actualización prevista elevaría la duración de cada generación hacia los diez minutos e incluiría control explícito de longitud.
¿Existe una API oficial de Seed Audio 1.0?
Sí, en Volcano Ark de Volcengine, aunque por ahora solo se accede mediante invitación. Para acceder abiertamente sin lista blanca, puedes usar una pasarela como fal, que aloja bytedance/seed-audio-1.0.
¿Qué diferencia hay entre Seed Audio y Seed Music?
Seed-Music fue la investigación previa de ByteDance centrada en música; Seed Audio 1.0 integra esa capacidad musical con voz y efectos de sonido en un único modelo de generación de escenas.