 AIREITER
Qwen Audio 3.0 Realtime es la propuesta de audio conversacional en tiempo real de la actual familia Qwen: hablas con el modelo y este responde por voz con una latencia suficientemente baja como para recordar a una llamada telefónica. En la plataforma de Alibaba se ofrece mediante la API Qwen3-Omni / Qwen3.5-Omni Realtime, con identificadores como qwen3-omni-flash-realtime; también cuenta con Qwen-TTS-Realtime para síntesis de voz y qwen3-asr-flash para transcripción. Los modelos omni Realtime alojados reconocen más de 100 idiomas, permiten conversaciones full-duplex con interrupciones y cuestan una fracción de céntimo por minuto.
La puerta de entrada más rápida es qwen3-omni-flash-realtime a través de WebSocket. A continuación repasamos qué hace cada modelo, cuánto cuesta, cómo se sitúa frente a OpenAI Realtime y Gemini Live, y cómo empezar a usarlo. Todas las especificaciones, precios e identificadores de modelo enlazan a su fuente primaria, principalmente la documentación Realtime de Model Studio de Alibaba y la ficha del modelo Qwen3-Omni. Este mercado cambia rápido, así que conviene dar prioridad a la fuente enlazada si alguna cifra ha variado.
Cómo encajan los modelos de audio de Qwen
La línea de audio de Qwen abarca varias generaciones. Entender esa evolución ayuda a elegir el modelo adecuado:
Qwen-Audio(2023) yQwen2-Audioeran modelos de comprensión de audio: recibían audio y devolvían texto. No respondían hablando.- La generación actual integra el audio en los modelos omni.
Qwen3-OmniyQwen3.5-Omniprocesan texto, imágenes, audio y vídeo, y generan tanto texto como voz natural. - El comportamiento en tiempo real es una modalidad de acceso: son los mismos modelos omni invocados mediante la Realtime API, con IDs de modelo terminados en
-realtime.
Por tanto, «Qwen Audio 3.0 Realtime», con la puntuación que se prefiera, se refiere a la familia Qwen3-Omni utilizada en tiempo real. Ese es el conjunto de herramientas que cubre el resto de esta guía.
Las tres piezas del audio en tiempo real de Qwen
Más que un único modelo, conviene verlo como una canalización. Una aplicación de voz en producción suele utilizar tres modelos de Qwen, que pueden combinarse o emplearse por separado.
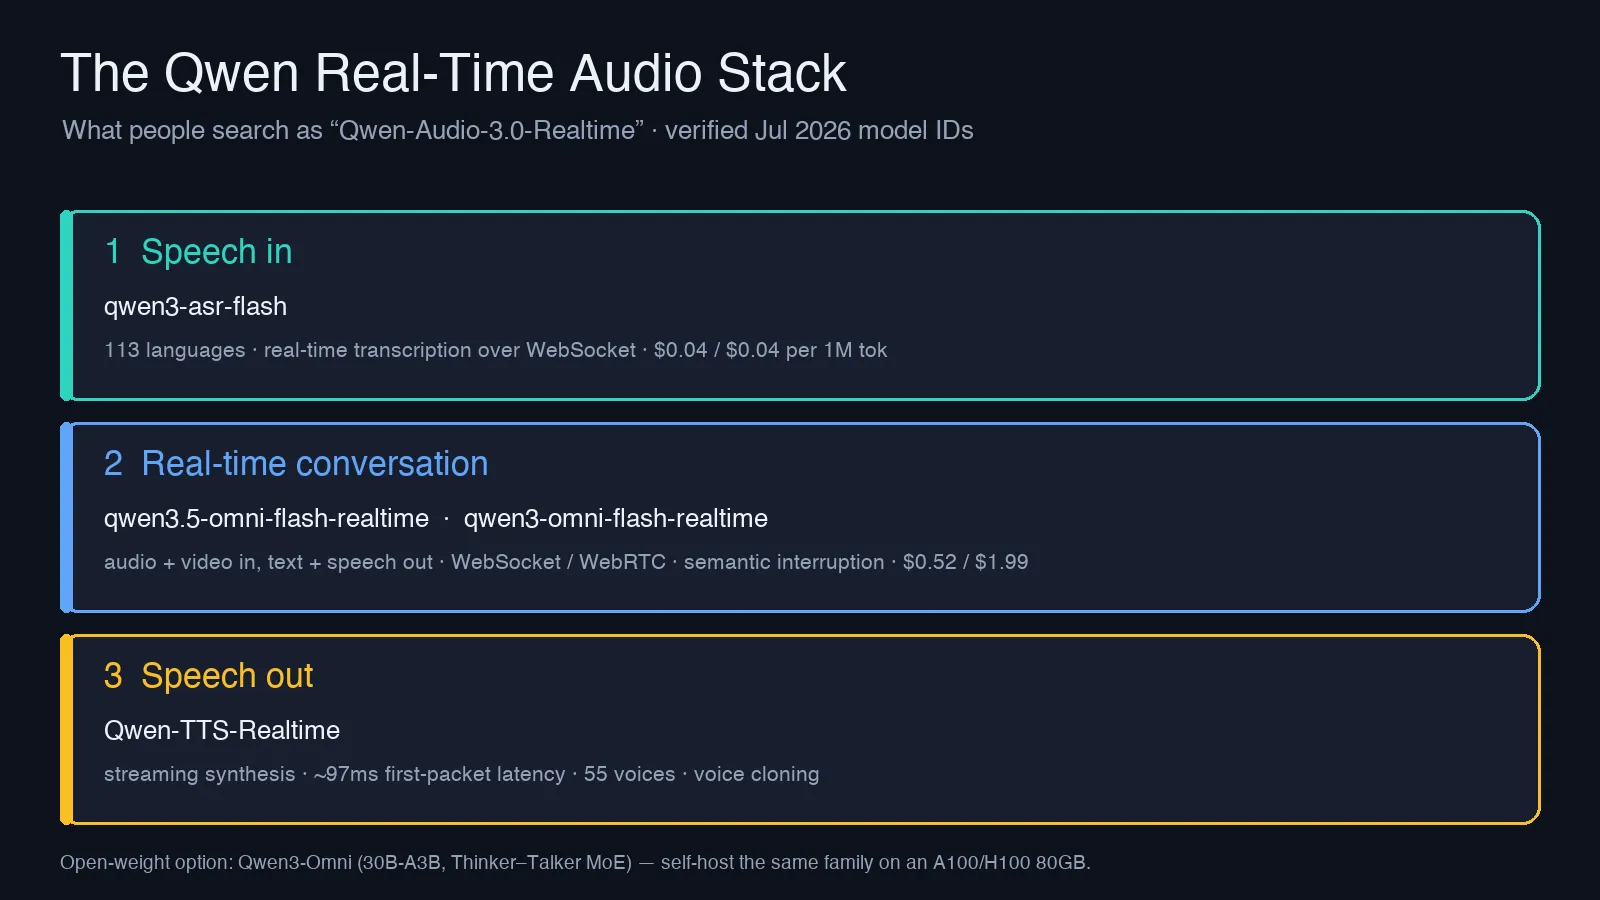
- Entrada de voz —
qwen3-asr-flash. Reconocimiento de voz en streaming mediante WebSocket, pensado para subtítulos en directo y front ends de agentes de voz. Transcribe en una gama muy amplia de idiomas y está planteado como una opción económica para transcripción. - Conversación en tiempo real —
qwen3.5-omni-flash-realtime,qwen3-omni-flash-realtime,qwen3.5-omni-plus-realtime. Es el núcleo: recibe audio —y fotogramas de vídeo— y devuelve texto y voz sintetizada mediante una conexión persistente que se mantiene entre turnos, sin reabrirse en cada solicitud. - Salida de voz —
Qwen-TTS-Realtime. Un modelo específico de texto a voz en streaming para los casos en que solo se necesita convertir texto en voz; por ejemplo, para leer la respuesta generada por un LLM de texto.
Si usas un modelo omni Realtime en la capa central, a menudo no necesitarás llamadas independientes a ASR y TTS: resuelve de extremo a extremo la entrada y la salida de voz. Los modelos separados están ahí para quienes prefieren combinar componentes, como un STT propio con el TTS de Qwen.
Las especificaciones que importan de verdad
Estas son las cifras de la documentación Realtime de Model Studio, no de páginas de marketing.
| Atributo | Qwen Realtime API (familia omni) |
|---|---|
| Entrada de audio | PCM, 16 kHz |
| Salida de audio | PCM, 24 kHz |
| Otras entradas | Fotogramas de imagen / vídeo (JPG, hasta 1080p, 256 KB tras la codificación) |
| Reconocimiento de voz | 113 idiomas y dialectos (API alojada) |
| Generación de voz | 36 idiomas y dialectos |
| Voces | 55 en total (47 multilingües, 8 dialectales), además de clonación de voz en los modelos 3.5 |
| Conexiones | WebSocket (autenticación Bearer, VAD manual o del servidor) y WebRTC (negociación SDP) |
| Duración máxima de sesión | 120 minutos mediante WebSocket |
| Funciones adicionales | Interrupción semántica, function calling, búsqueda web autónoma y control por voz de volumen / velocidad / emoción |
Hay varios puntos que merecen destacarse. La interrupción semántica permite al modelo distinguir entre una intervención del usuario y una simple señal de escucha, como un «ajá». Esa diferencia separa a un agente de voz natural de uno irritante. La compatibilidad con WebRTC es especialmente relevante en aplicaciones de navegador, ya que resuelve por ti la cancelación de eco y el jitter. Y la cifra de reconocimiento en 113 idiomas corresponde a la API alojada; como veremos más adelante, la versión de pesos abiertos cubre un conjunto más limitado.
En cuanto a latencia, la ruta de streaming de Qwen-TTS-Realtime apunta a unos 97 ms de latencia hasta el primer paquete, según la documentación de streaming de Qwen3-TTS. Es la métrica que determina si la voz parece inmediata, y mide el tiempo hasta el primer fragmento de audio, no hasta completar una respuesta. Para el ciclo conversacional completo, la arquitectura Thinker–Talker está diseñada para streaming; el informe técnico de Qwen3-Omni describe un diseño multi-codebook orientado a reducir la latencia, mientras que pruebas de la comunidad sitúan la respuesta de audio a audio por debajo de los 250 ms, con turnos full-duplex e interrumpibles. Las cifras reales dependen de la región, la red y la carga, así que es mejor medirlas con tu propio tráfico que fiarse de un único titular.
Precios de Qwen para audio en tiempo real, sin rodeos
Los precios alojados de Qwen para tiempo real son sensiblemente inferiores a los de las APIs cerradas de tiempo real. Estas son las tarifas por millón de tokens, de entrada / salida, recogidas en el directorio de modelos DashScope de Portkey, un agregador externo que replica las tarifas de Alibaba. Antes de comprometerte, confirma el precio vigente en la consola de Model Studio:
| Modelo | Entrada / 1M tok | Salida / 1M tok |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash (transcripción) | $0.04 | $0.04 |
Traducido a una llamada real. El audio consume muchos tokens: aproximadamente 427 tokens por minuto de audio. Imagina una conversación de voz de 10 minutos, con 5 minutos de habla del usuario y 5 minutos de respuesta del modelo. En qwen3-omni-flash-realtime serían unos 2.135 tokens de entrada y 2.135 de salida: alrededor de $0.001 de entrada + $0.004 de salida ≈ medio céntimo por llamada de 10 minutos. Incluso a escala, el audio en tiempo real resulta económico; el componente que suele sorprender es el tiempo de habla de salida, ya que las respuestas habladas cuestan aproximadamente 4 veces más que la entrada.
Antes de hacer presupuestos, conviene tener en cuenta dos detalles más:
- Hay cuota gratuita, pero depende de la región. El endpoint de Singapur, internacional, ha ofrecido 1 millón de tokens de entrada y 1 millón de tokens de salida gratis durante 90 días; el endpoint de EE. UU. no. Las cuotas cambian, así que verifica la oferta actual de tu región en la consola de Model Studio antes de basar tu planificación en ella.
- El nivel
qwen3.5-omniaplica tramos de precio según el tamaño de la solicitud, en lugar de una tarifa plana. Una petición con mucho contexto puede caer en una banda distinta que varias solicitudes pequeñas. Pruébalo con la forma real de tu tráfico antes de decidir.
Frente a OpenAI Realtime y Gemini Live
Entre los proveedores generalistas de LLM de frontera, las tres opciones evidentes para voz a voz en tiempo real a mediados de 2026 son Realtime API de OpenAI, Gemini Live de Google y la familia omni Realtime de Qwen. Los proveedores especializados de voz, como ElevenLabs, Deepgram, Cartesia y Hume, compiten con fuerza específicamente en TTS y STT; esta comparación se centra en la vía del modelo multimodal integral. En vez de citar precios de competidores que cambian cada mes, así es como conviene plantear la elección:
- Coste. Con las tarifas por llamada mostradas arriba, Qwen se sitúa en el extremo económico de las opciones alojadas de modelos de frontera. Como contraste, el audio de OpenAI Realtime ha rondado los $0.06 por minuto de entrada y $0.24 por minuto de salida (desglose de precios aquí); con esa referencia, la misma llamada de 10 minutos que cuesta cerca de medio céntimo en
qwen3-omni-flash-realtimese acerca a los $1.50 en OpenAI. Confirma las tarifas vigentes en ambos lados antes de depender de esa diferencia, porque todas cambian, pero la distancia es considerable. Qwen también es el único de los tres con una versión de pesos abiertos que puedes alojar por tu cuenta para reducir el coste marginal casi a cero. - Apertura. OpenAI Realtime y Gemini Live solo están disponibles como APIs cerradas. Qwen3-Omni publica sus pesos, de modo que puedes pasar de un servicio alojado a uno propio sin rehacer tu aplicación para adaptarla al comportamiento de otro modelo.
- Calidad. Cobertura de terceros indica que el nivel superior
qwen3.5-omni-plusiguala o supera a Gemini 3.1 Pro en algunos benchmarks de comprensión de audio. Toma cualquier benchmark aislado como una hipótesis inicial y pruébalo con tu propio audio. - Ecosistema. OpenAI y Google tienen actualmente herramientas, SDKs y ejemplos de comunidad más maduros. La documentación de Qwen es sólida, aunque tendrás que apoyarte más en la especificación directa de WebSocket/WebRTC.
La conclusión práctica es sencilla: Qwen es la opción más fuerte si importa el coste o la posibilidad de alojar el modelo por cuenta propia. Si buscas la experiencia de SDK más pulida y aceptas pagarla, OpenAI y Google siguen por delante en acabado. Para un desglose completo de costes de las alternativas cerradas, consulta las lecturas relacionadas al final.
Qué variante elegir según tu caso
| Tu situación | Usa |
|---|---|
| El ciclo completo de voz alojado más barato | qwen3-omni-flash-realtime |
| La mejor calidad alojada, sesiones más largas y clonación de voz | qwen3.5-omni-plus-realtime |
| Solo necesitas transcripción | qwen3-asr-flash |
| Solo necesitas texto a voz | Qwen-TTS-Realtime |
| Los datos deben permanecer en tu propio hardware | Aloja por tu cuenta Qwen3-Omni de pesos abiertos (30B-A3B) |
Los niveles 3.5 añaden clonación de voz y límites más amplios de contexto y diálogo, hasta 100 turnos y 600 segundos de audio retenido, frente a los 8 turnos del más ligero qwen3-omni-flash. Para un prototipo, empieza con Flash; pasa a Plus solo cuando encuentres una limitación concreta.
Cómo acceder a Qwen Realtime
Servicio alojado, por la vía directa. Crea una clave API en Alibaba Cloud Model Studio y abre una conexión WebSocket con autenticación Bearer. Para aplicaciones de navegador, también puedes negociar WebRTC mediante un POST SDP. Envías audio PCM en streaming y recibes audio PCM junto con texto. El SDK de DashScope para Python encapsula la interfaz Realtime si prefieres no gestionar el socket directamente. La conexión mínima es corta; este esquema omite el manejo de errores:
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. configure the session: voice, output format, server-side turn detection
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. stream microphone audio up as base64 PCM 16 kHz frames
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. read events back; response.audio.delta carries PCM 24 kHz to play
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
Con VAD del servidor, el modelo decide cuándo ha terminado de hablar el usuario; cambia a modo manual si quieres controlar tú mismo los límites de cada turno. El flujo de eventos se parece mucho al de OpenAI Realtime, por lo que el código de clientes Realtime existentes se puede portar con pocos cambios. Antes de lanzar a producción, comprueba en la documentación Realtime los nombres exactos de los campos, la lista de voces y el host del endpoint regional: difieren entre los despliegues de Singapur y EE. UU. y evolucionan con la API.
Alojamiento propio. El Qwen3-Omni de pesos abiertos usa un diseño Thinker–Talker Mixture-of-Experts, con 30B de parámetros totales y unos 3B activos. Alibaba recomienda vLLM en lugar de Transformers sin optimizar. Para inferencia BF16 del modelo completo de 30B, las guías de despliegue de terceros sitúan el mínimo en una sola tarjeta de 80 GB, A100 o H100. Una tarjeta de 24 GB como la RTX 4090 no basta para los pesos completos, aunque las compilaciones cuantizadas reducen ese requisito.
La contrapartida es que servir en tiempo real resulta más difícil que la inferencia por lotes. Quienes lo alojan por su cuenta informan de que deben limitar la caché KV para evitar bloqueos con carga concurrente, y de que el rendimiento de tokens en una sola tarjeta queda por debajo de la API alojada. Las pilas de serving optimizadas para streaming reducen buena parte de esa brecha: ingenieros de Red Hat AI y vLLM han informado de que solapar las etapas de la canalización reduce la generación de voz de un clip de 3 segundos desde unos 8 segundos hasta alrededor de 0.5. Es una mejora real, pero exige trabajo adicional de ingeniería. El alojamiento propio elimina el coste por token, a cambio de sumar costes de GPU y operaciones; compensa con un volumen alto y sostenido, no para prototipos.
Para voz omni en tiempo real hoy, el endpoint de DashScope es la vía canónica. Si tu stack ya enruta varios proveedores a través de una única pasarela, puedes poner un agregador delante, pero confirma primero que incluye los IDs concretos de modelos Qwen realtime: muchos relés ofrecen modelos de texto e imagen, pero no el nivel de audio en tiempo real.
Límites que conviene conocer antes de integrarlo
- Las sesiones tienen un límite de 120 minutos. Para interacciones más largas, como una línea de soporte o una tutoría prolongada, necesitarás lógica de reconexión que conserve el contexto entre sockets.
- La región afecta tanto a la cuota gratuita como a la disponibilidad. Prueba contra el endpoint donde vayas a desplegar, no contra el primero en el que te registraste.
- La API alojada y los pesos abiertos no son idénticos. La API alojada anuncia reconocimiento en 113 idiomas y generación en 36; la versión Qwen3-Omni de pesos abiertos cubre un conjunto menor: 19 idiomas de entrada de voz y 10 de salida. Si necesitas un idioma concreto, verifícalo en la variante exacta que vayas a desplegar.
- El coste en tiempo real crece con el tiempo de conversación, no con el número de solicitudes. Como el audio consume muchos tokens, un usuario locuaz cuesta más que uno breve. Modela la factura según los minutos de conversación, no según la cantidad de llamadas.
Preguntas frecuentes
¿Qwen 3 admite audio?
Sí. Los modelos Qwen3-Omni son multimodales de forma nativa: aceptan audio, texto, imágenes y vídeo como entrada, y pueden responder con texto o voz en tiempo real.
¿Qwen puede generar audio, además de comprenderlo?
Sí. A diferencia del Qwen-Audio original, que solo producía texto, los modelos omni Realtime y Qwen-TTS-Realtime generan audio hablado, incluidas voces clonadas en el nivel 3.5.
¿El audio en tiempo real de Qwen es gratuito?
Existe una cuota de prueba gratuita que históricamente ha sido de 1 millón de tokens de entrada y 1 millón de salida durante 90 días en el endpoint internacional de Singapur. Después se paga por token; Qwen3-Omni, completamente de pesos abiertos, es gratuito de ejecutar si aportas tu propia GPU.
¿Cómo ejecuto Qwen audio en local?
Descarga Qwen3-Omni (30B-A3B) de pesos abiertos y sírvelo con vLLM. Para el modelo completo en BF16 necesitarás aproximadamente una tarjeta de 80 GB, A100 o H100; las GPU de consumo más pequeñas solo pueden manejar compilaciones cuantizadas, no los pesos completos.
Lecturas relacionadas
Fuentes primarias:
- Documentación de Alibaba Model Studio Realtime API
- Ficha del modelo y pesos abiertos de Qwen3-Omni (GitHub)
Precios de las alternativas: