 AIREITER
OpenAI ya acumula tres nombres con «fast» o «ultra», pero solo uno promete alcanzar 750 tokens por segundo. OpenAI Ultrafast mode, anunciado el 13 de agosto de 2026, es un nuevo nivel de servicio para la API que ejecuta GPT-5.6 Sol sobre chips wafer-scale de Cerebras y puede llegar a ser hasta 14 veces más rápido que Standard. El problema es que sigue siendo por invitación y OpenAI no ha publicado su precio. Por ahora, el nivel más rápido que cualquier cliente puede contratar es Fast mode, con tarifas de $10/$60 por millón de tokens.
Qué distingue a ultra, Fast mode y Ultrafast
Quien compre GPT-5.6 Sol se encontrará hoy con tres etiquetas relacionadas con la velocidad, aunque cada una describe algo muy distinto. Esta tabla las separa de un vistazo.
| Nombre | Qué es | Cómo se accede | Precio de Sol (por 1M de tokens) | Velocidad anunciada |
|---|---|---|---|---|
Ajuste de razonamiento ultra | Un modo de razonamiento/trabajo que dedica subagentes y cómputo adicional a una misma tarea | Ajuste de Codex, no un nivel de API que se contrate por separado | Sin tarifa independiente; consume rápidamente los límites de uso | Más lento por diseño |
| Fast mode | Nivel de procesamiento de la API, renombrado desde Priority el 30 de julio de 2026 | service_tier="fast" en cualquier solicitud a la API | $10 de entrada / $60 de salida (contexto corto) | Hasta 2,5 veces Standard |
| Ultrafast mode | Nivel de API impulsado por Cerebras para GPT-5.6 Sol, presentado en vista previa el 13 de agosto de 2026 | Vista previa limitada, solo para clientes seleccionados | No divulgado | Hasta 14 veces Standard |
En realidad, van en direcciones opuestas: ultra es el modo de trabajo con subagentes que cambia velocidad por profundidad, mientras que Ultrafast mode busca acelerar la generación pura con el mismo modelo. Fast mode queda en medio como mejora de latencia contratable, con documentación independiente en la página de Fast mode de OpenAI.
Qué incluye realmente la vista previa del 13 de agosto
El anuncio oficial confirma cinco datos concretos: Ultrafast llega primero a la API de OpenAI, funciona únicamente con GPT-5.6 Sol, ofrece hasta 14 veces la velocidad de procesamiento Standard y hasta 750 tokens de salida por segundo, utiliza Cerebras y se lanza como vista previa limitada para un grupo selecto de clientes, entre ellos Jane Street, Podium, Basis y Rogo.
También deja fuera cuatro datos que cualquier comprador querría conocer: el precio por token, el ID del modelo, los límites de tasa y un SLA de latencia. Tampoco aporta benchmarks con nombre.
La demostración de OpenAI compara Ultrafast y Standard Sol creando un simulador de almacén 3D a partir de un único prompt. Una cita de Alex Wang, de Rogo, resume la propuesta: «Ultrafast hace que la investigación financiera compleja se sienta como una interacción en tiempo real».
De 2,5x a 14x: qué aporta esa diferencia de velocidad
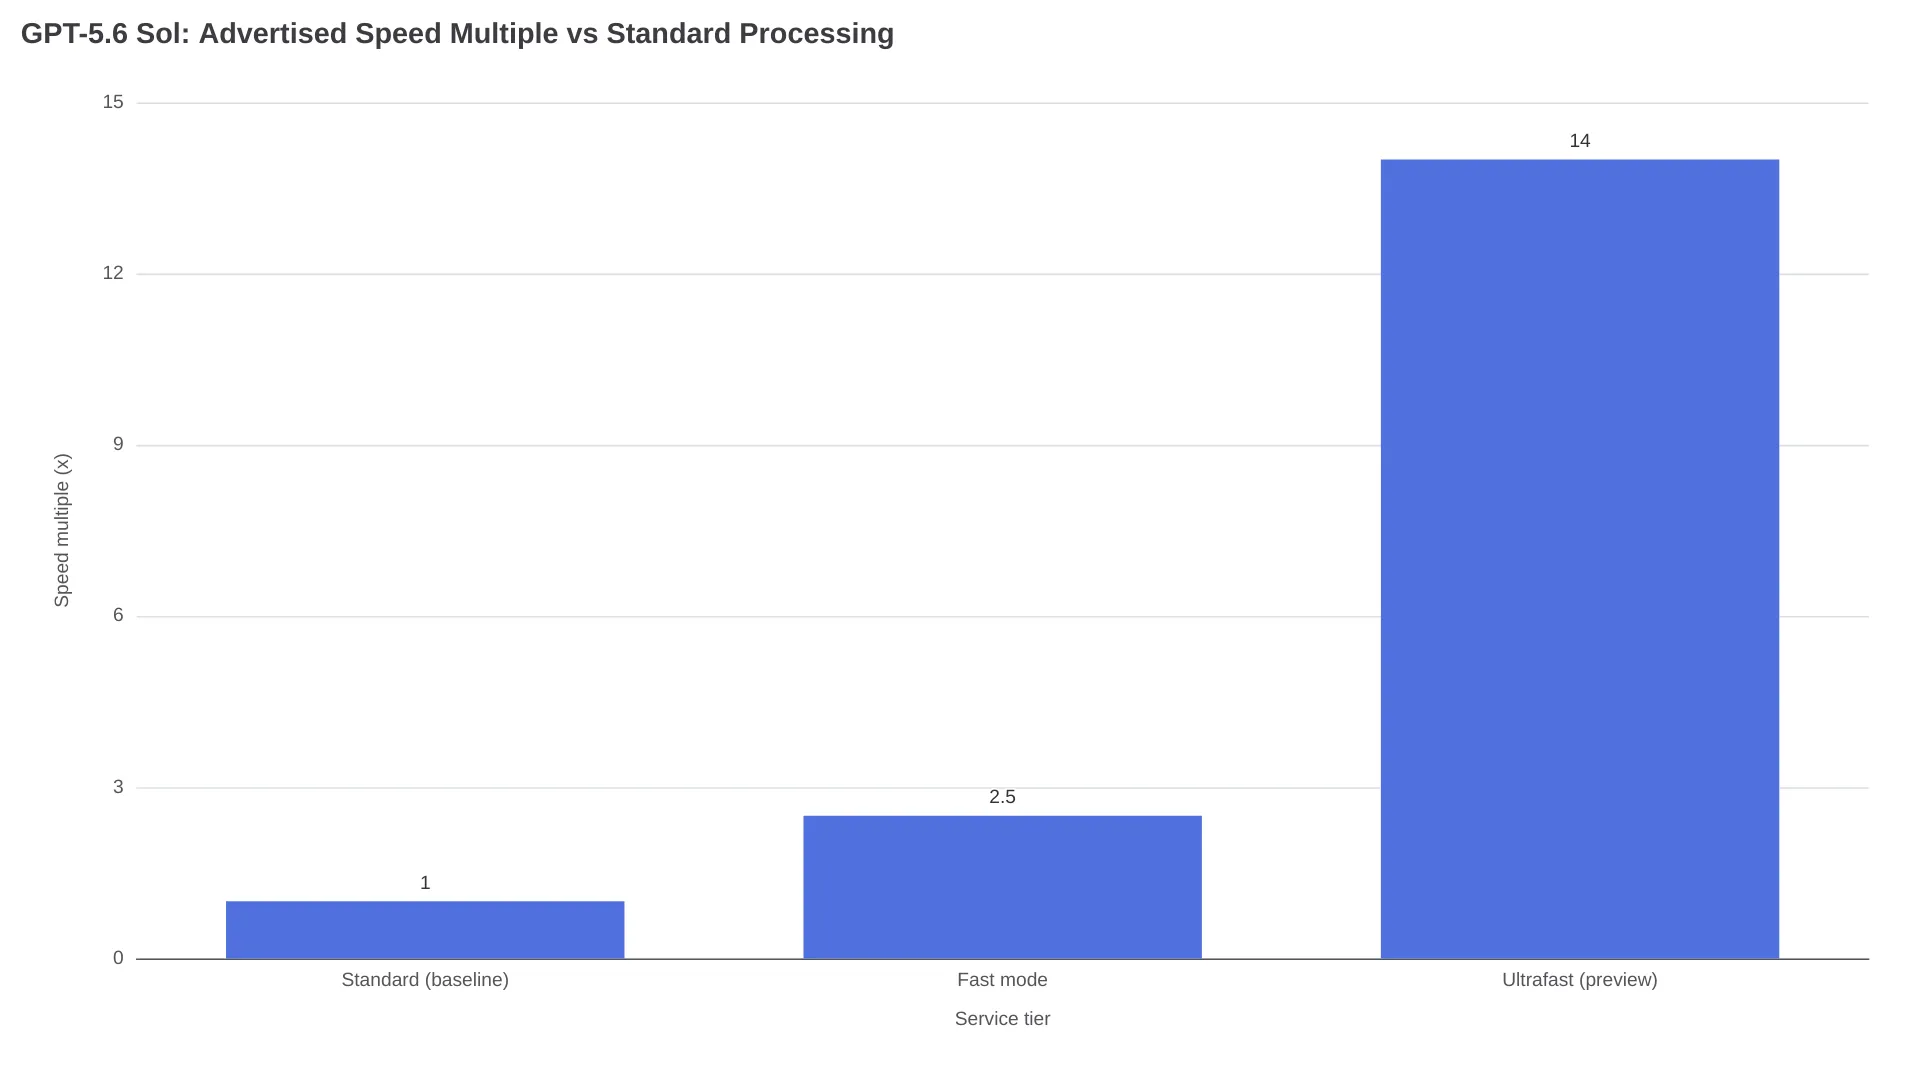
Antes de comparar, conviene matizar una cuestión de medición: los 750 tokens por segundo son el rendimiento de salida anunciado, mientras que la cifra de Fast mode es un mínimo de SLA. Son métricas relacionadas, pero no idénticas. Si se divide 750 entre 14, Standard Sol decodificaría aproximadamente 54 tokens por segundo. Con ello, una generación de 10.000 tokens tardaría cerca de 186 segundos en Standard, hasta 125 segundos con el mínimo de SLA Enterprise de Fast mode, de 80 tokens por segundo, y unos 13 segundos con Ultrafast.
| Carga de trabajo | Standard (~54 tok/s, derivado) | Fast mode (SLA ≥80 tok/s) | Ultrafast (750 tok/s anunciados) |
|---|---|---|---|
| Generación de 10.000 tokens | ~186 s | ≤125 s | ~13 s |
| Bucle de agente de 5 turnos, 1.000 tokens/turno | ~93 s | ≤63 s | ~7 s |
Las cifras que circulan en r/AIToolsPerformance atribuyen estas comparaciones a Artificial Analysis y Cerebras: Ultrafast sería 11 veces más rápido que Claude Fable 5 y 5 veces más rápido que Opus 4.8 en Fast mode. También sitúan una ejecución completa de Humanity's Last Exam, con 2.500 preguntas, en 11 horas y 11 minutos, frente a las 78 horas y 27 minutos de Fable 5. Todos esos resultados proceden de proveedores; todavía no hay replicación independiente.
El precio que nadie fuera de la vista previa conoce
No hay precios públicos para Ultrafast. El anuncio no menciona ninguna tarifa y la comunidad detectó enseguida esa ausencia. Como escribió un usuario de r/AIToolsPerformance: «Lo que el blog no dice es el precio. Nadie fuera de la vista previa sabe cuánto cuesta».
La escala de precios conocida para GPT-5.6 Sol, siempre por millón de tokens, es por ahora la única referencia disponible:
| Nivel | Entrada (ctx corto) | Salida (ctx corto) | Entrada (ctx largo >272k) | Salida (ctx largo) | Entrada en caché |
|---|---|---|---|---|---|
| Standard | $5.00 | $30.00 | $10.00 | $45.00 | $0.50 |
| Fast mode | $10.00 | $60.00 | $20.00 | $90.00 | $1.00 |
| Ultrafast | No divulgado | No divulgado | No divulgado | No divulgado | No divulgado |
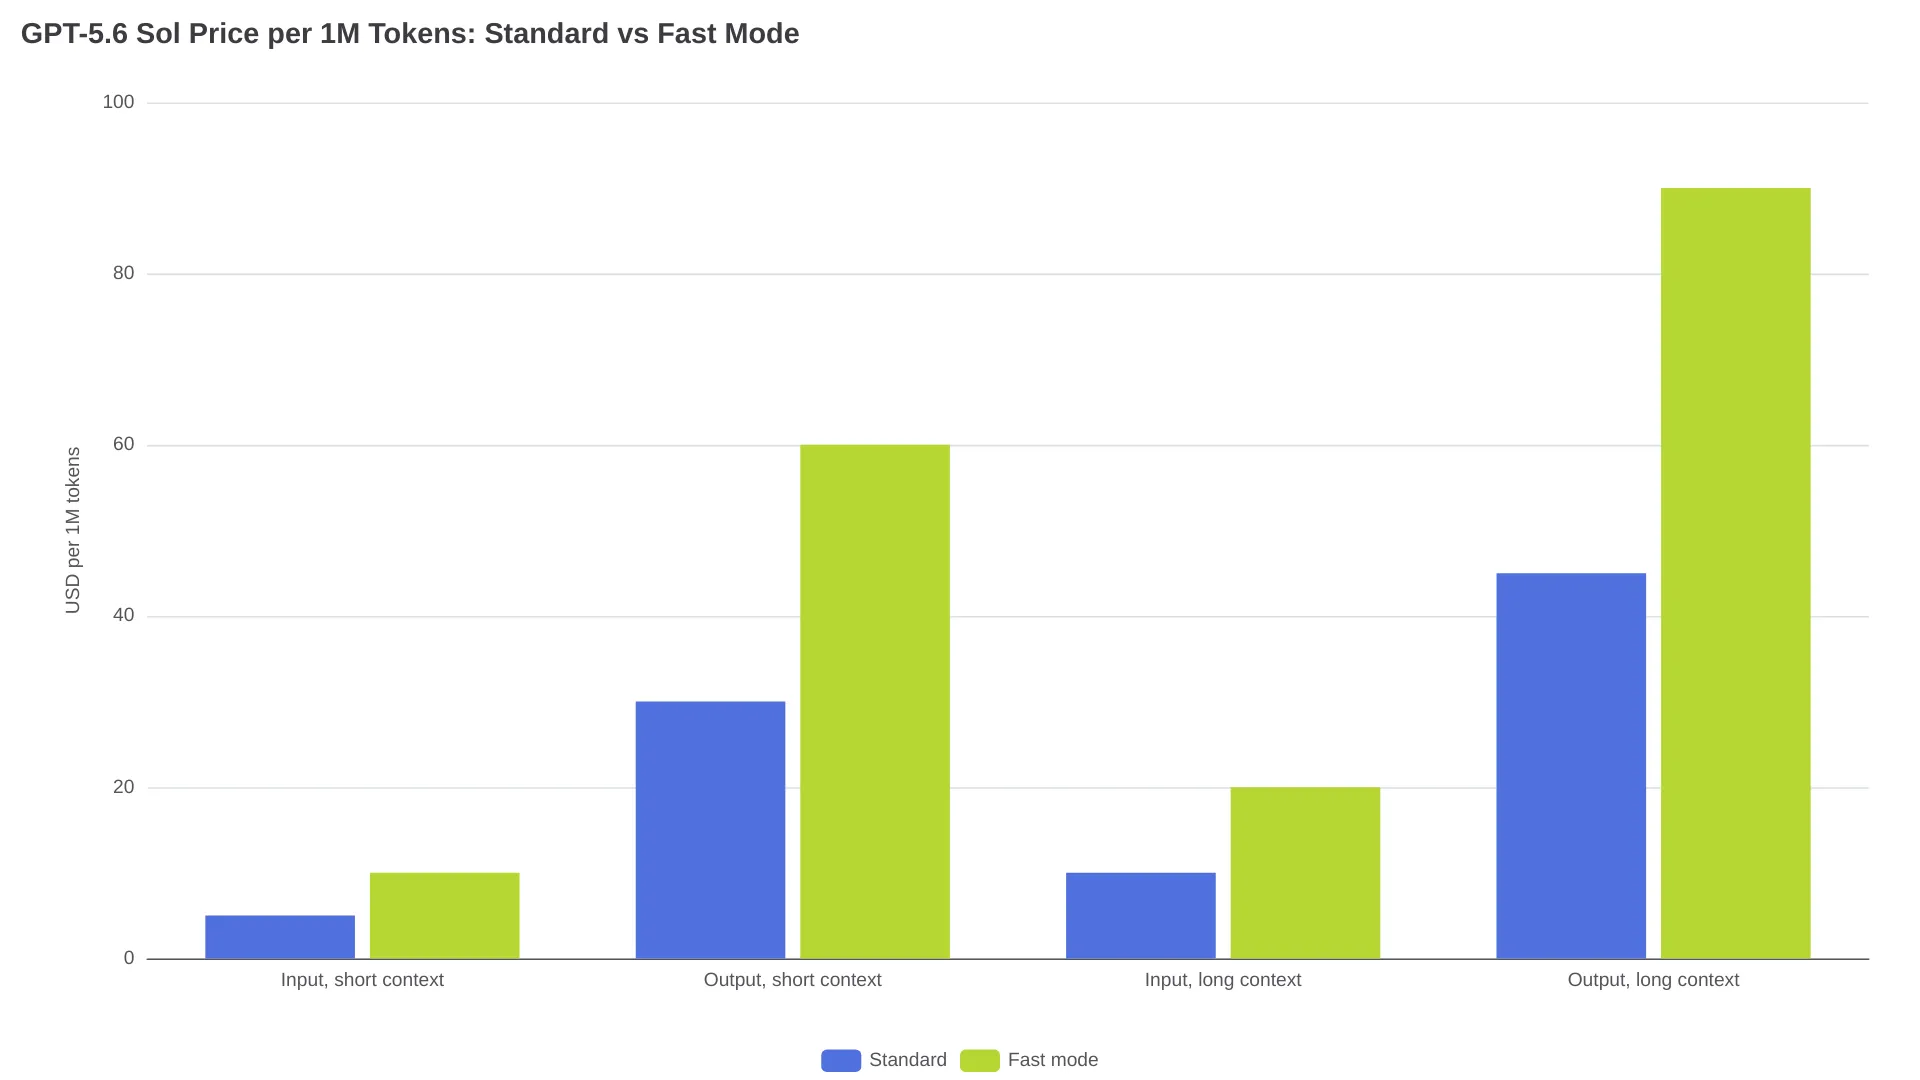
Fast mode cuesta exactamente el doble que Standard para Sol, pero la información pública no permite extrapolar el precio de Ultrafast a partir de ese multiplicador. Las tarifas pueden variar en cualquier dirección: OpenAI recortó los precios de Terra/Luna el 30 de julio. La letra pequeña de Fast mode también importa al calcular un presupuesto de latencia: si se supera 1 millón de tokens por minuto y el tráfico aumenta más de un 50% en menos de 15 minutos, las solicitudes excedentes bajan silenciosamente a Standard, devuelven service_tier="Default" y se facturan a tarifas Standard.
Acceso a Ultrafast: así funciona hoy
El acceso a Ultrafast se gestiona mediante invitación, no a través de una lista de espera pública. OpenAI indica que la vista previa se ampliará «a medida que crezca la capacidad» y ofrece un registro para recibir novedades de acceso en la página del anuncio. Además, una información de julio cifraba en apenas unas 20 las organizaciones con acceso temprano a Sol.
La infraestructura no parte de cero: la alianza de OpenAI con Cerebras se remonta al 14 de enero de 2026 y reserva 750 MW de capacidad wafer-scale. Por su parte, GPT-5.3-Codex-Spark ya superaba los 1.000 tokens por segundo sobre el mismo hardware.
Cómo obtener respuestas rápidas mientras llega la invitación
Fast mode está disponible ya para cualquier cliente de la API, y activarlo solo requiere cambiar un parámetro:
- Añade
service_tier="fast"a una solicitud en/v1/responseso/v1/chat/completions. - Los valores heredados
service_tier="priority"siguen funcionando: los modelos existentes aún muestranpriorityen los paneles de uso, mientras que los modelos posteriores a GPT-5.6 mostraránfast. - Para establecerlo como predeterminado en todo un proyecto, ve a Project settings -> Default Service Tier -> Fast.
| Modelo con Fast mode | Precio por 1M (entrada / salida) | SLA de latencia |
|---|---|---|
| GPT-5.6 Sol | $10 / $60 | >80 tok/s |
| GPT-5.6 Terra | $4 / $24 | >70 tok/s |
| GPT-5.6 Luna | $0.40 / $2.40 | >100 tok/s |
Luna tiene el mínimo de SLA más alto de los tres. Las lecturas de caché reducen un 90% el coste de entrada: $0.50/M en Standard Sol con un TTL de aproximadamente 30 minutos. Por eso, una sesión de larga duración resulta preferible a solicitudes nuevas en cualquier nivel. Para probar estos niveles con tráfico real, el endpoint de la API GPT-5.6 ofrece los tres modelos a través de una sola interfaz.
Preguntas frecuentes
¿Ultrafast mode está disponible en ChatGPT o Codex?
No. Ultrafast llega primero a la API de OpenAI, y el anuncio no indica ninguna fecha para su disponibilidad en ChatGPT o Codex.
¿Ejecutar GPT-5.6 Sol en Cerebras cambia la calidad de las respuestas?
OpenAI presenta Ultrafast como el mismo GPT-5.6 Sol servido con mayor velocidad, no como un modelo distinto. Un aumento de velocidad de 5,6 veces en GDP-Val sin pérdida de calidad comunicado por Cerebras es, hasta ahora, la única afirmación sobre calidad, y ningún benchmark independiente la ha replicado.
¿Hay un SLA de latencia para Ultrafast mode?
No se ha publicado ninguno. Fast mode incluye un SLA p50 de >80 tokens/s y un 99,9% de disponibilidad para clientes Enterprise; Ultrafast no tiene un SLA declarado durante la vista previa.
¿Qué modelos son compatibles con Ultrafast mode?
Solo GPT-5.6 Sol. Terra y Luna son compatibles con Fast mode, pero no forman parte de la vista previa de Ultrafast.
¿Cuánto costará Ultrafast mode?
No existe una cifra oficial. El recargo publicado de 2x de Fast mode sobre Standard Sol es el único punto de referencia.