 AIREITER
Un contexto de un millón de tokens y un endpoint de $0 hacen que la API de Nemotron 3 Ultra parezca la opción predeterminada perfecta. No lo es: la ruta gratuita resulta útil para evaluar el modelo, pero en producción todo depende de la fiabilidad del proveedor, el tratamiento de los datos y la existencia de una alternativa de pago.
¿Merece la pena usar la API de Nemotron 3 Ultra?
La API de Nemotron 3 Ultra merece una prueba si vas a trabajar con agentes de texto de larga duración, documentos extensos o flujos de programación que aprovechen un contexto muy amplio. No es una buena opción predeterminada para chats rutinarios de baja latencia, prompts confidenciales enviados a un endpoint gratuito con registro de uso ni servicios de producción sin alternativa de respaldo.
NVIDIA lanzó Nemotron 3 Ultra el 4 de junio de 2026. La tarjeta oficial del modelo identifica el checkpoint NVFP4 como la versión 1.0 GA, con licencia para uso comercial y no comercial bajo OpenMDW 1.1.
| Dato clave para decidir | Valor verificado | Por qué importa |
|---|---|---|
| Tamaño del modelo | 550B en total, 55B activos | El cómputo disperso no hace que todos los pesos ocupen poco |
| Contexto máximo | Hasta 1M de tokens | Los límites del proveedor pueden ser inferiores según la ruta |
| Modalidad | Entrada y salida de texto | No entiende imágenes ni vídeo |
| SWE-Bench Verified oficial con NVFP4 | 69.7 | Un dato relevante para evaluar agentes de programación |
| RULER 1M oficial con NVFP4 | 94.0 | Respalda el caso de uso con contexto largo |
| Precio gratuito en OpenRouter | $0 de entrada, $0 de salida | Adecuado para pruebas, no para un SLA |
| Disponibilidad gratuita observada en OpenRouter | 84.07% de éxito durante tres días | Que el endpoint fuese accesible no siempre significó que funcionara |
| Mínimo oficial para alojarlo por tu cuenta | 4x de clase B200 u 8x H100 | No es un despliegue normal para una estación de trabajo |
Los valores de benchmark anteriores proceden de la tarjeta del modelo de NVIDIA y deben interpretarse como resultados de primera mano. La disponibilidad de OpenRouter es una medición dinámica del proveedor, no una garantía permanente.
Prueba gratis la API de Nemotron 3 Ultra en cinco minutos
La vía gratuita más rápida utiliza el endpoint de chat completions compatible con OpenAI de OpenRouter y el ID exacto de modelo nvidia/nemotron-3-ultra-550b-a55b:free. Crea una clave de OpenRouter, guárdala en una variable de entorno y envía primero una prueba pequeña antes de lanzarte con una tarea de contexto largo.
- Crea una clave de API en OpenRouter.
- Expórtala como
OPENROUTER_API_KEY. - Llama a
/api/v1/chat/completionsusando el ID del modelo gratuito. - Registra el estado HTTP, la latencia y las respuestas vacías durante la evaluación.
- Añade una ruta de pago u otro modelo antes de llevar el flujo a producción.
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
La misma ruta funciona con el cliente de OpenAI para Python: solo tienes que cambiar base_url y model:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
Qué ofrece realmente la ruta gratuita
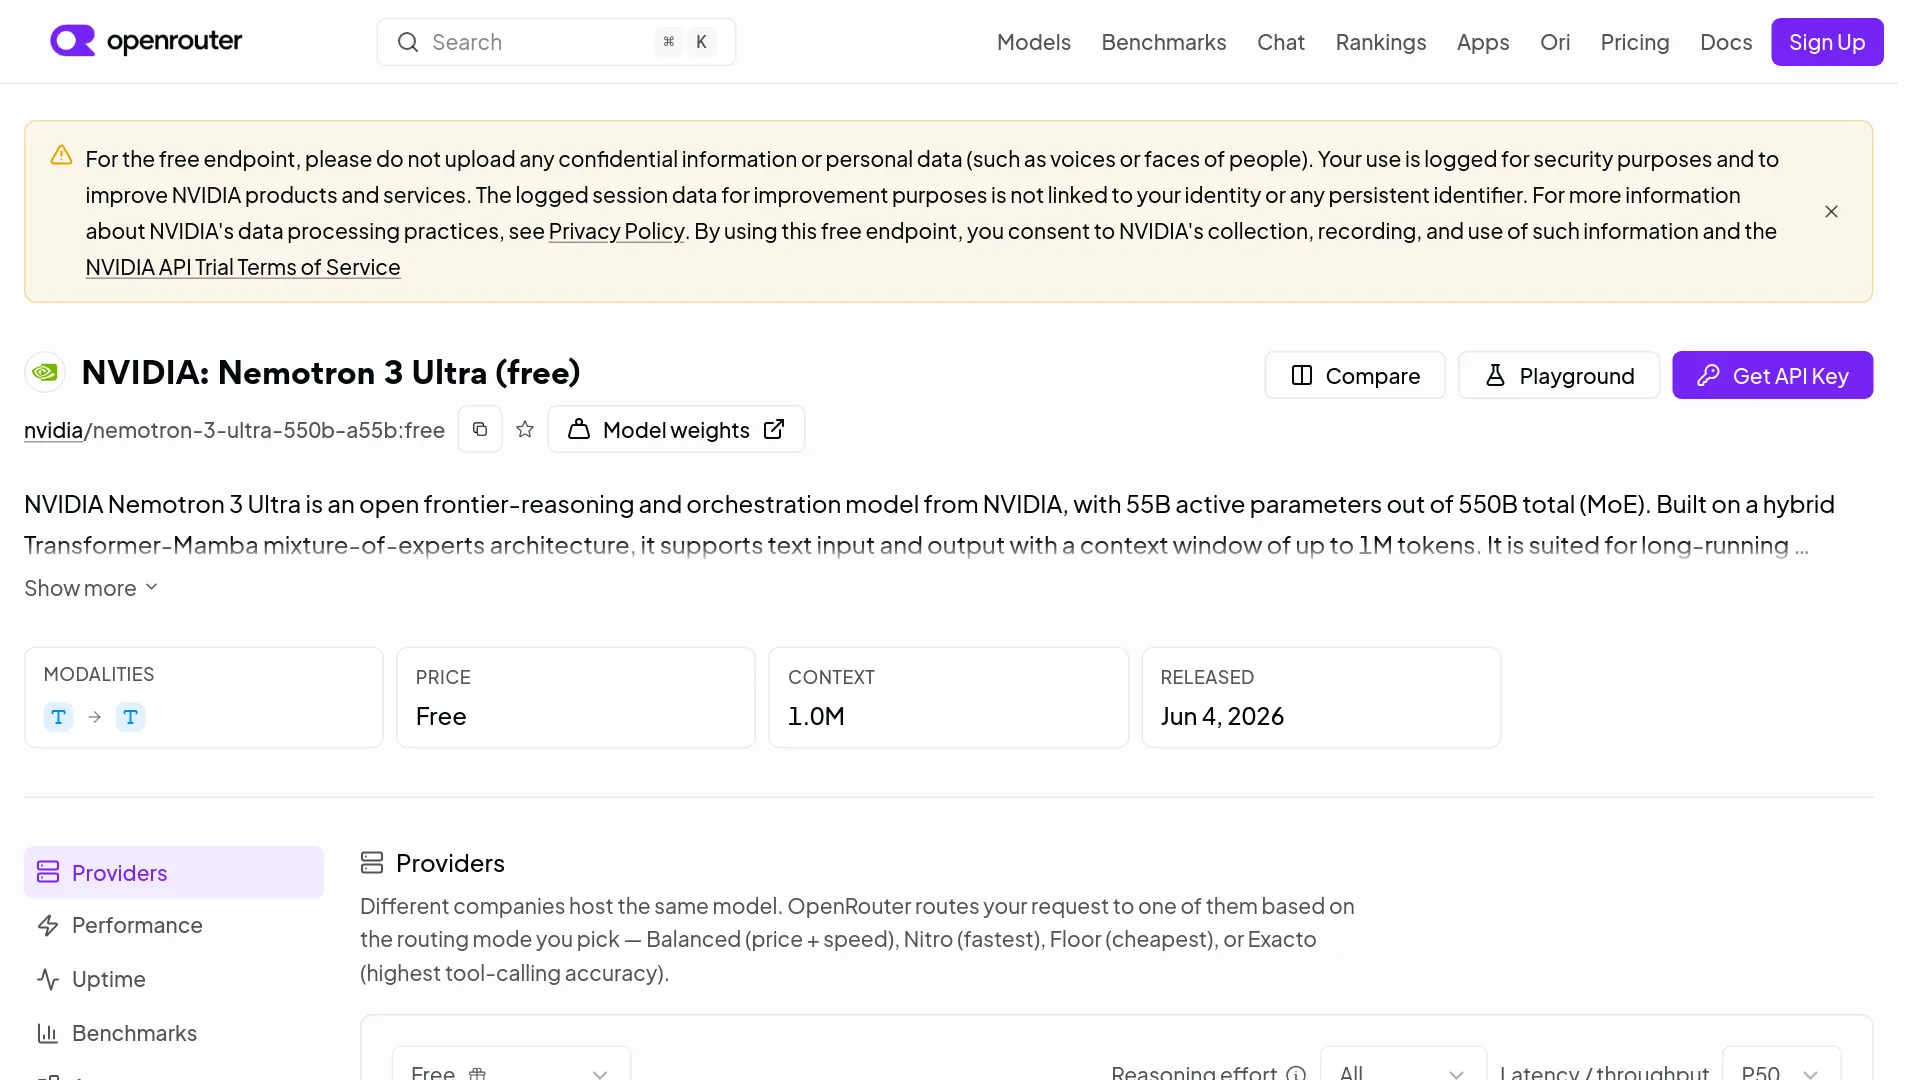
La ruta gratuita de Nemotron 3 Ultra no garantiza capacidad ilimitada ni disponibilidad para producción. La página de OpenRouter indica que los endpoints gratuitos tienen límites de uso, pero no publica una cuota exacta en la página del modelo. En su captura del 19 de septiembre aparecía una accesibilidad del 100%, aunque la disponibilidad efectiva durante tres días fue de solo 84.07%; los errores y las respuestas vacías se contabilizaron como fallos.
En esa captura, OpenRouter mostraba un contexto de 1M de tokens, una finalización máxima de 65,536 tokens, llamadas a herramientas, una latencia mediana de 2.28 segundos y un rendimiento mediano de 29 tokens por segundo.
También existe una diferencia de funciones específica del proveedor: la ruta gratuita de OpenRouter admitía tools y tool_choice, pero no hacía cumplir response_format. La ruta de pago de Segmind documenta la salida con JSON Schema a $0.625 por millón de tokens de entrada y $2.75 por millón de tokens de salida. Si tu código depende de JSON estricto, debes probar el proveedor elegido en lugar de asumir que la función está disponible por el simple hecho de que el modelo base la soporte.
No envíes datos confidenciales ni información personal a través de la ruta gratuita de OpenRouter. Su página indica que el uso se registra por motivos de seguridad y que puede emplearse para mejorar los productos y servicios de NVIDIA. Ante un 429, un timeout o una respuesta vacía, utiliza un backoff exponencial acotado y cambia después a una ruta de pago; no reintentes indefinidamente una acción de agente.
Qué cambia en la práctica con 550B A55B
La etiqueta 550B-A55B significa que Nemotron 3 Ultra almacena 550.000 millones de parámetros en total, aunque activa unos 55.000 millones para cada token. NVIDIA combina enrutamiento LatentMoE, Mamba-2, capas de atención seleccionadas y Multi-Token Prediction. La activación dispersa reduce el cómputo por token, pero todos los pesos siguen teniendo que almacenarse, distribuirse o descargarse a otro nivel; A55B no convierte el despliegue en uno de 55B.
El lanzamiento de investigación de NVIDIA informa de hasta 1M de tokens de contexto y compara el rendimiento con una carga poco habitual: una entrada de 8,000 tokens más una salida de 64,000 tokens. NVIDIA afirma que ofrece 5.9 veces el rendimiento de GLM-5.1-754B-A40B, 4.8 veces el de Kimi-K2.6-1T-A32B y 1.6 veces el de Qwen-3.5-397B-17B. La página no incluye el rendimiento absoluto ni los detalles del hardware, así que no conviene convertir esos multiplicadores directamente en expectativas de latencia para una API.
Para decidir cómo desplegarlo resulta más útil la tabla oficial en BF16/NVFP4:
| Benchmark | BF16 | NVFP4 | Lectura práctica |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | La cuantización cuesta 2.2 puntos en esta prueba de programación |
| Terminal Bench 2.1 | 56.4 | 53.9 | El trabajo agéntico en terminal también empeora |
| Media de TauBench V3 | 70.9 | 70.3 | La media en uso de herramientas se mantiene cerca |
| GPQA, sin herramientas | 87.0 | 87.9 | NVFP4 no es inferior en todos los casos |
| RULER 1M | 94.7 | 94.0 | La recuperación con contexto largo se mantiene cerca |
| OmniScience, no alucinación | 78.7 | 75.5 | Las comprobaciones de factualidad siguen siendo importantes |
El efecto depende de la tarea: NVFP4 pierde 3.2 puntos en no alucinación, pero gana 0.9 puntos en GPQA.
Elige según la tarea, no según el número de parámetros
Nemotron 3 Ultra debe compararse con DeepSeek V4, GLM 5.2 y Qwen 3.8 Max usando la carga de trabajo que realmente llegará a producción, no el tamaño del modelo. Ningún resultado obtenido con el mismo harness para esta guía respalda la idea de un ganador universal; la comparación defendible es un plan de pruebas con límites verificados.
| Tarea | Empieza por | Qué evidencia necesitas antes de decidir |
|---|---|---|
| Recuperación o síntesis de documentos de un millón de tokens | Nemotron 3 Ultra | El RULER 1M oficial en NVFP4 es 94.0; prueba la precisión de recuperación y la latencia de prefill con la longitud real del prompt |
| Agente de programación de larga duración | Nemotron 3 Ultra o DeepSeek V4 | Nemotron obtiene 69.7 en SWE-Bench Verified y 53.9 en Terminal Bench 2.1; compara el éxito en tareas de repositorios y la validez de las llamadas a herramientas con un mismo harness |
| Automatización con salidas estructuradas | GLM 5.2, Qwen 3.8 Max o un proveedor de Nemotron con soporte de esquemas | La ruta gratuita de OpenRouter no hace cumplir response_format; mide la adherencia al esquema y los reintentos en la ruta exacta |
| Peticiones cortas de gran volumen | DeepSeek V4, GLM 5.2 o Qwen 3.8 Max | Compara el coste por tarea completada y la latencia p95; la escala de Ultra no resulta útil automáticamente |
| Despliegue con pesos abiertos y hardware NVIDIA | Nemotron 3 Ultra | Compara BF16 y NVFP4 en la tarea objetivo y calcula después la utilización sostenida |
DeepSeek V4 y GLM 5.2 tienen superficies de API específicas en AIReiter, mientras que Qwen 3.8 Max está disponible como modelo de chat alojado: guía de la API de DeepSeek V4 Pro, análisis de la API de GLM 5.2 y precios de la API de Qwen 3.8 Max. Son alternativas para evaluar, no afirmaciones de que un modelo gane en todas las tareas.
¿Puedes ejecutar Nemotron 3 Ultra en local?
Nemotron 3 Ultra se puede alojar por tu cuenta, pero “local” aquí significa hardware de centro de datos o una DGX Station, no un portátil. NVIDIA establece como configuraciones mínimas para la ruta de despliegue normal 4x GB200, 4x B200, 4x GB300, 4x B300 u 8x H100.
Los ejemplos oficiales de vLLM en la tarjeta del modelo de NVIDIA utilizan paralelismo tensorial y de expertos de 4 vías, caché KV en FP8, prefill fragmentado y decodificación especulativa MTP. Un ejemplo estándar usa por defecto 262,144 tokens; para activar 1,048,576 tokens hay que aplicar una sobrescritura explícita, de modo que el contexto anunciado no es la configuración de servicio predeterminada.
NVIDIA también documenta un despliegue especial en una única DGX Station. Ejecuta el checkpoint NVFP4 en una GPU GB300 integrada, poniendo a disposición hasta 150 GiB de memoria coherente de CPU y descargando los pesos de los expertos. Esta receta requiere vLLM 0.22.0, el backend NVFP4 específico de Blackwell y la arquitectura de memoria de DGX Station; no se puede extrapolar a un PC normal con una sola GPU.
| Despliegue | Elígelo cuando | Principal limitación |
|---|---|---|
| API gratuita de OpenRouter | Estás evaluando prompts y comportamiento de herramientas | Límites de uso, registro de datos y disponibilidad variable |
| API alojada de pago | Necesitas ponerlo en producción antes de que el uso justifique el hardware | Diferencias de precio, precisión, contexto y funciones según el proveedor |
| Autohospedaje con 4x de clase B200 / 8x H100 | Importan el volumen sostenido, el control de los datos o la personalización del modelo | Coste de capital y operaciones de inferencia distribuida |
| DGX Station GB300 individual con descarga de pesos | Ya tienes exactamente ese sistema con memoria coherente | Latencia de la descarga y dependencia de un hardware muy concreto |
Preguntas frecuentes sobre la API de Nemotron 3 Ultra
¿La API de Nemotron 3 Ultra es gratuita?
Sí. OpenRouter lista nvidia/nemotron-3-ultra-550b-a55b:free a $0 tanto para los tokens de entrada como para los de salida, pero el endpoint tiene límites de uso y registra la actividad.
¿Nemotron 3 Ultra admite realmente un millón de tokens?
NVIDIA especifica un máximo de 1M de tokens, pero las rutas de los proveedores pueden ofrecer valores predeterminados inferiores; el ejemplo de vLLM de NVIDIA usa por defecto 262,144 tokens, salvo que el operador active 1,048,576.
¿La API admite herramientas y JSON estructurado?
El modelo admite herramientas, pero el cumplimiento depende del proveedor: la ruta gratuita de OpenRouter no aplica response_format, mientras que Segmind documenta JSON Schema estricto.
¿Puedo usar Nemotron 3 Ultra con fines comerciales?
NVIDIA afirma que la licencia OpenMDW 1.1 permite el uso comercial y no comercial. Consulta los términos de licencia enlazados desde la tarjeta oficial del modelo para conocer las obligaciones de redistribución y despliegue.
¿Puedo desactivar el razonamiento?
La documentación de la API de NVIDIA expone enable_thinking=True/False. Los proveedores alojados pueden implementar este control de otra forma, así que comprueba el parámetro aceptado y el recuento de tokens en la ruta seleccionada.
¿550B A55B equivale a un modelo denso de 55B?
No. Se activan unos 55B de parámetros por token, pero los 550B completos siguen teniendo que almacenarse, distribuirse o descargarse.
Una decisión de despliegue, no un trofeo de benchmarks
El mejor primer paso es probar gratis la API de Nemotron 3 Ultra con prompts no sensibles y un conjunto de evaluación pequeño. Pasa a un endpoint de pago cuando importen los fallos, el cumplimiento de esquemas o una capacidad predecible; alójalo por tu cuenta solo si la utilización medida, la privacidad o la personalización justifican al menos cuatro GPU actuales de gran memoria o la ruta documentada para DGX Station.
| Resultado después de las pruebas | Siguiente paso |
|---|---|
| La calidad es buena, pero las llamadas gratuitas fallan o se quedan en cola | Añade una ruta de Nemotron de pago y una política de reintentos |
| La recuperación con contexto largo es la diferencia clave | Prueba con el documento real más grande y mide el tiempo de prefill |
| Los fallos de JSON son el principal problema | Usa un proveedor con validación de esquemas o compara las rutas de GLM/Qwen |
| El coste o la latencia de las tareas cortas dominan | Prefiere un modelo más pequeño y reserva Ultra para las escalaciones |
| Los datos no pueden salir de tu red | Calcula el presupuesto del despliegue oficial con varias GPU antes de comprometerte |