 AIREITER
GLM-5.2 acepta solicitudes con formato de OpenAI por prácticamente todas sus rutas, pero eso no significa que se comporte igual en cada una. Desde su lanzamiento del 16 de junio, la API de GLM-5.2 se ha ganado un sitio en trabajos de programación y agentes donde el coste importa, siempre que resuelvas por tu cuenta tres puntos débiles: la semántica de las tool calls, las tormentas de reintentos y la contabilidad de caché. Su tarifa de lista de $1.40/$4.40 por millón de tokens existe; el coste final de completar una tarea es otra cifra. Esa diferencia es el foco de este análisis.
Compatibilidad con OpenAI: qué incluye y qué deja fuera
La documentación oficial de GLM-5.2 admite el SDK de Python de OpenAI con la URL base https://api.z.ai/api/paas/v4/ y el identificador de modelo glm-5.2. Para un chat básico, el cambio se resuelve de verdad en tres líneas. La compatibilidad cubre el formato de la petición, no la semántica de las respuestas, los campos de control opcionales de OpenAI ni la superficie más reciente de Responses API.
| Contrato documentado | Valor |
|---|---|
| Modalidad | Entrada de texto, salida de texto (sin visión) |
| Ventana de contexto | 1M de tokens |
| Salida máxima | 128K tokens |
| Capacidades documentadas | Modo de razonamiento, streaming, function call, caché de contexto, salida estructurada, MCP |
| Endpoint medido | https://api.z.ai/api/paas/v4/ |
| Endpoint de Coding Plan | https://api.z.ai/api/coding/paas/v4 |
| Endpoint compatible con Anthropic | https://api.z.ai/api/anthropic |
| SDK oficiales | zai-sdk (Python), Java, SDK de OpenAI |
El primer límite es claro: Z.ai no ofrece Responses API. «Codex solo admite el formato de Responses API, que no está disponible en Z.ai», explica u/quinncom; otros usuarios recurren a ZenMux como capa de traducción. El segundo afecta a Claude Code: la ruta funciona mediante el endpoint compatible con Anthropic, pero las notas de configuración de @armor_rust señalan dos trampas. Hay que usar AUTH_TOKEN, no API_KEY; esta última activa una confirmación de confianza que, tras un rechazo, puede negarse permanentemente. Además, las URL base de suscripción y pago por uso son distintas. El proceso completo está en nuestra guía para configurar Claude Code.
Un desarrollador lo resumió así: «la compatibilidad de la API termina en el formato de la petición; las llamadas a herramientas aún requieren evaluaciones específicas para cada proveedor» — @sebuzdugan.
Tool calling: correcto en pruebas cortas, problemático en bucles largos
En bucles de herramientas breves y controlados, la API de GLM-5.2 devuelve justo lo que prometen los documentos. En bucles de agentes prolongados, usuarios intensivos describen secuencias de llamadas corruptas que entran en espiral hasta que tus propios límites las detienen. Ambas cosas pueden ser ciertas a la vez: el riesgo depende por completo del tipo de bucle que estés construyendo.
Según la documentación de Z.ai y las pruebas de la suite Docker de 27 solicitudes de GLM52.ai, el contrato permite hasta 128 definiciones de función; los nombres tienen un máximo de 64 caracteres y deben cumplir ^[a-zA-Z0-9_-]+$; los parámetros usan JSON Schema; los argumentos vuelven como una cadena JSON que tu aplicación debe validar; y solo está documentado tool_choice: "auto". La suite superó 27 de 27 solicitudes en la ruta de Coding Plan: 4/4 coincidencias exactas de herramienta y argumentos, 3/3 rechazos correctos sin herramienta, 4/4 pedidos dobles en dos llamadas de nivel superior, con una latencia mediana de 5.3 segundos.
La trampa está en los campos que los usuarios de OpenAI dan por sentados. Cuando GLM52.ai envió pruebas con instrucciones contradictorias, el endpoint respondió HTTP 200 e ignoró después los controles:
| Control estilo OpenAI enviado | Comportamiento observado |
|---|---|
tool_choice: "required" + «no uses ninguna herramienta» | Se detuvo, cero llamadas |
| Objeto de función forzada + «no uses nunca esta herramienta» | Se detuvo, cero llamadas |
parallel_tool_calls: false + prompt con dos pedidos | Devolvió dos llamadas de todos modos |
strict: true | Lo aceptó una vez; no hay evidencia de que fuerce el esquema |
Que HTTP acepte una solicitud no equivale a tener un contrato de comportamiento. Y es en los bucles largos donde aparecen las grietas.
Un desarrollador que procesó aproximadamente cuatro mil millones de tokens con el modelo fue directo: «el mayor problema con GLM 5.2 tras 4 mil millones de tokens fue la falta de visión, cierta confusión en las tool calls y la corrupción mortal de tool calls —simplemente entra en espiral—» — @RasputinKaiser. También existe un único informe sin respuesta sobre el modelo codificando una segunda tool call dentro de los argumentos de la primera. Es un solo caso, pero corresponde exactamente al tipo de fallo contra el que debe protegerse un bucle del lado del cliente.
La defensa que funciona en la práctica consiste en no delegar la orquestación en el modelo. Un desarrollador usa NVIDIA NIM con tool_call: false y deja todo el bucle en manos del framework de agentes. El bucle de referencia acotado limita los pasos del modelo a cuatro, admite como máximo cuatro llamadas por turno y valida cada JSON de argumentos antes de ejecutarlo.
Streaming y latencia: las cifras que no aparecen en la publicidad
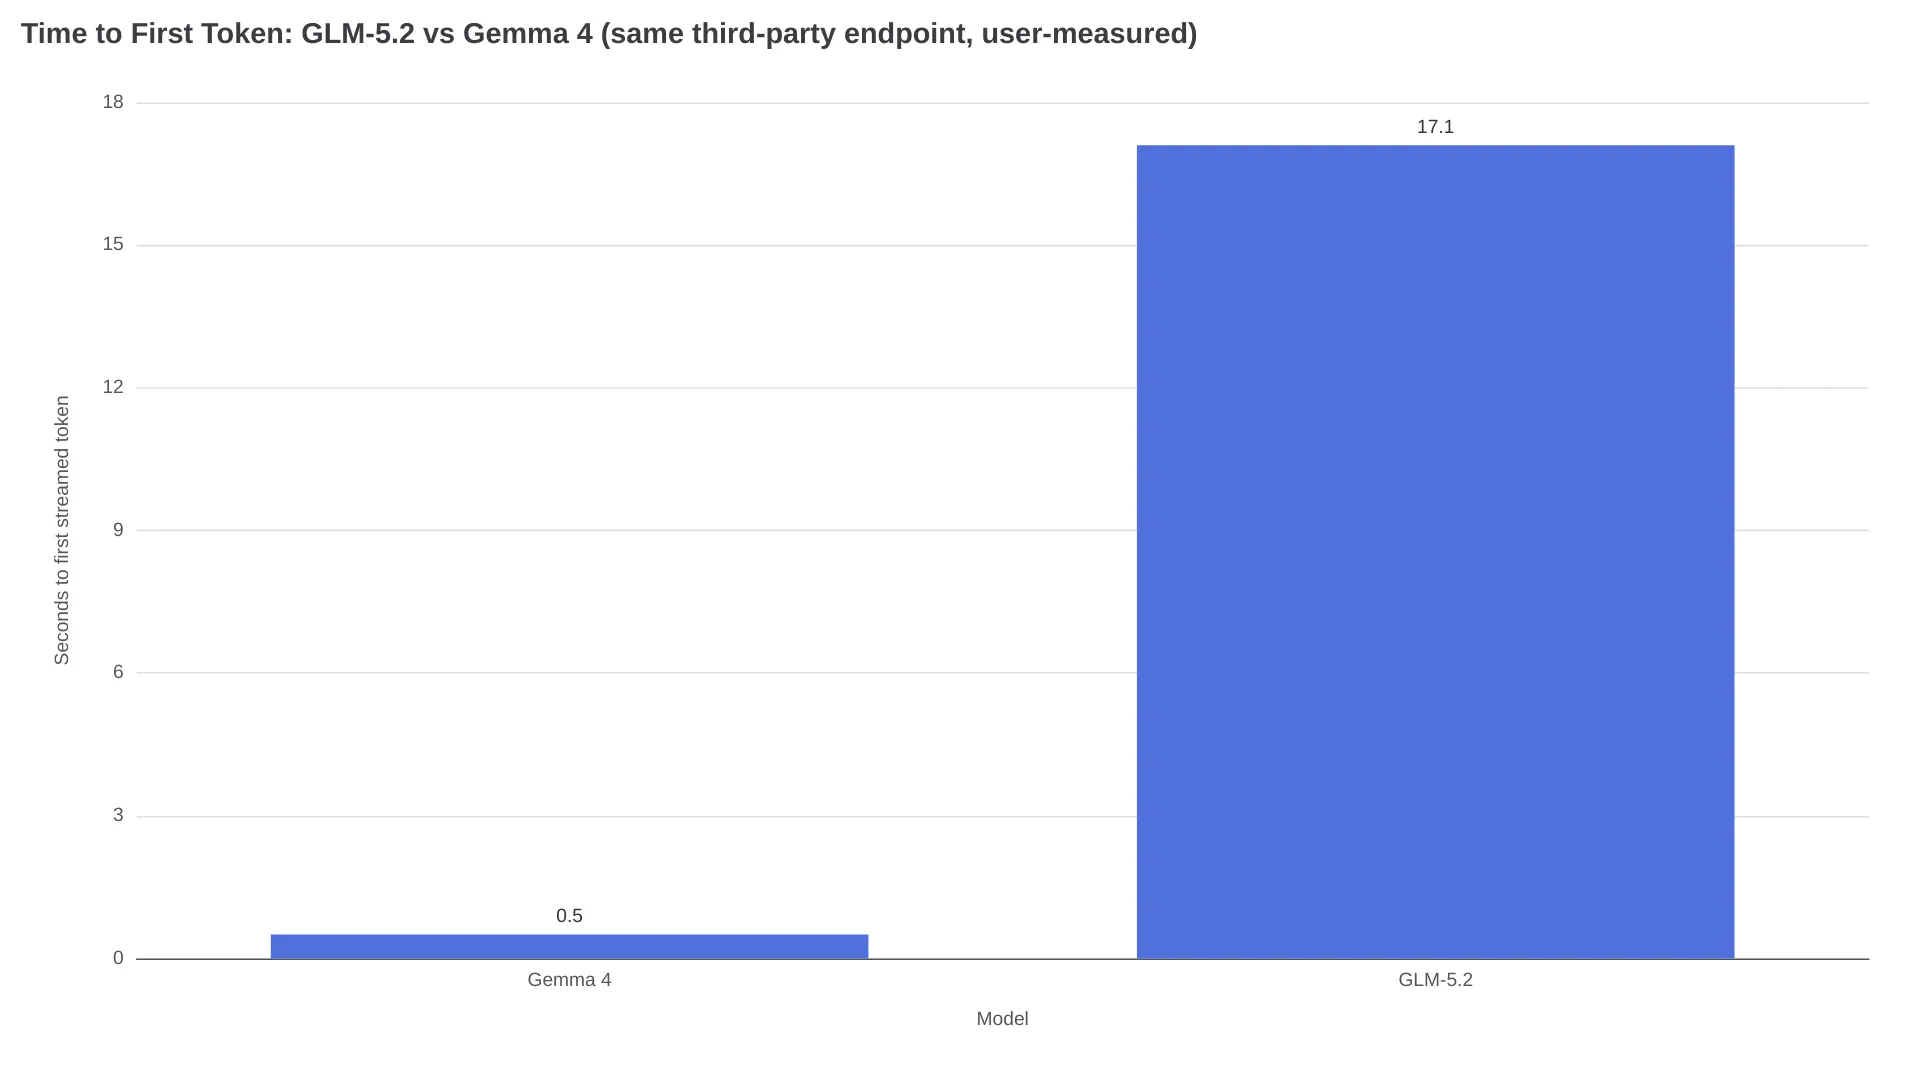
La latencia hasta el primer token es el dato medido más flojo de la API. Una prueba comparativa de endpoints en Sarvam situó a GLM-5.2 en 148 tokens por segundo en streaming, frente a los 260 de Gemma 4, y midió 17.1 segundos hasta el primer token frente a 0.5: «empieza a generar 33 veces antes», según @noctus91.
El rendimiento anunciado adolece del mismo problema:
«Todos estos proveedores de GLM 5.2 anuncian más de 200 tok/s. Luego los pruebas y obtienes 50 tok/s» — @tomgreenwald, que lo llama «benchmaxxing, pero para proveedores».
En rutas de suscripción aparecen dos patrones de fallo adicionales: streams que mueren a mitad de sesión —«el streaming simplemente... se detuvo»—, tras lo cual un usuario de GLM Pro Coding Plan abandonó por completo; y degradación al escalar: «cuando superas los 300k de contexto el modelo se vuelve lento» (@mosh_Ontong). Como contraste, el benchmark ejecutado de DataLLM Lab, con nueve tareas en su propio gateway, promedió 12.3 segundos por tarea completada. El endpoint, más que el modelo, determina gran parte de la historia de latencia.
Límites de tasa y 429: reintentar es parte del funcionamiento normal
La documentación de modelos de Z.ai no publica una tabla de límites de tasa, así que los desarrolladores los descubren de forma empírica, a base de 429. En las rutas de Coding Plan, el retrato que ofrece la comunidad es que los reintentos no son una ruta excepcional, sino la operación habitual. Estos hilos identifican modos de fallo, no tasas de prevalencia, pero apuntan todos en la misma dirección.
En un hilo sobre límites de tasa en r/ZaiGLM:
- «Ahora mismo recibo 429/529 en Coding Max Plan casi en cada segunda solicitud. Sin concurrencia...» — u/A-B-user
- «Sí, casi todas las solicitudes se reintentan, pero los resultados son muy buenos» — u/hyeluoh
- «Funciona bien, muy lento pero sin errores, si uso concurrencia única para glm52» — u/evia89
Los errores dependen del cliente: la misma clave API funciona en ZCode pero lanza 429 en OpenClaw, que otro usuario interpreta como un mensaje de «demasiado ocupado». Las capas de suscripción lo complican aún más. Usuarios chinos informan de que Coding Plan cambia automáticamente cargas de trabajo de 5.2 a GLM-5.3, que consume cuota más rápido, y de que revendedores externos de Coding Plan aplican límites de tasa tras apenas unas cuantas llamadas.
Las respuestas de ingeniería que resisten en producción son: backoff exponencial con jitter, claves de idempotencia para cualquier operación de escritura, un presupuesto de reintentos por tarea en lugar de por solicitud y un modo degradado de concurrency=1 que puedas activar automáticamente. Los patrones de reintento de nuestra guía para resolver 429 en OpenRouter se aplican aquí sin cambios.
La duda sobre la facturación de caché que Z.ai no ha resuelto
La caché de contexto está documentada y, cuando revisamos las páginas de los proveedores el 13 de julio, la entrada en caché aparecía a aproximadamente $0.26 por millón de tokens, frente a $1.40 para entrada nueva. La queja sin resolver —la reclamación sobre API con mayor interacción en los hilos de comunidad que revisamos— es que, en algunas rutas, el contexto repetido se factura igualmente como entrada nueva. Eso multiplica el coste de cualquier bucle de agente que reenvíe un prompt de sistema largo.
«Los tokens en caché no están funcionando correctamente en GLM 5.2. El contexto repetido se contabiliza como entrada normal en lugar de como tokens en caché» — @Da7_Tech, quien lo describe como «un grave problema de facturación y contabilidad de caché».
En ese hilo, la misma tarea que Claude Opus 4.8 completó con menos de 1.5M de tokens dejó a GLM-5.2 incompleto tras 53M tokens, con la cuota de cinco horas al 100%, mientras que el contador de la propia aplicación mostraba aproximadamente 1.67M.
Dos meses después, el mismo desarrollador seguía resumiéndolo así: «muchos usuarios se quejan de que los aciertos de caché parecen contar contra el uso. Si te ocurre, el valor del plan se desploma». En esos hilos no apareció ninguna respuesta oficial hasta finales de agosto.
Hasta que se confirme que está corregido, considera el precio de entrada en caché como el mejor caso posible y verifícalo contra tus propias facturas: registra cached_tokens del objeto de uso en cada respuesta y concílialo semanalmente.
Esfuerzo de razonamiento: un ajuste con tres nombres
La interfaz oficial utiliza thinking.type (enabled/disabled) junto a reasoning_effort, con los valores high y max. Los propios ejemplos de la documentación incluyen reasoning_effort: "max". La guía de lanzamiento de Z.ai indicó que max prioriza la capacidad, mientras que high equilibra rendimiento y eficiencia de tokens; max es el valor recomendado para código.
De ahí se desprenden dos hechos de integración. Primero, las rutas de programación usan max por defecto: «Por defecto es max, así que no hace falta configurarlo salvo que quieras bajarlo» (r/ZaiGLM). Los tokens de razonamiento se cobran a tarifas de salida, de modo que el valor predeterminado multiplica el gasto sin avisar. En Coding Plans, los usuarios que han documentado la contabilidad del plan indican que las llamadas con esfuerzo máximo consumen 3x de cuota durante la franja de 14:00–18:00 de Pekín entre semana, además de una ventana de cinco horas y créditos semanales.
Segundo, el ajuste a menudo ni siquiera llega al backend: usuarios de OpenCode informan de que «actualmente no permite ajustar el esfuerzo de razonamiento» en proveedores personalizados. Algunos clientes exponen el mismo ajuste bajo un tercer nombre, xhigh, que quizá ni reenvíen al proveedor (r/opencodeCLI). La verbosidad depende del mismo control: un desarrollador que hace comparativas diarias observó que un modelo rival «no es tan verboso como Opus-4.8 o GLM-5.2».
El mismo identificador, despliegues distintos: deriva entre endpoints
glm-5.2 es un único identificador de modelo que apunta a despliegues sustancialmente diferentes. Cuando circularon resultados de precisión entre endpoints a principios de agosto, el responsable de Z.ai pidió a la comunidad «probar la API oficial de GLM-5.2 como punto de referencia adicional. Puede obtener más del 100%» — @ZixuanLi_. El punto de referencia que mencionaba era la API oficial, no los endpoints de terceros evaluados en el informe.
En la práctica, esta deriva se traduce en límites de tokens de salida lo bastante bajos como para truncar el razonamiento a mitad del stream, un rendimiento de lanzamiento que se desvanece —el patrón de «benchmaxxing» citado antes— y techos de contexto distintos según el host. Together AI ofrece GLM-5.2 con 256K, mientras que la API oficial, con 1M según la documentación, y los agregadores de nuestra comparación de julio mantienen la ventana completa.
Las diferencias de precio son incluso mayores que las de comportamiento: frente a la tarifa de lista de Z.ai de $1.40/$4.40, OpenRouter mostraba $0.42/$1.32 en nuestra comparación de proveedores de julio, con tarifas de entrada en caché entre $0.14 en Fireworks y $0.26. Elige el endpoint según la carga de trabajo y vuelve a probar en ese endpoint exacto: que el comportamiento sea correcto en una ruta no permite extrapolarlo a otra.
Antes de desplegar: prueba previa de 30 minutos
Todos los fallos anteriores se pueden detectar en media hora, antes de comprometer una carga de trabajo de producción. Ejecuta estas pruebas contra el endpoint, el identificador de modelo y el SDK exactos que vayas a desplegar:
- Prueba conflictos en el contrato de herramientas. Envía
tool_choice: "required"junto con una instrucción de no usar herramientas, yparallel_tool_calls: falsecon un prompt de dos pedidos. Espera que ambos controles se ignoren; si tu orquestación depende de alguno de ellos, detente aquí. - Prueba de carga con reintentos. Lanza 50 solicitudes con la concurrencia prevista y registra la tasa de 429/529, además de la proporción de reintentos exitosos. Si los reintentos superan aproximadamente un tercio de las solicitudes —un umbral operativo conservador—, baja la concurrencia a 1 y vuelve a medir.
- Comprueba la contabilidad de caché. Reenvía cinco veces un prefijo idéntico de 10K tokens; suma
cached_tokensde las respuestas de uso y compáralo con lo que el panel haya facturado como entrada. Una discrepancia invalida tu modelo de costes. - Prueba de latencia con el tamaño de contexto real. Mide el tiempo hasta el primer token y los bloqueos a mitad del stream con tamaños de contexto representativos, no con una prueba rápida de 1K tokens: de otro modo, la ralentización por encima de 300K no será visible.
- Decide la ruta. Coding Plan está diseñado para herramientas interactivas de programación. Los análisis de contabilidad del plan indican que no tiene licencia para servir sitios web, bots ni tráfico SaaS, por lo que los backends de producto deben usar la API medida.
Hay una tensión que no desaparece: GLM-5.2 ofrece algunos de los tokens de programación capaces más baratos del mercado, pero el precio de entrada es la ingeniería de envoltorio que las API de frontera incorporan, en cambio, a su coste por token.
Preguntas frecuentes sobre la API de GLM-5.2
¿Puedo usar el SDK de OpenAI con GLM-5.2?
Sí, para chat completions: apunta base_url a https://api.z.ai/api/paas/v4/ con el modelo glm-5.2. No existe Responses API, por lo que la interfaz más reciente de OpenAI —y Codex— necesita una capa de traducción.
¿La API de GLM-5.2 admite streaming, function calling y salida estructurada?
Las tres figuran entre las capacidades documentadas, junto con la caché de contexto y MCP. Las salvedades son de comportamiento: la estabilidad del streaming varía según el endpoint, y los campos de control de herramientas de OpenAI —tool_choice más allá de auto, parallel_tool_calls y strict— no se respetan.
¿Qué identificador de modelo y URL base debo usar?
Ruta oficial medida: glm-5.2 en https://api.z.ai/api/paas/v4/. Coding Plan utiliza una base distinta, y OpenRouter lista el modelo como z-ai/glm-5.2.
¿Por qué GLM-5.2 es lento o inusualmente verboso?
Las rutas de programación usan por defecto el esfuerzo de razonamiento máximo, que se cobra como tokens de salida, y los informes de la comunidad sitúan el rendimiento sostenido más cerca de 50 tok/s que de los más de 200 anunciados. Antes de atribuirlo a límites del modelo, la latencia y la verbosidad suelen ser efectos de la configuración y el endpoint.
¿Puedo usar GLM Coding Plan para la API de mi aplicación?
No. Los análisis de contabilidad del plan indican que la suscripción es para herramientas interactivas de programación y excluye servir sitios web, bots o productos SaaS. Los multiplicadores de cuota de las horas punta de Pekín tampoco lo hacen adecuado para tráfico continuo.
¿La ventana de contexto de 1M está disponible en todos los proveedores?
No. La API oficial y la mayoría de agregadores ofrecen 1M, pero Together AI limita GLM-5.2 a 256K, una diferencia suficiente para cambiar la arquitectura de los flujos de trabajo a escala de repositorio.
Lecturas relacionadas
- Análisis de GLM-5.2: dos meses después del hype — calidad del modelo, benchmarks y para quién merece la pena
- API de GLM 5.2: acceso más barato, precios y claves gratuitas — la matriz completa de precios por proveedor
- GLM-5.2 vs GLM-5.3 — si el sucesor de agosto cambia el cálculo