 AIREITER
Nemotron 3.5 Lightning no aspira a ser el modelo de 30B más capaz en razonamiento puro. De hecho, en los benchmarks de NVIDIA queda por detrás de Qwen 3.6 35B-A3B en 11 de 12 pruebas. Su apuesta va por otro lado: generar tokens hasta 4 veces más rápido. Es un modelo mixture-of-experts de 30B, pero solo activa 3B de parámetros por token, pensado para los pasos repetitivos de un pipeline de agentes, donde la velocidad y el coste pesan más que exprimir el razonamiento al máximo. La contrapartida es que los pesos BF16 a precisión completa exigen una GPU de 80 GB; para producción, NVIDIA recomienda el checkpoint NVFP4.
Por qué Nemotron 3.5 Lightning no es otro modelo de 30B
Nemotron 3.5 Lightning combina capas de espacio de estados Mamba-2, enrutamiento MoE y capas selectivas de atención, una arquitectura híbrida que NVIDIA identifica como nemotron_h. Las capas Mamba-2 reducen la carga de memoria y cómputo que supone la atención con contextos largos. Gracias a ello, Lightning admite una ventana de contexto de 1M de tokens, aunque la model card la limita en la práctica a 256K en una única H100 de 80 GB, sin asumir el coste cuadrático de un modelo basado exclusivamente en atención.
| Especificación | Valor |
|---|---|
| Parámetros totales | 30B |
| Parámetros activos por token | 3B |
| Arquitectura | Híbrida: Mamba-2 + MoE + atención |
| Longitud de contexto | Hasta 1M de tokens (256K en una sola H100) |
| Opciones de precisión | BF16, NVFP4 |
| Licencia | OpenMDW v1.1 (permite uso comercial) |
| Idiomas | Inglés, español, francés, alemán, italiano, japonés + código |
| Corpus de preentrenamiento | 20T+ tokens |
| Modo de razonamiento | Activable mediante enable_thinking en la plantilla de chat |
| Muestreo recomendado | Temperatura 1.0, top-p 0.95 |
NVIDIA presenta Lightning como el miembro más pequeño de la familia Nemotron 3, entrenado específicamente para el comportamiento de los arneses de agentes: llamadas a herramientas, validación de salidas, formateo de resultados y delegación a subagentes. Un modelo de razonamiento frontier, como Nemotron 3 Ultra, se ocupa de la planificación compleja; Lightning asume los pasos de ejecución rutinarios que, de otro modo, consumirían el presupuesto de tokens de un modelo premium.
Benchmarks: sus ventajas y sus límites
La model card de HuggingFace publica 14 filas de benchmarks que comparan Lightning con Qwen 3.6 35B-A3B, Gemma 4 26B-A4B, Nemotron 3 Nano/Super y GPT-OSS 20B. Estas son las 10 métricas más relevantes para tomar una decisión:
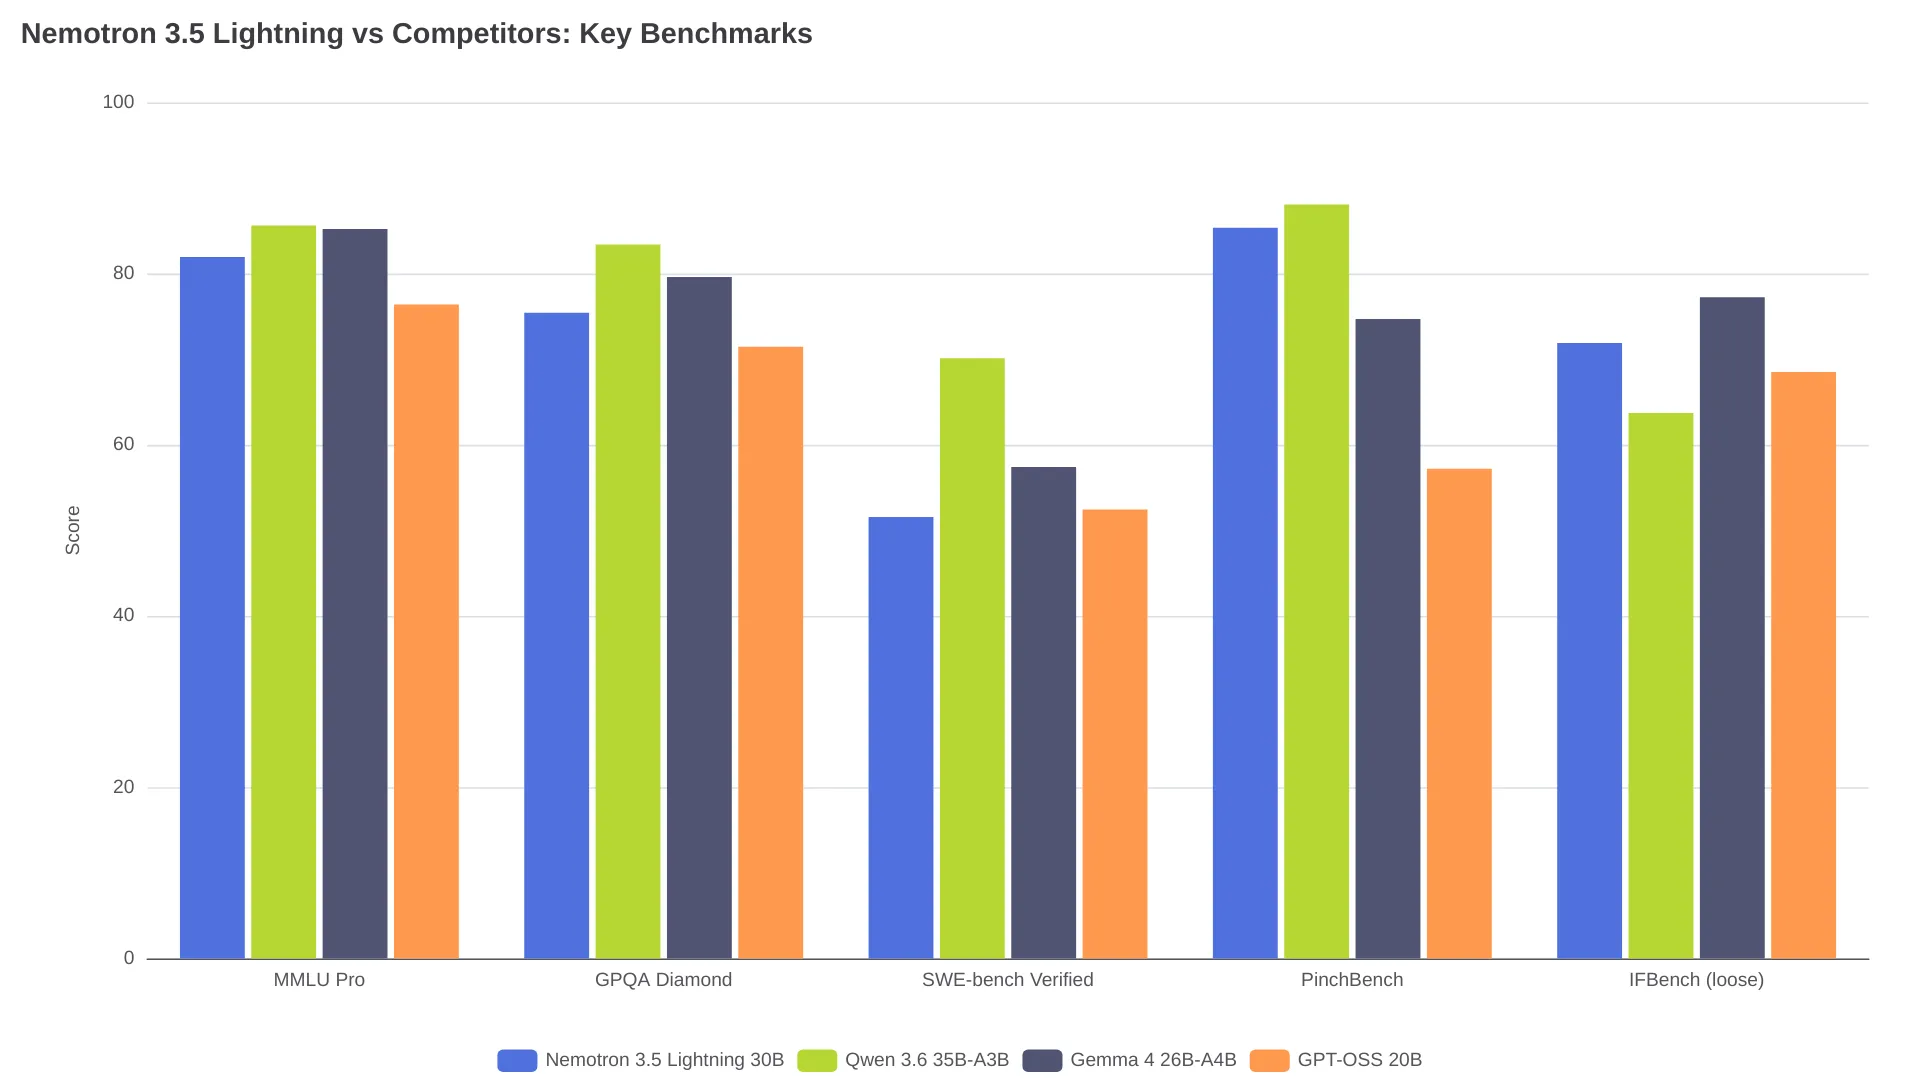
| Benchmark | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond (sin herramientas) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench (flexible) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
Lightning queda por debajo de Qwen 3.6 35B-A3B en 11 de las 12 filas comparables. La excepción es IFBench, en el modo flexible de seguimiento de instrucciones: alcanza 71.88 frente a los 63.71 de Qwen, una ventaja de 8 puntos coherente con su enfoque de ejecución para agentes. A la hora de dar formato a una llamada de herramienta o validar una salida, cumplir instrucciones puede importar más que la capacidad de razonamiento en bruto.
La diferencia real aparece en velocidad. En la evaluación PinchBench de NVIDIA, con 10.000 tareas de agentes medidas en horas de GPU H100, Lightning completa la carga en aproximadamente 16.5 horas de GPU y con un 86% de precisión. Qwen 3.6 35B necesita entre 23.5 y 24 horas para un 87% de precisión, mientras que Gemma 4 26B requiere entre 25 y 26 horas y obtiene un 73%:
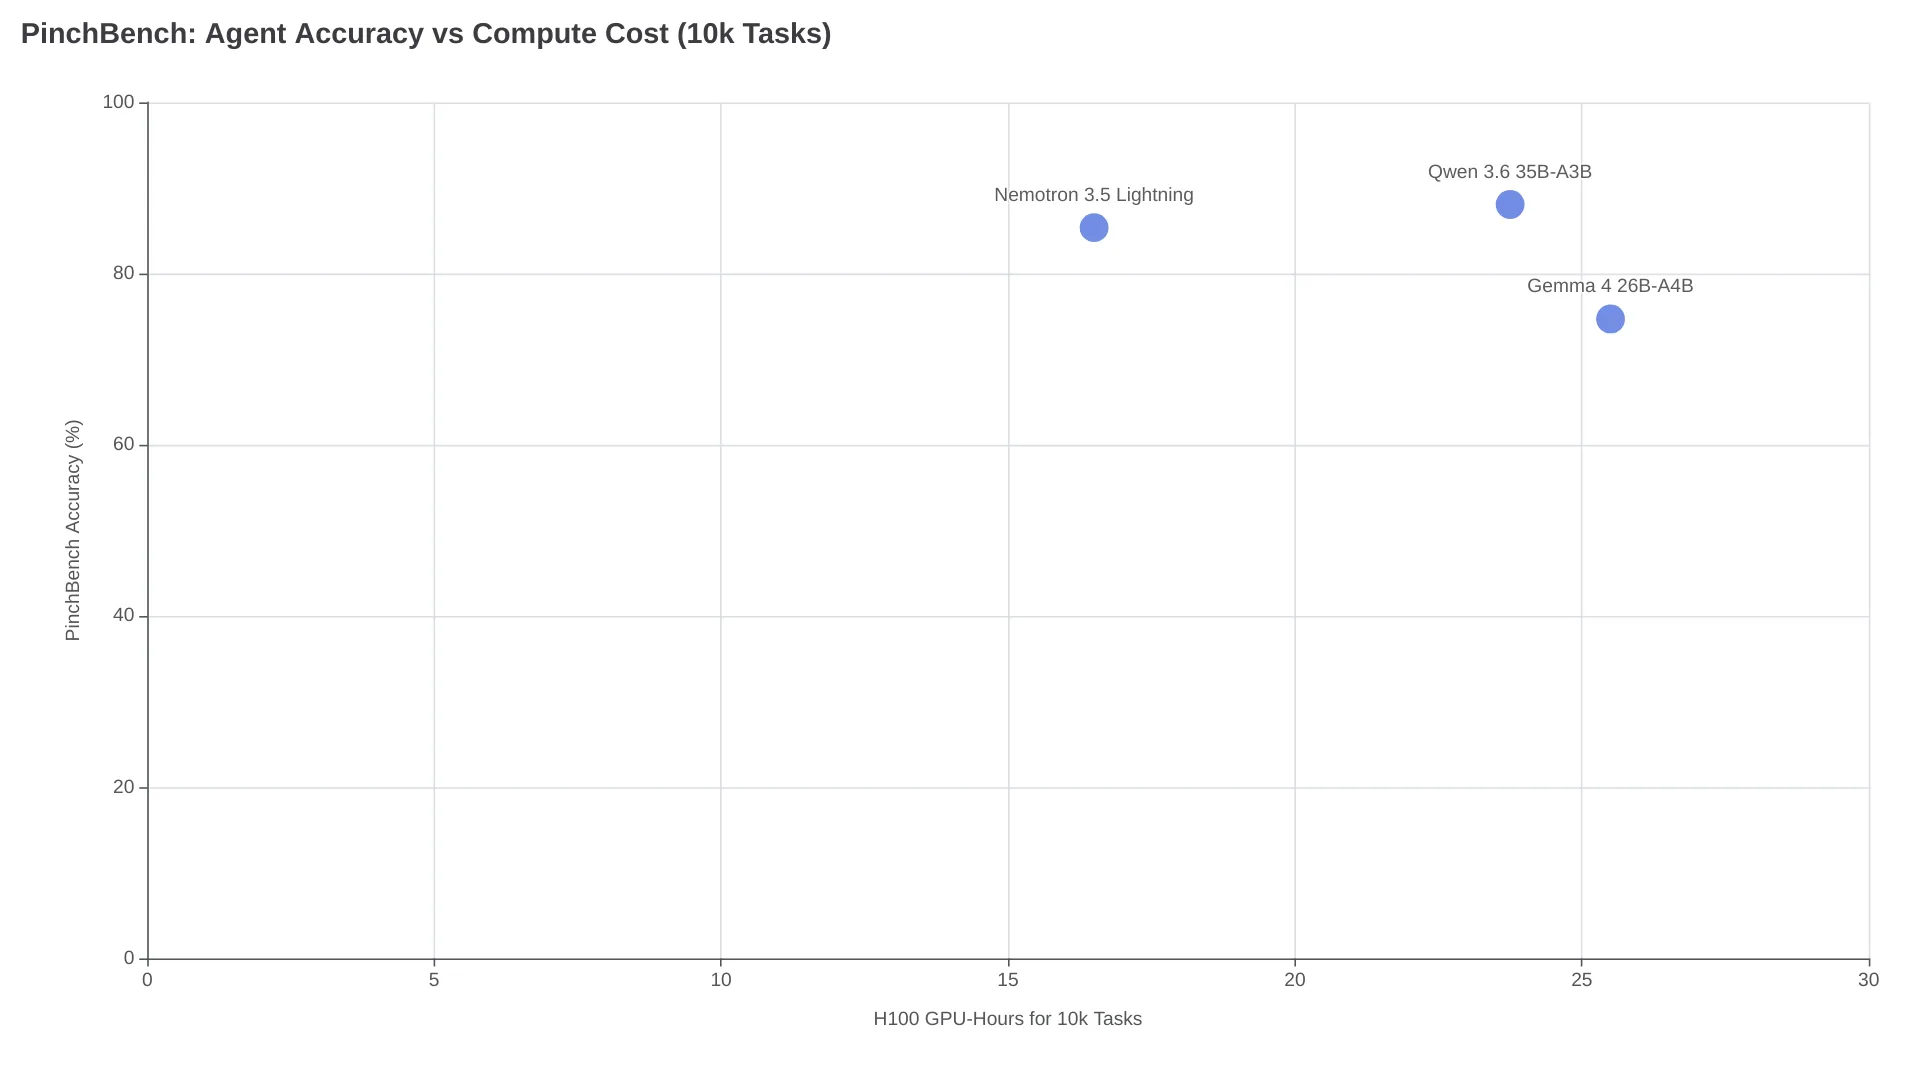
Eso equivale a aproximadamente un 30% menos de cómputo para una precisión casi idéntica, una diferencia relevante si ejecutas 10.000 pasos de agentes y pagas por hora de GPU. NVIDIA también sitúa a Lightning en aproximadamente 670 tokens de salida por segundo, con unos 23-24 puntos en el Intelligence Index de la clasificación de Artificial Analysis, lo que lo coloca en la frontera de Pareto entre los modelos de pesos abiertos con menos de 40B de parámetros totales.
Las pruebas de la comunidad en r/LocalLLaMA han llegado a conclusiones similares sobre el rendimiento. Un usuario de DGX Spark informó de 78.5 tokens por segundo solo con el modelo objetivo y de 90.7 tokens por segundo usando decodificación especulativa con el checkpoint NVFP4. Otro usuario, en el hilo principal de discusión, situó su calidad «entre Gemma 4 26B y 31B, mucho más cerca de 26B». También señaló que funciona cerca de 2 veces más rápido que Gemma 31B, pero genera muchos tokens de razonamiento, lo que en la práctica reduce parte de esa ventaja. Las primeras conversiones a GGUF Q4 ocupaban unos 25 GB y mostraban avisos de tensores sin usar, una señal de que la arquitectura híbrida Mamba-2 quizá todavía no esté plenamente soportada por todas las herramientas basadas en GGUF.
Requisitos de hardware y opciones para desplegarlo en local
El checkpoint BF16, que contiene los pesos de referencia a precisión completa, necesita 1x H100 de 80 GB o 1x A100 de 80 GB para un despliegue en una sola GPU. Su archivo safetensors fragmentado ocupa 65.8 GB. NVIDIA recomienda explícitamente la versión NVFP4 independiente para inferencia en producción.
| Checkpoint | Tamaño de archivo (aprox.) | GPU mínima | Mejor uso |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | Fine-tuning, investigación y creación de variantes cuantizadas |
| NVFP4 | ~16 GB | RTX 5090, DGX Spark, Jetson (Blackwell/Hopper/Ampere) | Inferencia en producción y despliegue de agentes |
| GGUF Q4 | ~25 GB | 16 GB+ de VRAM (creado por la comunidad) | llama.cpp, Ollama, LM Studio |
NVIDIA colaboró con cuatro proyectos de serving local para ofrecer soporte desde el primer día: vLLM, SGLang, Ollama y llama.cpp. También se mencionan LM Studio y Unsloth. El modelo admite tres estrategias de decodificación especulativa:
- DSpark - recomendada para DGX Spark e inferencia de centro de datos con baja concurrencia
- DFlash - modelo draft alternativo; depende de la carga de trabajo
- MTP (Multi-Token Prediction) - integrado en el modelo y óptimo para concurrencia media o alta
Si no dispones de hardware local, Lightning está disponible en build.nvidia.com como microservicio NIM y también en OpenRouter. El checkpoint NVFP4 funciona en GeForce RTX 5090, DGX Spark, sistemas OEM GB10 y NVIDIA Jetson.
El patrón de enrutamiento de agentes donde Lightning aporta valor
La biblioteca de enrutamiento de código abierto de NVIDIA, NeMo Switchyard, dirige cada paso de un flujo de agentes al modelo más adecuado según precisión, velocidad y coste. La planificación se asigna a un modelo frontier de razonamiento; la ejecución baja a Lightning. El benchmark interno de NVIDIA sostiene que Switchyard mantuvo una finalización de tareas «de nivel frontier» y redujo el coste a aproximadamente un tercio de usar únicamente Opus 4.8. Entre las tareas de ejecución que se derivan a Lightning están git pull, la validación de respuestas de herramientas, el formateo de resultados y las llamadas rutinarias a API.
También hay casos de uso reales detrás de este planteamiento. CodeRabbit publicó un caso práctico en Reddit: realizó post-training de Nemotron 3.5 Lightning para el enrutamiento de revisiones de código mediante SFT específico y RLVR, aprendizaje por refuerzo con recompensas verificables. El resultado superó su referencia en una evaluación congelada de 1.000 tareas, con menos de $100 de coste de entrenamiento. NVIDIA respalda este flujo con NeMo Automodel y NeMo Megatron Bridge para LoRA/SFT, NeMo RL y NeMo Gym para aprendizaje por refuerzo, además del dataset abierto Nemotron-RL Agentic Terminal Pivot.
Para un equipo que construye pipelines de agentes, la pregunta práctica es sencilla: ¿puedes ajustar Lightning para que resuelva la mayor parte de los pasos del agente con el coste de 3B de parámetros activos y reservar un modelo frontier solo para los pocos pasos que realmente lo necesitan?
¿Deberías usar Nemotron 3.5 Lightning?
| Caso de uso | Recomendación | Motivo |
|---|---|---|
| Enrutamiento de agentes a gran escala: llamadas a herramientas, validación y formato | Lightning NVFP4 | 3B de parámetros activos, 4x de velocidad de tokens, ~30% menos cómputo con precisión similar |
| Asistencia general de programación | Qwen 3.6 35B-A3B | 70.12 frente a 51.56 en SWE-bench Verified: 19 puntos de diferencia |
| Razonamiento complejo / planificación | Nemotron 3 Ultra o un modelo frontier | Lightning no está diseñado como modelo de planificación |
| Chat local en una sola GPU de consumo | Lightning NVFP4 en RTX 5090 | Funciona, pero las conversiones GGUF aún son irregulares; vLLM/SGLang son más fiables |
| Fine-tuning para una tarea de agente concreta | Lightning BF16 | 3B de parámetros activos = fine-tuning más barato; OpenMDW v1.1 permite uso comercial |
| Seguimiento de instrucciones a escala | Lightning | IFBench: 71.88 frente a 63.71 de Qwen, una ventaja de 8 puntos |
Lightning sacrifica precisión máxima a cambio de velocidad en ejecución de alto volumen. Ese 30% de reducción de cómputo se acumula a lo largo de cientos de pasos de agentes por sesión, pero el modelo se lanzó el 11 de agosto de 2026 y su ecosistema todavía está madurando. La arquitectura híbrida Mamba-2 implica que las herramientas basadas en GGUF quizá aún no le den soporte completo. Hoy, en hardware NVIDIA y con vLLM o SGLang, el checkpoint NVFP4 es la vía de despliegue más segura; en Apple Silicon o configuraciones limitadas a GGUF, conviene esperar a que la comunidad estabilice las conversiones.
Preguntas frecuentes
¿Puede Nemotron 3.5 Lightning funcionar en hardware de consumo?
NVIDIA solo ofrece soporte para hardware de consumo con el checkpoint NVFP4. Los pesos BF16 requieren una GPU de 80 GB, H100 o A100. NVFP4 funciona en GeForce RTX 5090, DGX Spark y NVIDIA Jetson. Existen conversiones comunitarias GGUF Q4 para llama.cpp y Ollama en sistemas con 16 GB+ de VRAM, pero las primeras compilaciones han reportado problemas de tensores sin usar relacionados con la arquitectura híbrida Mamba-2.
¿Cómo se compara Nemotron 3.5 Lightning con Qwen 3.6 35B?
Qwen 3.6 35B-A3B supera a Lightning en 11 de los 12 benchmarks publicados, con las mayores diferencias en SWE-bench Verified y Terminal-Bench. Lightning gana en seguimiento de instrucciones en IFBench y completa tareas aproximadamente un 30% más rápido con una precisión similar en cargas de trabajo de agentes. Qwen es el modelo más sólido para uso general; Lightning es el modelo más rápido para ejecutar agentes.
¿Es Nemotron 3.5 Lightning bueno para programar?
Para benchmarks de programación en bruto, no: obtiene 51.56 en SWE-bench Verified frente a los 70.12 de Qwen 3.6. Sin embargo, CodeRabbit ajustó con éxito Lightning para el enrutamiento de revisiones de código por menos de $100 y superó su referencia. El modelo está pensado para personalizarse: si lo ajustas a las convenciones de tu base de código, puede asumir tareas rutinarias de programación con el coste de 3B de parámetros activos.
¿Qué licencia utiliza Nemotron 3.5 Lightning?
El modelo se publica bajo OpenMDW v1.1 (Open Model Data Weight), una licencia que NVIDIA describe como publicada «de la forma más permisiva posible». Permite el uso comercial de los pesos, los datos de entrenamiento y las recetas. Los términos completos están disponibles en la model card de HuggingFace.