 AIREITER
MiniMax Music 3.0 se lanzó el 13 de agosto de 2026 con pesos abiertos en HuggingFace, una API a $0.15 por canción y capacidad para generar temas de hasta cinco minutos. La documentación del endpoint de API todavía hace referencia a Music 2.6, mientras que la inferencia local puede requerir hasta 24 GB de VRAM.
Qué cambia en Music 3.0 y por qué importan los temas de 5 minutos
Music 3.0 pasa a ser el modelo musical recomendado por MiniMax en sustitución de Music 2.6. Su gran novedad es poder crear canciones de hasta cinco minutos en una sola generación, incluyendo composición, arreglo, interpretación y producción. Según MiniMax, el objetivo es evitar un problema de las versiones anteriores: que el género, la instrumentación y las voces perdieran coherencia después de la primera sección del tema (blog oficial).
| Componente | Parámetros | Función |
|---|---|---|
| LLM global (basado en Qwen3.5-8B) | 8B | Predice la estructura y la semántica musical de toda la canción |
| LLM local | 0.6B | Completa los detalles acústicos finos dentro de cada frame |
| Flow-matching + Flow-VAE | 2.4B + 123M | Convierte estados ocultos en audio continuo, no en tokens discretos |
Por debajo hay una pila de cuantización vectorial residual (RVQ) de 8 capas que separa la estructura musical gruesa —capa 1, con un codebook de 16.384 entradas— del detalle acústico fino —capas 2 a 8, con 1.024 entradas cada una—. El LLM global mantiene el contexto a escala de canción; el local se ocupa de predecir la acústica de cada frame. Después, la pila de flow-matching genera el audio final a partir de estados ocultos fusionados, en vez de limitarse a decodificar tokens discretos. El blog afirma que este enfoque reduce los artefactos de alta frecuencia y el fraseo rígido de modelos musicales de IA anteriores, aunque MiniMax no ha publicado benchmarks controlados frente a Music 2.6, Suno o Udio.
Precios de la API, IDs de modelo y límites de uso
La plataforma oficial de MiniMax incluye dos IDs para Music 3.0 con facturación por uso:
| ID de modelo | Precio por canción | Límite de solicitudes | Notas |
|---|---|---|---|
Music-3.0 | $0.15 | 120 RPM | Contacta con ventas para límites superiores |
Music-3.0-free | $0 | 3 RPM | Nivel de prueba gratuito |
Generación/edición de letras con Music-3.0 | $0.01 | — | Genera u optimiza letras automáticamente |
Ambos modelos generan una canción completa —de hasta cinco minutos y con voces— en cada llamada a la API. El endpoint es POST /v1/music_generation, el mismo que utiliza Music 2.6. El día del lanzamiento, la documentación de referencia de la API seguía mostrando music-2.6 en sus ejemplos indexados, así que es posible que los desarrolladores deban probar manualmente el ID Music-3.0 hasta que la documentación se actualice.
Cómo ejecutar Music 3.0 en local con ComfyUI: requisitos de hardware
La versión con pesos abiertos es lo que más entusiasmo ha generado en la comunidad. Los pesos están disponibles en HuggingFace, en MiniMaxAI/MiniMax-Music3, y existe una distribución optimizada para ComfyUI en Comfy-Org/MiniMax-Music-3.
La model card, respaldada por los primeros reportes de la comunidad, documenta tres configuraciones de hardware:
| Modo | VRAM | Velocidad aproximada | Calidad |
|---|---|---|---|
| Precisión completa | <24 GB (por ejemplo, RTX 4090) | La más rápida | La mejor |
| Offloading a CPU | ~22 GB de GPU + 32 GB+ de RAM | Moderada | Casi completa |
| Streaming de capas | 8 GB de GPU + 32 GB+ de RAM | Lenta | Limitada |
Para empezar en local, instala ComfyUI 0.33.0 o posterior (confirmado en el hilo de la comunidad de ComfyUI), descarga los archivos del modelo desde uno de los repositorios de HuggingFace anteriores, carga el workflow de ComfyUI para MiniMax-Music3, selecciona el modo de precisión adecuado para tu VRAM y genera. Por ahora CUDA es el único backend de cómputo compatible: aún no hay soporte para ROCm ni MPS (según reportes de la comunidad). Hay una PR de integración con Diffusers en marcha, lo que abriría la puerta a la inferencia nativa en Python fuera de ComfyUI.
Un usuario de Reddit en r/comfyui afirmó haber generado 140 segundos de música country en una AMD RX 7900 GRE (16 GB de VRAM y 32 GB de RAM) en aproximadamente 125 segundos. Otro hilo en r/StableDiffusion resumía sin rodeos el sentir de la comunidad:
"Hoy me he dado de baja de Suno gracias a Minimax Music." — r/StableDiffusion
Conviene revisar los términos de licencia antes de cualquier uso comercial. El blog habla de "pesos abiertos" y de un modelo "listo para producción", pero no publica el texto de la licencia, las cláusulas de uso comercial ni las condiciones de redistribución. El archivo LICENSE del repositorio de HuggingFace es la fuente autorizada: compruébalo antes de lanzar trabajos que generen ingresos.
Cómo hacer prompting en Music 3.0: Structured Captions y etiquetas de sección
La interfaz de control de Music 3.0 gira en torno a las Structured Captions: descripciones detalladas y ordenadas temporalmente que indican al modelo qué debe ocurrir en cada parte de la canción. Según el blog oficial, una caption bien construida debe especificar:
- Género y subgénero (por ejemplo, "progressive house / EDM")
- Tempo y tonalidad (por ejemplo, "126 BPM, B-flat major")
- Instrumentación (por ejemplo, "breathy male tenor, side-chained synths, club bass, hall reverb")
- Interpretación vocal (por ejemplo, "gravelly tenor with falsetto breaks")
- Arco emocional (por ejemplo, "airy verse building to high-energy chorus")
- Carácter de producción (por ejemplo, "vintage room mix," "glossy keys")
Las letras emplean las etiquetas de sección estándar que reconocen la mayoría de los modelos de IA musical:
[intro]
[verse]
[pre-chorus]
[chorus]
[bridge]
[instrumental]
[solo]
[outro]
Un Prompt Enhancement System puede transformar solicitudes sencillas —como "upbeat pop song with female vocals"— en el formato completo de Structured Caption usando terminología de la industria musical. Así, quienes no son músicos pueden acceder a controles detallados sin dominar vocabulario especializado. Las pistas instrumentales se pueden generar sin letra; para las pistas vocales hay que aportar la letra o utilizar el optimizador de letras por $0.01/canción.
MiniMax Music 3.0 frente a Suno y Udio
La comparación clave es sencilla: ¿conviene pagar $0.15 por canción a MiniMax o suscribirse a una plataforma ya consolidada?
| Función | MiniMax Music 3.0 | Suno | Udio |
|---|---|---|---|
| Duración máxima de canción | 5 min | ~4 min | ~2–4 min |
| Modelo de precios | $0.15/canción (pago por uso) | $10/mes Pro (500 canciones) | $10/mes Standard (~600 canciones) |
| Opción gratuita | API a 3 RPM + pesos abiertos | 10 canciones/día | Créditos limitados |
| Pesos abiertos | Sí (HuggingFace) | No | No |
| Despliegue local | Sí (ComfyUI) | No | No |
| Uso comercial | Consulta la licencia de HuggingFace | Incluido en los planes de pago | Incluido en los planes de pago |
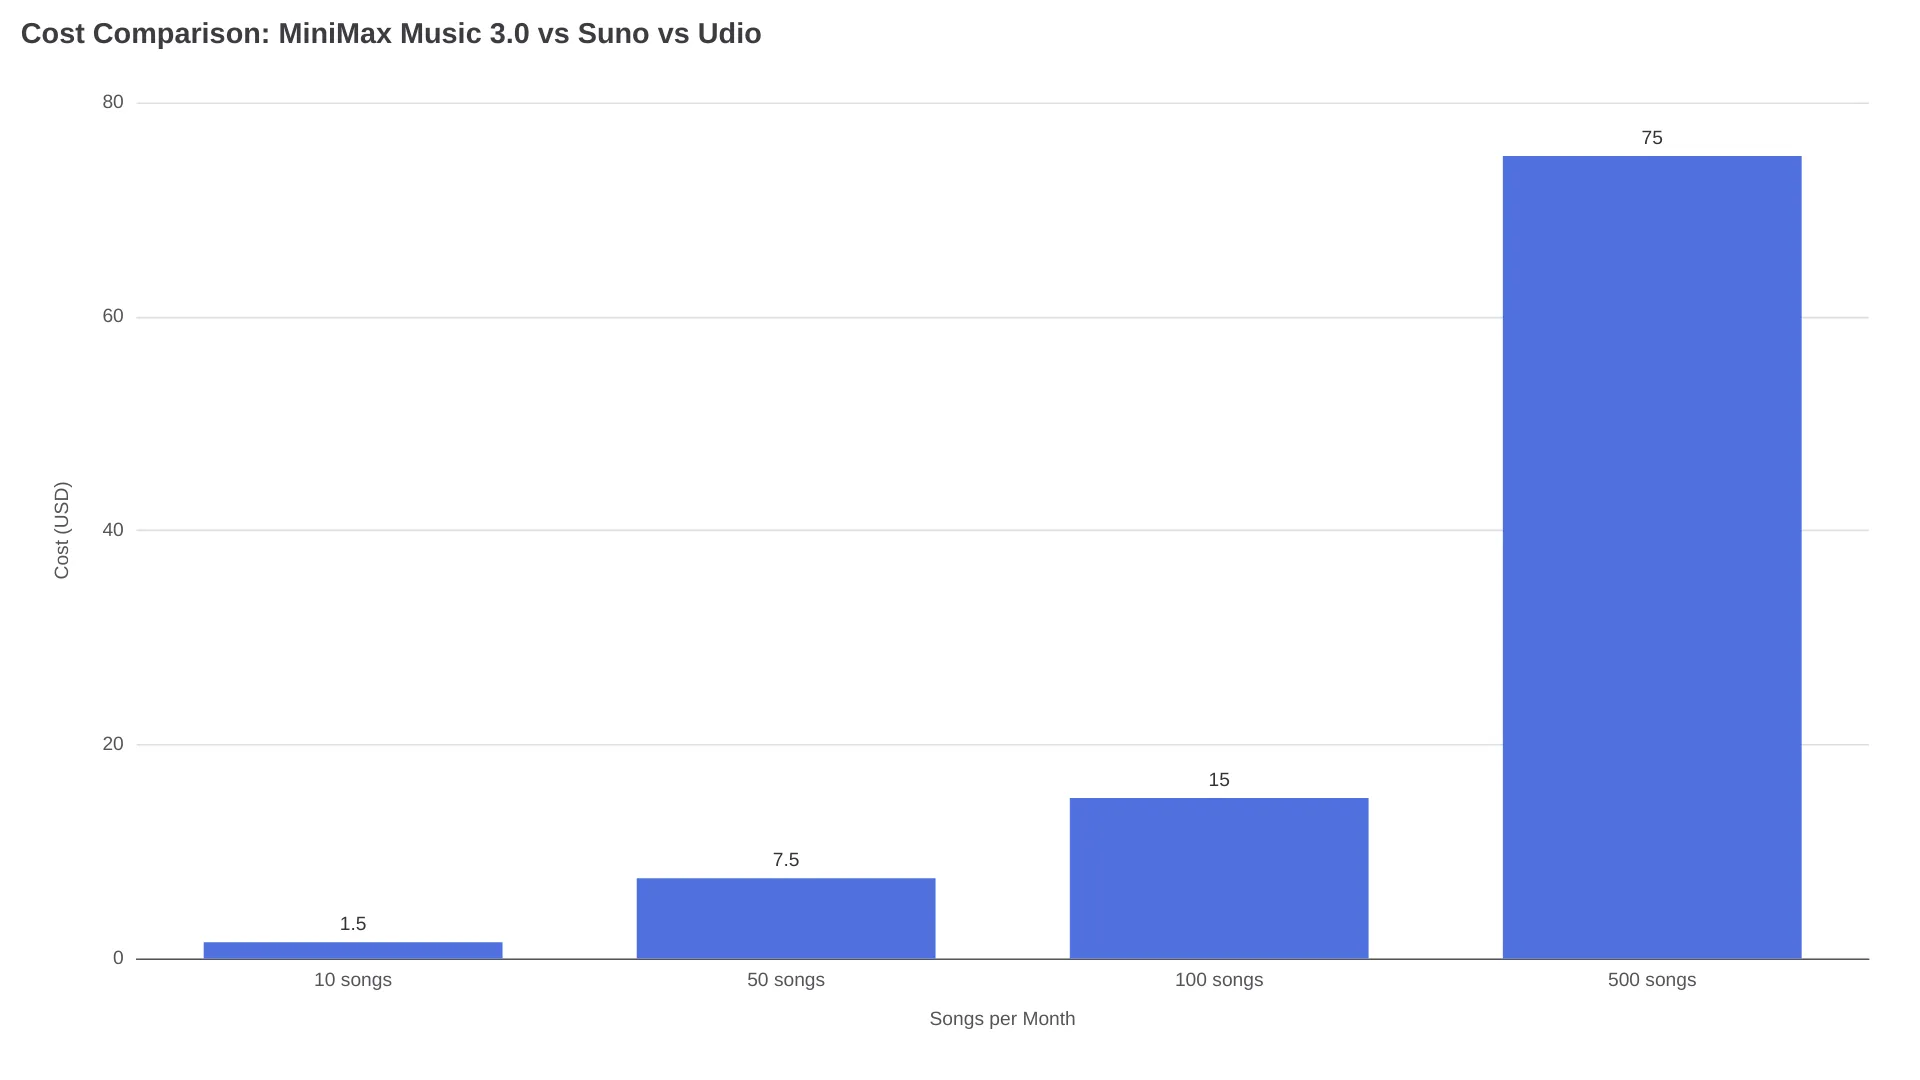
El punto de equilibrio está en torno a 67 canciones al mes. Por debajo de esa cifra, el pago por uso de MiniMax a $0.15 por canción es más barato que cualquier suscripción. Por encima, Suno Pro o Udio Standard, con $10 al mes por más de 500 canciones, ganan en coste puro. Pero la opción local de MiniMax con pesos abiertos cambia la ecuación: generación gratuita e ilimitada si ya cuentas con la GPU.
Los hilos de la comunidad en r/SunoAI y r/comfyui sitúan a Music 3.0 como una alternativa competitiva frente a Suno v4 en naturalidad vocal y fidelidad al prompt, con elogios especialmente para electrónica y pop. Las reacciones sobre rock, metal y estilos acústicos más antiguos fueron más desiguales: algunos usuarios señalaron falta de definición en mezclas densas. El soporte multilingüe parece sólido, con demos oficiales en mandarín e inglés, además de pruebas de la comunidad con rap de Bollywood.
Preguntas frecuentes
¿MiniMax Music 3.0 es gratis?
El modelo de API Music-3.0-free genera canciones sin coste, con un límite de 3 RPM. También puedes ejecutar gratis el modelo con pesos abiertos en local mediante ComfyUI.
¿Music 3.0 puede generar pistas instrumentales?
Sí. La generación instrumental no necesita letra; la generación vocal requiere letras aportadas por el usuario o el optimizador de letras de $0.01/canción.
¿Cuál es el ID de modelo de API para Music 3.0?
Music-3.0 (120 RPM, $0.15/canción) y Music-3.0-free (3 RPM), ambos a través de POST /v1/music_generation. Ten en cuenta que la documentación de la API todavía menciona music-2.6 en algunas páginas.
¿Music 3.0 admite idiomas además del inglés?
Las demos oficiales incluyen mandarín e inglés. Las pruebas de la comunidad muestran generación satisfactoria en hindi (prueba de rap de Bollywood). No se ha publicado una lista oficial de idiomas compatibles.
¿Puedo usar comercialmente pistas de MiniMax Music 3.0?
Consulta el archivo LICENSE de HuggingFace y los términos de servicio de la API. El blog no concreta los derechos de uso comercial.
¿Cuánta VRAM necesito para ejecutar Music 3.0 en local?
Menos de 24 GB para precisión completa, ~22 GB con offloading a CPU u 8 GB en modo de streaming de capas. Consulta la tabla de hardware anterior.
Qué opción elegir según tu caso
| Tu situación | Opción recomendada | Coste |
|---|---|---|
| Probar o crear prototipos de unas pocas canciones | API Music-3.0-free | $0 |
| Uso de producción ocasional (<67 canciones/mes) | API Music-3.0 | $0.15/canción |
| Generación de gran volumen (>67 canciones/mes) | Suno Pro o Udio Standard | $10/mes |
| Tienes una GPU de 24 GB y buscas generación gratuita ilimitada | ComfyUI local con los pesos de HuggingFace | $0 (solo cómputo) |
| Estás creando una app con generación musical programática | API Music-3.0 mediante la plataforma de MiniMax | $0.15/canción |
Quedan dos carencias por resolver: el retraso en la documentación de la API, que aún está centrada en Music 2.6, y los términos de licencia sin especificar para los pesos abiertos. Ambas cuestiones deberían aclararse a medida que el lanzamiento se estabilice, pero ninguna impide que la API funcione hoy.