 AIREITER
Sobre el papel, Kimi K3.1 Pro reúne lo que se espera de un modelo serio para programación y agentes: una ventana de contexto de 1M de tokens, $2 por millón de tokens de entrada y $10 por millón de tokens de salida. En las cargas de trabajo de la semana de lanzamiento recogidas a continuación, usar la API por consumo resultó mucho más barato que la suscripción de $39.
Qué es realmente Kimi K3.1 Pro
Kimi K3.1 Pro es el primer modelo de la serie K3.1 de Moonshot AI. Llegó el 23 de octubre de 2026 como sucesor posentrenado de Kimi K3. Moonshot lo presenta como un modelo mixture-of-experts de clase 3T orientado a programación de larga duración, flujos de herramientas 3D y CAD, análisis de documentos financieros y agentes con múltiples pasos.
La ventana de contexto es de 1.048.576 tokens compartidos entre entrada, tokens de razonamiento y salida; no son 1M de entrada más otro 1M de salida. A través de los productos de Moonshot admite texto, imágenes y vídeo como entrada; la API devuelve texto, código y llamadas a herramientas, mientras que el artefacto visual lo genera el software externo, como Blender, motores de juego o herramientas PDF. El razonamiento está siempre activado, con niveles de reasoning_effort low, high y max; el valor predeterminado es max.
Moonshot prometió publicar los pesos abiertos antes del 4 de noviembre, pero la comprobación de TheQuery del 24 de octubre no pudo verificar un checkpoint descargable ni la licencia definitiva, y ArtificialWatch también indicaba que la licencia era desconocida. Hasta que se publique un checkpoint junto con su licencia, conviene contar con la API alojada.
Precios de Kimi K3.1 Pro y Highspeed, sin letra pequeña
En la plataforma API de Kimi, Kimi K3.1 Pro estándar cobra $2 por millón de tokens de entrada sin caché y $10 por millón de tokens de salida. Kimi K3.1 Pro Highspeed duplica las tarifas de los tokens medidos, hasta $4 de entrada y $20 de salida, pero conserva los $0.20 por lectura de entrada almacenada en caché. La división $2/$10 y $4/$20 coincide con la publicada por ArtificialWatch y la tabla de precios de AI/ML API.
| Operación (por 1M de tokens) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Entrada sin caché | $2.00 | $4.00 |
| Salida (incluido el razonamiento) | $10.00 | $20.00 |
| Lectura de entrada en caché | $0.20 | $0.20 |
| Escritura en caché, duración de 5 minutos | $2.00 | $4.00 |
| Escritura en caché, duración de 1 hora | $4.00 | $8.00 |
Hay tres detalles de facturación más importantes que el precio de partida. Primero, las tarifas no varían con la longitud del contexto y la caché dura cinco minutos por defecto. Si reutilizas un prefijo de prompt durante ese intervalo, pagas $0.20 en lugar de $2.00. Segundo, los tokens de razonamiento se facturan a tarifa de salida: en una traza larga de agente, el esfuerzo max puede convertirse en la mayor parte de la factura. Tercero, los cargos de la API son independientes de las membresías de Kimi y de las suscripciones a Kimi Code. Además, la revisión de TheQuery de la guía de Batch API encontró que K3.1 Pro no figuraba en ella, así que no hay que dar por hecho que exista descuento por lotes.
Con esas tarifas, un ejemplo de volumen fijo sale barato: 100.000 tokens de entrada sin caché ($0.20) más 10.000 tokens de salida ($0.10) suman $0.30 antes de escrituras de caché, herramientas, reintentos e impuestos.
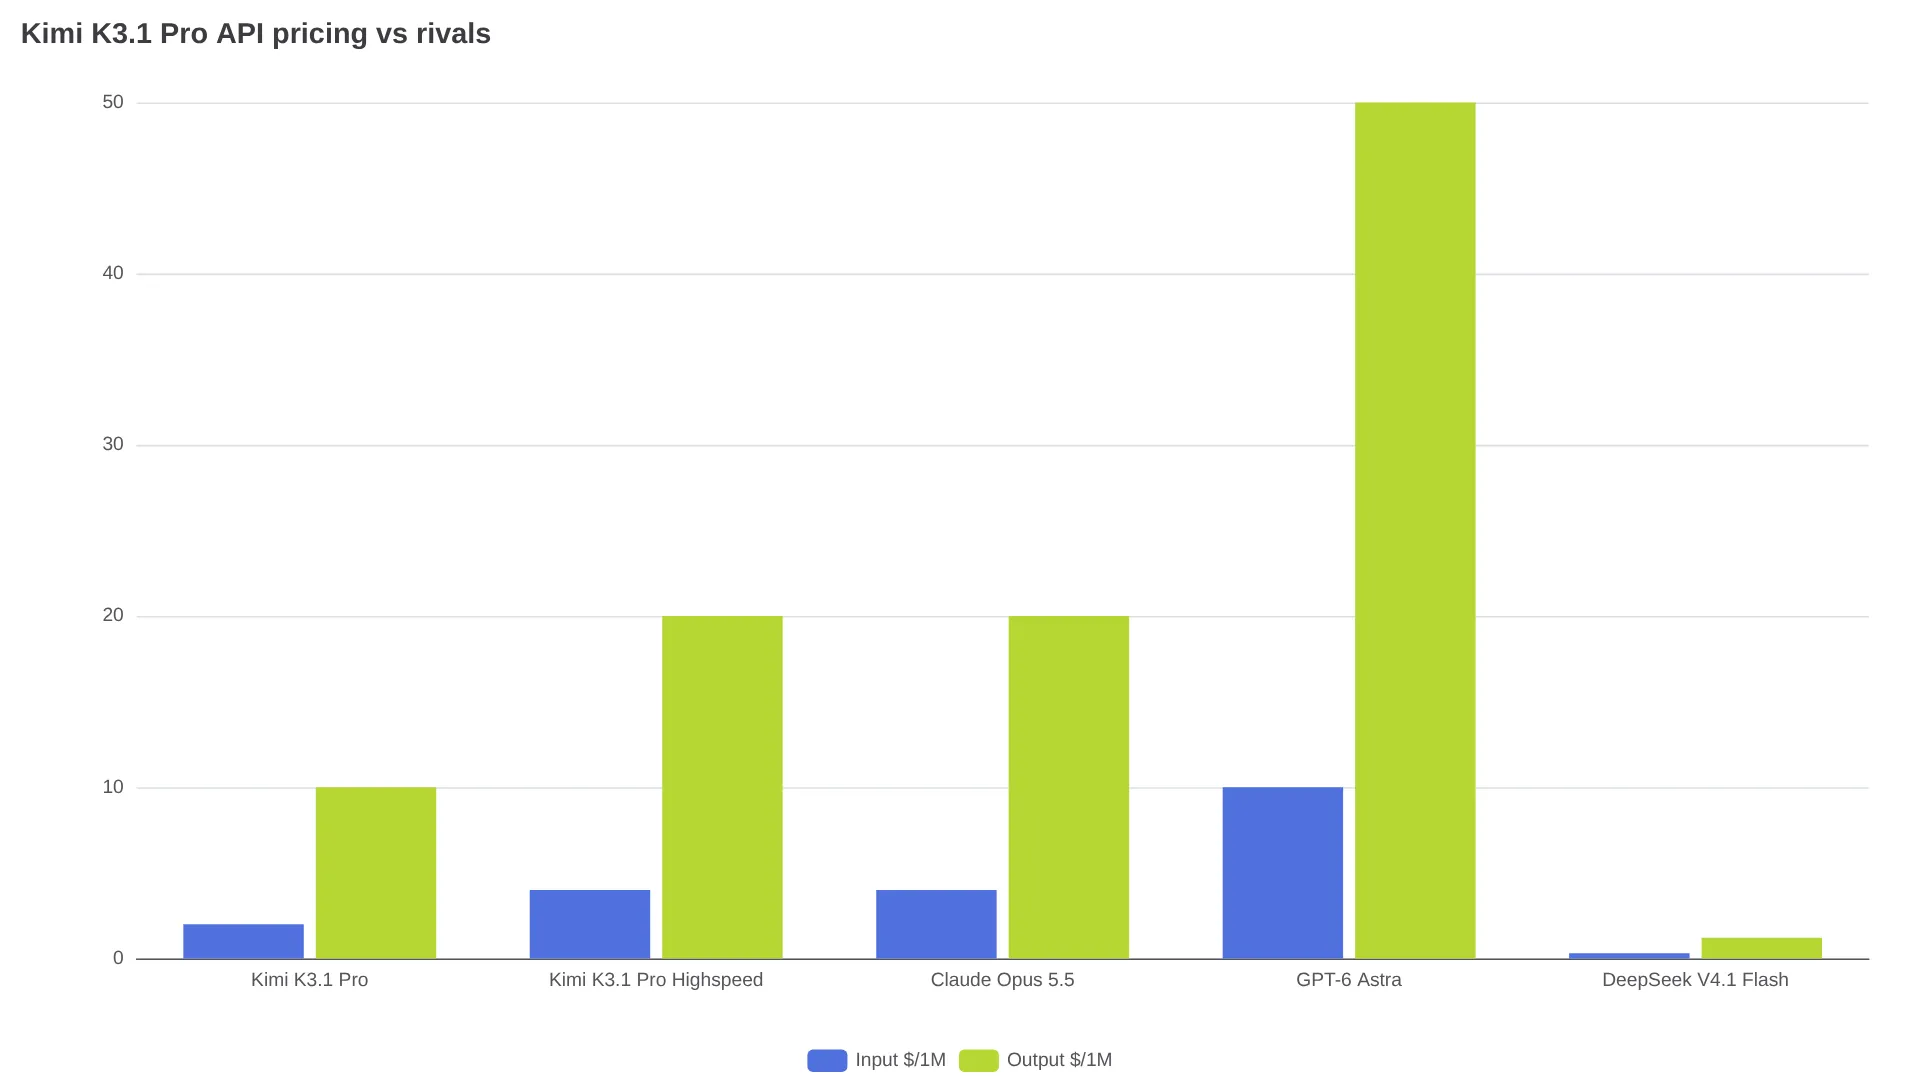
Frente a sus rivales, K3.1 Pro estándar cuesta un 33% menos que Kimi K3 ($3/$15), la mitad que Claude Opus 5.5 ($4/$20) y una quinta parte de GPT-6 Astra ($10/$50), según la comparativa de ArtificialWatch. DeepSeek V4.1 Flash rebaja a todos los modelos citados con $0.30/$1.20, según la tabla de precios de AI/ML API, aunque sus resultados en los benchmarks de la siguiente sección quedan muy por detrás. Highspeed iguala exactamente el precio de Opus 5.5, así que solo compensa si su aceleración anunciada de 2-3x reduce lo suficiente una tarea limitada por latencia como para justificar duplicar el coste por token.
Por qué la suscripción de $39 se agota y la API no
El precio de la API parecía razonable el día del lanzamiento; el de la suscripción, no. Varios usuarios de pago informaron de que su cuota de 5 horas desaparecía tras uno o dos prompts, y de que una sola tarea de programación consumía cuotas mensuales.
"Kimi K3.1 Pro is the best open model in the world right now. No contest. But it's practically unusable on its own subscription. I was on the $39 plan. I built the ship test... it ate 11.6% of my monthly quota. That means I can build something like this about 8 times a month... Worst subscription out there... The bottleneck isn't quality. It's compute." — @Da7_Tech, consumo de cuota reportado por un usuario
"absolutely disgusting and shameful usage limits on Kimi K3.1 Pro. My 5-hour limit was DONE after exactly 1 min into the prompt, and nothing was built!" — @MiaAI_lab, suscriptora del plan de $39
Un usuario afirmó haber gastado $400 en suscripciones para cuatro prompts y calculó que el mismo trabajo costaría $29 mediante API. Otro informó de que una única tarea de animación consumió la mayor parte de una cuota de 5 horas. Para desarrolladores, la conclusión es clara: conviene evaluar K3.1 Pro mediante API de pago por uso —Moonshot, OpenRouter o Vercel AI Gateway—, donde 100k de entrada más 10k de salida cuestan $0.30 antes de reintentos y herramientas, y no mediante una cuota de suscripción que mide ese mismo razonamiento de forma mucho más restrictiva.
Benchmarks: qué dicen y qué matices tienen
Todos los resultados principales de abajo proceden de Moonshot, salvo que se indique lo contrario. Se ejecutaron con esfuerzo de razonamiento máximo, temperatura 1.0 y top-p 0.95. Las diferencias pequeñas dependen de la configuración: las puntuaciones rivales se recogieron con harnesses distintos —Kimi Code para Kimi, Claude Code para los demás y Codex para GPT-6 Astra en OfficeQA—, tal como documenta AI/ML API.
| Evaluación | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | 40.0% |
| Agents' Last Exam v1.1 | 43.2% | 42.6% | 32.8% | 37.7% |
| OfficeQA Pro v2 | 64.4% | 62.2% | 54.4% | 40.4% |
| BenchCAD with tools | 92.7% | 96.2% | 95.9% | 81.6% |
Kimi lidera tres de las cinco pruebas y queda 0.7 puntos por detrás en Terminal-Bench. Según apunta TheQuery, esa diferencia es inferior al error estándar de 2.6 puntos comunicado por Anthropic para Opus. El 92.7% de BenchCAD mide la superposición de vóxeles en un subconjunto abierto de 1.000 casos, y las cifras de Claude se importaron de su system card en lugar de obtenerse en una repetición uniforme, según las notas metodológicas de AI/ML API.
En factualidad, el benchmark interno Kimi Hallu Bench de Moonshot atribuye a K3.1 Pro un 5.4% de errores a nivel de afirmación en el conjunto estándar, frente al 4.2% de GPT-6 Astra, y un 8.3% frente al 5.5% en el conjunto Hard with-tools, de acuerdo con la tabla Hallu de AI/ML API. Supone una reducción relativa del 65% respecto al 23.4% de K3 en el conjunto difícil, pero Astra sigue liderando en ambas divisiones. Si una sola afirmación errónea invalida el resultado, Astra debe seguir en la lista de candidatos. Todos son tests de estrés adversariales, no probabilidades de error en uso cotidiano.
El único dato independiente disponible durante el lanzamiento procedió de Artificial Analysis, que otorgó a K3.1 Pro un 55 en su Intelligence Index y lo situó en el puesto #4 global, por detrás de Claude Opus 5.5, Sonnet 5.5 y Muse Wonder Full. Esa posición respalda la idea de un modelo cercano a la frontera por la mitad de precio sin depender exclusivamente de pruebas del proveedor.
Cómo llamarlo desde la API sin pagar de más
Kimi K3.1 Pro es compatible con OpenAI, por lo que migrar consiste en cambiar la URL base y el ID del modelo. La base oficial es https://api.moonshot.ai/v1, con los IDs kimi-k3.1-pro y kimi-k3.1-pro-highspeed, según la comprobación de endpoints de TheQuery y la guía de configuración de AI/ML API. Las pasarelas de terceros emplean IDs con espacio de nombres, como moonshot/kimi-k3.1-pro en Requesty o moonshotai/kimi-k3.1-pro en Vercel.
El quickstart fija la temperatura en 1.0 y top-p en 0.95, y recomienda omitirlos en vez de ajustarlos, según las notas de comportamiento de API de TheQuery. El control de costes debe hacerse con reasoning_effort: empieza con low para pruebas, sube a high si una tarea falla y reserva max, el valor por defecto, para la ejecución final. Un presupuesto de max_completion_tokens de 8.192 tokens puede producir una respuesta visible mucho más corta, porque el razonamiento oculto consume ese mismo presupuesto a $10 por millón.
Lista de control para reducir costes, según la guía de uso de herramientas y tokens de AI/ML API:
- Conserva el mensaje completo del asistente entre pasos de herramientas, incluido
reasoning_contental usar streaming, y devuelve los resultados de las herramientas antes de la siguiente llamada. - Reutiliza los prefijos de prompt dentro de la ventana de caché de 5 minutos para reducir la entrada repetida a $0.20 por millón.
- Mide el coste por resultado aceptado, no por token.
- Un modelo más barato por token no siempre cuesta menos si necesita dos reintentos.
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
Una recarga de $1 habilita el acceso, sujeto a límites de tasa por niveles, y el acceso empresarial viene desactivado por defecto hasta que un administrador lo habilite, según la comprobación de comportamiento de API de TheQuery. En privacidad, la auditoría de Opper sobre la ruta de Moonshot informa de que el contenido se retiene y los datos de clientes se usan para entrenamiento por defecto, sin una opción de retención cero de datos en esa ruta. No envíes datos confidenciales o regulados por ella sin garantías contractuales.
¿Merece la pena? El coste que debes tener en cuenta
| Si necesitas | Elige | Motivo |
|---|---|---|
| Ejecuciones de programación de clase frontier al menor coste | API de Kimi K3.1 Pro | Lidera SWE-Marathon por la mitad del precio de Opus y ofrece 1M de contexto compartido |
| La menor latencia | Kimi K3.1 Pro Highspeed | Aceleración anunciada de 2-3x, pero exactamente 2x el coste por token |
| Menos errores factuales | GPT-6 Astra | 4.2% frente a 5.4% en Hallu estándar, por 5x el precio |
| Los tokens más baratos, con peores resultados | DeepSeek V4.1 Flash | $0.30/$1.20, pero el más bajo en cuatro de los cinco benchmarks listados |
| Autoalojamiento | Espera | Pesos prometidos para el 4 de noviembre con licencia desconocida |
Si Moonshot publica los pesos completos bajo una licencia permisiva antes del 4 de noviembre, el autoalojamiento podría cambiar por completo las cuentas entre cuota y API. Quienes comparen modelos de programación con contexto largo también deberían revisar el mejor LLM para agentes de programación en 2026 antes de decidirse.
Preguntas frecuentes sobre la API de Kimi K3.1 Pro
¿Cuánto cuesta la API de Kimi K3.1 Pro?
Kimi K3.1 Pro estándar cuesta $2 por millón de tokens de entrada sin caché y $10 por millón de tokens de salida, con lecturas de entrada en caché a $0.20 por millón. Highspeed duplica las tarifas de entrada, salida y escritura en caché, pero mantiene el precio de $0.20 para las lecturas en caché.
¿Qué diferencia hay entre K3.1 Pro y Highspeed?
Highspeed anuncia la misma inteligencia con una velocidad de servicio 2-3x superior a cambio de duplicar el precio de entrada y salida ($4/$20 frente a $2/$10). La tabla de proveedores en tiempo real de Vercel muestra menor latencia y mayor rendimiento para Highspeed, aunque la afirmación de Moonshot sobre la aceleración no cuenta con una comparación independiente de finalización de tareas.
¿Cuáles son los IDs de modelo de la API?
En la API oficial de Kimi, usa kimi-k3.1-pro y kimi-k3.1-pro-highspeed; en pasarelas de terceros, emplea equivalentes con espacio de nombres, como moonshot/kimi-k3.1-pro. Las integraciones existentes de K3 deben cambiar los IDs explícitamente.
¿El uso de la API está incluido en una membresía de Kimi?
No. Los cargos de la API son independientes de las membresías de Kimi y de las suscripciones a Kimi Code. Los usuarios de la semana de lanzamiento comprobaron que las cuotas de suscripción eran mucho más restrictivas que los tokens de pago por uso para el mismo trabajo.
¿Se puede desactivar el razonamiento?
No. Kimi K3.1 Pro siempre razona; low, high y max solo reducen la deliberación, y max es el valor predeterminado. Para solicitudes cortas que no requieran razonamiento, usa otro modelo.
¿La API es compatible con OpenAI?
Sí. Apunta un cliente SDK de OpenAI a https://api.moonshot.ai/v1 —o a la URL base de una pasarela—, establece el ID del modelo y usa streaming con stream=True. El quickstart fija temperatura 1.0 y top-p 0.95. Ajusta reasoning_effort y max_completion_tokens en su lugar.