 AIREITER
MiniMax M3.1 Flash publicó sus open weights el 23 de octubre de 2026. Más allá del ruido del lanzamiento, la conclusión práctica es sencilla: el checkpoint descargable de 428B está fuera del alcance de casi cualquier configuración con una sola GPU. El repositorio MiniMaxAI/MiniMax-M3.1-Flash reúne unos 252 GB en 48 fragmentos y se descarga sin aprobación previa, pero la MiniMax Community License condiciona el uso comercial a atribución, una notificación única y autorización previa si los ingresos anuales superan $20M.
Veredicto rápido sobre el checkpoint de 252 GB
MiniMax M3.1 Flash es un modelo multimodal nativo de mezcla de expertos, con aproximadamente 428.000 millones de parámetros totales y unos 23.000 millones activados por token. Admite texto, imágenes y vídeo como entrada, genera texto y maneja hasta 1.000.000 de tokens de contexto. Incorpora MiniMax Sparse Attention en toda la arquitectura y un cabezal de borrador DSpark para decodificación especulativa. Los pesos ya se pueden descargar desde Hugging Face y mediante un mirror de ModelScope, pero «Flash» habla de la economía de inferencia, no de un modelo pequeño; y «open weights» no equivale a código abierto.
| Dato | Valor verificado |
|---|---|
| Parámetros totales / activos | ~428B en total, ~23B por token |
| Ventana de contexto | Hasta 1.000.000 de tokens |
| Entradas / salida | Texto, imagen y vídeo de entrada; texto de salida |
| Tamaño del checkpoint | ~252 GB, 48 fragmentos safetensors + cabezal de borrador DSpark |
| Cuantización | Configuración MXFP8; NVFP4 en la ruta MoE enrutada |
| Ajustes de inferencia | Temperatura 1.0, top-p 0.95, reasoning_effort low / medium / high / xhigh / max |
| Recetas de serving | SGLang, vLLM, TokenSpeed; FlagOS para varios chips |
| Precio de API | $0.15 entrada / $0.60 salida / $0.015 en caché por 1M de tokens |
| Coste medido por tarea | ~$0.22 por tarea agéntica (Artificial Analysis vía TPS Report) |
| Licencia | MiniMax Community License; uso comercial condicionado |
Encaja en equipos con infraestructura multi-GPU y en cargas de trabajo agénticas cuyo gasto actual ya sea superior a los $0.15/$0.60 de la API. No encaja en portátiles ni en equipos con una única GPU de consumo, ni en productos comerciales que no puedan incluir la atribución requerida. Mi lectura: empieza por la API y plantéate el autoalojamiento solo si el volumen o el control de los datos justifican el hardware.
Cómo descargar y comprobar los pesos oficiales
El checkpoint oficial está en MiniMaxAI/MiniMax-M3.1-Flash en Hugging Face. El anuncio de MiniMax del 23 de octubre enlaza las descargas de Hugging Face y ModelScope. El análisis de lanzamiento de pesos de alfw.ai sitúa la descarga en unos 252 GB y sin barrera de acceso: 48 fragmentos de pesos, un cabezal de borrador DSpark independiente, además de los archivos de tokenizer y configuración.
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash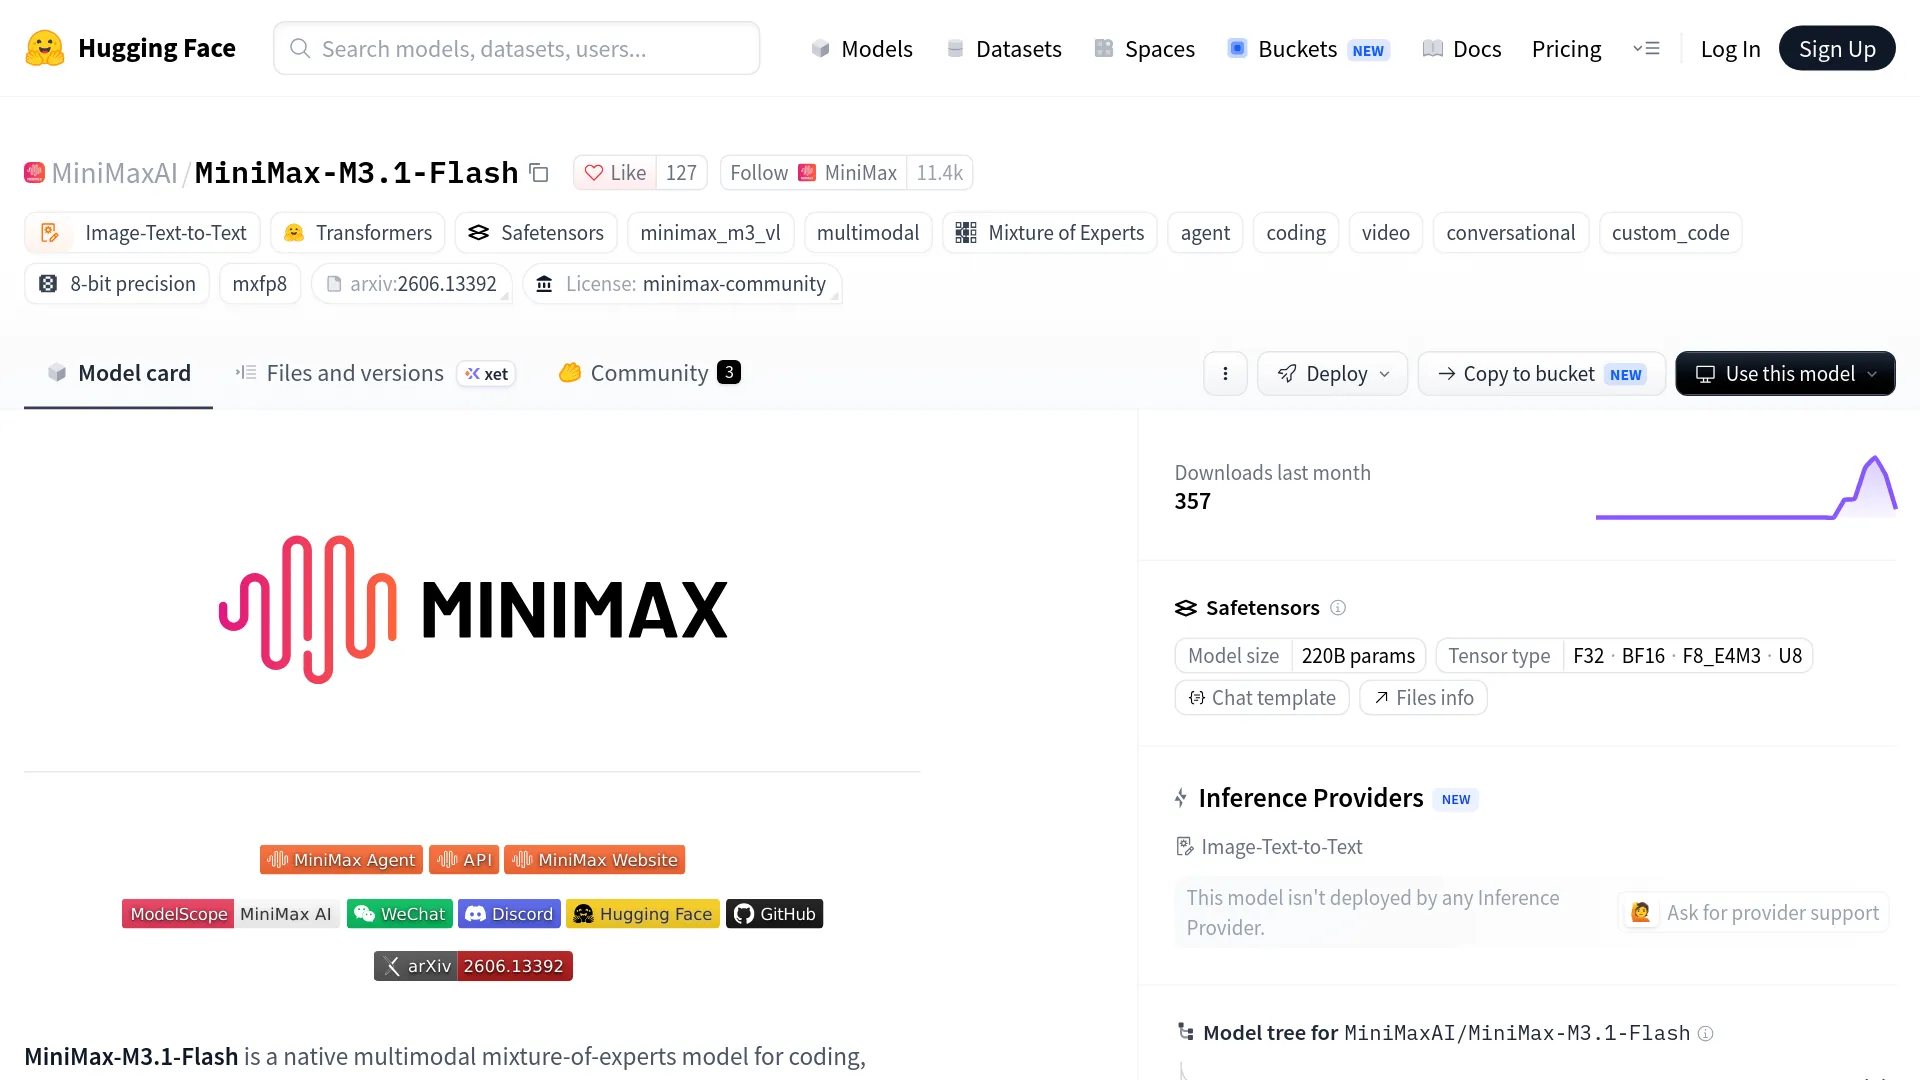
Antes de calcular el hardware, revisa tres puntos directamente en la página del repositorio. Primero, confirma que la lista de archivos incluye los 48 fragmentos y el cabezal de borrador, y no un mirror incompleto. Segundo, verifica que el campo de licencia indique minimax-community, no MIT ni Apache, e ignora etiquetas antiguas de prerreleases en páginas agregadoras. Tercero, recuerda la advertencia de la propia tarjeta: las puntuaciones publicadas corresponden a los pesos oficiales y las cuantizaciones de terceros pueden comportarse de otra forma. Por tanto, trata cualquier EXL3 o reempaquetado que circule esta semana como no verificado hasta que identifique su commit base.
¿Puedes autoalojarlo? Primero haz las cuentas de hardware
Que solo se activen 23B de parámetros por token no reduce el tamaño de un modelo de 428B; aquí es donde se equivocan la mayoría de los debates sobre si puede ejecutarse en local. Los parámetros activos determinan el coste de inferencia por token; los parámetros totales determinan lo que hay que almacenar y mantener en memoria. En BF16, 428.000 millones de parámetros por 2 bytes implican unos 856 GB solo para los pesos, mientras que una representación genérica de 4 bits rondaría los 214 GB. Los 252 GB reales del repositorio reflejan su formato cuantizado de entrenamiento, además de tokenizer, configuración y archivos del cabezal de borrador, antes de sumar búferes de ejecución y caché KV.
"MiniMax-M3.1-Flash open weights are now LIVE 🔥🔥 428B params, 23B active." — @MiaAI_lab, señalando la descarga de ~252 GB junto con una receta de TensorFold y trabajo de cuantización EXL3
El umbral de hardware es alto incluso para equipos. @perry_weijie apunta que las máquinas personales prácticamente no pueden moverlo y que las instalaciones propias tienen sentido para equipos con tarjetas disponibles. Como medición de puesta en marcha del día 0, encontré TP4 en 4x DGX Spark de @majewskizby: reportó unos 39.7 tok/s en decodificación de prosa y 62.2 tok/s en decodificación estructurada, con 262K de contexto, rutas NVFP4/MXFP8 y atención dispersa Triton. Es un dato del día 0, no una diapositiva del fabricante, y aun así requiere cuatro nodos de gama alta trabajando en conjunto.
Las rutas realistas, ordenadas por esfuerzo, son:
- SGLang con el cookbook enlazado, incluido el patrón Docker de la tarjeta del modelo (
--shm-size 32g, puerto 30000 y montaje de caché HF). - vLLM con la receta enlazada (
vllm serveen el puerto 8000 en el ejemplo de la tarjeta). - TokenSpeed con su receta enlazada para una ruta centrada en eficiencia.
- FlagOS para despliegues en varios chips.
Hay dos problemas de configuración que ya están afectando a usuarios. El esfuerzo de razonamiento viene por defecto en el máximo, lo que dispara factura y latencia si nunca ajustas el control de low a max. Las notas independientes de configuración de minimax-m31flash.org añaden fallos clásicos de integración agéntica: sufijo de modelo incorrecto para contexto largo, variables de entorno que sobrescriben los archivos de configuración, versiones mínimas de Codex desactualizadas y nombres de modelos preview retirados. La tarjeta indicaba que las integraciones con Transformers, KTransformers, unsloth y ATOM seguían en desarrollo, así que conviene comprobar su estado antes de basar un plan en ellas. alfw.ai recoge la compatibilidad anunciada con 10 fabricantes de chips y seis nubes, pero tómalo como un anuncio de compatibilidad hasta que el catálogo del proveedor que pagas muestre realmente el modelo.
API frente a autoalojamiento: decide por coste de tarea
Mirar solo el precio por token induce a error, porque el trabajo agéntico está dominado por los tokens de razonamiento y el comportamiento de la caché. La API plana de MiniMax cuesta $0.15 por millón de tokens de entrada, $0.60 por salida y $0.015 por entrada en caché, sin escalón por contexto largo; MiniMax M3, en cambio, duplica el precio a partir de 512K tokens de entrada según minimax-m31flash.org. Artificial Analysis midió unos $0.22 por tarea para M3.1 Flash frente a $0.26 para DeepSeek V4.1 Flash 1017 en la misma suite, con 189M frente a 224M tokens de salida respectivamente: una ventaja de coste por tarea de aproximadamente el 15%, procedente de un razonamiento más eficiente y no de simples recortes de tarifa.
| Ruta | Mejor para | Precaución |
|---|---|---|
API de MiniMax (api.minimax.io, compatible con Anthropic/OpenAI según minimax-m31flash.org) | Agentes de programación, carga variable y trabajo con 1M de contexto sin hardware | El esfuerzo de razonamiento máximo es el predeterminado; la caché y la configuración del nivel de servicio determinan la factura real |
| Suscripción M Plan (niveles Go / Explore / Build según minimax-m31flash.org) | Uso predecible de asistente de programación dentro de MiniMax Code | Límites por ventana, no una bolsa mensual plana de tokens; revisa los precios en dólares antes de presupuestar |
| Autoalojamiento (SGLang / vLLM / TokenSpeed, FlagOS multichip) | Volumen alto y sostenido, necesidades de control de datos y base para fine-tuning | Descarga de 252 GB, memoria multi-GPU más caché KV con contexto largo, sin especificación mínima verificada |
Haz las cuentas para tu carga antes de descargar nada: multiplica tu reparto mensual de entrada y salida por $0.15/$0.60, aplicando tu tasa real de aciertos de caché, y compáralo con el coste de GPU reservadas más el tiempo de ingeniería. En la mayoría de los casos por debajo de un volumen alto sostenido, la API suele ganar; el autoalojamiento puede imponerse cuando la factura mensual de API supera el coste amortizado del clúster o cuando los pesos deben permanecer dentro de tu perímetro.
Benchmarks: separando quién los midió
| Benchmark | M3.1 Flash | Mejor rival de la tabla citada | Fuente |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 DeepSeek V4.1 Flash-1017 | Tarjeta de MiniMax (fabricante) |
| BankerToolBench | 76.2 | 76.2 Opus 5 (empate) | Tarjeta de MiniMax (fabricante) |
| LOCA-Bench 256K | 60.3 | 60.0 GPT-5.6 Sol | Tarjeta de MiniMax (fabricante) |
| OSWorld 2.0 | 61.7 | 70.6 Opus 5 | Tarjeta de MiniMax (fabricante) |
| CyberGym | 82.2 | 84.5 GLM-5.3 | Tarjeta de MiniMax (fabricante) |
| DeepSWE v1.1 | 73.7 | 77.0 DeepSeek V4.1 Flash-1017 | Tarjeta de MiniMax (fabricante) |
| Vals Index | 53.78% (16.º de 26) | MiMo V2.6 Flash 54.83% (en el lanzamiento) | Vals AI (independiente) |
| Intelligence Index | 42 | 45 DeepSeek V4.1 Flash 1017 | Artificial Analysis vía TPS Report (independiente) |
| LMArena WebDev | 1587.48 | campo clasificado | VectorWire (único de 10 verificado de forma independiente) |
La tarjeta de MiniMax documenta los harnesses de cada benchmark —BankerToolBench en OpenCode 1.17.18 con MiniMax-M2.7 como juez; CyberGym en Claude Code 2.1.263 con 1M de contexto—, un nivel de transparencia superior al de la mayoría de anuncios de lanzamiento, pero las puntuaciones siguen siendo reportadas por el fabricante. Las lecturas independientes son más matizadas: Vals AI muestra un salto de 26.37 puntos en Vibe Code Bench frente a M3, aunque señala debilidad a largo plazo —Terminal-Bench 25.25%, HLAB-Vals 7.50% en su harness—; Artificial Analysis combina una sólida precisión de omnisciencia del 56% con una tasa de alucinación del 93% en ese benchmark; y VectorWire considera que hay evidencia insuficiente para clasificar ninguna capacidad. Toma esa tasa de alucinación como aviso para añadir verificación en recuperación de información, cumplimiento y respuestas de cara al cliente.
Las condiciones de licencia que determinan el uso comercial
Los pesos se pueden descargar, pero la MiniMax Community License no es una licencia de código abierto sin restricciones. La concesión está planteada para uso no comercial, y el uso comercial solo se permite con condiciones: los productos o servicios deben mostrar de forma visible "Built with MiniMax M3.1-Flash", el usuario debe enviar una notificación única a MiniMax y cualquier actividad que genere más de $20M de ingresos anuales requiere autorización previa por escrito de MiniMax. La definición de uso comercial es lo bastante amplia como para incluir acceso alojado de pago, APIs de modelos, fine-tunes y derivados modificados. Quedan prohibidos los usos militares y la generación intencionada de información falsa, dañina o engañosa. El análisis de licencia de alfw.ai no encontró restricciones territoriales en la licencia de este modelo, aunque esa interpretación procede de un análisis de terceros y no de una FAQ de MiniMax; confírmalo con asesoría legal antes de lanzar un producto. Clasificación: open weights, no open source.
Preguntas frecuentes
¿Los pesos de MiniMax M3.1 Flash se pueden descargar de verdad?
Sí. MiniMaxAI/MiniMax-M3.1-Flash apareció en Hugging Face el 23 de octubre de 2026 con unos 252 GB de archivos, sin aprobación previa, y con un mirror en ModelScope.
¿Cuál es el repositorio oficial de Hugging Face?
MiniMaxAI/MiniMax-M3.1-Flash: 48 fragmentos safetensors, cabezal de borrador DSpark, tokenizer y configuración, con etiqueta de licencia minimax-community. Usa hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
¿Puedo usar M3.1 Flash comercialmente?
De forma condicionada. Muestra "Built with MiniMax M3.1-Flash", envía la notificación única y obtén autorización previa por escrito por encima de $20M de ingresos anuales. Los fine-tunes y las APIs alojadas cuentan como uso comercial.
¿Puede ejecutarse en una GPU de consumo o en Apple Silicon?
No se cita aquí ningún despliegue validado con una sola GPU de consumo ni con Apple Silicon: el checkpoint completo ocupa ~252 GB y el cálculo en BF16 implica unos ~856 GB solo de pesos, lo que descarta las configuraciones habituales de memoria GPU. Cuenta con servidores multi-GPU o un proveedor cloud; la ejecución del día cero citada aquí usó 4x DGX Spark.
¿Funciona con vLLM, SGLang o TokenSpeed?
Sí, mediante las recetas oficiales enlazadas desde la tarjeta del modelo. SGLang y vLLM son las rutas recomendadas, y TokenSpeed es la tercera receta. FlagOS cubre despliegues multichip. Las integraciones de la familia Transformers seguían en desarrollo en el lanzamiento.
¿Cómo se compara con DeepSeek V4.1 Flash?
Resulta más barato por tarea (~$0.22 frente a ~$0.26 en la suite de AA) y obtiene mejor precisión de HLE y omnisciencia en esa instantánea, pero queda por detrás en Intelligence Index agregado (42 frente a 45) y en DeepSWE (73.7 frente a 77.0 para la compilación 1017). Para programación agéntica eficiente en costes, merece una prueba por lotes de tareas; si pesan más el índice agregado y DeepSWE, valida DeepSeek con tus propias tareas. Siguiente paso: ejecuta un lote de tareas de API de pago cambiando el esfuerzo de razonamiento máximo predeterminado por tu ajuste elegido y decide después si merece la pena descargarlo.