 AIREITER
Si necesitas descargar y alojar un checkpoint por tu cuenta esta semana, la decisión entre estos dos modelos es sencilla: MiniMax M3.1 Flash es el único disponible. Sus pesos abiertos ya se pueden bajar, mientras que Moonshot ha prometido publicar los de Kimi K3.1 Pro antes del 4 de noviembre de 2026.
MiniMax es el único checkpoint disponible para descargar
MiniMax publicó los pesos de M3.1 Flash aproximadamente entre el 22 y el 23 de octubre de 2026 en Hugging Face, bajo la licencia minimax-community. La cobertura de su lanzamiento también informó de su disponibilidad en ModelScope (Cocoloop). Por su parte, el blog técnico oficial de Kimi indica que Kimi K3.1 Pro ya puede utilizarse en Kimi.com, sus aplicaciones, Kimi Code y la API de Kimi, pero que los pesos completos no llegarán hasta el 4 de noviembre de 2026 (kimi.com).
MiniMax M3.1 Flash y Kimi K3.1 Pro: especificaciones clave
Los pesos abiertos de MiniMax M3.1 Flash corresponden a un MoE multimodal nativo de aproximadamente 428.000 millones de parámetros totales, con 23.000 millones activos por token. Acepta texto, imágenes y vídeo como entrada, genera texto y admite hasta 1M de tokens de contexto (anuncio de MiniMax). Kimi K3.1 Pro se presenta oficialmente como un MoE de la clase 3T con una ventana de contexto de 1M de tokens (kimi.com). Las cifras de 2.8T de parámetros totales y 104B activos proceden de la cobertura de lanzamiento, no de una declaración propia de Moonshot (ArtificialWatch, ExplainX).
| Aspecto | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| Parámetros totales / activos | ~428B / 23B por token | Clase 3T; la cobertura de lanzamiento informa de 2.8T / 104B activos |
| Repositorio en Hugging Face | MiniMaxAI/MiniMax-M3.1-Flash, disponible | Ninguno a 24 de octubre de 2026; previsto para el 4 de noviembre |
| Tamaño de descarga | Aproximadamente 252 GB | Desconocido; con la densidad de MiniMax (~0.59 GB por B de parámetros), un checkpoint de 2.8T sería de clase TB |
| Contexto | Hasta 1M de tokens, según el despliegue | 1M de tokens |
| Entradas / salida | Texto, imagen y vídeo como entrada; texto como salida | Multimodal, salida de texto; modalidades exactas en autoalojamiento sin confirmar |
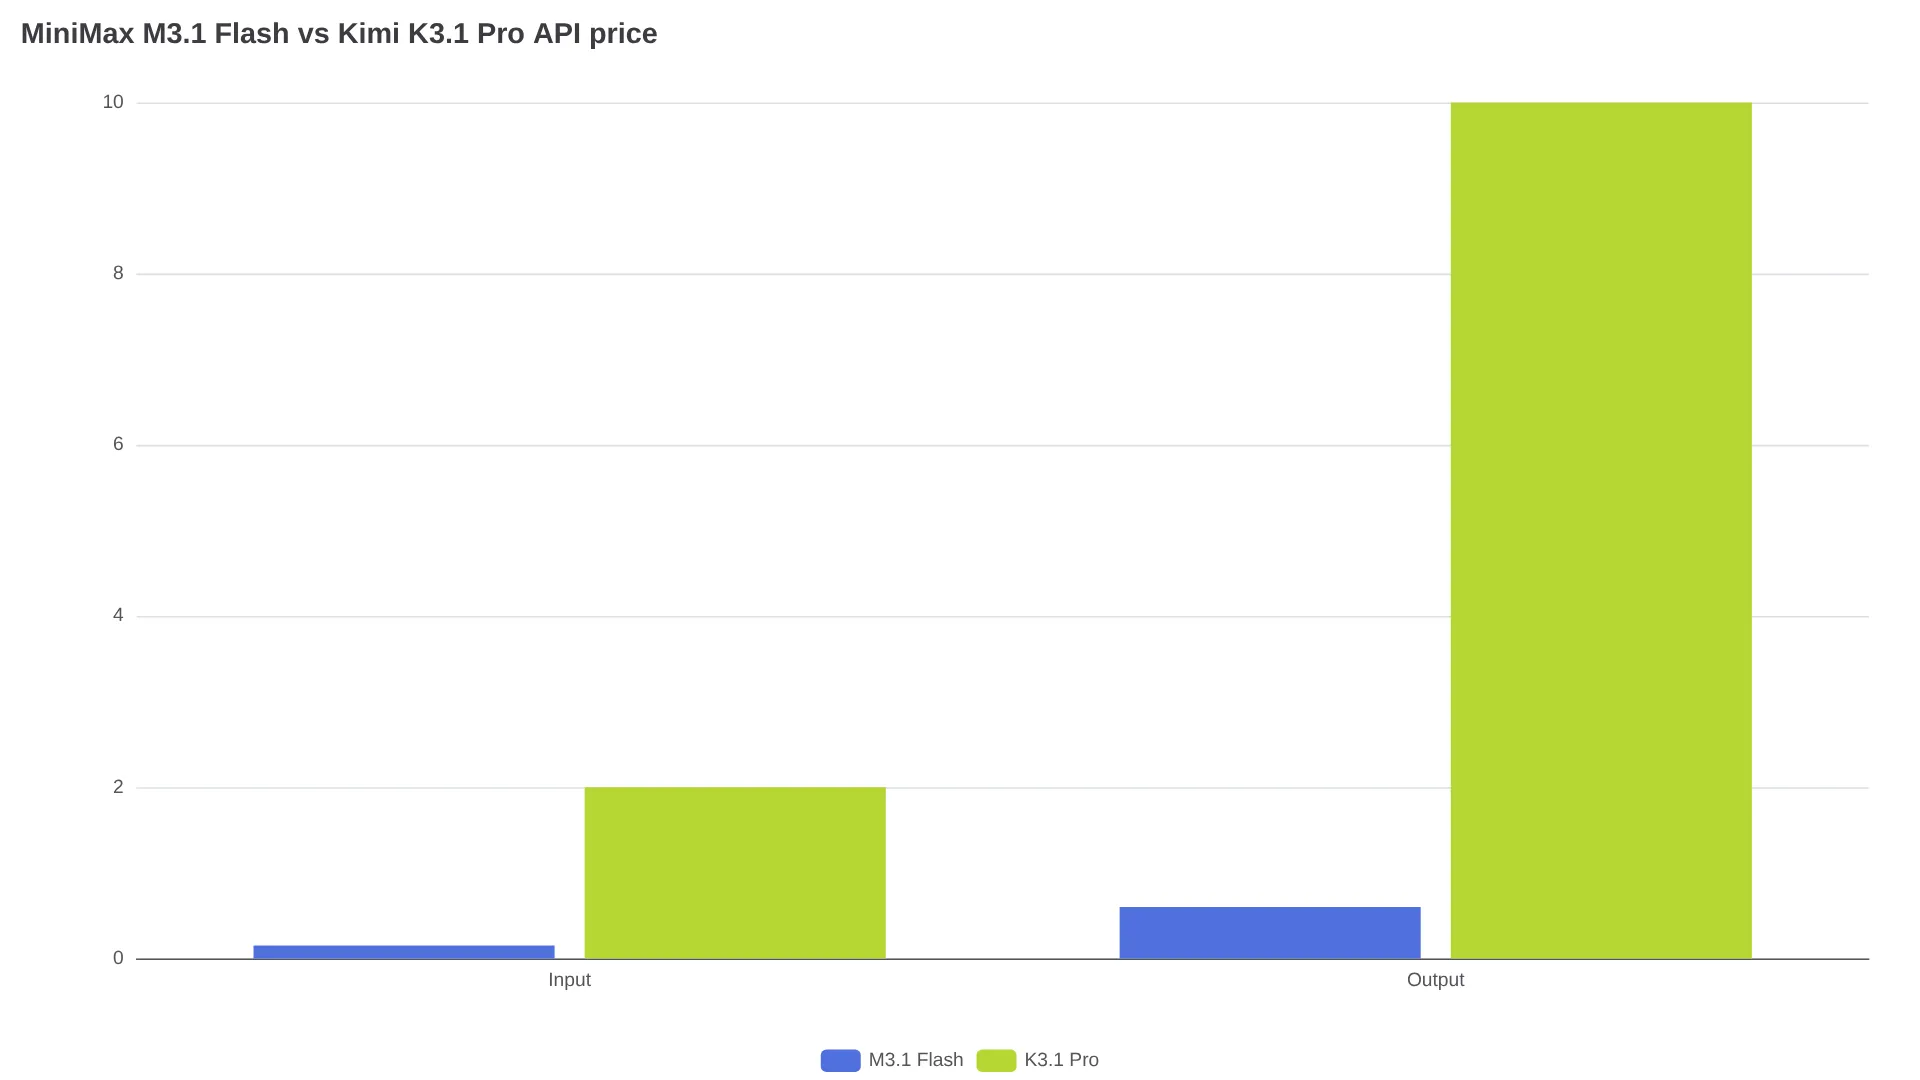
| Precio oficial de API | $0.15 de entrada / $0.60 de salida / $0.015 en caché por 1M de tokens (MiniMax) | $2 de entrada / $10 de salida por 1M de tokens según los informes (ArtificialWatch) |
| Recetas de serving | SGLang, vLLM, TokenSpeed; FlagOS para varios chips | Sin anunciar; ID de modelo de API kimi-k3.1-pro / kimi-k3.1-pro-highspeed (documentación de Kimi) |
| Muestreo recomendado | Temperatura 1.0, top-p 0.95; razonamiento de low a max | Máximo esfuerzo de razonamiento, temperatura 1.0 y top-p 0.95 según la configuración de benchmarks de Kimi |
El comando oficial para descargar el checkpoint de MiniMax es:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashAntes de ejecutar benchmarks, comprueba que dispones del conjunto completo de archivos, incluido el draft head de DSpark, el tokenizador y los archivos de configuración. MiniMax advierte de que sus resultados se aplican a los pesos oficiales y pueden variar con cuantizaciones de terceros.
En cuanto a benchmarks, considera que las cifras siguientes proceden del proveedor salvo cuando se indique que son independientes:
| Benchmark | M3.1 Flash (proveedor) | Rival citado por el proveedor |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017: 60.5 |
| BankerToolBench | 76.2 | Opus 5: 76.2 (empate) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol: 60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017: 77.0 |
| OSWorld 2.0 | 61.7 | Opus 5: 70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5: 51.8 |
Una medición independiente citada sitúa a M3.1 Flash en la zona media, con un 53.78% y el puesto 16 de 26, además de resultados débiles en tareas de horizonte largo (Vals). La propia tabla de Kimi afirma que K3.1 Pro lidera 6 de las 14 pruebas mostradas, entre ellas Agents' Last Exam (43.2) y SWE Marathon (51.7), y le asigna un 65.7 en Terminal-Bench 4.0.
Qué implica alojar una descarga de 252 GB
El repositorio ocupa aproximadamente 252 GB. Con 4 bits por peso, los 428B parámetros por sí solos requieren unos 214 GB antes de sumar la caché KV y los búferes de ejecución; para disponer de contexto utilizable, conviene prever varias GPU de la clase 80 GB. La cuenta de NVIDIA RTX Spark apunta a una DGX Station o a un clúster de 4x DGX Spark de 128 GB para ejecuciones locales (publicación en X). Quienes autoalojan en X también señalan que una descarga de 252 GB, junto con ese requisito de hardware, deja fuera a los ordenadores de escritorio convencionales, mientras que la API sigue siendo económica (@bufcapy).
Antes de plantearte el hardware, conviene hacer cuentas con la API, porque la de MiniMax tiene un precio inusualmente bajo. A $0.15 por entrada y $0.60 por salida cada 1M de tokens, un día con 10M de tokens de entrada y 2M de salida cuesta 10 × $0.15 + 2 × $0.60 = $2.70, o aproximadamente $81 al mes.
El punto de equilibrio se calcula dividiendo el coste mensual del clúster entre el coste de API por token. Con $0.15 por 1M de tokens de entrada, cada $150 al mes de alquiler equivalen a 1B de tokens de entrada; con $0.60 por 1M de tokens de salida, cada $600 al mes equivalen a 1B de tokens de salida. Añade a la ecuación tu presupuesto de alquiler y el tiempo de ingeniería: el autoalojamiento solo gana cuando tu factura mensual de API a esas tarifas supera ese total, o cuando las políticas exigen mantener los pesos dentro de tu perímetro. La diferencia con Kimi es mayor: el precio de API informado de $2/$10 por 1M de tokens hace que su opción alojada cueste aproximadamente 13 veces más que MiniMax en entrada y unas 17 veces más en salida. Por ello, un futuro checkpoint de 2.8T de parámetros necesitaría un rendimiento sostenido muy elevado para justificar almacenamiento de clase TB y un clúster multinodo.
Qué ofrece el autoalojamiento desde el primer día
El soporte de frameworks desde el lanzamiento existe, aunque no es completo. La ficha del modelo menciona SGLang, vLLM y TokenSpeed, además de FlagOS para despliegues multichip, e incluye imágenes Docker para SGLang. En el momento del lanzamiento, las integraciones con Transformers, KTransformers, unsloth y ATOM seguían en desarrollo. Un responsable de despliegue señaló que la configuración de ejemplo de vLLM para H100/H200 apunta a 256K tokens, no al millón completo; además, desactiva la entrada de vídeo y no habilita la decodificación especulativa de DSpark (@sancaksofttech). Tener los mismos pesos no garantiza que todas las configuraciones habiliten las mismas funciones.
Una preocupación recurrente en r/LocalLLaMA es que «Flash» describe la economía de inferencia, no un modelo pequeño:
With quantization can it fit on 256GB? Praying — u/BawbbySmith en r/LocalLLaMA
La licencia puede decidirlo antes que el hardware
M3.1 Flash ofrece pesos abiertos, no código abierto. El archivo LICENSE del repositorio, identificado como minimax-community y disponible en el archivo LICENSE, permite libremente el uso no comercial. Para uso comercial exige mostrar de forma destacada «Built with MiniMax M3.1-Flash» y enviar una notificación única a MiniMax. Las organizaciones o productos con más de $20M de ingresos anuales necesitan autorización previa por escrito, y se prohíben los usos militares.
Para herramientas internas, esa carga es reducida; para un servicio comercial alojado puede ser un obstáculo, ya que la atribución y el umbral de ingresos son las condiciones más difíciles de cumplir. La licencia de Kimi seguirá siendo desconocida hasta que se publiquen los pesos el 4 de noviembre. Moonshot ya ha comunicado en su blog técnico que el checkpoint abierto diferirá del modelo de API porque se han retirado de los pesos abiertos los datos de entrenamiento relacionados con ciberseguridad (kimi.com). Lee ambos archivos LICENSE antes de construir sobre ellos.
Cuál encaja mejor en cada caso
| Tu situación | Elección |
|---|---|
| Necesitas pesos esta semana para evaluación local, una base de fine-tuning o un despliegue aislado de la red | MiniMax M3.1 Flash: es la única opción descargable de las dos |
| Agentes de programación sensibles al coste y con carga variable | API de MiniMax a $0.15/$0.60; autoaloja solo con un volumen elevado y sostenido |
| Programación de frontera a largo plazo y puedes esperar | Evalúa ahora la API de Kimi K3.1 Pro; decide sobre el autoalojamiento cuando lleguen los pesos, la licencia y el tamaño real el 4 de noviembre |
| Producto comercial alojado | Primero valida con el equipo legal la atribución de MiniMax y el umbral de autorización de $20M; Kimi no se puede valorar hasta que publique su licencia |
| GPU de consumo o un único Mac | No hay una receta validada para un único dispositivo entre las fuentes citadas; usa la API salvo que estés preparado para probar una configuración no soportada |
Preguntas frecuentes
¿Dónde se descargan los pesos oficiales de MiniMax M3.1 Flash?
El repositorio oficial es MiniMaxAI/MiniMax-M3.1-Flash en Hugging Face, con un espejo en ModelScope. Puedes descargarlo con hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
¿Existe un repositorio oficial de Kimi K3.1 Pro en Hugging Face?
No. A 24 de octubre de 2026 no hay ningún repositorio público con los pesos de K3.1 Pro; el blog técnico de Moonshot se compromete a publicar los pesos completos antes del 4 de noviembre de 2026.
¿Puedo usar MiniMax M3.1 Flash comercialmente?
Sí, con condiciones: debes mostrar «Built with MiniMax M3.1-Flash», enviar una notificación única y obtener autorización previa por escrito si superas $20M de ingresos anuales. Los usos militares están prohibidos. Confírmalo con asesoramiento legal a partir de la LICENSE del repositorio.
¿Puede ejecutarse en una GPU de consumo o en Apple Silicon?
La guía de despliegue citada no incluye una configuración validada para una sola GPU de consumo. Las estimaciones requieren varias GPU de 80 GB para los pesos cuantizados y la caché KV. NVIDIA apunta a una DGX Station o a un clúster de 4x DGX Spark de 128 GB.
¿Funciona ya con vLLM o SGLang?
Ambos cuentan con recetas disponibles desde el primer día, junto con TokenSpeed y FlagOS para ejecuciones multichip. Sin embargo, las configuraciones de ejemplo pueden limitar el contexto a 256K, desactivar la entrada de vídeo o dejar DSpark apagado. Revisa la receta actual de la ficha del modelo para tu hardware.
¿Está disponible el contexto completo de 1M al autoalojarlo?
El máximo anunciado es 1M de tokens, pero la longitud realmente utilizable depende de la memoria de las GPU y de la configuración de serving. Reserva explícitamente margen para la caché KV si vas a trabajar con contextos largos.
Lecturas relacionadas: MiniMax M3.1 Flash Open Weights: guía de descarga, ejecución y costes, Guía de precios de la API de Kimi K3.1 Pro, Kimi K3 Open Weights