 AIREITER
Para un agente de programación que no suele superar unos 150K tokens de contexto, Hy3 es la elección más sensata: ofrece mejor capacidad de razonamiento y cuesta prácticamente lo mismo por token de entrada. Pero si trabajas con sesiones largas, repositorios grandes o necesitas mucha concurrencia en producción, DeepSeek V4 Flash se impone por tres cifras que Hy3 no puede igualar: 1M de tokens de contexto, un precio documentado de $0.0028 por acierto de caché y un límite de 2,500 solicitudes concurrentes. Esa es la versión corta de la comparativa hy3 vs deepseek v4 flash. El análisis se apoya en precios consultados el 14 de julio de 2026 en la documentación oficial de DeepSeek y las tarifas activas de OpenRouter, además de benchmarks independientes y la experiencia diaria compartida por desarrolladores en Hacker News y Reddit.
Hy3 y Flash persiguen objetivos distintos
Tencent lanzó la versión final de Hy3 el 6 de julio de 2026, como evolución de la preview disponible desde el 23 de abril. Según el anuncio, se trata de un modelo Mixture-of-Experts con 295B parámetros totales y 21B activos. Su propuesta gira en torno a lo que Tencent denomina razonamiento híbrido rápido y lento: el propio modelo decide cuánto razonamiento dedica a cada petición. Su contexto llega a 256K tokens. Los pesos son abiertos bajo licencia Apache 2.0 y la API se ofrece a través de Tencent Cloud TokenHub.
DeepSeek V4 Flash llegó en abril de 2026 como la variante rápida de la familia V4. También es un MoE de pesos abiertos —284B parámetros totales y 13B activos, según Artificial Analysis—, pero usa licencia MIT y está orientado a otra prioridad: servir hasta 1M de tokens de contexto a bajo coste. Incluye modos con razonamiento y sin razonamiento, siendo el primero el predeterminado, y admite hasta 384K tokens de salida.
Sobre el papel, los recuentos de parámetros son parecidos. Sin embargo, sus objetivos de diseño no lo son. Hy3 prioriza la calidad del razonamiento por token; Flash apuesta por contexto, eficiencia de caché y rendimiento. De ahí nacen casi todas las diferencias prácticas de esta comparativa.
| Especificación (verificada el 2026-07-14) | Hy3 | DeepSeek V4 Flash |
|---|---|---|
| Parámetros | 295B totales / 21B activos | 284B totales / 13B activos |
| Ventana de contexto | 256K | 1M (384K de salida máxima) |
| Razonamiento | Razonamiento híbrido rápido/lento | Modos con y sin razonamiento |
| Licencia | Apache 2.0 | MIT |
| Lanzamiento | 6 de julio de 2026 (preview: 23 de abril) | Abril de 2026 |
| API oficial | Tencent Cloud TokenHub | api.deepseek.com (formatos OpenAI + Anthropic) |
Qué dicen realmente los benchmarks
En el Intelligence Index v4.1 de Artificial Analysis, Hy3 obtiene 41 puntos frente a los 37 de DeepSeek V4 Flash en modo de razonamiento con esfuerzo alto. Cuatro puntos en este índice representan una diferencia apreciable, aproximadamente la distancia entre Flash y los modelos situados un escalón por debajo. Aun así, no los separa una categoría completa: ambos encajan en el grupo de modelos muy capaces, pero no de frontera.
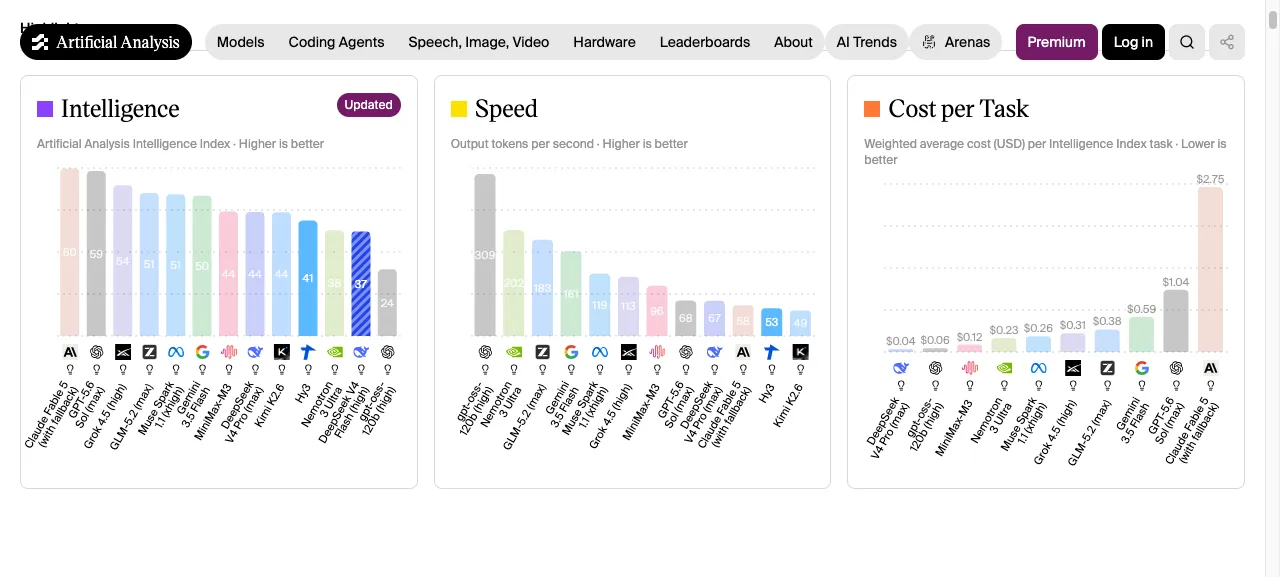
Conviene tener presentes dos matices antes de dar demasiado peso a esa puntuación.
Para empezar, los benchmarks de programación agéntica son bastante menos favorables para ambos. Un participante de el hilo de lanzamiento en Hacker News localizó el resultado DeepSWE de Hy3: 28%, frente al 52% de GPT-5.4 con esfuerzo máximo. Ninguno de estos dos modelos chinos se acerca a los mejores modelos de programación agéntica; compiten entre ellos, no con la cima de la clasificación.
Además, las tablas de benchmarks publicadas por los propios proveedores merecen el escepticismo habitual. Las cifras de lanzamiento de Hy3 recibieron acusaciones inmediatas de estar optimizadas para benchmarks en el hilo de HN, y las tablas de DeepSeek solo cubren las evaluaciones que decidió ejecutar. Las métricas independientes anteriores son una base más sólida: Hy3 es algo más inteligente, pero la distancia es lo bastante pequeña como para que el precio y el contexto cambien la decisión.
Precios: la tarifa base no cuenta toda la historia
Hay dos listas de precios, consultadas el 14 de julio de 2026, que conviene no mezclar. DeepSeek publica precios exactos por token para su API propia. Tencent no ofrece una tarifa equivalente en inglés para la versión final de Hy3 —su nota de prensa sitúa la entrada de Hy3 preview en alrededor de $0.18 por millón de tokens en TokenHub—, así que la columna de Hy3 usa las tarifas publicadas por OpenRouter: es un precio de marketplace, no del proveedor original.
| Por 1M de tokens | Hy3 (marketplace de OpenRouter) | DeepSeek V4 Flash (API propia) |
|---|---|---|
| Entrada | $0.14 | $0.14 (sin acierto de caché) |
| Entrada en caché | $0.035 | $0.0028 (acierto de caché) |
| Salida | $0.58 | $0.28 |
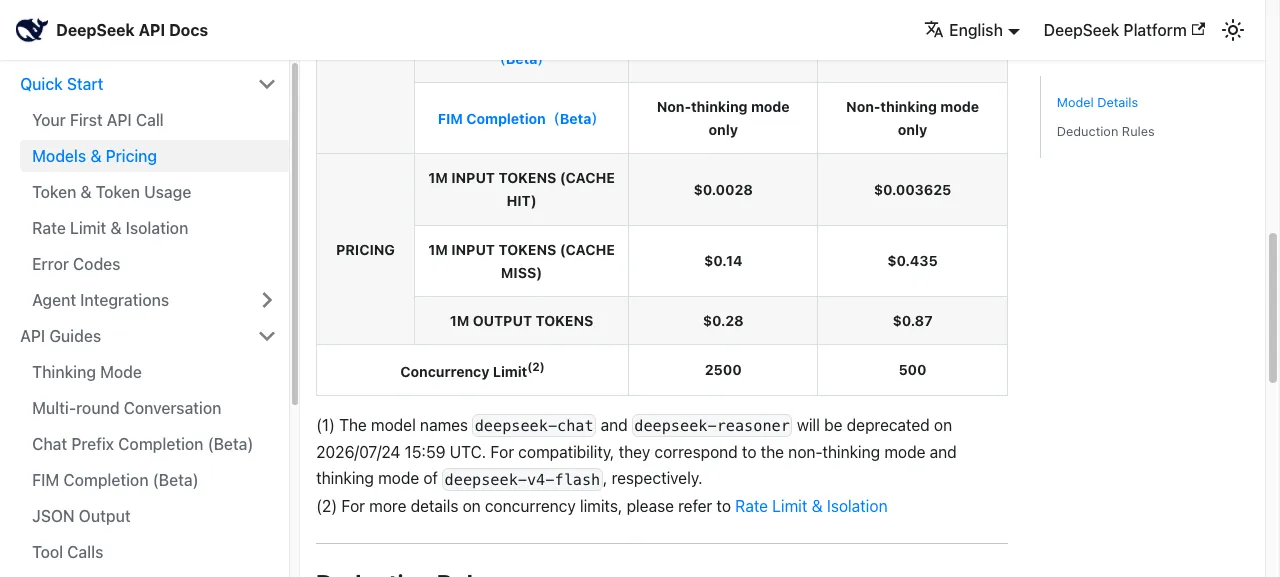
El precio de entrada es idéntico. La diferencia está en las otras dos filas.
El descuento de los aciertos de caché
El precio de DeepSeek por un acierto de caché es 50x inferior a su tarifa sin caché y 12.5x inferior al precio de Hy3 en caché a través de OpenRouter. Las dos tarifas no son estrictamente equivalentes: la de DeepSeek corresponde a su API propia, mientras que la de Hy3 depende de lo que cobren los proveedores subyacentes de OpenRouter por leer la caché. Pero son los precios que pagarías hoy. Para agentes, esta diferencia importa más que cualquier otra cifra de la página. En cada iteración, un agente reenvía un contexto creciente: prompt de sistema, definiciones de herramientas, contenido de archivos e historial de conversación. En una sesión de 40 turnos, la mayor parte de los tokens de entrada se repiten. Con un 90% de aciertos de caché, el coste efectivo de entrada de Flash baja de $0.14 a unos $0.017 por millón de tokens. En Hy3 cae a unos $0.045: sigue siendo barato, pero es casi 3x más caro, y la brecha aumenta cuanto más se alarga la sesión.
La salida es el punto débil de Hy3 en costes
Ambos son modelos de razonamiento, por lo que ambos facturan sus tokens de pensamiento como salida. Hy3 cobra $0.58 por salida, más del doble que los $0.28 de Flash; cada cadena de razonamiento extensa cuesta aproximadamente el doble a los usuarios de Hy3. Flash también cuenta con una alternativa que Hy3 no ofrece: cambiar al modo sin razonamiento para tareas mecánicas, como formateo, extracción o ediciones sencillas, y dejar de pagar por razonamiento innecesario. El análisis deepseek-v4-flash-vs-deepseek-v4-pro explica cómo funciona ese cambio de modo en la práctica.
La opción gratuita
Hy3 sí tiene una ventaja clara: OpenRouter ofrece una variante tencent/hy3:free sin coste. Tiene límites de tasa, pero es una opción real. Para probar el modelo antes de comprometerse, es mejor que Flash, que no dispone de un nivel de API gratuito. La preview de Hy3 también sigue disponible por $0.063/$0.21, por debajo del precio de la versión final, si te basta con el checkpoint de abril.
El coste oculto de tener menos contexto
Los 256K de contexto de Hy3 parecen más que suficientes hasta que ejecutas un agente sobre una base de código real. Un usuario de Reddit en r/hermesagent, que probó ambos modelos con el mismo entorno, describió Hy3 como «casi idéntico salvo por el tamaño de contexto, así que requiere compactación frecuente». La compactación no es una simple molestia: cada ciclo consume tokens de salida para resumir, elimina detalles e invalida la caché del prompt. Eso obliga a pagar la tarifa sin caché para reconstruirla.
La diferencia se vuelve estructural al hacer self-hosting. El diseño de atención dispersa de la arquitectura V4 —DeepSeek denomina al mecanismo lightning indexer— hace que su caché KV sea mucho más ligera que la atención convencional de Hy3. Son informes de usuarios individuales, no benchmarks, pero las cifras de el hilo de HN resultan contundentes: un participante que ejecutaba ambos en un par de DGX Sparks afirmó poder alojar 3M tokens de caché KV junto a DeepSeek V4 Flash, frente a unos 130K tokens con Hy3 cuantizado a FP4. Otro estimó que, cuando llama.cpp sea plenamente compatible con el indexer, el contexto completo de 1M de Flash debería requerir solo unos 6GB de RAM. Flash también ha demostrado tolerar cuantizaciones agresivas: varios usuarios del mismo hilo indican que mantiene la coherencia incluso a 2 bits, algo que todavía no se ha demostrado con Hy3.
Si tu caso de uso se mantiene holgadamente por debajo de 200K tokens, toda esta sección no te afecta y los cuatro puntos extra de inteligencia de Hy3 salen gratis. Si no, el coste del contexto se acumula: más compactación, más invalidación de caché y más memoria por sesión.
Lo que cuentan los desarrolladores tras el lanzamiento
La señal más útil no está en ninguna tabla de benchmarks, sino en las diferencias de comportamiento que describen quienes usan ambos modelos dentro de agentes de programación.
Un usuario del mismo hilo de Hacker News, que convirtió DeepSeek V4 Flash y Pro en sus modelos de uso diario tras cancelar su suscripción a Anthropic y después probó Hy3, resumió Flash así: es muy rápido, pero «a menudo construye un modelo mental completamente equivocado y se lanza por el camino erróneo», por lo que necesita correcciones frecuentes y compactación del historial. En su experiencia, Hy3 «no es tan rápido, pero por ahora parece mantenerse en el rumbo con mucha más fiabilidad» y se degrada menos al crecer el contexto. Otros participantes del hilo también destacaron que Hy3 ofrece mejores conocimientos generales y mejor prosa que Flash para su tamaño.
En Reddit, la percepción se inclina hacia Flash cuando se trata de salida de código sin más. Una comparativa con la misma tarea en r/LLMDevs clasificó «DeepSeek V4 Flash > Hy3 > GLM», aunque calificó a Hy3 de «prometedor para flujos de trabajo prácticos de programación». En r/opencode, se repite la idea de que Flash es «más que suficiente» para el trabajo habitual con agentes.
También hay que valorar el historial operativo. La demanda inicial de Hy3 superó la capacidad de servicio de Tencent: usuarios del hilo de HN informaron de límites de tasa intensos, y una persona que sigue las clasificaciones públicas de uso de OpenRouter señaló que el modelo cayó del primer puesto al 8.º–9.º en un mes, atribuyendo el descenso directamente a esas restricciones. DeepSeek, en cambio, documenta un límite de 2,500 solicitudes concurrentes para Flash en su API oficial, cinco veces más que para V4 Pro. Para tráfico de producción, uno de estos proveedores ha publicado garantías de capacidad y el otro arrastra un historial de congestión.
Qué modelo elegir según el caso
- Programación con agentes y sesiones por debajo de ~150K tokens: Hy3. Tiene mayor calidad de razonamiento, se mantiene mejor en la tarea y su precio de entrada base coincide con el de Flash. Se usan 150K en lugar de los 256K completos porque el contexto de un agente crece rápido y conviene dejar margen antes de que entre en juego la compactación.
- Sesiones largas, repositorios grandes o RAG sobre documentos extensos: Flash suele encajar mejor. Su ventana de 1M, junto al descuento de caché de 50x, lo sitúa en otra categoría de coste, y la sobrecarga de compactación de Hy3 termina erosionando su ventaja de inteligencia.
- APIs de producción con alto volumen: Flash. Ofrece 2,500 solicitudes concurrentes documentadas, un historial de servicio más estable y un modo sin razonamiento para llamadas masivas económicas.
- Redacción, investigación y tareas de conocimiento general: Hy3. Tanto los informes de la comunidad como las evaluaciones de conocimiento de AA lo favorecen en este tamaño.
- Despliegue local: Flash para la mayoría de equipos. Hay mucha más evidencia práctica sobre la eficiencia de su caché KV y su resistencia a la cuantización; las recomendaciones de servicio de Tencent para Hy3, citadas en el hilo de lanzamiento, hablan de ocho GPU de clase H20.
- Evaluación antes de decidir: el nivel gratuito de Hy3 en OpenRouter no cuesta nada. Pruébalo con tus propias tareas antes de creer cualquier tabla de benchmarks, incluida esta.
Dónde ejecutar cada modelo
DeepSeek V4 Flash: la API oficial ofrece endpoints compatibles con el formato de OpenAI (api.deepseek.com) y con el de Anthropic (api.deepseek.com/anthropic), así que puede integrarse en herramientas compatibles con Claude cambiando la URL base. Atención a la fecha de migración indicada en la misma página de precios: los nombres de modelo antiguos deepseek-chat y deepseek-reasoner quedan obsoletos el 24 de julio de 2026 y pasan a corresponder, respectivamente, a los modos sin razonamiento y con razonamiento de Flash. OpenRouter lo ofrece por $0.09/$0.18, ligeramente por debajo de la tarifa oficial, aunque sin el precio por acierto de caché de la API oficial.
Hy3: Tencent Cloud TokenHub es la vía oficial. OpenRouter ofrece la versión final, el checkpoint preview más económico y el nivel gratuito. SiliconFlow ha tenido promociones de lanzamiento. El despliegue propio es posible bajo Apache 2.0 si cuentas con las GPU necesarias. La guía de configuración de la API de Hy3 explica cómo obtener una clave y realizar la primera llamada.
Preguntas frecuentes
¿Hy3 es gratis?
En parte. OpenRouter ofrece un nivel tencent/hy3:free gratuito con límites de tasa, y los productos de consumo de Tencent, Yuanbao e ima, utilizan Hy3 sin coste. El acceso de producción mediante TokenHub o el nivel de pago de OpenRouter se factura por token.
¿Hy3 es lo mismo que Tencent Hunyuan?
Sí. Hy3 es la tercera generación de la línea de modelos Hunyuan de Tencent, que ahora la compañía comercializa como «Tencent Hy». La preview se lanzó el 23 de abril de 2026 y la versión final el 6 de julio de 2026.
¿Qué es mejor para programar: Hy3 o DeepSeek V4 Flash?
Los resultados de la comunidad varían según el tipo de tarea. Las comparativas de Reddit con la misma tarea situaron la salida bruta de Flash por encima de Hy3, mientras que quienes usan agentes en sesiones largas dicen que Hy3 se mantiene mejor en el rumbo. Las tareas cortas y bien delimitadas favorecen la velocidad de Flash; para sesiones agénticas de varias horas, donde desviarse tiene un coste alto, Hy3 puede ser preferible siempre que el contexto se mantenga holgadamente dentro de su ventana de 256K.
¿Puedo ejecutar DeepSeek V4 Flash en local?
Sí, y es más viable que con Hy3. Los pesos tienen licencia MIT, la caché KV de su arquitectura es inusualmente ligera y los usuarios informan de calidad utilizable incluso con cuantización a 2 bits en equipos con ~96GB de RAM.
¿Por qué resulta tan confusa la comparativa de precios hy3 vs deepseek v4 flash?
Porque hay al menos cuatro listas de precios: Tencent TokenHub, las tarifas de OpenRouter para Hy3 final y preview, y la API oficial de DeepSeek con su precio específico para aciertos de caché. Hay que comparar el precio efectivo según tu propio patrón de tráfico: la entrada en caché domina las cargas de trabajo con agentes, y ahí es difícil competir con la tarifa de $0.0028 de DeepSeek.
Conclusión
Hy3 es el modelo más capaz según la evidencia independiente disponible; DeepSeek V4 Flash es el mejor servicio. Para cargas de trabajo de API en producción, Flash es mi opción predeterminada: su economía de caché, ventana de contexto y concurrencia publicada se combinan de una forma que una ventaja de cuatro puntos en benchmarks no compensa. Recurre a Hy3 cuando la calidad de razonamiento por prompt importe más que la escala, y prueba antes su nivel gratuito, ya que no cuesta nada contrastarlo con tus propias tareas.