 AIREITER
Google lanzó Gemini 3.7 Flash el 13 de agosto de 2026 como su modelo de la gama Flash más potente hasta la fecha para agentes de código y uso de herramientas en varios pasos. La cifra que más llama la atención es su 65.3% en DeepSWE v1.1, frente al 49.0% de 3.6 Flash, con una tarifa introductoria de $0.75/M de tokens de entrada y $3.75/M de salida. Es exactamente la mitad de las tarifas estándar de 3.6 Flash. La contrapartida es importante: según los informes, el precio se duplicará a $1.50/$7.50 en enero de 2027, así que el periodo para evaluarlo a la tarifa reducida ronda los cuatro meses.
Precios de la API: $0.75/$3.75 hasta diciembre de 2026
Gemini 3.7 Flash debuta a $0.75 por millón de tokens de entrada y $3.75 por millón de tokens de salida, según el anuncio de lanzamiento de Google DeepMind, corroborado por informes de la comunidad y resultados indexados de búsqueda. Como referencia, la tarifa estándar de Gemini 3.6 Flash es de $1.50/M de entrada y $7.50/M de salida (AgentPedia). La tarifa inicial de 3.7 Flash coincide con la modalidad Batch/Flex de 3.6 Flash, pero se aplica al rendimiento estándar.
Los informes de la comunidad señalan un detalle clave de la letra pequeña: la tarifa introductoria estará vigente hasta el 31 de diciembre de 2026 y, después, los precios volverán a $1.50/M de entrada y $7.50/M de salida. Un usuario de Reddit indicó que «la letra pequeña del precio mostrado hace que el precio se duplique tras cuatro meses» (r/GeminiAI).
| Modalidad de precios | Entrada ($/M tokens) | Salida ($/M tokens) | Notas |
|---|---|---|---|
| 3.7 Flash introductorio (ago.–dic. 2026) | $0.75 | $3.75 | Según informes de la comunidad; se duplica en ene. de 2027 |
| 3.7 Flash estándar (desde ene. de 2027) | $1.50 | $7.50 | Igual que 3.6 Flash estándar |
| 3.6 Flash estándar | $1.50 | $7.50 | Precio GA actual |
| 3.6 Flash Batch/Flex | $0.75 | $3.75 | Modalidad de menor rendimiento |
| 3.5 Flash-Lite estándar | $0.30 | $2.50 | La gama Gemini Flash más económica |
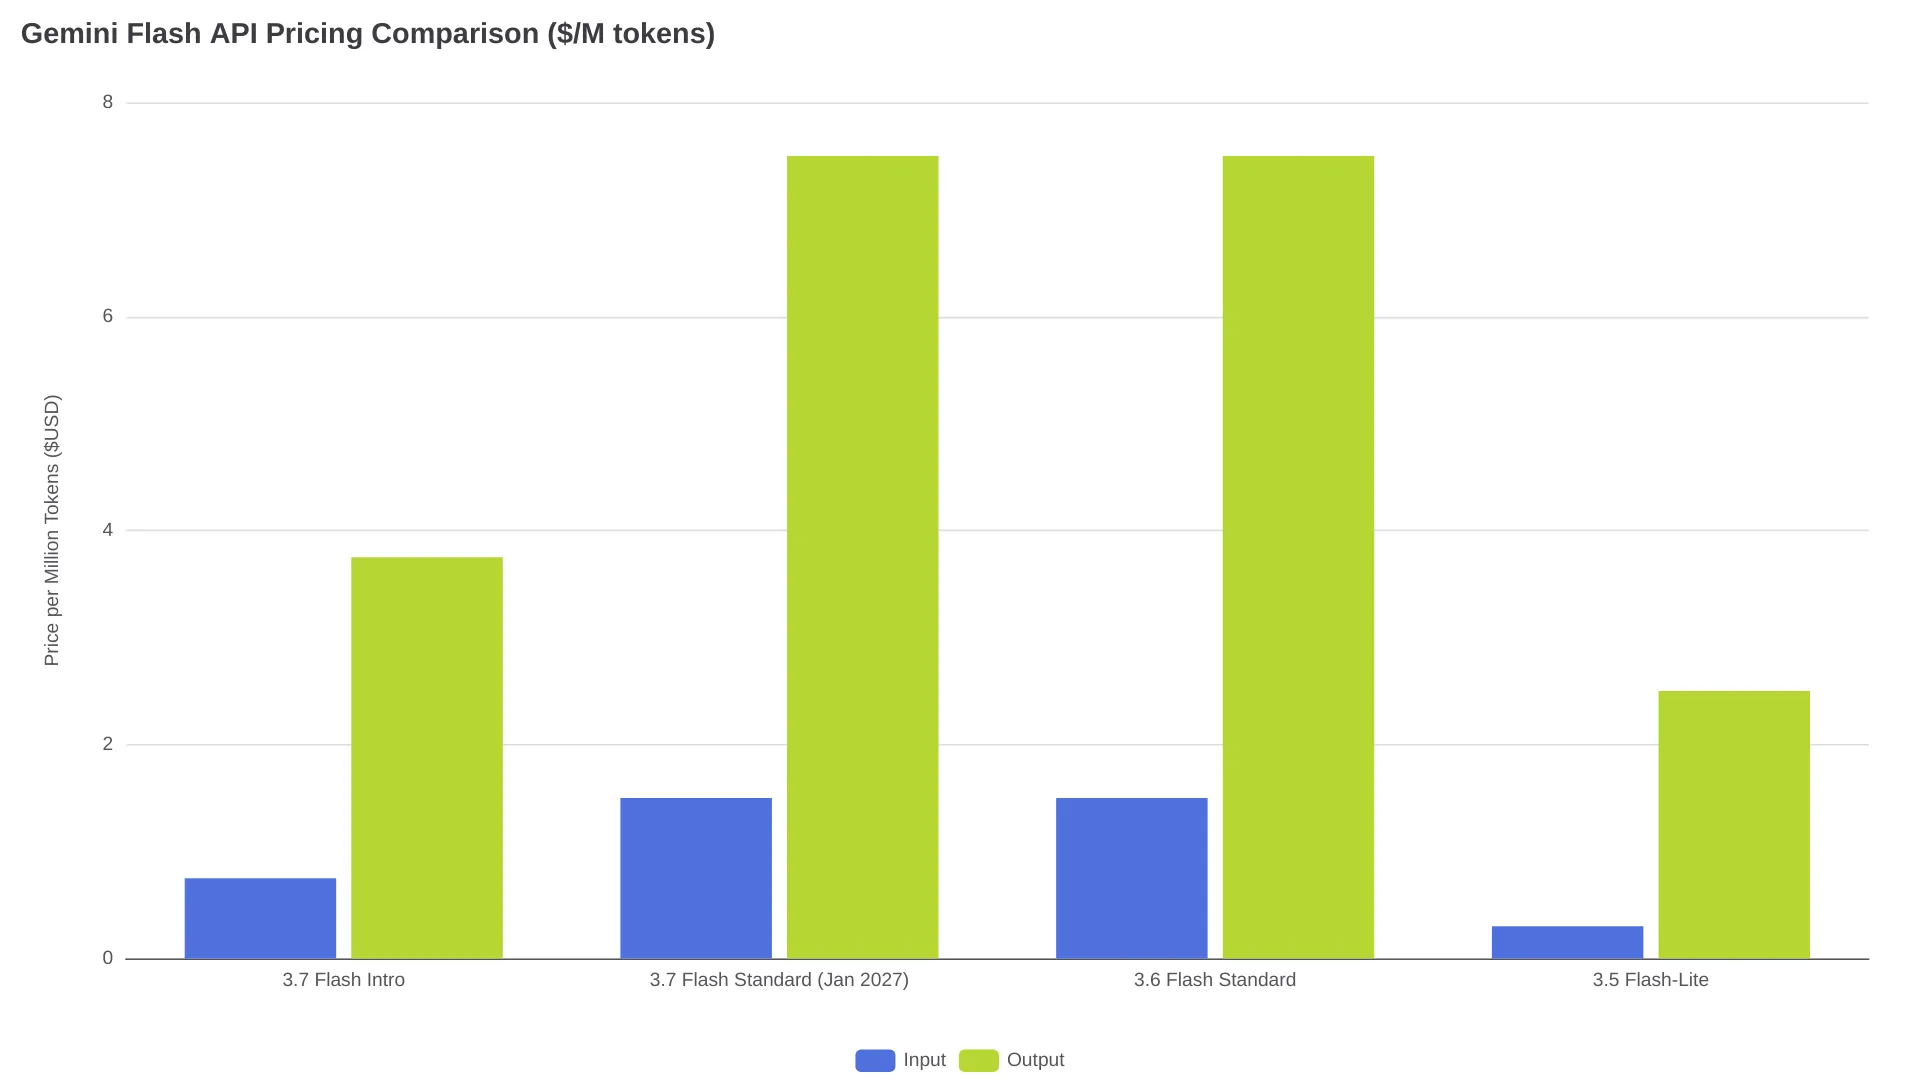
El precio de salida incluye los tokens de razonamiento. El almacenamiento en caché de contexto añade $0.15/M de tokens en la modalidad estándar, según las tarifas publicadas de 3.6 Flash a través de AgentPedia. La conexión con Google Search y Maps tiene cargos independientes. El modelo conserva la ventana de contexto de 1M de tokens y el máximo de salida de 64K de 3.6 Flash, por lo que no hay cambios en los límites de contexto que puedan romper llamadas API existentes.
Qué mejora realmente en los benchmarks
Los benchmarks comunicados por Google concentran las mejoras en ingeniería de software, programación y procesamiento de documentos. Las cifras siguientes proceden del anuncio de lanzamiento de Google, difundido en publicaciones de la comunidad el 13 de agosto de 2026.
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Diferencia |
|---|---|---|---|
| DeepSWE v1.1 | 65.3% | 49.0% | +16.3 puntos |
| FrontierCode 1.1 Main | 43.6% | 34.4% | +9.2 puntos |
| WebDev Arena (Elo) | 1,588 | 1,538 | +50 Elo |
| Procesamiento de documentos GDP.pdf | 34.0% | 22.0% | +12.0 puntos |
| AutomationBench | 30.4% | ~17% | +13 puntos |
| Recuperación con contexto largo | 97% | — | — |
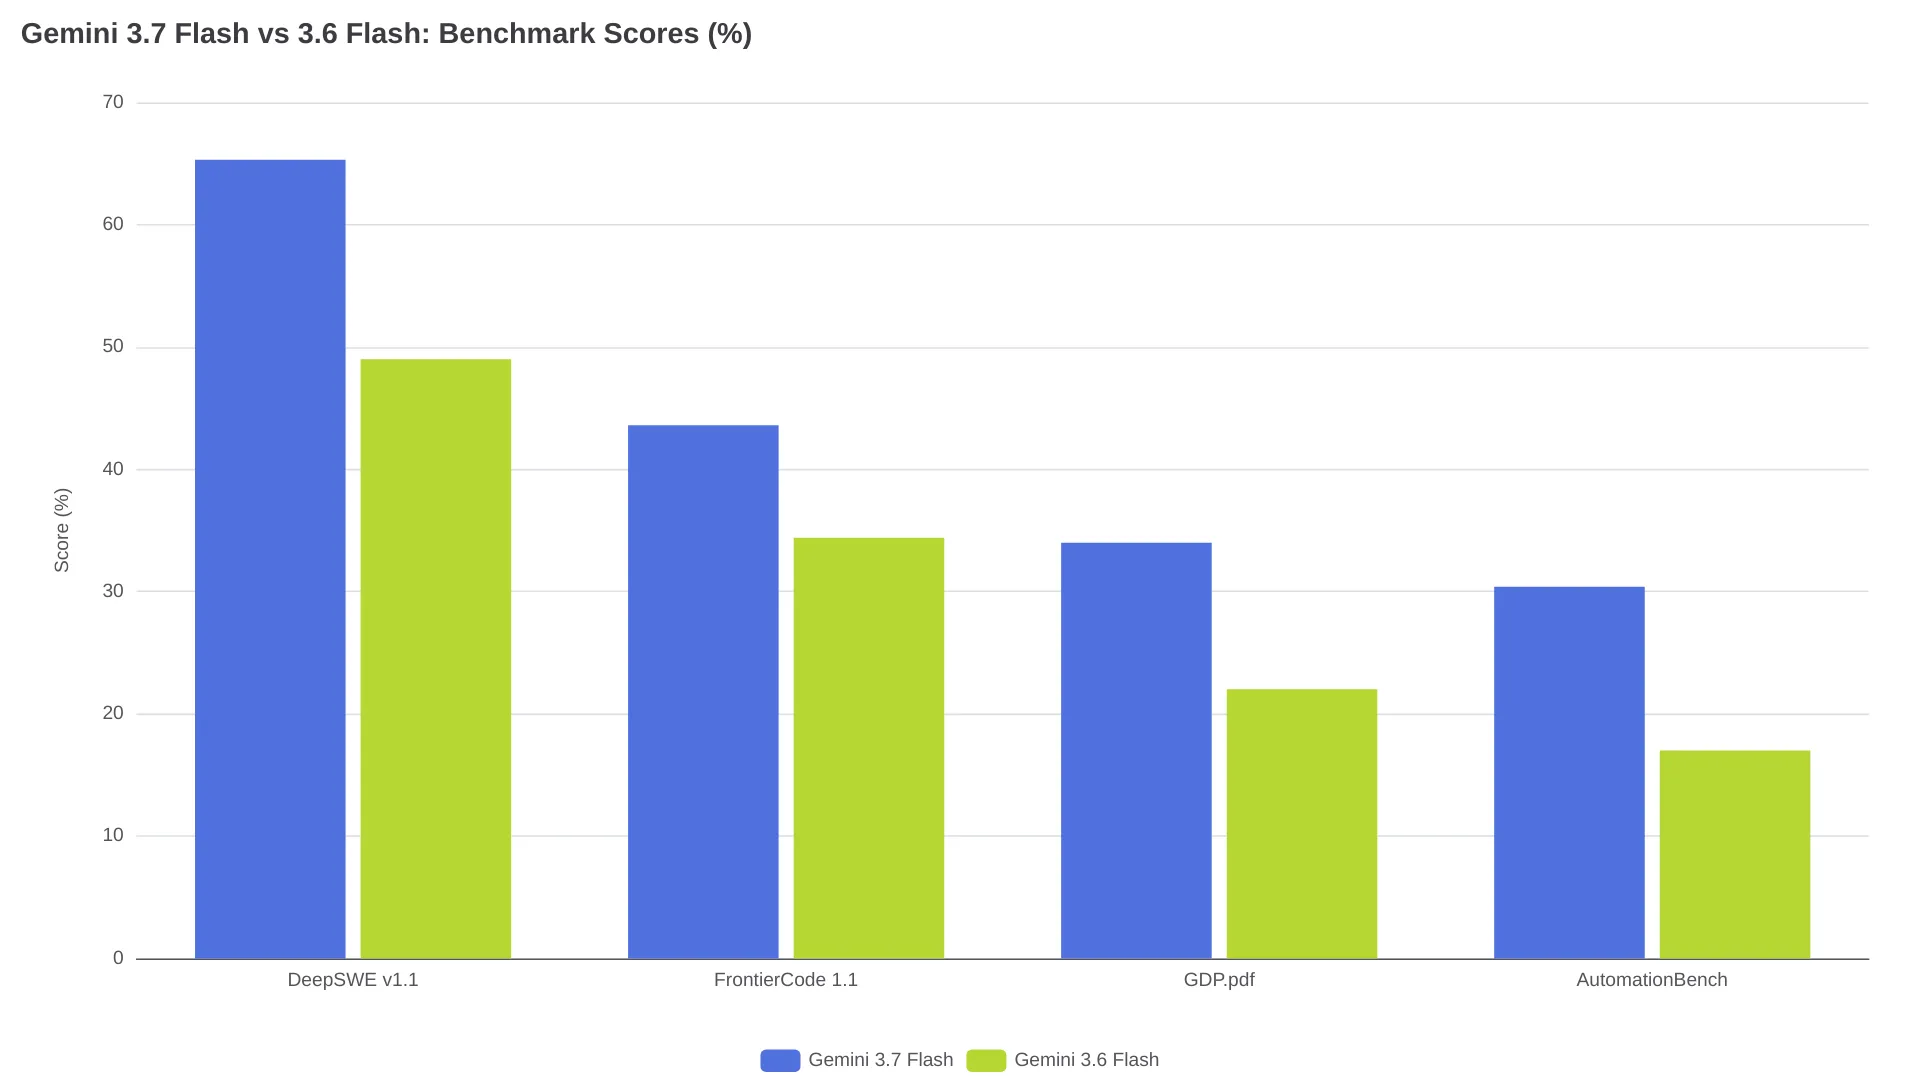
El salto de DeepSWE del 49% al 65.3%, un +33% relativo, es el resultado más destacado. DeepSWE evalúa ingeniería de software a nivel de repositorio: ediciones en varios archivos, ejecución de pruebas y navegación por bases de código. Aun así, la comunidad de Reddit está dividida sobre si estas cifras se sostienen en producción. Un usuario escribió: «Da por hecho que está optimizado para benchmarks hasta que se demuestre lo contrario» (r/GeminiAI). Otros apuntaron que 3.6 Flash usó razonamiento high en la comparación, mientras algunos modelos rivales utilizaron medium, algo que infla las puntuaciones. El 97% en recuperación con contexto largo sí despertó interés real para flujos de trabajo de programación que requieren localizar código relevante en una base de código grande.
Coste frente a otros modelos para programar
Los primeros usuarios de Reddit compararon enseguida la relación precio-rendimiento de 3.7 Flash con alternativas más baratas. El panorama no es concluyente: 3.7 Flash obtiene buenas puntuaciones, pero cuesta considerablemente más por tarea que los modelos económicos orientados a código.
Un comentarista del hilo sobre benchmarks calculó que Gemini 3.7 Flash cuesta aproximadamente 8x más que GPT-5.6 Luna según el coste por tarea de Artificial Analysis, pese a que Luna logra puntuaciones de benchmark casi idénticas. Otro usuario afirmó que Gemini 3.7 Flash era antes aproximadamente 13x más caro que DeepSeek V4 Flash, aunque el precio de DeepSeek ha subido desde entonces. El mismo comentarista lo resumió sin rodeos: Gemini 3.7 Flash cuesta «más de un 300% adicional» frente a Luna para resultados «casi iguales» (r/GeminiAI).
El argumento contrario es que, según los informes, Luna alucina más y el razonamiento de DeepSeek V4 Flash «comete muchos errores», aunque se trata de evidencia anecdótica.
Donde 3.7 Flash recibe elogios es en velocidad. Los usuarios informan de que la mayoría de las respuestas llegan en 3 a 6 segundos; la respuesta más larga observada, una prueba de escritura creativa, tardó cerca de un minuto. Varios comentaristas lo calificaron de «increíblemente rápido».
Especificaciones, disponibilidad y acceso a la API
Gemini 3.7 Flash mantiene los mismos límites de contexto y el mismo conjunto de funciones que 3.6 Flash, según las especificaciones mencionadas en debates de la comunidad y la documentación de 3.6 Flash.
| Especificación | Valor |
|---|---|
| Ventana de contexto | 1,048,576 tokens (1M) |
| Salida máxima | 65,536 tokens (64K) |
| Niveles de razonamiento | Low, Medium, High |
| Modalidades | Texto, imágenes, vídeo, audio, PDF (entrada); texto (salida) |
| Fecha de corte del conocimiento | Marzo de 2026 (3.6 Flash; fecha de corte de 3.7 Flash sin confirmar) |
| Precio de entrada en caché | $0.15/M de tokens (estándar, inferido de 3.6 Flash) |
Dónde acceder:
- Gemini API / Google AI Studio — acceso para desarrolladores
- Gemini app — despliegue para consumidores
- Gemini Spark — disponible para suscriptores de Google AI Pro y Google AI Ultra
- Vertex AI — se espera que siga el patrón de disponibilidad de 3.6 Flash
El ID de modelo de API previsto es gemini-3.7-flash, siguiendo la convención de nombres de Google para 3.6 Flash. Confirma la cadena exacta en la documentación de Google AI for Developers antes de desplegarlo y fíjala en lugar de depender de alias como gemini-flash-latest.
¿Conviene migrar desde 3.6 Flash?
La decisión depende del tipo de carga de trabajo y de cuánto afecte a tu caso la subida de precios de enero de 2027.
Migra si tu aplicación ejecuta agentes de programación, cadenas de uso de herramientas en varios pasos o procesamiento intensivo de documentos. El salto de DeepSWE de 49% a 65.3% es suficiente para cambiar cuántos bucles de agente se resuelven al primer intento, y el precio introductorio reducido permite evaluarlo con menor coste. Los equipos que ya usan 3.6 Flash pueden intercambiar el ID del modelo tras una feature flag sin reescribir sus supuestos sobre la ventana de contexto.
Espera si tu carga de trabajo consiste en clasificación, enrutamiento o extracción de gran volumen, casos en los que Flash-Lite ya cumple por $0.30/$2.50. El precio introductorio de 3.7 Flash sigue siendo 2.5x la tarifa de entrada de Flash-Lite, y la duplicación de enero amplía esa diferencia.
Planifica teniendo en cuenta el cambio de precio. Presupuesta $1.50/$7.50 a partir de enero de 2027, no la tarifa introductoria actual. Si tu economía unitaria solo funciona con $0.75/$3.75, el modelo será 2x más caro en cuatro meses.
Preguntas frecuentes
¿El precio de $0.75/$3.75 de Gemini 3.7 Flash es permanente?
No. Los informes de la comunidad indican que es una tarifa introductoria válida hasta el 31 de diciembre de 2026. A partir de enero de 2027, los precios supuestamente se duplicarán a $1.50/M de entrada y $7.50/M de salida, igualando las tarifas estándar de 3.6 Flash.
¿Gemini 3.7 Flash está disponible en Vertex AI?
La disponibilidad en Vertex AI no se ha confirmado de forma independiente en el lanzamiento. Gemini 3.6 Flash estuvo disponible a través de Vertex AI en GA, por lo que se espera que 3.7 Flash siga el mismo camino. Consulta la consola de Google Cloud para ver la lista de modelos actual.
¿Cómo se compara 3.7 Flash con Gemini 3.1 Pro?
Usuarios de Reddit señalan que 3.7 Flash compite con modelos de gama Pro o los supera en benchmarks concretos de agentes y programación, especialmente en análisis documental agéntico. Para bucles puros de agentes de código al precio introductorio, 3.7 Flash ofrece una mejor relación coste-rendimiento; para razonamiento y planificación complejos, Pro sigue siendo la opción más potente.
¿Los tokens de razonamiento se facturan por separado?
No. Los tokens de razonamiento se facturan como tokens de salida a la tarifa estándar de salida ($3.75/M durante el periodo introductorio). Usar razonamiento high incrementa proporcionalmente los costes de salida, así que conviene usar medium o low en cargas de trabajo de gran volumen donde el razonamiento adicional no sea necesario.