 AIREITER
El 29 de julio de 2026 pusimos a Claude Opus 5 y a GPT-5.6 Sol, Terra y Luna frente a las mismas cuatro tareas. El resultado fue un empate total: 16 respuestas, 16 aciertos. Con pruebas pequeñas como estas, la precisión no sirve para inclinar la balanza.
Las diferencias aparecen en dos variables que sí afectan a la factura. Opus 5 consumió 1.642 tokens de salida frente a los 480 de Sol y, al superar los 272.000 tokens de entrada, las solicitudes a GPT-5.6 pasan a una tarifa superior, mientras que Claude Opus 5 mantiene una tarifa plana en toda su ventana de 1M. En una solicitud de 200K tokens de entrada y 20K de salida, ambos modelos insignia quedan a menos de un 7% en precio de lista; la diferencia crece con el volumen de salida y tras cruzar la barrera de 272K. La elección, por tanto, depende de la forma de la petición y del comportamiento del modelo.
Cuatro modelos, cuatro pruebas idénticas
Enviamos a cada modelo exactamente el mismo prompt de usuario para resolver cuatro comprobaciones con respuestas verificables de forma mecánica: corregir una función median con errores en Python, contar letras en una cadena fija, calcular el ángulo de 7,5 grados que marca un reloj a las 3:15 y refactorizar una función JavaScript deliberadamente desordenada sin alterar su comportamiento. Las respuestas de código se validaron ejecutándolas con casos límite, no a simple vista.
Los cuatro superaron las cuatro pruebas. Todas las correcciones de Python trataron correctamente las listas de longitud par; los cuatro respondieron 9 y 7,5 cuando esas eran las soluciones; y las cuatro refactorizaciones pasaron una comparación de comportamiento que incluía campos falsy y filtros de categoría null.
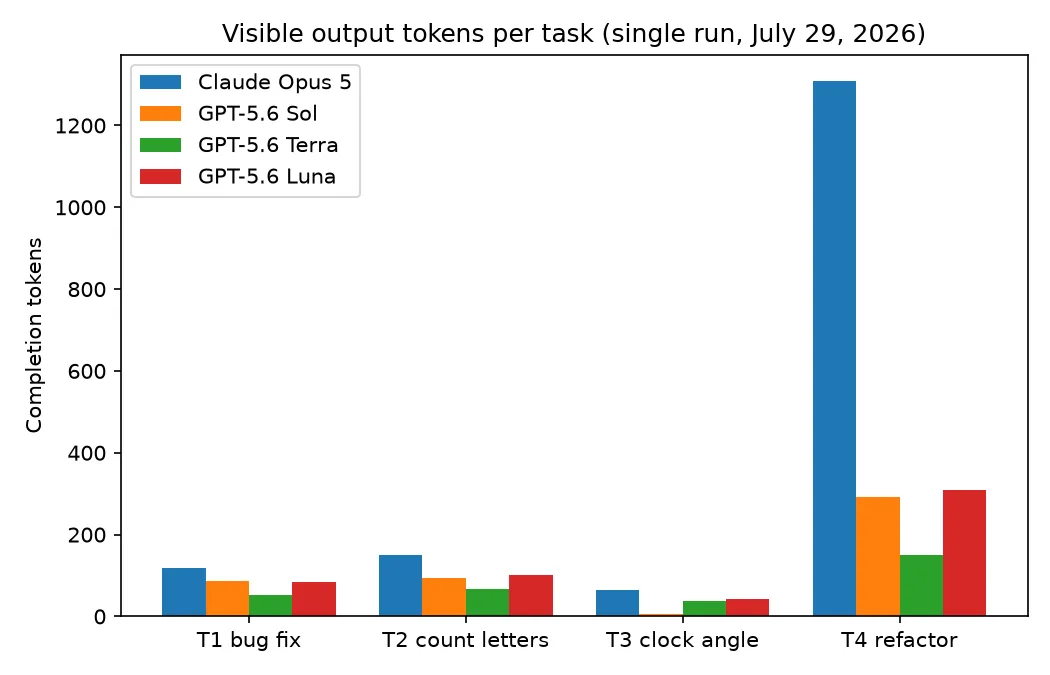
Antes de citar estas cifras, conviene tener presentes tres matices. Hay una sola ejecución por modelo y tarea: es una prueba de humo, no un benchmark. Las llamadas pasaron por una pasarela que inyecta su propio prompt de sistema, de modo que los tokens de entrada variaron entre 35 y 4.415 según la solicitud y los descartamos por completo. Además, ambos proveedores facturan como salida los tokens de razonamiento ocultos, así que aquí «tokens de salida» significa lo que se cobra, no lo que se lee.
Del empate sí quedó una diferencia cualitativa: Opus 5 generó la mejor refactorización de los cuatro. Convirtió los dos bucles originales en una única pasada, extrajo el multiplicador 1,2 a una constante con nombre y dejó un comentario explicando que mantenía deliberadamente la igualdad débil para conservar el comportamiento. Sol, Terra y Luna dieron soluciones correctas, pero más literales y con dos bucles.
La diferencia está en tokens y tiempo, no en aciertos
Con la corrección empatada en las 16 ejecuciones, la comparación útil es cuánto costó cada respuesta. Opus 5 completó las cuatro tareas en 32,4 segundos y facturó 1.642 tokens de finalización. Sol tardó 19,7 segundos y usó 480 tokens; Terra, 11,7 segundos y 308; Luna, 15,3 segundos y 537.
| Ejecución única, 29 de julio de 2026 | Correctas | Tokens de salida | Tiempo total | Coste solo de salida |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1.642 | 32,4 s | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19,7 s | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11,7 s | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15,3 s | $0.0032 |
La brecha no está en la extensión de las respuestas, sino en el volumen de razonamiento. La refactorización de Opus 5 facturó 1.308 tokens para una respuesta final de 492 bytes, y empleó 64 tokens para responder «7,5», donde Sol utilizó 7. La documentación de Anthropic indica que Opus 5 usa por defecto un esfuerzo alto en la API, así que parte de la diferencia procede de esa configuración predeterminada y no de una característica inamovible; medimos el comportamiento por defecto, no el mínimo posible.
Los datos de la comunidad dibujan un patrón parecido. Un gráfico publicado en r/Anthropic, el primer resultado de Google para esta consulta cuando lo comprobamos el 29 de julio, sitúa a ambos prácticamente empatados en puntuaciones de programación, aunque Opus tarda más y consume bastantes más tokens. Un usuario de r/ClaudeCode lo expresó con menos diplomacia:
GPT 5.6 Sol se pone directamente a hacer lo que le pides. Opus 5 escribe «Guerra y paz» en 12 volúmenes y después se pone a hacer lo que le pides.
Sin embargo, los ajustes de esfuerzo pueden cambiar por completo la ecuación económica. Un comentarista de Hacker News que analizaba datos de Artificial Analysis señaló que Opus 5 con esfuerzo alto rondaba los $1.06 por ejecución del índice de inteligencia, frente a $1.04 de Sol en máximo: casi empate cuando ambos modelos razonan a fondo.
GPT-5.6 no es un solo modelo: Sol, Terra y Luna
GPT-5.6 agrupa tres SKU de OpenAI. Además, la cadena sin sufijo gpt-5.6 está documentada como alias de gpt-5.6-sol, el más caro de los tres. Una configuración que indique gpt-5.6 se factura a la tarifa más alta de la familia, un detalle que conviene revisar antes de comparar costes.
La referencia de modelos de OpenAI define Sol como su «modelo de frontera para trabajo profesional complejo», Terra como la opción que «equilibra inteligencia y coste», y Luna como la variante «optimizada para cargas de trabajo sensibles al coste». Los tres comparten una ventana de contexto de 1,05M tokens, una salida máxima de 128K, un corte de conocimiento del 16 de febrero de 2026 y seis niveles seleccionables de razonamiento, de none a max.
| Especificación, verificada el 29 de julio de 2026 | Claude Opus 5 | GPT-5.6 (los tres) |
|---|---|---|
| Ventana de contexto | 1M tokens | 1,05M tokens |
| Salida máxima | 128K (300K mediante Batch API beta) | 128K |
| Corte de conocimiento fiable | Mayo de 2026 | 16 de febrero de 2026 |
| Control de razonamiento | Pensamiento adaptativo; effort usa high por defecto | none / low / medium / high / xhigh / max |
| ID de API | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
Dos de estas filas pesan de verdad en la decisión. El corte de conocimiento de Opus 5, en mayo de 2026, es tres meses más reciente que el de toda la familia GPT-5.6, algo relevante para referencias a lanzamientos de la primavera de 2026. Y los controles de razonamiento no solo difieren en número, sino en enfoque: GPT-5.6 permite desactivar por completo el razonamiento con none, mientras que Opus 5 administra su presupuesto de pensamiento de forma adaptativa y expone niveles de esfuerzo adicionales.
Precios: tarifa plana hasta 1M frente al salto de 272K
Ambos proveedores publican tarifas claras por token y, por debajo de 272K tokens de entrada, están muy próximos: $5 por millón de tokens de entrada en ambos modelos insignia; $25 por millón de salida para Opus 5 frente a $30 para Sol; la misma tarifa de $0.50 para entrada en caché; y un 50% de descuento por lotes en los dos casos. Con esas tarifas, una petición de 200K tokens de entrada y 20K de salida cuesta $1.50 en Opus 5 y $1.60 en Sol.
| Por 1M tokens, precio de lista el 29 de julio de 2026 | Entrada | Entrada en caché | Salida | Batch |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
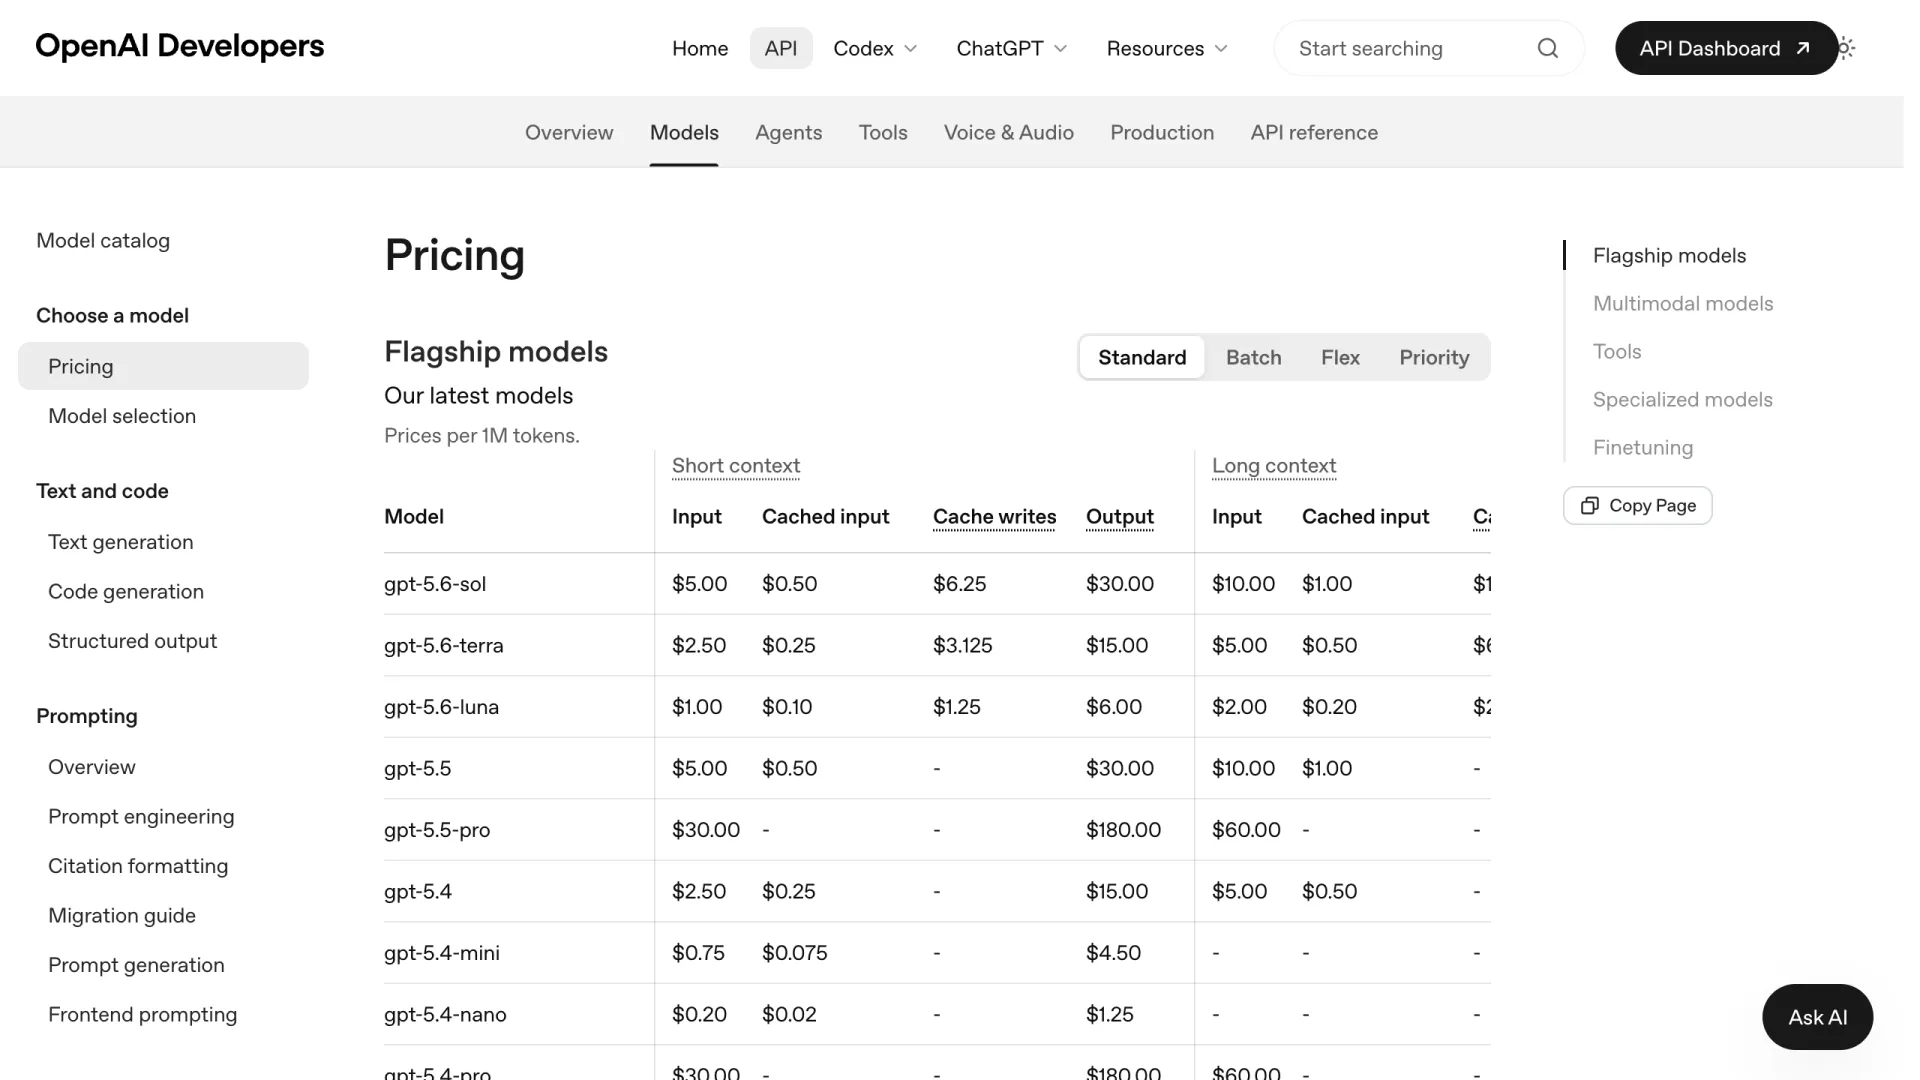
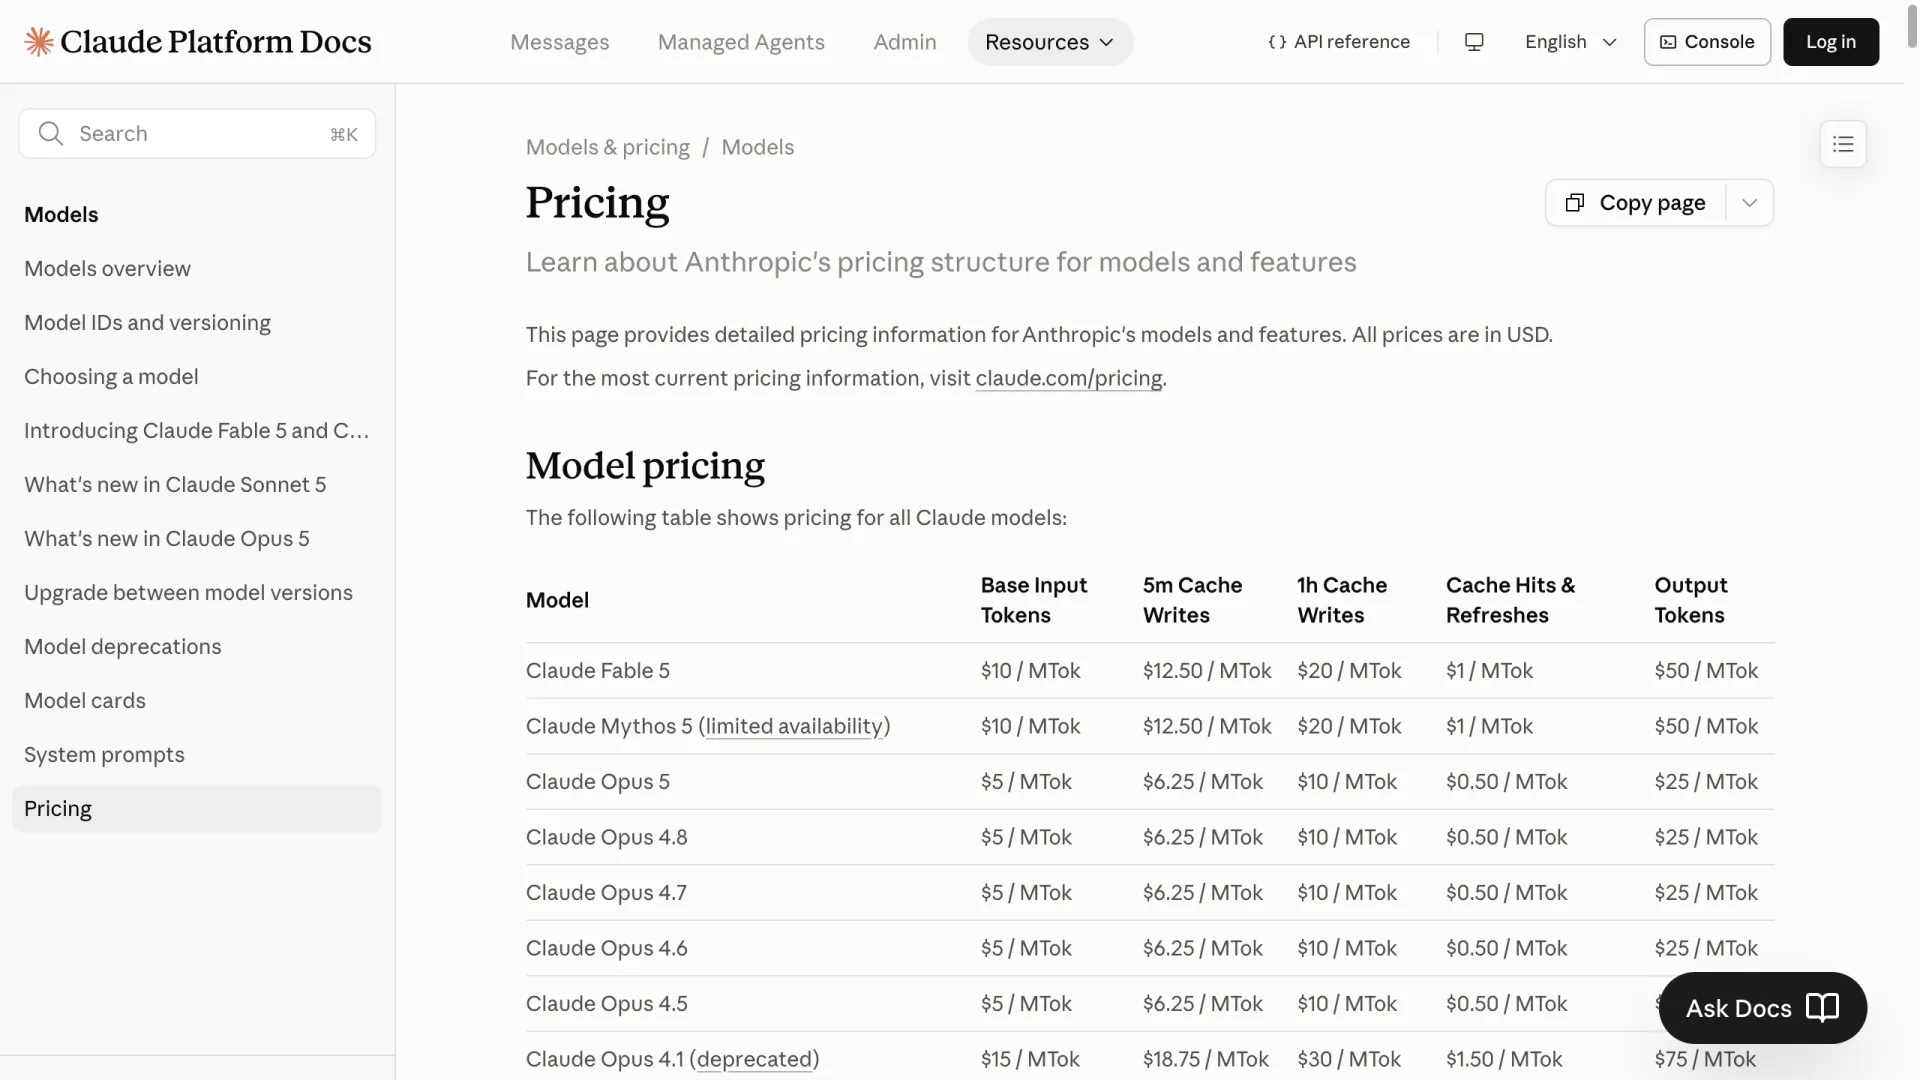
La diferencia estructural aparece al llegar a 272K tokens de entrada. La página de precios de OpenAI separa todas las tarifas de GPT-5.6 entre contexto corto y largo: a partir de 272K de entrada, la entrada se cobra al doble y la salida a 1,5 veces, llevando a Sol a $10 y $45. La documentación de precios de Anthropic describe el diseño contrario en una frase: «Una solicitud de 900k tokens se factura a la misma tarifa por token que una de 9k tokens».
Traducido a dólares y manteniendo 20K tokens de salida en cada caso: una solicitud de 300K tokens de entrada cuesta $2.00 con Opus 5 y $3.90 con Sol. En 500K, son $3.00 frente a $5.90; en 900K, $5.00 frente a $9.90. Por encima del salto, Opus 5 cuesta aproximadamente la mitad que Sol para solicitudes con la misma estructura.
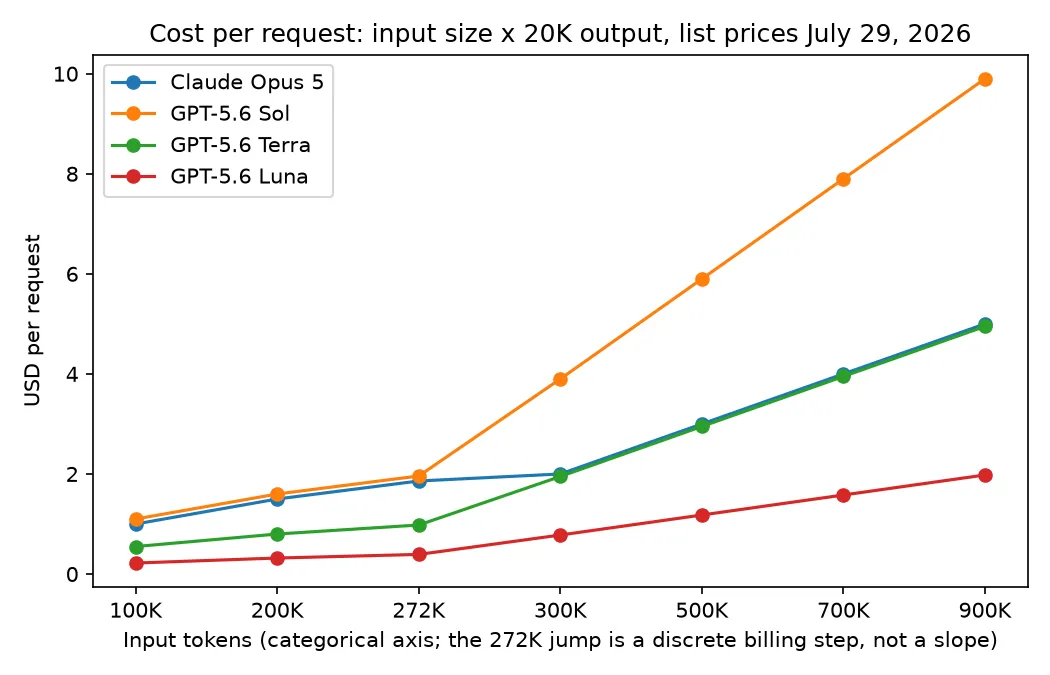
El gráfico esconde una sorpresa que impide dar una victoria rotunda a Anthropic. Por encima de 272K, la tarifa de entrada duplicada de Terra es de $5, igual que la de Opus 5, y su tarifa de salida para contexto largo, de $22.50, mejora los $25 de Opus 5. Con 20K tokens de salida, Terra cuesta cinco centavos menos por solicitud de forma constante en 300K, 500K, 700K y 900K. Esos cinco centavos escalan con el volumen de salida, no con el tamaño de entrada: la diferencia es de $2.50 por millón de tokens de salida.
Tres notas al pie para planificar presupuesto. Anthropic ofrece para Opus 5 un modo rápido en vista previa de investigación por $10 de entrada y $50 de salida; OpenAI vende un nivel prioritario a 2 veces las tarifas estándar, solo para contexto corto. La residencia de datos en regiones de EE. UU. añade alrededor de un 10% en ambos proveedores. Además, el tokenizador actual de Claude produce aproximadamente un 30% más de tokens que los modelos anteriores a 4.7 para el mismo texto, según la propia nota de Anthropic; por eso, la comprobación final honesta es pasar un prompt representativo por ambos tokenizadores antes de multiplicar tarifas.
Qué modelo elegir según la carga de trabajo
Al haber empate en corrección, el enrutamiento depende de la forma de la solicitud y del estilo de trabajo. Desarrolladores de r/ClaudeCode usan Sol con esfuerzo alto como revisor y agente de QA por su exhaustividad y su buen desempeño con navegador; otros, en r/codex, envían la mayor parte del trabajo a las capas GPT más baratas con razonamiento medio y reportan ahí la mejor relación coste-rendimiento.
| Forma de la solicitud | Modelo recomendado | Motivo |
|---|---|---|
| Menos de 272K de entrada, bucles de agentes con mucha salida | Claude Opus 5 | $25 frente a $30 en salida; mejor criterio de refactorización en nuestra prueba |
| Menos de 272K, prioridad en latencia o alto volumen | GPT-5.6 Terra | El modelo aprobado más rápido y barato de los que probamos |
| Más de 272K de entrada | Claude Opus 5 o Terra | Las tarifas de contexto largo de Sol se duplican; Terra queda cinco centavos por debajo de Opus 5 |
| Revisión, QA y comprobaciones guiadas por navegador | GPT-5.6 Sol | Seis niveles de esfuerzo para ajustar la profundidad de la revisión; valídalo con tu propio conjunto de QA |
| Clasificación y extracción desechables | GPT-5.6 Luna | $1/$6 y superó las cuatro pruebas |
No todos creen que Sol merezca el puesto de QA: un hilo de r/codex lo considera una regresión respecto a GPT-5.5, aunque atribuye a Opus 5 más tareas completadas por plan. Probar los valores predeterminados cuesta poco: los cuatro modelos están en el catálogo de AIReiter (Opus 5, Sol), así que puedes repetir tus propias tareas en paralelo.
La cifra que conviene recordar de toda esta comparación es 272.000 tokens de entrada. Por debajo, decide según comportamiento, latencia y la diferencia de $5 en la tarifa de salida. Por encima, el argumento de precio favorece a Anthropic frente a Sol, con Terra cinco centavos por debajo de Opus 5 y Luna muy por debajo de ambos.
Preguntas frecuentes
¿gpt-5.6 es el mismo modelo que GPT-5.6 Sol?
Sí. La referencia de modelos de OpenAI incluye la cadena sin sufijo gpt-5.6 como un alias que resuelve a gpt-5.6-sol, así que se factura a las tarifas de Sol: $5 de entrada y $30 de salida por millón de tokens por debajo de 272K tokens de entrada; $10 y $45 por encima.
¿Claude Opus 5 cobra más por las solicitudes de contexto largo?
No. Anthropic factura toda la ventana de 1M con tarifas estándar en la API regular e indica que una solicitud de 900K tokens cuesta lo mismo por token que una de 9K. Solo el modo rápido opcional aplica un recargo: $10 de entrada y $50 de salida.
¿Qué es más barato, Claude Opus 5 o GPT-5.6?
Depende de la capa. Por debajo de 272K tokens de entrada, Opus 5 rebaja a Sol en $5 por millón de tokens de salida y ambos tienen el resto de tarifas idénticas; Terra y Luna son mucho más baratos que los dos. Por encima de 272K, Opus 5 cuesta aproximadamente la mitad que Sol por solicitud, mientras que Terra sigue siendo ligeramente más barata que Opus 5.
¿Claude Opus 5 es mejor que GPT-5.6 para programar?
Ambos corrigieron, contaron y refactorizaron correctamente en nuestra ejecución del 29 de julio, y el gráfico de r/Anthropic que encabezaba los resultados de Google para esta consulta ese día los muestra casi empatados en puntuaciones de programación. Opus 5 demostró mejor criterio de refactorización, pero facturó 3,4 veces los tokens de salida de Sol con la configuración predeterminada; la elección para programación es, por tanto, una cuestión de economía y verbosidad.
¿Cuáles son los cortes de conocimiento de Opus 5 y GPT-5.6?
Anthropic sitúa el corte de conocimiento fiable de Claude Opus 5 en mayo de 2026. Los tres modelos GPT-5.6 comparten el 16 de febrero de 2026, alrededor de tres meses antes.