 AIREITER
Das Fazit vorweg: Wer kurze Audioinhalte auf Englisch oder Chinesisch produziert, sollte Seed Audio 1.0 jetzt ausprobieren – allerdings über einen Drittanbieter-Gateway statt über die offizielle API. ByteDances Modell erstellt aus einem einzigen Prompt eine komplette Audioszene mit Dialogen, Hintergrundmusik und Soundeffekten. Gerade mehrstimmige Gespräche samt integriertem Musikmix heben es von spezialisierten TTS- oder Musiktools ab. Drei Einschränkungen bleiben: Pro Generierung sind maximal zwei Minuten möglich, unterstützt werden nur Englisch und Chinesisch, und die offizielle API ist weiterhin nur auf Einladung zugänglich und ohne veröffentlichten Preis. Hier ist der vollständige Überblick.
Was Seed Audio 1.0 eigentlich macht
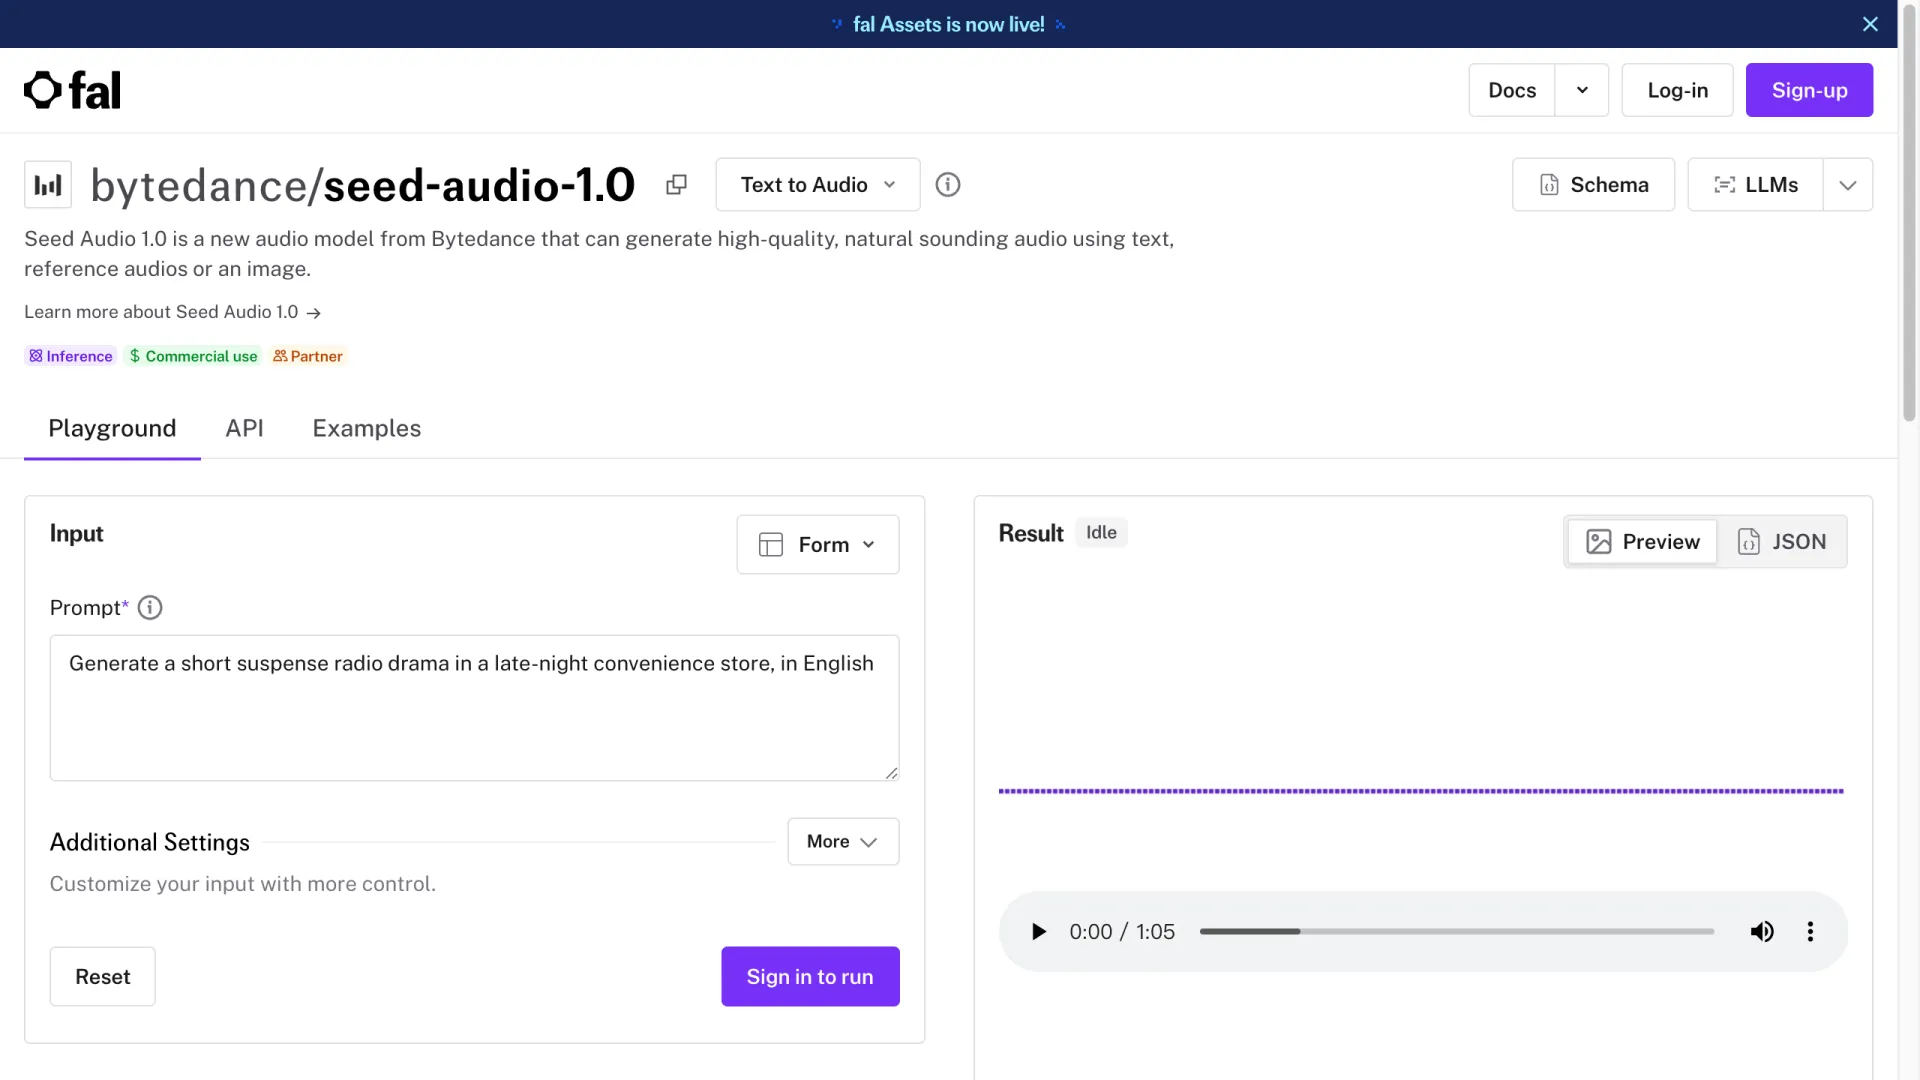
Die meisten Audiotools erfüllen genau eine Aufgabe: Text in Sprache umwandeln, Musik erzeugen oder Soundeffekte generieren. Seed Audio 1.0, mit vollem Namen Doubao-Seed-Audio 1.0, vereint alle drei auf einer gemeinsamen Timeline und erledigt sie in einem Durchgang. Ein Prompt wie "a suspense radio drama in a late-night convenience store" reicht aus, und das Modell liefert fertiges Audio mit gesprochenen Rollen, Atmosphäre und bereits abgemischter Musik.
Das Modell arbeitet in drei Modi. Text-to-Audio (T2A) erzeugt eine Szene aus einer Textbeschreibung. Text-and-Audio-to-Audio (TA2A) kombiniert Referenzclips mit Text, um Stimme und Stil zu steuern. Klassisches TTS ist für reine Sprechertexte gedacht, wenn schlicht saubere Sprache benötigt wird. Welcher Modus zum Einsatz kommt, richtet sich nach den Eingaben.
Ein Punkt verdient Klarstellung: Ist das ein Tool zum Klonen von Stimmen? Seed Audio 1.0 kann eine Stimme mehrere Rollen sprechen lassen und den Klang eines Referenzclips nachbilden. Die Ausgabe ist jedoch synthetisch und nicht an die Identität einer bestimmten realen Person gebunden. Sinnvoller ist es daher, von Zero-Shot-Voice-Styling zu sprechen – nicht von einem zustimmungsfreien Klon einer namentlich genannten Person. Technisch baut das Modell auf ByteDances früherer Forschung zu Seed-TTS und Seed-Music auf. Deshalb vereint es ausdrucksstarke Sprache und Musikgenerierung in einem Modell.
Diese Spezifikationen sind entscheidend
Bevor es an die Praxis geht, sollte klar sein, ob der jeweilige Anwendungsfall innerhalb der harten Grenzen liegt. Die folgenden Werte sind laut den Modellseiten von fal und EvoLink abgeglichen:
| Spezifikation | Wert |
|---|---|
| Maximale Ausgabe pro Generierung | 120 Sekunden (2 Minuten) |
| Limit für Textprompts | ~1.500–2.000 Zeichen (Quellen weichen ab; in der Konsole prüfen) |
| Referenzaudio | Bis zu 3 Clips, jeweils ≤30 Sekunden |
| Sprachen | Nur Englisch und Chinesisch |
| Ausgabeformate | WAV, MP3, PCM, OGG Opus |
| Sampleraten | 48K / 24K / 16K / 8K |
| Steuerung | Geschwindigkeit, Tonhöhe, Lautstärke (kein SSML) |
| Abrechnungsmodell | Nach Ausgabedauer |
Am stärksten fällt die Zwei-Minuten-Grenze ins Gewicht. Für eine komplette Podcastfolge oder längere Sprechertexte muss das Skript aufgeteilt und anschließend zusammengesetzt werden. Dabei kann der Klangcharakter zwischen den Segmenten auseinanderdriften. Laut den Modellhinweisen von fal ist ein Update geplant, das die Länge einzelner Generierungen in Richtung zehn Minuten anheben, eine explizite Längensteuerung einführen und weitere Sprachen unterstützen soll. Für Longform-Audio könnte sich das Warten lohnen.
Preise: noch keine offizielle Ansage
Einen offiziellen Preis gibt es noch nicht. Stand Juli 2026 hat Volcengine keinen Sekundenpreis für Seed Audio 1.0 veröffentlicht. Das Modell ist auf Volcano Ark weiterhin nur auf Einladung verfügbar; offizielle Preise folgen üblicherweise erst mit der allgemeinen Verfügbarkeit. Gateways wie fal und EvoLink nennen ebenfalls keinen festen Tarif. Abgerechnet wird nach Ausgabedauer – Kosten = generierte Sekunden × Tarif – und auch Wiederholungsversuche werden gezählt. Angaben zu einer Token-Abrechnung sollte man ignorieren: Für ein zeitbasiert abgerechnetes Audiomodell ergibt dieses Modell keinen Sinn.
So kommt man heute an Seed Audio 1.0
In der Praxis gibt es zwei Wege, die sich deutlich unterscheiden.
Der offizielle Weg führt über Volcano Ark. Dort ist Seed Audio 1.0 nur auf Einladung zugänglich. Man stellt einen Antrag, wartet auf die Freischaltung und arbeitet anschließend in ByteDances eigener Konsole. Sobald allgemeine Verfügbarkeit und Preise kommen, ist das die maßgebliche Quelle.
Direkter ist der Zugang über Drittanbieter-Gateways. fal bietet das Modell als bytedance/seed-audio-1.0 ohne Whitelist an: Mit einem normalen API-Key lässt sich der Endpoint ansprechen. EvoLink bietet einen vergleichbaren Zugang. Für die meisten Nutzer ist das aktuell der Weg, mit dem Modell zu arbeiten, ohne auf eine Einladung zu warten.
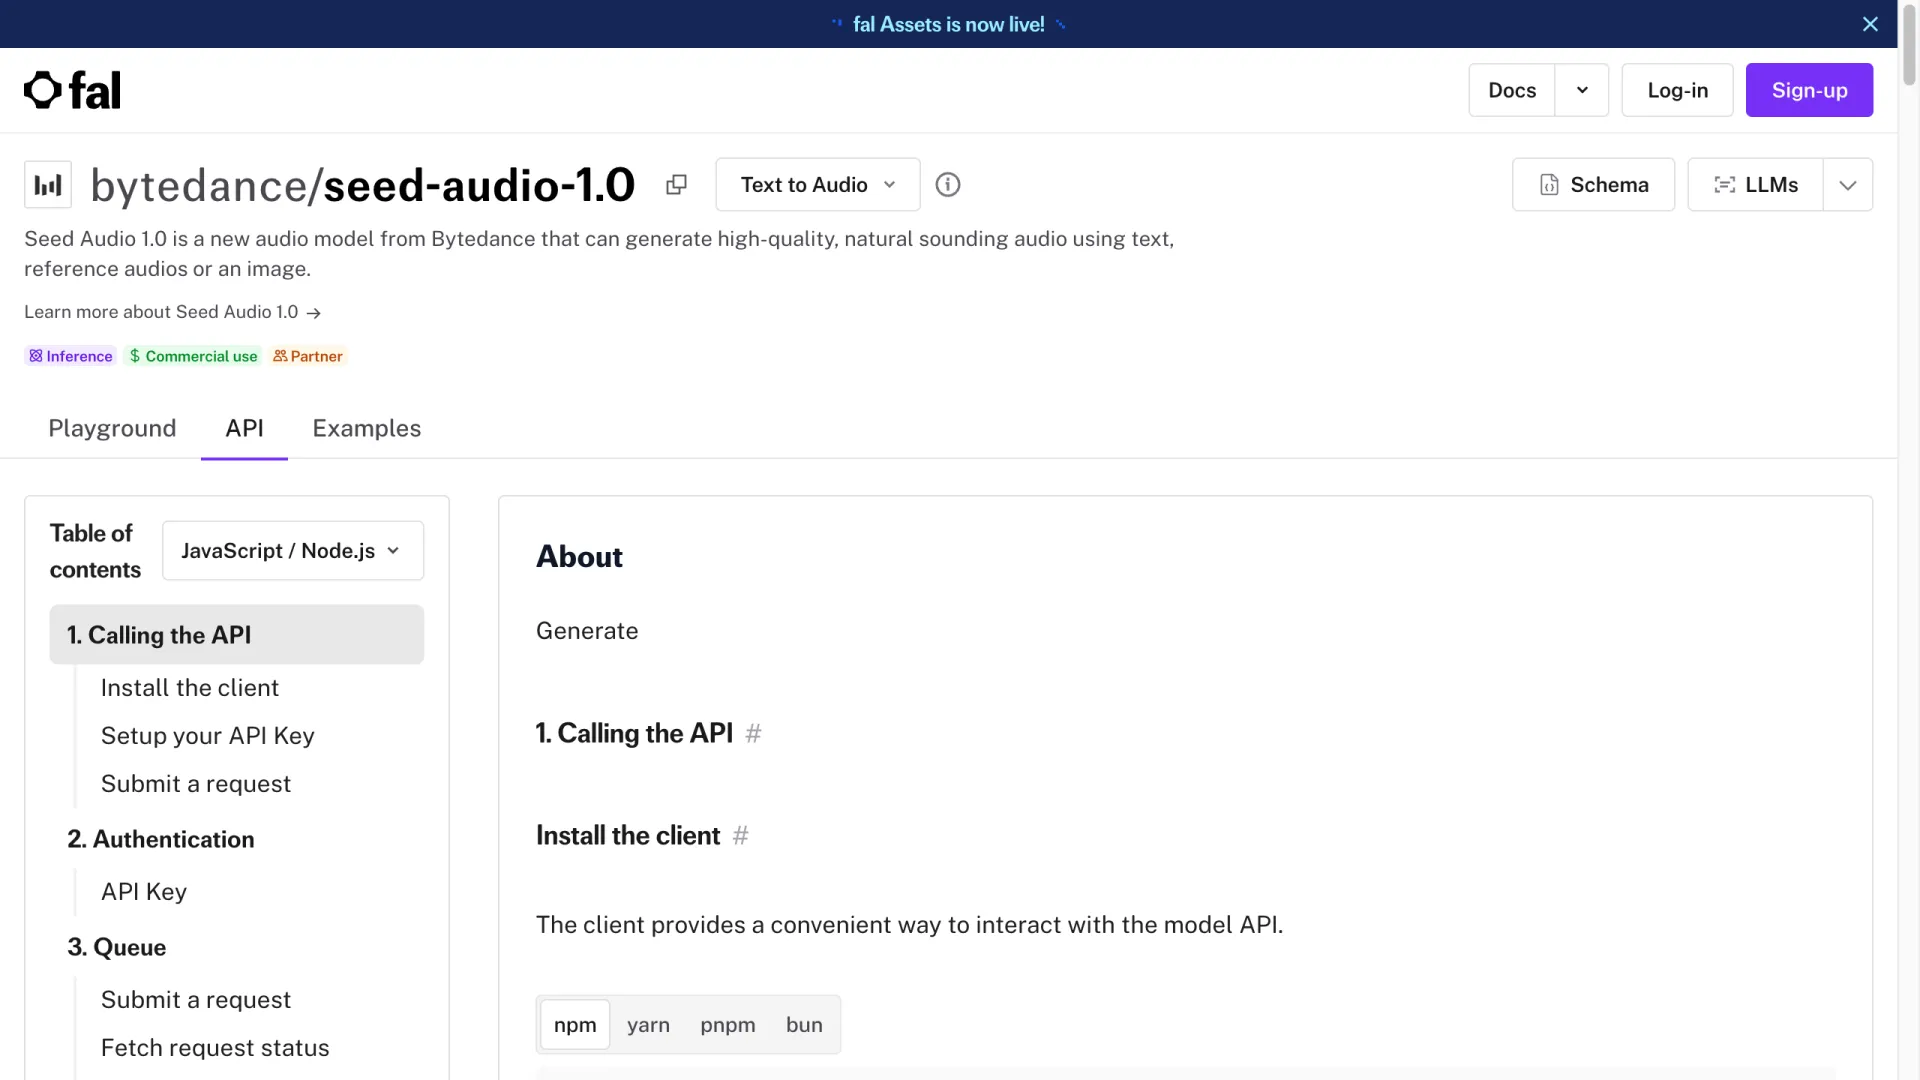
Der Aufruf folgt dem üblichen Queue-basierten API-Muster: Client installieren, Key hinterlegen, Prompt absenden und das Ergebnis abfragen. Wer bereits ein gehostetes generatives Modell auf diese Weise eingebunden hat, muss hier nichts Neues lernen. Unser fal.ai review erläutert die Entwicklererfahrung ausführlicher.
Für den ersten Test eignet sich eine kurze Szene mit mehreren Sprechern, die Dialog, Atmosphäre und Timing gleichzeitig abdeckt – etwa "a 30-second suspense radio drama in a late-night convenience store, English." Der erste Clip sollte unter 30 Sekunden bleiben. So sind misslungene Versuche günstig, während man ein Gefühl dafür entwickelt, wie das Modell Prompts interpretiert.
Seed Audio 1.0 im Vergleich mit ElevenLabs, Stable Audio & AudioCraft
Entscheidend ist nicht allein die Qualität eines einzelnen Clips, sondern die Aufgabe, für die jedes Tool konzipiert wurde.
| Tool | Kernstärke | Szenenmix | Sprachen | Stimmsteuerung |
|---|---|---|---|---|
| Seed Audio 1.0 | Komplette Audioszenen (Sprache + Musik + SFX) | Ja, in einem Durchgang | EN, CN | Zero-Shot-Styling |
| ElevenLabs | Sprache und Stimmklonen | Nur Sprache | 30+ | Stärkstes Klonen |
| Stable Audio | Musik- und Soundgenerierung | Einzelspur | N/A (Musik) | Prompt-basiert |
| AudioCraft | Open-Source-Musik/SFX | Einzelspur | N/A (Musik) | Prompt-basiert |
Für die beste reine Sprachqualität oder präzises Stimmklonen in vielen Sprachen bleibt ElevenLabs vorn. Wer eigenständige Musik benötigt, findet mit Stable Audio oder Metas AudioCraft passendere Werkzeuge. Die Stärke von Seed Audio 1.0 liegt darin, Dialoge, Musik und Effekte zu einer stimmigen, bearbeitbaren Szene zu verbinden. Keines der anderen hier genannten Tools erledigt das in einem einzigen Aufruf.
Stärken und Schwächen in der Praxis
Stärken: Mehrsprecher-Dialoge sowie das Zusammenmischen von Musik und Effekten in einem Durchgang sind die Hauptargumente. Die dokumentierten Bearbeitungsabläufe – Clips verlängern, Bereiche per Inpainting bearbeiten und Takes zusammensetzen, wie in der Nutzungsanleitung von fal beschrieben – machen daraus ein Produktionswerkzeug statt eines reinen Einmal-Generators.
Schwächen: Für längere Inhalte zwingt die Zwei-Minuten-Grenze zum Zusammensetzen mehrerer Segmente. Mit Englisch und Chinesisch allein ist der Großteil internationaler Voice-Projekte ausgeschlossen. Als Offline-Generierungsmodell eignet es sich nicht für Echtzeit-Sprachagenten. Außerdem bleibt der offizielle Zugang an eine Einladung gebunden.
Lohnt sich Seed Audio 1.0 schon?
Für kurze Inhalte auf Englisch oder Chinesisch – Synchronisationen, Hörbuchauszüge, Soundtracks für Kurzvideos oder Audio-Drama-Prototypen – lohnt sich ein Test von Seed Audio 1.0 über ein Gateway bereits heute. Die Szenengenerierung in einem Durchgang spart die manuelle Arbeit, Sprache, Musik und Effekte selbst übereinanderzulegen.
Wer Echtzeitinteraktion, eine nicht unterstützte Sprache oder langes Audio ohne Unterbrechung braucht, sollte warten. Die allgemeine Verfügbarkeit und das geplante Längen-Update werden die Rechnung verändern. Für Live-Anwendungen passt in der Zwischenzeit ein Echtzeitmodell wie Qwen Audio 3 besser. Für alle anderen gilt: Über ein Gateway testen und den bestehenden Stack weiterlaufen lassen – noch ist das kein Anlass für einen vollständigen Wechsel.
FAQ
Ist Seed Audio 1.0 kostenlos?
Nein. Es gibt keinen kostenlosen offiziellen Tarif. Die Volcano-Ark-API ist nur auf Einladung verfügbar und wird nach Ausgabedauer abgerechnet, sobald Zugang besteht. Drittanbieter-Gateways berechnen ihre eigenen nutzungsbasierten Tarife.
Kann Seed Audio 1.0 meine Stimme klonen?
Das Modell kann den Stil eines Referenzclips nachbilden und mehrere Rollen sprechen, erzeugt aber synthetische Sprache statt eines fest an eine konkrete reale Person gebundenen Klons. Es sollte nicht als direkt einsetzbares Tool zum Klonen von Identitäten betrachtet werden.
Welche Sprachen unterstützt Seed Audio 1.0?
Zum Start nur Englisch und Chinesisch. Laut den Modellhinweisen von fal ist eine breitere mehrsprachige Unterstützung für ein geplantes Update vorgesehen.
Wie lang darf generiertes Audio sein?
Aktuell sind bis zu 120 Sekunden pro Generierung möglich. Das geplante Update soll die Länge einzelner Generierungen mit expliziter Längensteuerung in Richtung zehn Minuten erhöhen.
Gibt es eine offizielle API für Seed Audio 1.0?
Ja, über Volcengines Volcano Ark, derzeit aber nur auf Einladung. Für offenen Zugang ohne Whitelist eignet sich ein Gateway wie fal, das bytedance/seed-audio-1.0 hostet.
Was ist der Unterschied zwischen Seed Audio und Seed Music?
Seed-Music war ByteDances frühere musikfokussierte Forschung. Seed Audio 1.0 bündelt diese Musikfähigkeiten mit Sprache und Soundeffekten in einem Modell zur Szenengenerierung.