 AIREITER
Qwen Audio 3.0 Realtime steht in Qwens aktuellem Portfolio für Sprachinteraktion ohne spürbare Wartezeit: Man spricht mit dem Modell, und es antwortet direkt per Stimme – mit einer Latenz, die sich eher wie ein Telefongespräch anfühlt. Auf Alibabas Plattform läuft das über die Qwen3-Omni / Qwen3.5-Omni Realtime API mit Modell-IDs wie qwen3-omni-flash-realtime. Für reines Text-to-Speech gibt es Qwen-TTS-Realtime, für Transkription qwen3-asr-flash. Die gehosteten Omni-Realtime-Modelle verstehen mehr als 100 Sprachen, unterstützen Full-Duplex-Gespräche samt Unterbrechungen und kosten pro Gesprächsminute nur einen Bruchteil eines Cents.
Am schnellsten startet man mit qwen3-omni-flash-realtime über WebSocket. Im Folgenden geht es darum, was die einzelnen Modelle leisten, was sie kosten, wie sie gegen OpenAI Realtime und Gemini Live abschneiden und wie der Einstieg funktioniert. Alle Specs, Preise und Modell-IDs sind mit den Primärquellen verlinkt – überwiegend mit Alibabas Model Studio Realtime documentation und der Qwen3-Omni model card. Da sich in diesem Markt Zahlen schnell ändern, gilt bei Abweichungen stets die verlinkte Quelle.
So ist die Qwen-Audiofamilie aufgebaut
Qwens Audiomodelle verteilen sich auf mehrere Generationen. Wer die Produktlinie einordnet, findet deutlich schneller das passende Modell:
Qwen-Audio(2023) undQwen2-Audiowaren Modelle zum Verstehen von Audio: Sprache hinein, Text heraus. Eigene Sprachausgabe gab es nicht.- In der aktuellen Generation steckt Audio in den Omni-Modellen.
Qwen3-OmniundQwen3.5-Omniverarbeiten Text, Bilder, Audio und Video und erzeugen sowohl Text als auch natürlich klingende Sprache. - Echtzeitverhalten ist eine Bereitstellungsvariante: Die Omni-Modelle werden über die Realtime API angesprochen und tragen dafür Modell-IDs mit dem Suffix
-realtime.
Mit „Qwen Audio 3.0 Realtime“ – unabhängig von der Schreibweise – ist also die Qwen3-Omni-Familie im Echtzeitbetrieb gemeint. Genau um diesen Stack geht es im weiteren Verlauf.
Der Qwen-Echtzeit-Stack: drei Bausteine
Statt an ein einzelnes Modell sollte man bei einer produktiven Voice-App eher an eine Pipeline denken. Typischerweise kommen dabei drei Qwen-Modelle zum Einsatz, die sich gemeinsam oder separat verwenden lassen.
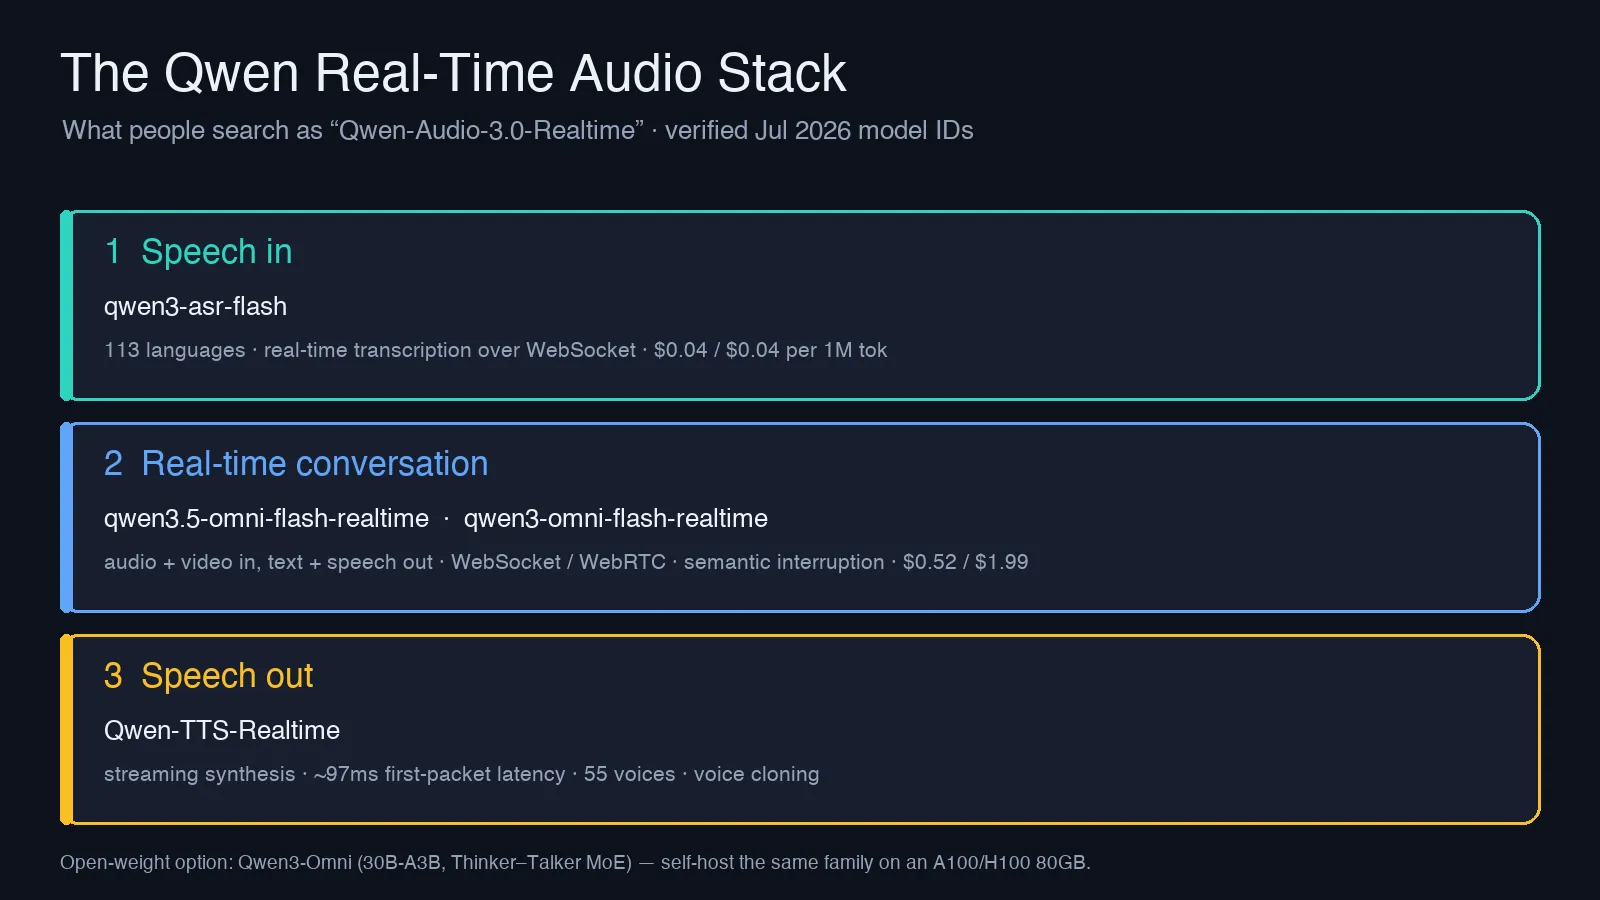
- Spracheingabe —
qwen3-asr-flash. Streaming-Spracherkennung via WebSocket, ausgelegt für Live-Untertitel und Voice-Agent-Frontends. Das Modell transkribiert ein sehr breites Sprachenspektrum und ist als günstiges Arbeitspferd für Transkriptionen positioniert. - Echtzeitdialog —
qwen3.5-omni-flash-realtime,qwen3-omni-flash-realtime,qwen3.5-omni-plus-realtime. Der Kern des Systems: Audio und Videoframes gehen hinein, Text und synthetisierte Sprache kommen heraus. Die Verbindung bleibt über mehrere Gesprächszüge bestehen, statt für jede Anfrage neu aufgebaut zu werden. - Sprachausgabe —
Qwen-TTS-Realtime. Ein dediziertes Streaming-Text-to-Speech-Modell für Fälle, in denen Text lediglich in Sprache umgewandelt werden soll – etwa um die Antwort eines Text-LLM vorzulesen.
Wer für die mittlere Schicht ein Omni-Realtime-Modell nutzt, braucht oft keine getrennten ASR- und TTS-Aufrufe: Das Modell übernimmt Ein- und Ausgabe von Sprache durchgängig. Die separaten Modelle sind vor allem dann sinnvoll, wenn Komponenten kombiniert werden sollen, etwa ein eigenes STT-System mit Qwen TTS.
Diese technischen Daten sind wirklich relevant
Die folgenden Werte stammen aus der Model Studio Realtime documentation, nicht aus Marketingmaterial.
| Merkmal | Qwen Realtime API (Omni-Familie) |
|---|---|
| Audioeingabe | PCM, 16 kHz |
| Audioausgabe | PCM, 24 kHz |
| Weitere Eingaben | Bild- / Videoframes (JPG, bis 1080p, 256 KB nach Kodierung) |
| Spracherkennung | 113 Sprachen und Dialekte (gehostete API) |
| Sprachgenerierung | 36 Sprachen und Dialekte |
| Stimmen | 55 insgesamt (47 mehrsprachige, 8 Dialektstimmen), plus Voice Cloning bei den 3.5-Modellen |
| Verbindungen | WebSocket (Bearer-Auth, manuelle oder serverseitige VAD) und WebRTC (SDP-Negotiation) |
| Maximale Sitzung | 120 Minuten über WebSocket |
| Zusatzfunktionen | Semantische Unterbrechungen, Function Calling, autonome Websuche, Sprachsteuerung für Lautstärke / Sprechtempo / Emotion |
Einige Punkte verdienen besondere Aufmerksamkeit. Bei einer semantischen Unterbrechung erkennt das Modell, ob jemand tatsächlich ins Wort fällt oder nur mit einem „mhm“ signalisiert, dass er zuhört. Genau das trennt einen natürlich wirkenden Voice Agent von einem nervigen. WebRTC-Unterstützung ist besonders für Browser-Anwendungen wichtig, weil Echo-Unterdrückung und Jitter-Handling damit bereits abgedeckt sind. Die Angabe von 113 Sprachen für die Erkennung bezieht sich auf die gehostete API; die Open-Weights-Version unterstützt, wie weiter unten erläutert, weniger Sprachen.
Zur Latenz: Der dedizierte Streaming-Pfad von Qwen-TTS-Realtime zielt laut den Qwen3-TTS streaming docs auf etwa 97 ms Latenz bis zum ersten Paket. Das ist die Kennzahl, die darüber entscheidet, ob Sprache unmittelbar wirkt. Gemeint ist die Zeit bis zum ersten Audio-Chunk, nicht bis zur vollständigen Antwort. Für den kompletten Gesprächszyklus ist die Thinker–Talker-Architektur auf Streaming ausgelegt. Der Qwen3-Omni technical report beschreibt ein Multi-Codebook-Design zur Latenzminimierung, während Community-Tests bei Full-Duplex-Gesprächen mit Unterbrechungen Audio-zu-Audio-Antwortzeiten im Bereich von unter 250 ms sehen. Die tatsächlichen Werte hängen von Region, Netzwerk und Auslastung ab – deshalb sollte man mit dem eigenen Traffic messen, statt sich auf eine einzelne Schlagzeilenzahl zu verlassen.
Preise für Qwen-Echtzeit-Audio: die konkreten Zahlen
Qwens gehostete Echtzeitpreise liegen deutlich unter denen geschlossener Realtime-APIs. Die folgenden Preise gelten pro einer Million Tokens für Ein- und Ausgabe und stammen aus Portkey's DashScope model directory. Der Drittanbieter spiegelt Alibabas Preise; vor einer verbindlichen Kalkulation sollte man den aktuellen Stand dennoch in der Model Studio console prüfen:
| Modell | Eingabe / 1 Mio. Tok. | Ausgabe / 1 Mio. Tok. |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash (Transkription) | $0.04 | $0.04 |
Was das pro Gespräch bedeutet. Audio verbraucht viele Tokens: ungefähr 427 Tokens pro Audiominute. Bei einem zehnminütigen Sprachgespräch, in dem Nutzer und Modell jeweils fünf Minuten sprechen, fallen mit qwen3-omni-flash-realtime rund 2.135 Eingabe- und 2.135 Ausgabe-Tokens an. Das ergibt etwa $0.001 für die Eingabe + $0.004 für die Ausgabe ≈ einen halben Cent pro 10-Minuten-Anruf. Selbst im größeren Maßstab bleibt Echtzeit-Audio günstig. Der überraschende Kostenblock ist die Ausgabe, denn gesprochene Antworten kosten rund das Vierfache der Eingabe.
Für die Budgetplanung sind außerdem zwei Dinge wichtig:
- Es gibt ein kostenloses Kontingent, aber nur regional. Der Endpunkt in Singapur für internationale Nutzer bot 1 Million Eingabe- und 1 Million Ausgabe-Tokens kostenlos für 90 Tage; beim US-Endpunkt galt das nicht. Kontingente können sich ändern – daher vor der Planung das aktuelle Angebot für die eigene Region in der Model Studio console prüfen.
- Die Stufe
qwen3.5-omniverwendet Preisstaffeln nach Anfragegröße statt eines Einheitspreises. Eine einzelne Anfrage mit großem Kontext kann damit in einer anderen Preisstufe landen als mehrere kleine. Vor einer Festlegung sollte das mit der tatsächlichen Traffic-Struktur getestet werden.
Vergleich mit OpenAI Realtime und Gemini Live
Unter den Anbietern universeller Frontier-LLMs sind Mitte 2026 OpenAIs Realtime API, Googles Gemini Live und Qwens Omni-Realtime-Familie die naheliegenden Optionen für Speech-to-Speech in Echtzeit. Spezialisierte Sprachplattformen wie ElevenLabs, Deepgram, Cartesia und Hume konkurrieren stark bei TTS und STT; hier geht es jedoch um den Weg über ein vollständiges multimodales Modell. Statt Preise von Wettbewerbern zu zitieren, die sich monatlich ändern können, hilft folgende Einordnung bei der Auswahl:
- Kosten. Mit den oben gezeigten Preisen liegt Qwen bei gehosteten Frontier-Modellen am unteren Ende der Kostenkurve. Zum Vergleich: OpenAI Realtime Audio lag bei etwa $0.06 pro Minute Eingabe und $0.24 pro Minute Ausgabe (Preisaufschlüsselung hier). Derselbe zehnminütige Anruf, der mit
qwen3-omni-flash-realtimeungefähr einen halben Cent kostet, läge bei OpenAI auf dieser Basis eher bei $1.50. Vor einer Kalkulation sollten die aktuellen Preise auf beiden Seiten geprüft werden, denn sie ändern sich. Der Abstand ist jedoch groß. Qwen ist außerdem der einzige dieser drei Anbieter mit einer Open-Weights-Variante, die sich selbst hosten lässt und die Grenzkosten gegen null drücken kann. - Offenheit. OpenAI Realtime und Gemini Live sind ausschließlich geschlossene APIs. Qwen3-Omni wird mit offenen Gewichten veröffentlicht, sodass sich eine Anwendung vom gehosteten zum selbst betriebenen Modell migrieren lässt, ohne sie auf ein völlig anderes Modellverhalten umzubauen.
- Qualität. Berichte von Drittanbietern sehen die höchste Stufe
qwen3.5-omni-plusin einigen Benchmarks für Audioverständnis auf Augenhöhe mit oder vor Gemini 3.1 Pro. Einzelne Benchmarks sind allerdings nur ein Ausgangspunkt – entscheidend ist der Test mit den eigenen Audiodaten. - Ökosystem. OpenAI und Google verfügen aktuell über umfangreichere Toolchains, SDKs und mehr Community-Beispiele. Qwens Dokumentation ist solide, verlangt aber häufiger direkte Arbeit mit der WebSocket-/WebRTC-Spezifikation.
Praktisch heißt das: Wenn Kosten oder die Option auf Self-Hosting wichtig sind, ist Qwen die stärkste Wahl. Wer das ausgereifteste SDK-Erlebnis sucht und dafür mehr bezahlen kann, findet bei OpenAI und Google weiterhin die polierteren Lösungen. Eine vollständige Kostenübersicht der geschlossenen Alternativen steht in den weiterführenden Links unten.
Welches Modell passt zu welchem Einsatz?
| Anforderung | Empfehlung |
|---|---|
| Günstigster gehosteter vollständiger Sprachdialog | qwen3-omni-flash-realtime |
| Beste gehostete Qualität, längere Sitzungen, Voice Cloning | qwen3.5-omni-plus-realtime |
| Nur Transkription erforderlich | qwen3-asr-flash |
| Nur Text-to-Speech erforderlich | Qwen-TTS-Realtime |
| Daten müssen auf eigener Hardware bleiben | Open-Weights-Qwen3-Omni (30B-A3B) selbst hosten |
Die 3.5-Stufen bieten Voice Cloning sowie längere Kontext- und Dialoglimits – bis zu 100 Turns und 600 Sekunden gespeichertes Audio – gegenüber dem schlankeren qwen3-omni-flash mit 8 Turns. Für einen Prototypen sollte Flash der Startpunkt sein; Plus lohnt sich erst, wenn ein klar benennbares Limit erreicht wird.
Zugang und erste Schritte
Gehostet und direkt. Zuerst wird ein API-Key in Alibaba Cloud Model Studio angelegt. Anschließend öffnet die Anwendung eine WebSocket-Verbindung mit Bearer-Authentifizierung oder handelt für Browser-Apps WebRTC über einen SDP-POST aus. PCM-Audio wird gestreamt, zurück kommen PCM-Audio und Text. Das DashScope Python SDK kapselt die Realtime-Schnittstelle, falls der Socket nicht manuell verwaltet werden soll. Die Basisverbindung ist kurz gehalten; Fehlerbehandlung fehlt in diesem Beispiel:
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. Sitzung konfigurieren: Stimme, Ausgabeformat, serverseitige Turn-Erkennung
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. Mikrofon-Audio als Base64-kodierte PCM-Frames mit 16 kHz streamen
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. Events lesen; response.audio.delta enthält PCM mit 24 kHz zur Wiedergabe
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
Bei serverseitiger VAD entscheidet das Modell, wann der Nutzer nicht mehr spricht. Wer die Turn-Grenzen selbst steuern möchte, wechselt auf den manuellen Modus. Der Event-Flow ähnelt stark dem Aufbau von OpenAI Realtime, sodass sich bestehender Realtime-Client-Code mit wenigen Anpassungen portieren lässt. Vor dem Deployment sollten die exakten Feldnamen, die Stimmenliste und der regionale Endpoint-Host anhand der Realtime docs geprüft werden: Sie unterscheiden sich zwischen Singapur- und US-Deployment und entwickeln sich mit der API weiter.
Self-Hosting. Das Open-Weights-Modell Qwen3-Omni nutzt eine Thinker–Talker-Mixture-of-Experts-Architektur mit 30B Parametern insgesamt und etwa 3B aktiven Parametern. Alibaba empfiehlt dafür vLLM statt plain Transformers. Für BF16-Inferenz des vollständigen 30B-Modells nennen third-party deployment guides mindestens eine 80GB-Karte (A100 oder H100). Eine 24-GB-Karte wie die RTX 4090 reicht nicht für die vollständigen Gewichte, auch wenn quantisierte Builds die Hardwarehürde senken.
Der Haken: Echtzeit-Serving ist schwieriger als Batch-Inferenz. Self-Hoster berichten, dass sie den KV-Cache begrenzen müssen, um bei gleichzeitiger Last Hänger zu vermeiden. Auch der Token-Durchsatz einzelner Karten bleibt hinter der gehosteten API zurück. Auf Streaming optimierte Serving-Stacks schließen einen großen Teil dieser Lücke: Entwickler bei Red Hat AI und vLLM berichteten, dass überlappende Pipeline-Stufen die Sprachgenerierung für einen drei Sekunden langen Clip von ungefähr 8 Sekunden auf etwa 0.5 Sekunden senken. Das ist ein echter Gewinn, bringt aber zusätzlichen Engineering-Aufwand mit sich. Self-Hosting eliminiert Tokenkosten, fügt jedoch GPU- und Betriebskosten hinzu – wirtschaftlich wird es bei hohem, konstantem Volumen statt bei Prototypen.
Für Echtzeit-Omni-Voice ist der DashScope-Endpoint derzeit der kanonische Weg. Wenn ein Stack bereits mehrere Anbieter über ein Gateway bündelt, kann ein Aggregator davor geschaltet werden. Vorher sollte aber geprüft werden, ob die konkreten Qwen-Realtime-Modell-IDs im Katalog vorhanden sind: Viele Relays führen Text- und Bildmodelle, nicht aber die Realtime-Audio-Stufe.
Wichtige Grenzen vor dem Produktivstart
- Sitzungen enden nach 120 Minuten. Für längere Szenarien wie Support-Hotlines oder ausgedehnte Nachhilfestunden ist eine Reconnect-Logik nötig, die den Kontext zwischen Sockets weiterträgt.
- Die Region bestimmt sowohl Freikontingent als auch Verfügbarkeit. Getestet werden sollte mit dem Endpoint, auf dem später deployt wird – nicht einfach mit dem ersten Endpoint, bei dem die Registrierung erfolgte.
- Gehostete API und Open Weights sind nicht identisch. Die gehostete API wirbt mit Erkennung in 113 und Generierung in 36 Sprachen. Das Open-Weights-Release Qwen3-Omni deckt weniger ab: 19 Sprachen für Spracheingabe und 10 für Sprachausgabe. Wenn eine bestimmte Sprache Voraussetzung ist, muss sie mit genau der geplanten Variante überprüft werden.
- Die Echtzeitkosten wachsen mit der Sprechzeit, nicht mit der Zahl der Requests. Da Audio viele Tokens benötigt, kostet ein gesprächiger Nutzer mehr als ein knapper. Rechnungen sollten auf Gesprächsminuten statt auf Anrufzahlen basieren.
Häufige Fragen
Unterstützt Qwen 3 Audio?
Ja. Die Qwen3-Omni-Modelle sind nativ multimodal: Sie verarbeiten Audio, Text, Bilder und Video als Eingabe und können in Echtzeit per Text oder Sprache antworten.
Kann Qwen Audio erzeugen oder nur verstehen?
Ja, Qwen kann Audio erzeugen. Anders als das ursprüngliche Qwen-Audio, das ausschließlich Text ausgab, generieren die Omni-Realtime-Modelle und Qwen-TTS-Realtime gesprochene Audioausgabe. In der 3.5-Stufe gehören auch geklonte Stimmen dazu.
Ist Qwen-Echtzeit-Audio kostenlos?
Es gibt ein kostenloses Testkontingent: Historisch waren es 1 Million Eingabe- und 1 Million Ausgabe-Tokens für 90 Tage am internationalen Endpoint in Singapur. Danach wird pro Token abgerechnet. Das vollständig offene Qwen3-Omni mit Open Weights lässt sich kostenlos ausführen, wenn eigene GPU-Hardware bereitsteht.
Wie betreibe ich Qwen Audio lokal?
Das Open-Weights-Modell Qwen3-Omni (30B-A3B) herunterladen und mit vLLM bereitstellen. Für das vollständige Modell in BF16 ist ungefähr eine 80GB-Karte wie A100 oder H100 nötig; kleinere Consumer-GPUs bewältigen nur quantisierte Builds, nicht die vollständigen Gewichte.
Weiterführende Links
Primärquellen:
Preise der Alternativen: