 AIREITER
Drei OpenAI-Angebote tragen inzwischen „fast“ oder „ultra“ im Namen – doch nur eines erreicht 750 Token pro Sekunde. Der am 13. August 2026 angekündigte OpenAI Ultrafast mode ist ein neuer API-Service-Tier für GPT-5.6 Sol auf Wafer-Scale-Chips von Cerebras und soll bis zu 14-mal schneller als Standard sein. Der Haken: Zugang gibt es nur auf Einladung, einen Preis hat OpenAI nicht veröffentlicht. Der schnellste Tarif, den man heute tatsächlich kaufen kann, bleibt damit Fast mode für $10/$60 pro Million Token.
Drei ähnliche Namen, drei verschiedene Funktionen
Wer GPT-5.6 Sol nutzt, stößt derzeit auf drei Geschwindigkeitsbegriffe mit grundverschiedener Bedeutung. Die Übersicht schafft Klarheit.
| Name | Was dahintersteckt | So erhält man Zugang | Sol-Preis (pro 1 Mio. Token) | Beworbene Geschwindigkeit |
|---|---|---|---|---|
ultra-Reasoning-Einstellung | Ein Arbeitsmodus für Reasoning, der Subagenten und zusätzliche Rechenleistung auf eine Aufgabe setzt | Codex-Einstellung, kein separat buchbarer API-Tarif | Kein eigener Tarif; verbraucht Nutzungslimits schnell | Absichtlich langsamer |
| Fast mode | API-Verarbeitungstarif, am 30. Juli 2026 von Priority umbenannt | service_tier="fast" in jeder API-Anfrage | $10 Input / $60 Output (kurzer Kontext) | Bis zu 2,5x Standard |
| Ultrafast mode | Cerebras-basierter API-Tarif für GPT-5.6 Sol, Vorschau vom 13. August 2026 | Begrenzte Vorschau, nur für ausgewählte Kunden | Nicht veröffentlicht | Bis zu 14x Standard |
Die Konzepte zielen in entgegengesetzte Richtungen: ultra ist der Subagent-Arbeitsmodus, der Tempo gegen Gründlichkeit tauscht. Ultrafast mode liefert dagegen reine Decoding-Geschwindigkeit für dasselbe Modell. Dazwischen liegt Fast mode als buchbares Latenz-Upgrade, das OpenAI auf der eigenen Fast-mode-Seite separat dokumentiert.
Was die Vorschau vom 13. August tatsächlich bietet
Die offizielle Ankündigung nennt fünf konkrete Punkte: Ultrafast startet zunächst in der OpenAI API, unterstützt ausschließlich GPT-5.6 Sol, soll bis zu 14-mal schneller als die Standardverarbeitung sein und bis zu 750 Output-Token pro Sekunde liefern. Die Infrastruktur stammt von Cerebras. Zum Start läuft der Dienst als begrenzte Vorschau für eine ausgewählte Kundengruppe, darunter Jane Street, Podium, Basis und Rogo.
Vier für Käufer zentrale Angaben fehlen allerdings: Preis pro Token, Modell-ID, Rate Limits und eine Latenz-SLA. Auch namentlich genannte Benchmarks sucht man vergeblich.
Als Beleg zeigt OpenAI einen Direktvergleich: Ultrafast und Standard Sol erstellen aus demselben Prompt einen 3D-Lagerhaus-Simulator. Ein Zitat von Rogos Alex Wang bringt das Versprechen auf den Punkt: „Ultrafast macht komplexe Finanzrecherche zu einer Echtzeit-Interaktion.“
Von 2,5x auf 14x: Was der Geschwindigkeitsunterschied bedeutet
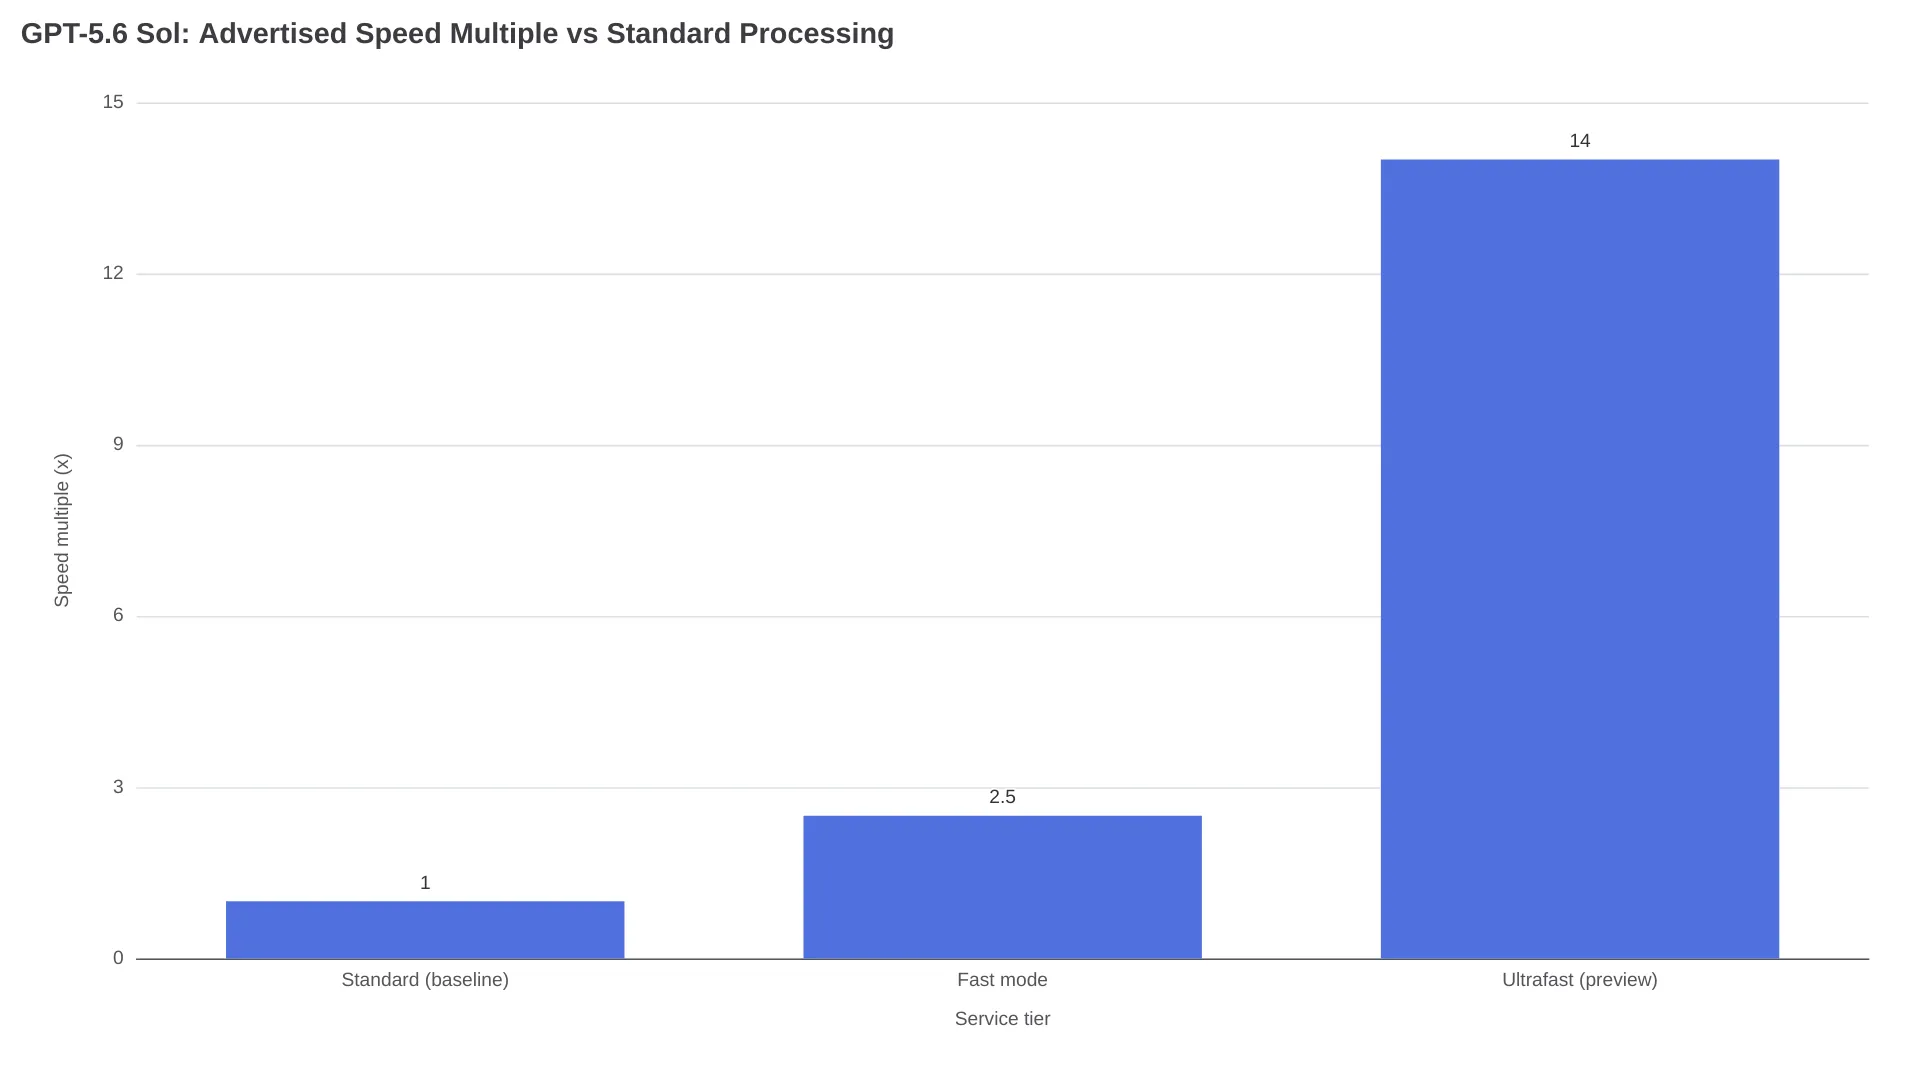
Zunächst ein wichtiger Messhinweis: Die 750 Token pro Sekunde bezeichnen den beworbenen Output-Durchsatz, während die Angabe für Fast mode eine SLA-Untergrenze ist. Die Kennzahlen hängen zusammen, sind aber nicht identisch. Teilt man 750 durch 14, ergibt sich für Standard Sol ein Decoding-Tempo von rund 54 Token pro Sekunde. Eine Generierung mit 10.000 Token würde damit bei Standard ungefähr 186 Sekunden dauern, bei der Enterprise-SLA-Untergrenze von Fast mode mit 80 Token pro Sekunde bis zu 125 Sekunden und mit Ultrafast etwa 13 Sekunden.
| Workload | Standard (~54 Tok./s, abgeleitet) | Fast mode (SLA ≥80 Tok./s) | Ultrafast (beworben: 750 Tok./s) |
|---|---|---|---|
| Generierung mit 10.000 Token | ~186 s | ≤125 s | ~13 s |
| Agent-Loop mit 5 Durchläufen, 1.000 Token/Durchlauf | ~93 s | ≤63 s | ~7 s |
Zahlen, die auf r/AIToolsPerformance kursieren, schreiben diese Vergleiche Artificial Analysis und Cerebras zu: Demnach ist Ultrafast 11-mal schneller als Claude Fable 5 und fünfmal schneller als Opus 4.8 im Fast mode. Ein kompletter Durchlauf von Humanity's Last Exam mit 2.500 Fragen soll 11 Stunden und 11 Minuten statt 78 Stunden und 27 Minuten für Fable 5 benötigen. Sämtliche Werte stammen von den Anbietern; eine unabhängige Replikation gibt es bislang nicht.
Der Preis, den außerhalb der Vorschau niemand kennt
Öffentlich bekannte Preise für Ultrafast gibt es nicht. In der Ankündigung fehlt jede Tarifangabe, und genau diese Lücke fiel der Community sofort auf. Ein Beitrag auf r/AIToolsPerformance formuliert es so: „Was der Blog nicht sagt, ist der Preis. Niemand außerhalb der Vorschau weiß, was es kostet.“
Als Orientierung bleibt die heute bekannte Preisstaffel für GPT-5.6 Sol, jeweils pro Million Token:
| Tarif | Input (kurzer Kontext) | Output (kurzer Kontext) | Input (langer Kontext >272k) | Output (langer Kontext) | Gecachter Input |
|---|---|---|---|---|---|
| Standard | $5.00 | $30.00 | $10.00 | $45.00 | $0.50 |
| Fast mode | $10.00 | $60.00 | $20.00 | $90.00 | $1.00 |
| Ultrafast | Nicht veröffentlicht | Nicht veröffentlicht | Nicht veröffentlicht | Nicht veröffentlicht | Nicht veröffentlicht |
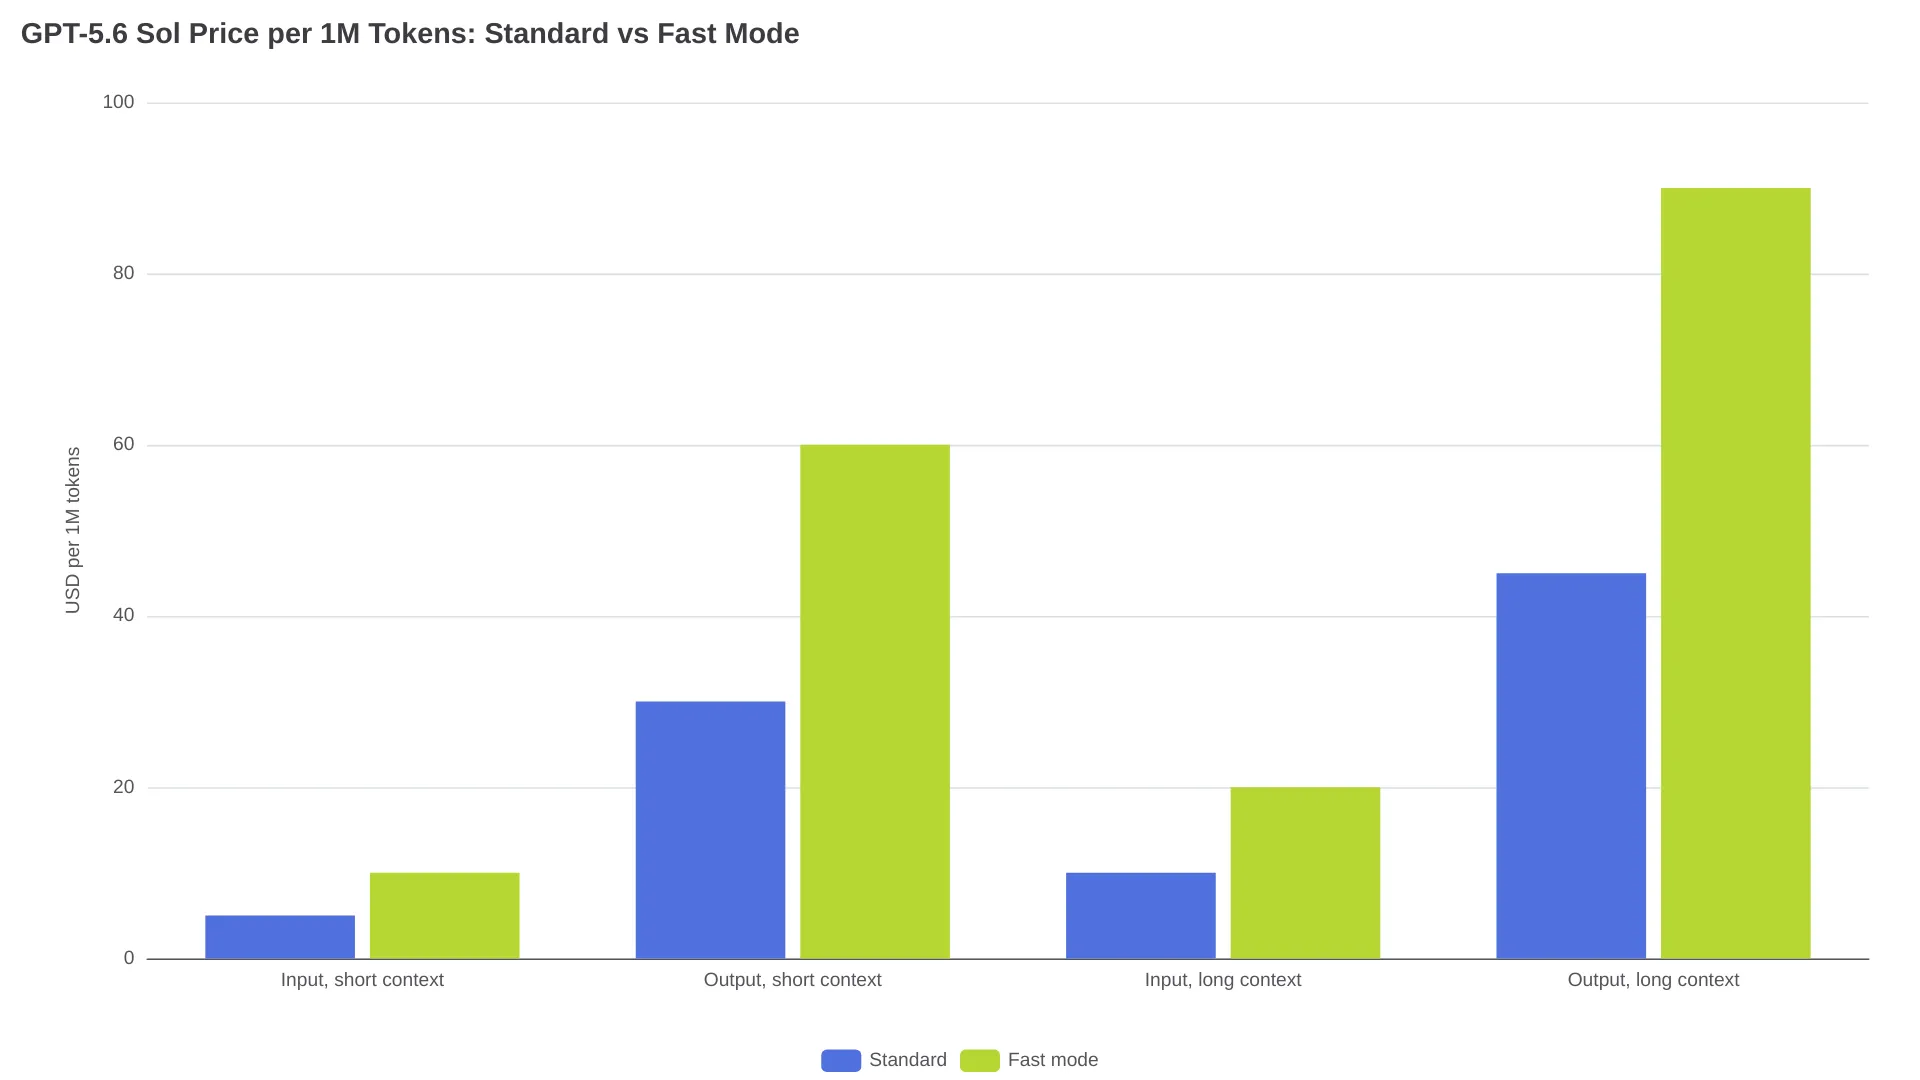
Für Sol kostet Fast mode exakt das Doppelte von Standard. Aus öffentlichen Informationen lässt sich daraus kein Ultrafast-Preis ableiten, denn Tarife können sich in beide Richtungen bewegen – OpenAI senkte am 30. Juli die Preise für Terra und Luna. Wer ein Latenzbudget plant, sollte auch das Kleingedruckte von Fast mode beachten: Bei mehr als 1 Million Token pro Minute und einem Traffic-Anstieg von über 50 % in weniger als 15 Minuten werden überschüssige Anfragen still auf Standard zurückgestuft. Sie geben dann service_tier="Default" zurück und werden zu Standard-Preisen abgerechnet.
Zugang heute: Einladung statt Warteliste
Ultrafast ist nur per Einladung zugänglich, nicht über eine öffentliche Warteliste. OpenAI erklärt, die Vorschau werde „as capacity grows“ ausgeweitet, und bietet auf der Ankündigungsseite eine Anmeldung für Zugangs-Updates an. Berichte aus dem Juli zählten innerhalb des frühen Sol-Zugangs lediglich rund 20 Organisationen.
Die Infrastruktur kommt nicht aus dem Nichts: Die Partnerschaft zwischen OpenAI und Cerebras besteht seit dem 14. Januar 2026 und reserviert 750 MW Wafer-Scale-Kapazität. GPT-5.3-Codex-Spark erreichte auf derselben Hardware bereits mehr als 1.000 Token pro Sekunde.
Schnellere Ausgaben schon vor der Ultrafast-Einladung
Fast mode steht bereits allen API-Kunden zur Verfügung. Die Aktivierung erfordert nur einen zusätzlichen Parameter:
- Bei einer Anfrage an
/v1/responsesoder/v1/chat/completionsservice_tier="fast"ergänzen. - Die bisherigen Werte
service_tier="priority"funktionieren weiterhin. Bestehende Modelle zeigen in den Nutzungs-Dashboards weiterpriority; Modelle nach GPT-5.6 verwenden dortfast. - Für ein ganzes Projekt den Standard unter Project settings -> Default Service Tier -> Fast setzen.
| Fast-mode-Modell | Preis pro 1 Mio. (Input / Output) | Latenz-SLA |
|---|---|---|
| GPT-5.6 Sol | $10 / $60 | >80 Tok./s |
| GPT-5.6 Terra | $4 / $24 | >70 Tok./s |
| GPT-5.6 Luna | $0.40 / $2.40 | >100 Tok./s |
Luna hat von den drei Modellen die höchste SLA-Untergrenze. Cache-Lesezugriffe senken die Input-Kosten um 90 % – bei Standard Sol auf $0.50/M und mit einer TTL von ungefähr 30 Minuten. Für alle Tiers ist eine langlebige Session daher günstiger als ständig neue Anfragen. Wer die Tiers mit echtem Traffic testen will, kann über den GPT-5.6 API endpoint alle drei Modelle über eine Schnittstelle nutzen.
FAQ
Ist Ultrafast mode in ChatGPT oder Codex verfügbar?
Nein. Ultrafast startet zunächst in der OpenAI API. Einen Termin für ChatGPT oder Codex nennt die Ankündigung nicht.
Verändert Cerebras bei GPT-5.6 Sol die Ausgabequalität?
OpenAI beschreibt Ultrafast als dasselbe GPT-5.6 Sol mit höherem Tempo, nicht als anderes Modell. Ein von Cerebras gemeldeter 5,6-facher GDP-Val-Speedup ohne Qualitätsverlust ist bislang die einzige Qualitätsbehauptung. Ein unabhängiger Benchmark hat sie noch nicht bestätigt.
Gibt es eine Latenz-SLA für Ultrafast mode?
Nein, es wurde keine veröffentlicht. Fast mode bietet für Enterprise-Kunden eine p50-SLA von >80 Token/s sowie 99,9 % Uptime; für Ultrafast nennt OpenAI während der Vorschau keine SLA.
Welche Modelle unterstützen Ultrafast mode?
Ausschließlich GPT-5.6 Sol. Terra und Luna unterstützen Fast mode, gehören aber nicht zur Ultrafast-Vorschau.
Wie viel wird Ultrafast mode kosten?
Eine offizielle Preisangabe gibt es nicht. Der veröffentlichte Aufschlag von Fast mode auf das Doppelte von Standard Sol ist der einzige Anhaltspunkt.