 AIREITER
MiniMax Music 3.0 ist am 13. August 2026 erschienen – mit offenen Gewichten auf HuggingFace, einer API für 0,15 $ pro Song und der Möglichkeit, bis zu fünfminütige Stücke in einem Durchlauf zu erzeugen. Ein kleiner Stolperstein bleibt: Die Dokumentation zum API-Endpunkt verweist weiterhin auf Music 2.6. Für die lokale Ausführung können außerdem bis zu 24 GB VRAM nötig sein.
Was Music 3.0 neu macht – und warum fünf Minuten zählen
Music 3.0 löst Music 2.6 als von MiniMax empfohlenes Musikmodell ab. Die wichtigste Neuerung ist die maximale Länge von fünf Minuten pro Generierung. Komposition, Arrangement, Performance und Produktion entstehen dabei in einem einzigen Durchlauf. MiniMax will damit eine Schwäche früherer Versionen beheben: Sobald ein Song über den ersten Abschnitt hinausging, verloren Genre, Instrumentierung und Gesang häufig an Konsistenz (offizieller Blog).
| Komponente | Parameter | Aufgabe |
|---|---|---|
| Globales LLM (aus Qwen3.5-8B) | 8B | Erkennt musikalische Struktur und Bedeutung über den gesamten Song hinweg |
| Lokales LLM | 0.6B | Ergänzt feine akustische Details innerhalb jedes Frames |
| Flow Matching + Flow-VAE | 2.4B + 123M | Wandelt verborgene Zustände in kontinuierliches Audio um, statt diskrete Tokens zu verwenden |
Im Kern arbeitet das Modell mit einem achtstufigen Residual-Vector-Quantization-Stack (RVQ). Er trennt die grobe musikalische Struktur – Layer 1 mit einem Codebook aus 16.384 Einträgen – von den feinen akustischen Details der Layer 2 bis 8 mit jeweils 1.024 Einträgen. Das globale LLM behält den Kontext auf Song-Ebene im Blick, während das lokale LLM die akustischen Vorhersagen pro Frame übernimmt. Anschließend rendert der Flow-Matching-Stack das finale Audio aus den zusammengeführten Hidden States, anstatt ausschließlich diskrete Tokens zu dekodieren. Laut Blog soll das die bei früheren KI-Musikmodellen häufigen Hochfrequenzartefakte und starren Phrasierungen reduzieren. Kontrollierte Benchmarks gegen Music 2.6, Suno oder Udio hat MiniMax allerdings nicht veröffentlicht.
API-Preise, Modell-IDs und Rate-Limits
Auf der offiziellen Plattform listet MiniMax zwei Music-3.0-Modell-IDs mit unkomplizierter Abrechnung nach Verbrauch:
| Modell-ID | Preis pro Song | Rate-Limit | Hinweise |
|---|---|---|---|
Music-3.0 | 0,15 $ | 120 RPM | Höhere Limits auf Anfrage beim Vertrieb |
Music-3.0-free | 0 $ | 3 RPM | Kostenlose Teststufe |
Music-3.0 Lyrics-Generierung/-Bearbeitung | 0,01 $ | — | Lyrics automatisch erzeugen oder optimieren |
Beide Modelle erzeugen pro API-Aufruf einen vollständigen Song mit Gesang und einer Länge von bis zu fünf Minuten. Der Endpunkt lautet POST /v1/music_generation – derselbe, den auch Music 2.6 verwendet. Am Tag des Starts enthielten die API-Referenzdocs in ihren indexierten Beispielen allerdings noch music-2.6. Entwickler müssen die ID Music-3.0 daher möglicherweise manuell testen, bis die Dokumentation aktualisiert ist.
Music 3.0 lokal ausführen: ComfyUI und Hardware-Anforderungen
Für besonders viel Aufmerksamkeit in der Community sorgt die Veröffentlichung der Open Weights. Die Gewichte liegen auf HuggingFace unter MiniMaxAI/MiniMax-Music3; eine für ComfyUI optimierte Variante gibt es bei Comfy-Org/MiniMax-Music-3.
Die Model Card dokumentiert drei Hardware-Varianten, die durch erste Berichte aus der Community bestätigt werden:
| Modus | VRAM | Ungefähre Geschwindigkeit | Qualität |
|---|---|---|---|
| Volle Präzision | <24 GB (z. B. RTX 4090) | Am schnellsten | Am besten |
| CPU-Offloading | ~22 GB GPU + mindestens 32 GB RAM | Mittel | Nahezu vollständig |
| Layer-Streaming | 8 GB GPU + mindestens 32 GB RAM | Langsam | Eingeschränkt |
Für den lokalen Start installierst du ComfyUI 0.33.0 oder neuer (bestätigt im ComfyUI-Community-Thread), lädst die Modelldateien aus einem der oben genannten HuggingFace-Repositories herunter, öffnest den ComfyUI-Workflow für MiniMax-Music3, wählst den zur verfügbaren VRAM-Menge passenden Präzisionsmodus und startest die Generierung. Aktuell wird ausschließlich CUDA unterstützt. Für ROCm oder MPS gibt es noch keinen Pfad (laut Community-Berichten). Eine Diffusers-Integration als PR ist in Arbeit und könnte Python-native Inferenz außerhalb von ComfyUI ermöglichen.
Ein Reddit-Nutzer aus r/comfyui berichtete, auf einer AMD RX 7900 GRE (16 GB VRAM, 32 GB RAM) in ungefähr 125 Sekunden 140 Sekunden Country-Musik erzeugt zu haben. Ein weiterer Thread auf r/StableDiffusion brachte die Stimmung in der Community ziemlich direkt auf den Punkt:
„Heute habe ich mich dank Minimax Music von Suno abgemeldet.“ — r/StableDiffusion
Vor dem kommerziellen Einsatz lohnt sich ein genauer Blick auf die Lizenz. Der Blog spricht zwar von „open weights“ und „production-ready“, veröffentlicht aber weder den Lizenztext noch Angaben zur kommerziellen Nutzung oder Weitergabe. Maßgeblich ist die LICENSE-Datei im HuggingFace-Repository. Prüfe sie, bevor du damit Einnahmen erzielende Projekte veröffentlichst.
Music 3.0 richtig prompten: Structured Captions und Abschnitts-Tags
Die zentrale Steuerungsmöglichkeit von Music 3.0 heißt Structured Captions. Dabei beschreibst du detailliert und zeitlich geordnet, was in den einzelnen Songabschnitten passieren soll. Laut offiziellem Blog sollte eine gut strukturierte Caption folgende Punkte enthalten:
- Genre und Subgenre (z. B. „Progressive House / EDM“)
- Tempo und Tonart (z. B. „126 BPM, B-Dur“)
- Instrumentierung (z. B. „hauchartiger männlicher Tenor, Sidechain-Synthesizer, Club-Bass, Hall“)
- Gesangsstil (z. B. „rau klingender Tenor mit Falsett-Passagen“)
- Emotionale Entwicklung (z. B. „luftige Strophe, die sich zu einem energiegeladenen Refrain steigert“)
- Produktionscharakter (z. B. „Vintage-Raummikrofonierung“, „glänzende Keys“)
Für die Lyrics kommen die üblichen Abschnitts-Tags zum Einsatz, die von den meisten Musik-KI-Modellen verstanden werden:
[intro]
[verse]
[pre-chorus]
[chorus]
[bridge]
[instrumental]
[solo]
[outro]
Ein Prompt Enhancement System kann einfache Wünsche wie „fröhlicher Popsong mit weiblichem Gesang“ automatisch in das ausführliche Structured-Caption-Format und die passende Fachsprache der Musikproduktion überführen. Auch ohne musikalisches Spezialwissen lässt sich so vergleichsweise präzise arbeiten. Instrumentalstücke funktionieren ohne Lyrics; für Songs mit Gesang brauchst du entweder eigene Lyrics oder den Lyrics-Optimierer für 0,01 $ pro Song.
MiniMax Music 3.0 im Vergleich zu Suno und Udio
Die entscheidende Frage lautet: Lohnt sich MiniMax für 0,15 $ pro Song – oder ist ein Abo bei einem etablierten Anbieter die bessere Wahl?
| Funktion | MiniMax Music 3.0 | Suno | Udio |
|---|---|---|---|
| Maximale Songlänge | 5 Min. | ~4 Min. | ~2–4 Min. |
| Preismodell | 0,15 $/Song (Pay-as-you-go) | 10 $/Monat Pro (500 Songs) | 10 $/Monat Standard (~600 Songs) |
| Kostenlose Option | 3 RPM API + Open Weights | 10 Songs/Tag | Begrenzte Credits |
| Open Weights | Ja (HuggingFace) | Nein | Nein |
| Lokale Ausführung | Ja (ComfyUI) | Nein | Nein |
| Kommerzielle Nutzung | HuggingFace-Lizenz prüfen | In kostenpflichtigen Tarifen enthalten | In kostenpflichtigen Tarifen enthalten |
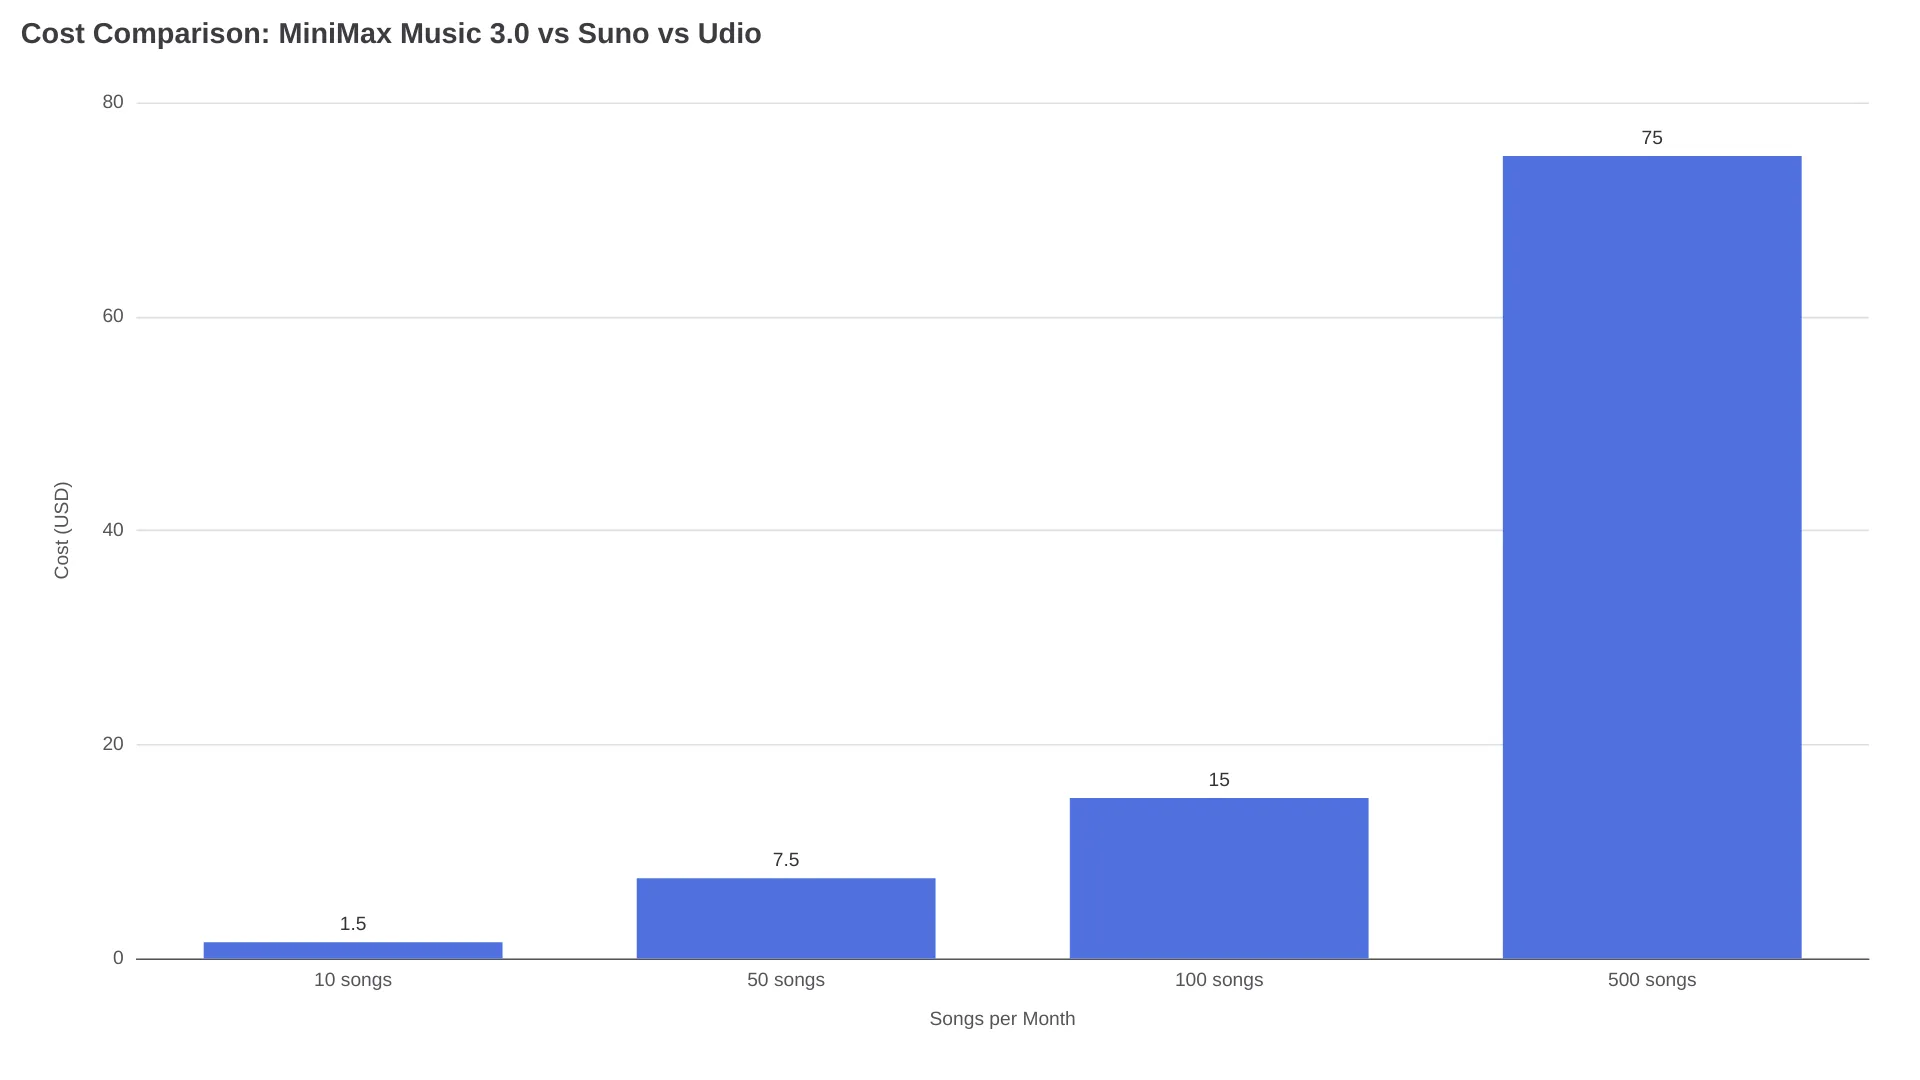
Der Break-even liegt bei ungefähr 67 Songs pro Monat. Darunter ist MiniMax mit 0,15 $ pro Song günstiger als jedes Abo. Oberhalb dieser Schwelle sind Suno Pro oder Udio Standard mit 10 $ pro Monat für mehr als 500 Songs bei den reinen Kosten im Vorteil. Der Joker bleibt jedoch die lokale Ausführung mit Open Weights: Wer die passende GPU bereits besitzt, kann unbegrenzt kostenlos generieren.
Diskussionen auf r/SunoAI und r/comfyui zeichnen Music 3.0 bei Natürlichkeit der Stimmen und Prompt-Treue auf Augenhöhe mit Suno v4. Besonders elektronische Musik und Pop kommen gut an. Bei Rock, Metal und älteren akustischen Stilrichtungen fallen die Reaktionen gemischter aus; einige Nutzer berichten von einem matschigen Klang in dichten Mixes. Die mehrsprachige Unterstützung wirkt vielversprechend: Offizielle Demos zeigen Mandarin und Englisch, aus der Community gibt es zudem Tests mit Bollywood-Rap.
FAQ
Ist MiniMax Music 3.0 kostenlos?
Das API-Modell Music-3.0-free erzeugt Songs kostenlos, allerdings mit einem Limit von 3 RPM. Außerdem kannst du das Modell mit offenen Gewichten über ComfyUI kostenlos lokal ausführen.
Kann Music 3.0 Instrumentalstücke erzeugen?
Ja. Für Instrumentalstücke sind keine Lyrics erforderlich. Bei Gesang brauchst du entweder eigene Lyrics oder den Lyrics-Optimierer für 0,01 $ pro Song.
Wie lautet die API-Modell-ID für Music 3.0?
Music-3.0 (120 RPM, 0,15 $/Song) und Music-3.0-free (3 RPM), beide über POST /v1/music_generation. Beachte, dass die API-Dokumentation auf einigen Seiten noch music-2.6 nennt.
Unterstützt Music 3.0 weitere Sprachen außer Englisch?
Die offiziellen Demos enthalten Mandarin und Englisch. Community-Tests zeigen außerdem erfolgreiche Generierungen auf Hindi (Bollywood-Rap-Test). Eine offizielle Liste der unterstützten Sprachen gibt es nicht.
Darf ich Tracks aus MiniMax Music 3.0 kommerziell nutzen?
Prüfe die HuggingFace-LICENSE-Datei und die Nutzungsbedingungen der API. Der Blog macht keine konkreten Angaben zu kommerziellen Nutzungsrechten.
Wie viel VRAM brauche ich für Music 3.0 lokal?
Unter 24 GB bei voller Präzision, etwa 22 GB mit CPU-Offloading oder 8 GB im Layer-Streaming-Modus. Details findest du in der Hardware-Tabelle weiter oben.
Welche Variante passt zu dir?
| Deine Situation | Empfohlener Weg | Kosten |
|---|---|---|
| Ein paar Songs testen oder prototypisch erstellen | Music-3.0-free API | 0 $ |
| Gelegentliche Produktion (<67 Songs/Monat) | Music-3.0 API | 0,15 $/Song |
| Hohe Generierungsmenge (>67 Songs/Monat) | Suno Pro oder Udio Standard | 10 $/Monat |
| Du besitzt eine 24-GB-GPU und möchtest unbegrenzt kostenlos generieren | Lokales ComfyUI mit HuggingFace-Gewichten | 0 $ (nur Rechenleistung) |
| Du entwickelst eine App zur programmgesteuerten Musikgenerierung | Music-3.0 API über die MiniMax-Plattform | 0,15 $/Song |
Zwei Punkte sind noch offen: Die API-Dokumentation hängt weiterhin bei Music 2.6 hinterher, und die Lizenzbedingungen für die offenen Gewichte sind nicht spezifiziert. Beides dürfte sich mit der weiteren Stabilisierung des Releases klären. Die API lässt sich davon zumindest heute nicht abhalten.