 AIREITER
Für native visuelle Workloads ist GLM-5.3-Flash die bessere Wahl. Bei cache-lastigem Text und Code spricht mehr für DeepSeek V4 Flash – denn am Ende zählen Workload und Abrechnungsweg mehr als ein einzelner Benchmark.
Der Vergleich beginnt bei den Modell-IDs
Verglichen werden GLM-5.3-Flash (glm-5.3-flash) und das Produktionsmodell deepseek-v4-flash von DeepSeek, das auf der offiziellen Preisseite als DeepSeek-V4-Flash-0731 geführt wird. DeepSeek V4 Pro sowie der separate Endpunkt deepseek-v4-flash-vision-exp sind in diesem Vergleich kein Ersatz für das reguläre Flash-Modell. Informationen zur Ox-Alpha-Identität, zu Hardware-Limits und zu den Einschränkungen der Preview gibt es im AIReiter-Test von GLM-5.3-Flash.
Die kurze Antwort nach Workload
| Wenn dir besonders wichtig ist … | Wähle | Warum |
|---|---|---|
| Screenshot-to-Code, UI-Inspektion, Video- oder Dateieingaben | GLM-5.3-Flash | Bild-, Video- und Dateieingaben direkt im selben Modell |
| Textbasierte Massenverarbeitung mit hoher Cache-Trefferquote | DeepSeek V4 Flash | Niedrigere offizielle Preise für Cache-Hits, besonders außerhalb der Spitzenzeiten |
| Viele neue Eingaben und Ausgaben während der GLM-Promotion | GLM-5.3-Flash | Die Aktionspreise für Input und Output liegen unter DeepSeeks offiziellen Preisen für Cache-Misses und Ausgaben |
| Terminal-lastiges Coding mit möglichst konservativer Produktionswahl | DeepSeek V4 Flash | Versionierter Public-Beta-Zugang und offizielle Flash-Evaluierungen |
| Visuelle Browser- oder Computer-Use-Agenten | GLM-5.3-Flash | Visuelles Feedback bleibt direkt im Coding- oder Tool-Use-Loop |
| Ein Textkontext mit 1 Mio. Tokens | Keines von beiden standardmäßig | Beide werben mit Kontexten der 1-Mio.-Token-Klasse; teste den Abruf mit deiner tatsächlichen Prompt-Größe |
| Ein Modell für gemischte Text-, Code- und Bild-Workloads | GLM-5.3-Flash | Für den zentralen multimodalen Workflow ist kein separater Vision-Endpunkt nötig |
Was die offiziellen Spezifikationen tatsächlich sagen
Die Modelldokumentation von Z.AI und die Preisseite von Z.AI beschreiben GLM und die zugehörige Abrechnung. DeepSeeks Dokumentation zu Models & Pricing sowie das Änderungsprotokoll liefern die entsprechenden Angaben zur Flash-Version und ihren Funktionen.
| Spezifikation | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| API-Modell-ID | glm-5.3-flash | deepseek-v4-flash |
| Veröffentlichte Version | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| Kontextfenster | 1 Mio. Tokens | 1 Mio. Tokens |
| Maximale Ausgabe laut offizieller Dokumentation | 128.000 Tokens | 384.000 Tokens |
| Wichtige Eingabetypen | Text, Bilder, Video und Dateien | Text und Code; Vision ist ein separates experimentelles Modell |
| Ausgabe | Text | Text |
| Steuerung des Reasonings | Thinking aktiviert; reasoning_effort wird unterstützt | Thinking- und Non-Thinking-Modus; geringer, hoher und maximaler Aufwand |
| Tools und strukturierte Ausgabe | Function Calling, Streaming, Kontext-Caching und JSON-Ausgabe | Tool-Aufrufe, JSON-Ausgabe, Responses API und Kompatibilität mit der Anthropic API |
| Gewichte | Vom Anbieter veröffentlichte Open Weights | Vom Anbieter veröffentlichte Open Weights |
Die Angaben von 320B Gesamtparametern und 18B aktiven Parametern beschreiben bei GLM eine Sparse-Expert-Architektur, keinen lokal nutzbaren 18B-Checkpoint. Auf der offiziellen Flash-Preisseite veröffentlicht DeepSeek keine vergleichbare Parameterzahl.
GLM verarbeitet visuelle Eingaben direkt im Hauptmodell. DeepSeek bietet dafür separat deepseek-v4-flash-vision-exp an – mit entsprechenden Auswirkungen auf Routing und Tests.
Coding und Agenten erfordern zwei unterschiedliche Tests
Terminal-Agenten müssen Repositories und Tools bedienen. Visuelle Agenten müssen zusätzlich gerenderte Oberflächen und GUI-Zustände interpretieren.
Arbeit im Terminal und am Repository
Die Launch-Tabelle von Z.ai und DeepSeeks offizielles Update vom 31. Juli nennen folgende Ergebnisse:
| Benchmark | GLM-5.3-Flash | DeepSeek V4 Flash | Status der Evidenz |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | Getrennte, von den Anbietern gemeldete Evaluierungen |
| DeepSWE | 63.4 | 54.4 | Getrennte, von den Anbietern gemeldete Evaluierungen |
| Toolathlon Verified | 78.4 | 70.3 | Getrennte, von den Anbietern gemeldete Evaluierungen |
| AutomationBench | 48.8 | 25.1 | Getrennte, von den Anbietern gemeldete Evaluierungen |
| Agents’ Last Exam | 26.3 | 25.2 | Getrennte, von den Anbietern gemeldete Evaluierungen |
In diesen von den Anbietern gemeldeten Benchmarks liegt GLM vorn. Wegen der unterschiedlichen Test-Harnesses sollten die Ergebnisse aber nur die Vorauswahl unterstützen – nicht die Entscheidung allein bestimmen.
Unabhängige Daten zeichnen ein weniger eindeutiges Bild. Composio testete am 27. August 30 mehrstufige Agentenaufgaben. GLM-5.3-Flash erledigte davon 21/30, DeepSeek V4 Flash 20/30. DeepSeek war bei 19 von 30 Aufgaben am schnellsten. Die gemeldeten Kosten pro erfolgreicher Aufgabe lagen bei etwa 0,028 $ für DeepSeek gegenüber etwa 0,06 $ für GLM. Diese Zahlen stammen aus dem Composio-Test, nicht von einem der beiden Anbieter.
Bei stark terminal-lastigen Agenten ist DeepSeek V4 Flash der sinnvollere erste Test, wenn Geschwindigkeit, Reproduzierbarkeit und ein gut begründbarer Produktionspfad im Vordergrund stehen. GLM sollte zusätzlich antreten, wenn die Qualität der ersten Reparatur oder ein breiteres Tool-Verhalten den Vergleich mit den niedrigeren Kosten rechtfertigt.
Tools, Browser-Zustände und visuelles Feedback
Wenn ein Agent prüfen muss, was sein eigener Code tatsächlich erzeugt hat, passt GLM besser zum Produkt. Z.ai beschreibt einen Ablauf, bei dem das Modell Screenshots oder gerenderte Oberflächen liest, die Implementierung anpasst und das Ergebnis erneut kontrolliert. Das ist für Screenshot-to-Code, Frontend-Debugging, Browser-Nutzung, Dokumente und bestimmte 3D-Workflows relevant.
DeepSeek bewältigt text- und codebasierte Agentenaufgaben über deepseek-v4-flash. Visuelle Eingaben erfordern dagegen den separaten Pfad deepseek-v4-flash-vision-exp. Für eine bestehende Pipeline mit eigenem Vision-Routing kann diese Trennung akzeptabel sein. Muss ein Agent dagegen zwischen Quellcode, Browser-Screenshot und Video wechseln, ohne den Endpunkt zu wechseln, ist GLM die sauberere Lösung. Der API-Leitfaden zu DeepSeek V4 Flash Vision Exp erklärt die Alternative.
Was Nutzer nach den Benchmarks berichten
Die Erfahrungsberichte aus der Community deuten eher auf einen Zielkonflikt als auf einen universellen Sieger hin. Ein zweitägiger Erfahrungsbericht beschreibt GLM bei kleineren Kontexten als leistungsfähig, bei wachsenden Prompts aber als weniger souverän – und hebt gleichzeitig die Bildunterstützung hervor:
„Wenn der Kontext größer wird, wirkt das Modell zunehmend nervös und schlampig.“ – @XBToshi über zwei Tage intensiver Nutzung von GLM-5.3-Flash in einem veröffentlichten Vergleich
Das ist anekdotische Evidenz und keine Ausfallquote. Sie weist aber auf eine Schwäche hin, die Benchmark-Tabellen nicht zeigen: Ein großes Kontextlimit garantiert noch kein stabiles Verhalten in mehrstufigen Agentenläufen.
Auch ein kleines Ollama-Experiment fiel bei den anbieterspezifischen Quota-Einheiten zugunsten von DeepSeek aus. Der Autor setzte diese Einheiten allerdings nicht mit API-Kosten in US-Dollar gleich.
Latenz- und Serving-Daten können die Antwort verändern
Für genau diese beiden Modelle gibt es keinen veröffentlichten p50-Latenz- oder Durchsatzvergleich mit identischem Test-Harness. Ergebnisse von Pro, Vision-Exp oder anderen Routen lassen sich daher nicht einfach übertragen. Composio ermittelte DeepSeek bei 19/30 Agentenaufgaben als schnellstes Modell – ein nützlicher Hinweis, aber kein Durchsatzvergleich. Für interaktive Assistenten solltest du die Zeit bis zum ersten nützlichen Tool-Aufruf messen, bei Batch-Jobs die gesamte Zeit bis zum akzeptierten Ergebnis.
Tokenpreis und Kosten pro erledigter Aufgabe sind nicht dasselbe
Die offiziellen Preislisten ergeben ein differenzierteres Bild als die Aussage „DeepSeek ist günstiger“. Z.AI nennt eine 50-prozentige GLM-5.3-Flash-Aktion bis 9. September 2026 um 24:00 UTC+8. DeepSeek unterscheidet bei der Abrechnung zwischen Cache-Hits und Cache-Misses sowie zwischen Spitzen- und Nebenzeiten.
Alle folgenden Angaben verstehen sich in US-Dollar pro 1 Mio. Tokens.
| Abrechnungsposten | GLM-5.3-Flash-Aktion | GLM-5.3-Flash regulär | DeepSeek V4 Flash außerhalb der Spitzenzeit | DeepSeek V4 Flash Spitzenzeit |
|---|---|---|---|---|
| Neue Eingabe/Cache-Miss | $0.075 | $0.15 | $0.22 | $0.44 |
| Cache-Hit | $0.015 | $0.03 | $0.007 | $0.014 |
| Ausgabe | $0.25 | $0.50 | $0.66 | $1.32 |
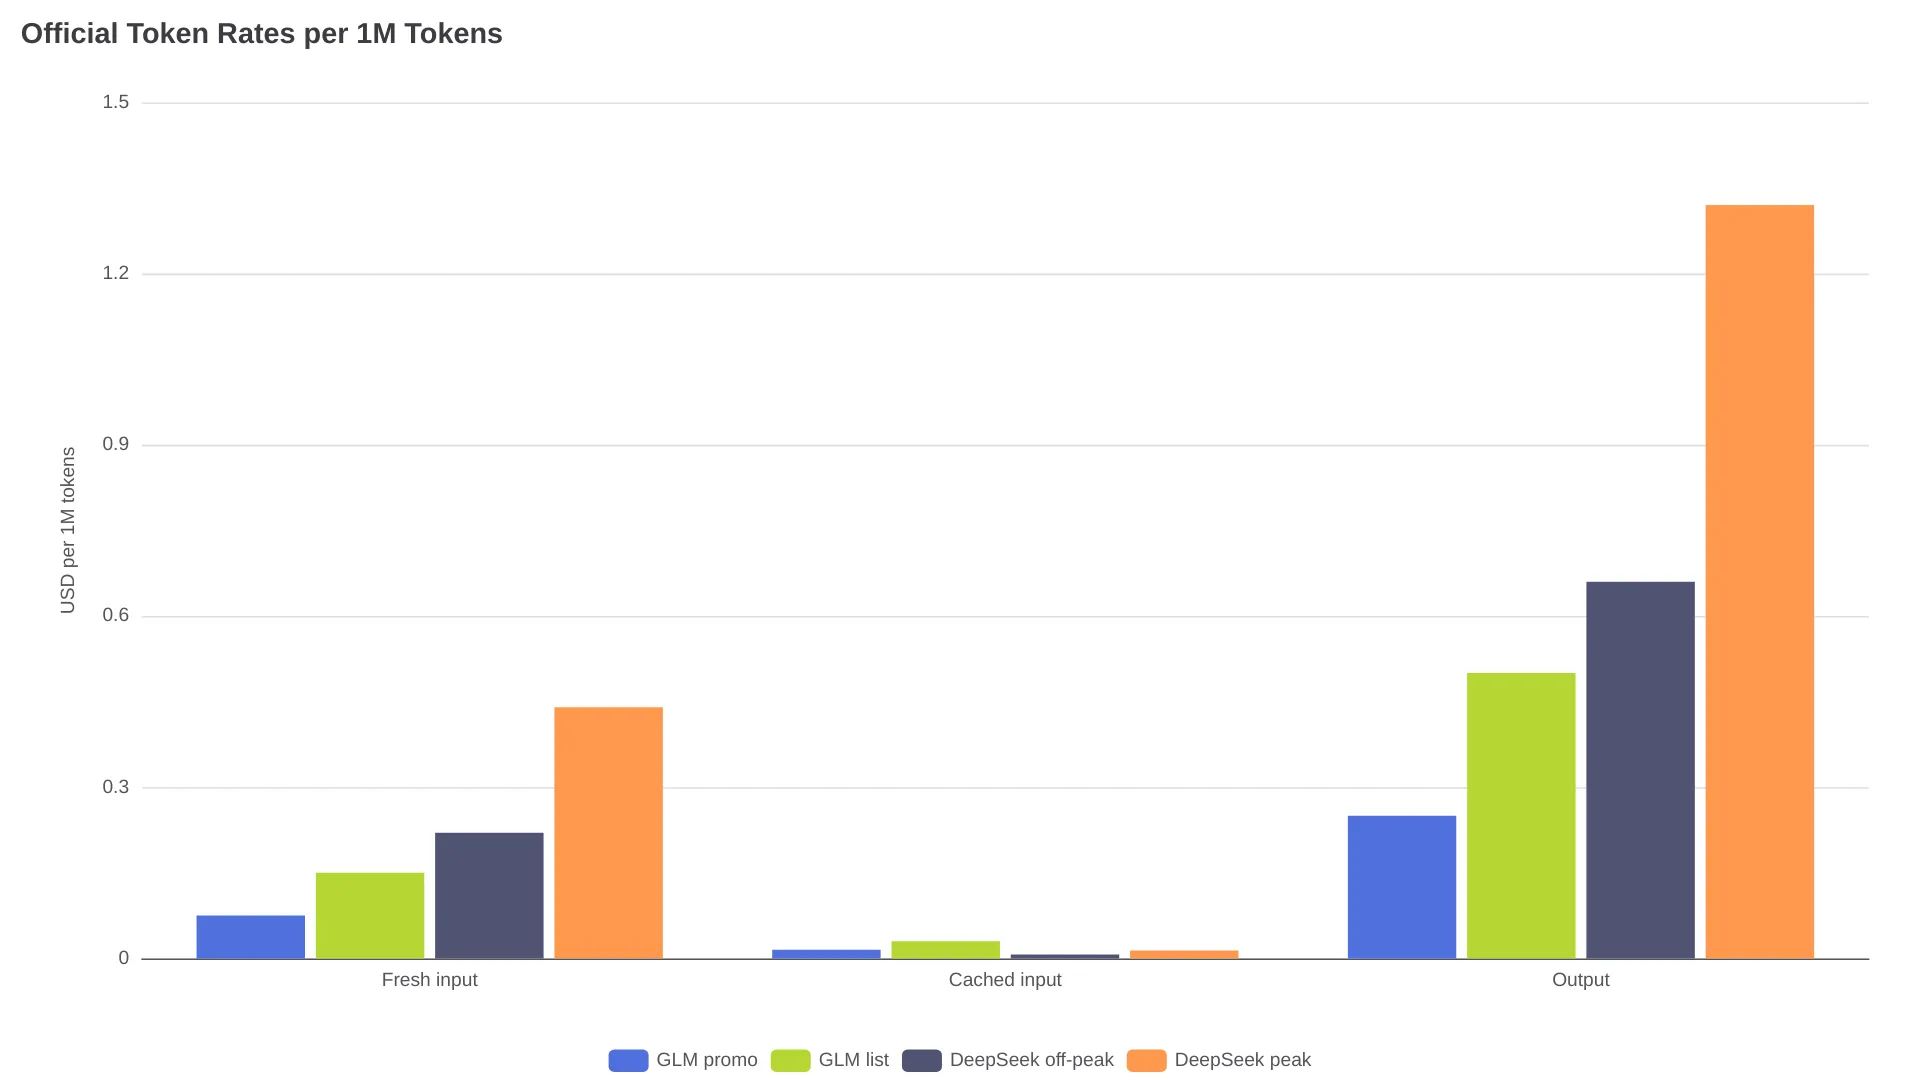
DeepSeeks Spitzenzeiten liegen montags bis freitags von 01:00–04:00 UTC und 06:00–10:00 UTC; alle übrigen Zeiten gelten als Nebenzeiten. Die offizielle Tabelle nennt für V4 Flash außerdem eine Parallelität von 2.500. Auf der Preisseite von GLM wird für das Caching von Eingaben eine zeitlich begrenzte kostenlose Speicherung aufgeführt, aber keine allgemeingültige Zahl zur Parallelität.
- Beim Preis für Cache-Hits liegt DeepSeek vorn – in jedem vergleichbaren Zeitraum.
- Bei neuen Eingaben und Ausgaben gewinnt GLM während der Aktion gegenüber DeepSeeks offiziellen Preisen für Cache-Misses und Ausgaben.
- Auch nach Ende der Aktion liegen GLMs reguläre Preise für neue Eingaben und Ausgaben unter DeepSeeks veröffentlichten Nebenzeiten-Preisen.
- DeepSeeks stärkstes Preisargument ist ein cache-lastiger, input-dominierter Workload mit kurzen Ausgaben, der sich möglichst in die Nebenzeiten verschieben lässt.
Beispiel mit 10 Mio. Input- und 2 Mio. Output-Tokens
Angenommen werden 10 Mio. neue Input-Tokens und 2 Mio. Output-Tokens, ohne Tool-Gebühren und Wiederholungsversuche:
| Modell und Abrechnungspfad | Berechnung | Gesamtkosten |
|---|---|---|
| GLM-Aktion | 10 × $0.075 + 2 × $0.25 | $1.25 |
| GLM regulär | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek Nebenzeit, Cache-Miss | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek Spitzenzeit, Cache-Miss | 10 × $0.44 + 2 × $1.32 | $7.04 |
Wenn alle 10 Mio. Input-Tokens Cache-Hits sind, sinken die Kosten bei DeepSeek außerhalb der Spitzenzeit auf $1.39 (10 × $0.007 + 2 × $0.66). Bei GLM während der Aktion wären es $0.65 (10 × $0.015 + 2 × $0.25). Je höher das Verhältnis von Input zu Output und je kürzer die Ausgabe, desto wichtiger wird DeepSeeks Cache-Vorteil.
Wann DeepSeeks niedrigere Rechnung entscheidend ist
DeepSeek V4 Flash ist die richtige Wahl, wenn die meisten Anfragen ein langes, stabiles System- oder Repository-Präfix wiederverwenden, kurze Antworten erzeugen und außerhalb der Spitzenzeiten laufen können. Klassifikation, Extraktion, Zusammenfassung und routinemäßige textbasierte Automatisierung passen besser in dieses Muster als screenshot-gesteuerte Agenten.
Wann GLMs zusätzliche Fähigkeiten insgesamt günstiger sein können
GLM kann die Pipeline-Kosten senken, wenn ein Bild, Dokument oder Video andernfalls eine separate Vision-Anfrage erfordern würde. Für Agenten mit langen Code-Patches ist außerdem der Aktionspreis für Ausgaben relevant. Diese Annahme sollte anhand tatsächlich abgerechneter Tokens, Reparaturschleifen und der Quote akzeptierter Aufgaben geprüft werden – nicht mit einem pauschalen Kosten-pro-Aufgabe-Vorteil.
Ein langer Kontext ist eine Kapazitätsangabe, keine Qualitätsgarantie
Beide offiziellen Dokumentationen nennen ein Kontextfenster von 1 Mio. Tokens. Bei der reinen Kontextgröße herrscht daher Gleichstand. DeepSeek nennt eine maximale Ausgabe von 384.000 Tokens; in der Modelldokumentation von Z.AI stehen für GLM-5.3-Flash maximal 128.000 Tokens. Relevant ist dieser Unterschied nur für Anwendungen, die ungewöhnlich lange Ausgaben zulassen.
Z.ai meldet im Vergleich zu GLM-5.3 eine 3,01-fach niedrigere Attention-Berechnung und eine 4,44-fach kleinere KV-Cache-Größe. Gleichzeitig weist der Anbieter darauf hin, dass GLMs KV-Cache weiterhin etwas größer als der von DeepSeek V4 Flash ist. Diese Angaben des Anbieters belegen weder einen Latenz- noch einen Qualitätsvorteil beim Retrieval gegenüber DeepSeek.
Teste Retrieval, Tool-Abschluss und die Quote akzeptierter Aufgaben bei 50K, 200K und deiner tatsächlichen maximalen Prompt-Größe. Verwende dabei die im folgenden Gate definierte Annahmeregel.
Eine Standardwahl treffen – oder beide Modelle routen
| Workload | Als Erstes testen | Fallback oder Eskalation |
|---|---|---|
| Textbasierte Klassifikation und Extraktion | DeepSeek V4 Flash | GLM, wenn Formatierung oder Qualität nicht ausreichen |
| Repository-Chat mit hohem Cache-Anteil | DeepSeek V4 Flash | GLM für schwierige Reparaturschritte |
| Terminal-Coding-Agent | DeepSeek V4 Flash | GLM, wenn die erste Ausführung möglichst oft funktionieren soll |
| Screenshot-to-Code | GLM-5.3-Flash | DeepSeek für rein textbasierte Nacharbeiten |
| Browser- oder Computer-Use-Agent | GLM-5.3-Flash | DeepSeek für nicht visuelle Planungsschritte |
| Analyse von Video, Bildern oder Dateien | GLM-5.3-Flash | DeepSeek Vision Exp, wenn ein separater Pfad akzeptabel ist |
| Langer Text mit kurzer Ausgabe | DeepSeek V4 Flash | GLM, wenn die Retrieval-Qualität nachlässt |
| Lange Codegenerierung während der Aktion | GLM-5.3-Flash | DeepSeek, wenn die Cache-Hit-Ökonomie dominiert |
Bevor du einen Produktions-Workload umstellst, solltest du ein kleines Gate mit identischem Test-Harness durchführen:
- Fixiere die exakten IDs:
glm-5.3-flashunddeepseek-v4-flash. Ein Router darf nicht unbemerkt Pro oder Vision-Exp einsetzen. - Verwende 20–50 reale Aufgaben, darunter erfolgreiche Jobs und aktuelle Fehlerfälle. Bei agentischen Produkten sollten mindestens fünf Tool-Use-Aufgaben enthalten sein.
- Erfasse Erfolgsquote, Reparaturschleifen, ausgelassene Tool-Aufrufe, Zeit bis zur ersten nützlichen Aktion, gesamte Input-/Output-Token und Cache-Hit-Quote.
- Vergleiche die Kosten pro akzeptierter Aufgabe. Behalte das jeweils andere Modell als Fallback, bis Timeout- und Fehlerquoten stabil sind.
Der Quick Start von Z.AI und DeepSeeks Anleitung für den ersten API-Aufruf beschreiben den OpenAI-kompatiblen Zugang. Reasoning-Steuerung, Vision-Routen und Abrechnungslogik sind bei den beiden Anbietern jedoch nicht identisch.
Fragen, die Käufer weiterhin stellen
Ist GLM-5.3-Flash dasselbe Modell wie Ox Alpha?
Z.ai hat GLM-5.3-Flash offiziell als das Modell identifiziert, das der Anbieter zuvor anonym als Ox Alpha getestet hatte. Preview-Routing, Quoten und Verhalten der Endpunkte sollten trotzdem nicht als dauerhafte Spezifikationen des öffentlichen Modells betrachtet werden.
Nutze die Routing-Tabelle und überprüfe die Standardwahl anschließend mit fixierten IDs, realen Fehlerfällen und demselben Test-Harness. Der Test von GLM-5.3-Flash behandelt Identität und Deployment-Evidenz; der API-Leitfaden zu DeepSeek V4 Flash Vision Exp erklärt den separaten visuellen Pfad.