 AIREITER
Mit dem deepseek-v4-flash-vision-exp-Endpoint bekommt die V4-Flash-Reihe Unterstützung für Bildeingaben. Das entscheidende Detail steckt jedoch im Namen: experimental. Die bisher veröffentlichten Startdaten belegen keine Produktionsreife. Wer das Modell einsetzen möchte, sollte deshalb zunächst einen protokollierten Pilotbetrieb mit Fallback aufsetzen, statt es direkt zum Standard-Backend zu machen.
Die API-Entscheidung in 30 Sekunden
DeepSeek V4 Flash Vision Exp passt gut zu bestehenden V4-Flash-Workflows, die zusätzlich Screenshots, Diagramme, Dokumente oder andere Bilder per API auswerten müssen. Bei visuellen Entscheidungen mit Identitätsbezug oder hohem Risiko sollte jedoch immer ein Fallback bereitstehen und die konkrete Aufgabe separat validiert werden.
| Situation | Geeignete Eingabemethode | Warum |
|---|---|---|
| Kleines lokales Bild für eine einmalige Anfrage | Base64-Daten-URL | Kein öffentliches Hosting erforderlich |
| Bild ist bereits öffentlich erreichbar | Externe URL | Kleiner Request-Payload |
| Großes Bild oder wiederholte Nutzung | Files API mit file_id | Upload lässt sich wiederverwenden; pro referenziertem Bild sind bis zu 64 MiB möglich |
| Für eine grobe Aufgabe soll der Detailgrad sinken | detail: "low" | Skaliert das Bild vor der Inferenz auf 512 x 512 herunter |
Der exakte Modellname lautet deepseek-v4-flash-vision-exp. DeepSeek führt das Modell als experimentell und nennt den 21. August 2026 als Verfügbarkeit auf der API-Plattform – nachzulesen im offiziellen Changelog. Laut Release-Hinweis entspricht die Leistung bei reinen Textaufgaben V4 Flash; bei Agenten-Benchmarks, die visuelles Verständnis voraussetzen, soll es zudem deutliche Verbesserungen geben.
Ein Bild per Chat Completions senden
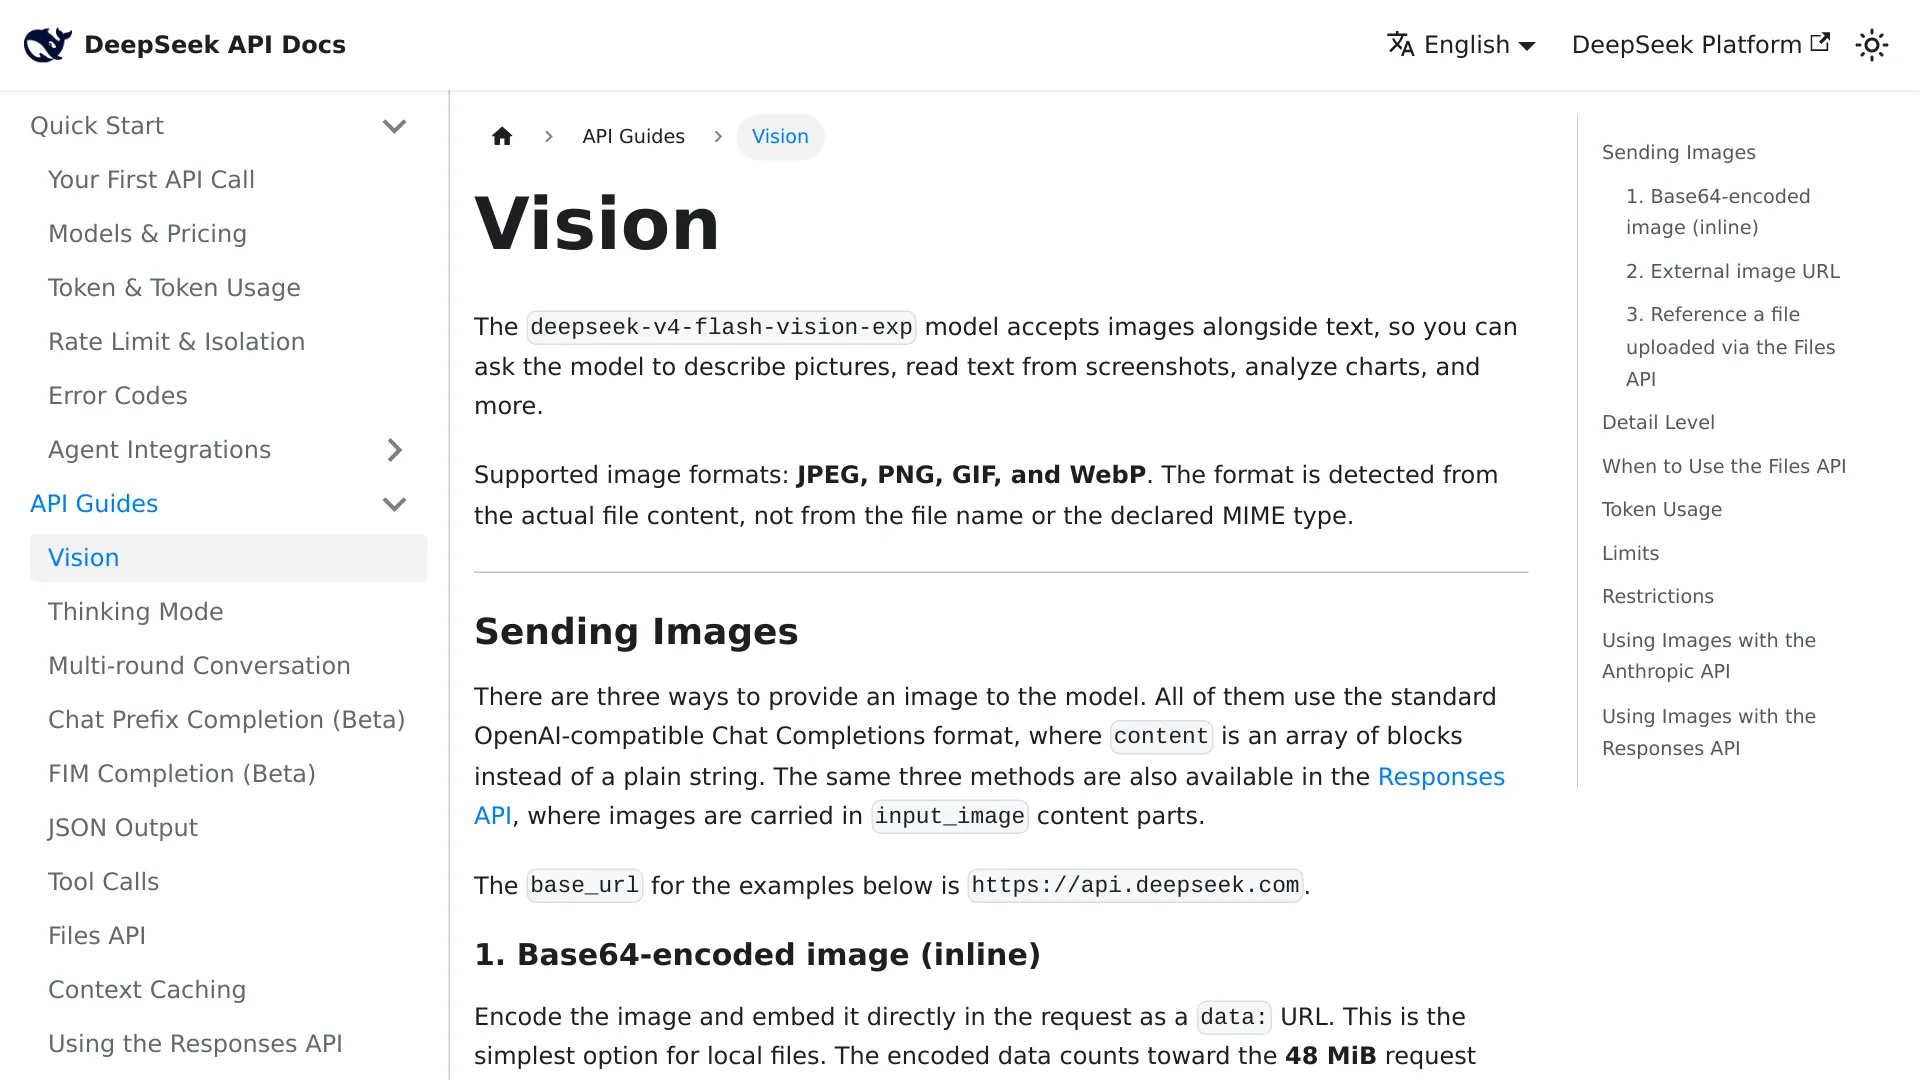
Beim OpenAI-kompatiblen Chat-Completions-Format stehen Text und Bild gemeinsam in einem content-Array innerhalb einer user-Nachricht. Der offizielle Vision-Leitfaden beschreibt das genaue Verhalten für dieses Modell. Wer ein Bild an das normale deepseek-v4-flash schickt, erhält einen 400-Fehler.
import base64
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

with open("chart.png", "rb") as image_file:
    encoded = base64.b64encode(image_file.read()).decode("utf-8")

response = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Extract the three trends from this chart."},
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{encoded}",
                        "detail": "original",
                    },
                },
            ],
        }
    ],
)

print(response.choices[0].message.content)
Bilder werden bei Chat Completions in user-Nachrichten unterstützt. Bild und Anweisung sollten im selben Content-Array stehen, damit das Modell visuellen Kontext und konkrete Aufgabe gemeinsam erhält.
Den passenden Bild-Transport wählen
Base64 für kleine lokale Dateien
Für ein lokales Bild, das nur einmal verarbeitet wird, ist Base64 der unkomplizierteste Weg. Öffentliches Hosting entfällt. Allerdings zählt die kodierte Datei zum Limit von 48 MiB für den Request-Body, während das Ausgangsbild höchstens 32 MiB groß sein darf.
Das eignet sich für einzelne Uploads von Nutzern oder Workern, nicht für Bilder, die in einer ganzen Batch-Verarbeitung mehrfach verwendet werden.
Öffentliche URL für gehostete Assets
Öffentliche http- oder https-URLs halten den Request klein. Sie müssen erreichbar sein, dürfen höchstens 8.192 Zeichen lang sein, innerhalb von 60 Sekunden heruntergeladen werden können und maximal 32 MiB umfassen. Private, abgelaufene oder nur intern erreichbare URLs können bereits beim Abruf durch DeepSeek scheitern.
Files API für Wiederverwendung und größere Dateien
Das Bild wird zunächst über die Files API hochgeladen. Anschließend verweist die Vision-Anfrage auf die zurückgegebene ID:
{
  "type": "file",
  "file_id": "file-api-xxxxxxxxxxxxxxxx"
}
Eine referenzierte Datei darf pro Bild bis zu 64 MiB groß sein. Außerdem müssen dieselben Bytes nicht bei jeder Anfrage erneut übertragen werden. Dafür kommt ein zusätzlicher Upload- und Lifecycle-Schritt hinzu. Die zurückgegebene ID sollte zusammen mit dem Schlüssel gespeichert werden, der sie erstellt hat – sie ist kein öffentlich teilbarer Link.
Die Files API ist besonders praktisch, wenn eine Datei größer als 32 MiB ist, der Request die Grenze von 48 MiB überschreiten könnte oder mehrere Agenten-Schritte dasselbe Bild untersuchen sollen.
Den visuellen Detailgrad vor der Abrechnung festlegen
Das Feld detail steht für image_url-Eingaben und Bildteile der Responses API zur Verfügung. Das folgende Verhalten entspricht dem offiziellen Vision-Leitfaden von DeepSeek.
| Wert | Dokumentiertes Verhalten | Geeignet, wenn |
|---|---|---|
low | Skaliert auf 512 x 512 herunter | Layout, grobe Szene oder eine grobe Klassifizierung ausreichen |
high | Behält das Originalbild bei | Kleiner Text oder feine Details wichtig sind |
original | Behält das Originalbild bei | Die Verarbeitung ausdrücklich mit voller Detailstufe erfolgen soll |
auto | Entspricht derzeit original | Das aktuelle Standardverhalten akzeptabel ist |
DeepSeek skaliert Bilder vor der Inferenz. Laut Vision-Leitfaden ist jedes Bild auf 384 Bild-Token begrenzt; mehrere Bilder werden unabhängig voneinander gezählt. Ein sehr großes Ausgangsbild verbraucht nach der Skalierung daher nicht zwingend proportional mehr Bild-Token. Große Dateien können trotzdem an Upload- oder Request-Größenlimits scheitern.
Auf der offiziellen Seite zu Modellen und Preisen wird deepseek-v4-flash-vision-exp mit denselben Tokenpreisen wie V4 Flash geführt: $0.007 pro 1M gecachte Input-Token und $0.22 pro 1M Input-Token bei Cache-Misses außerhalb der Spitzenzeiten; zu Spitzenzeiten sind es $0.014 beziehungsweise $0.44. Für Output werden außerhalb der Spitzenzeiten $0.66 und zu Spitzenzeiten $1.32 berechnet. Bild-Token zählen als Input-Token. Bildanzahl und Detailstufe gehören deshalb in jede realistische Kostenkalkulation.
Limits, die in der Praxis API-Fehler auslösen
| Beschränkung | Limit oder Verhalten |
|---|---|
| Unterstützte Formate | JPEG, PNG, GIF, WebP |
| Maximale Request-Größe | 48 MiB |
| Maximales Base64- oder URL-Bild | 32 MiB |
Maximales Bild per Files-API-file_id | 64 MiB |
| Maximale Bildanzahl pro Request | 600 |
Gesamtgröße ohne Bilder per file_id | 64 MiB |
Gesamtgröße einschließlich Bildern per file_id | 200 MiB |
| Maximale Abmessung | 8.192 Pixel pro Seite |
| Abmessungslimit bei 15 oder mehr Bildern | 4.096 Pixel pro Seite |
| Länge externer URLs | 8.192 Zeichen |
| Download externer Bilder | Muss innerhalb von 60 Sekunden abgeschlossen sein |
Zwei Einschränkungen werden leicht übersehen: Nur deepseek-v4-flash-vision-exp akzeptiert Bilder, und Bildblöcke in system- oder assistant-Nachrichten schlagen bei Chat Completions fehl. Wird ein Bild an ein Modell ohne Vision-Unterstützung gesendet, dokumentiert DeepSeek die 400-Fehlermeldung This model does not support image.
Dasselbe Modell über drei API-Schnittstellen
DeepSeek beschreibt das Modell in seinem Vision-Leitfaden für drei Schnittstellen:
| Schnittstelle | Bildblock | Ergebniszugriff |
|---|---|---|
| Chat Completions | image_url in einem User-Content-Array | response.choices[0].message.content |
| Responses API | input_image zusammen mit input_text | response.output_text |
| Anthropic-kompatible API | image unter https://api.deepseek.com/anthropic | Anthropic-Message-Content |
Alle drei Varianten unterstützen Base64, öffentliche URLs und Referenzen auf die Files API. Die Content-Typen unterscheiden sich jedoch. Der Block für Chat Completions lässt sich daher nicht unverändert in die Responses API kopieren.
Was die Launch-Daten zeigen – und was nicht
Im Changelog vom 21. August nennt DeepSeek starke Benchmark-Ergebnisse, darunter 83.9 bei Terminal Bench 2.1 und 64.3 bei Chartography auf p0.95. Das sind vom Anbieter gemeldete Werte, keine unabhängige Reproduktion. Außerdem weist der Release-Hinweis darauf hin, dass das reine Textmodell V4 Flash multimodale Elemente in zwei visuellen Evaluationen ignoriert.
Die Benchmark-Ergebnisse zum Launch stammen also vom Anbieter. Bevor Produktions-Traffic über das Modell läuft, sollten die für die eigene Anwendung relevanten visuellen Aufgaben mit realen Daten geprüft werden.
Ist der Einsatz in der Produktion sinnvoll?
Für einen kontrollierten Pilotbetrieb eignet sich DeepSeek V4 Flash Vision Exp etwa zur Screenshot-Analyse, Diagrammextraktion, Dokumentvorsortierung oder für Agenten, die visuelle Zustände untersuchen müssen. Die Preise auf V4-Flash-Niveau und drei verschiedene Wege für Bildeingaben machen die Evaluierung günstig. Auch die Obergrenze von 384 Token pro Bild liefert einen konkreten Ausgangspunkt für die Kostenplanung.
Als einziges Backend für Identitätsprüfungen, Sicherheitsentscheidungen, medizinische Interpretationen oder andere visuelle Bewertungen mit hohen Konsequenzen sollte das Modell jedoch nicht eingesetzt werden, solange es experimentell bleibt und die genannten Launch-Daten keine Zuverlässigkeit für solche Fälle belegen. Ein Fallback sollte hinter derselben Schnittstelle bereitstehen. Außerdem gehören Bildquelle, detail-Einstellung, Input- und Output-Nutzung, Latenz, Retries und Aufgabenerfolg ins Monitoring.
Vor der Weiterleitung von Produktions-Traffic sollten mindestens diese Fälle getestet werden:
- Kleiner Text in Screenshots mit den Detailstufen
lowundoriginal. - Diagramme mit Beschriftungen, Legenden und dicht beschrifteten Achsen.
- Mehrere Bilder in einer Anfrage.
- Private und langsame Bild-URLs.
- Tool-Aufrufe nach der visuellen Analyse.
- Falsche oder mehrdeutige Identitäts-Prompts.
- Fallback-Verhalten nach einem 400-Fehler, Timeout oder einer fehlerhaften Bildantwort.
DeepSeek V4 Flash Vision Exp API: Häufige Fragen
Wie lautet der exakte Modellname?
Verwende deepseek-v4-flash-vision-exp. Im Changelog vom 21. August 2026 bezeichnet DeepSeek das Modell als experimentelles multimodales Modell auf der API-Plattform.
Wird es wie V4 Flash abgerechnet?
Ja. Auf der Preisseite nennt DeepSeek für Vision Exp und V4 Flash dieselben Tokenpreise für Cache-Hits, Cache-Misses und Output. Bild-Token werden als Input-Token abgerechnet; nach der Skalierung sind bis zu 384 Bild-Token pro Bild möglich.
Kann das Modell Bilder erzeugen?
Der offizielle Vision-Leitfaden beschreibt Bildverständnis, nicht Bildgenerierung. Solange DeepSeek keine separate Unterstützung für die Generierung veröffentlicht, sollte dieser Endpoint ausschließlich zur Analyse von Bildern betrachtet werden.
Warum liefert mein Request einen 400-Fehler?
Prüfe Modellnamen, Nachrichtenrolle, Content-Block-Typ, Dateigröße und Bildformat. Bilder an ein Modell ohne Vision-Unterstützung oder in nicht unterstützten Nachrichtenrollen können den dokumentierten Fehler This model does not support image auslösen.