 AIREITER
Bevor der Name offiziell bekannt war, kursierte das anonyme Modell als Ox Alpha. Nun hat Z.ai diesem Experiment eine öffentliche Identität gegeben: GLM-5.3-Flash. Die Auflösung ist relevant, doch die Bezeichnung „Flash“ sollte man nicht falsch verstehen: Pro Token werden 18B Parameter aktiviert, der veröffentlichte Checkpoint umfasst aber rund 320B Parameter und stellt lokal weiterhin erhebliche Hardware-Anforderungen.
Kurz gesagt: Ox Alpha war die Vorschau auf GLM-5.3-Flash
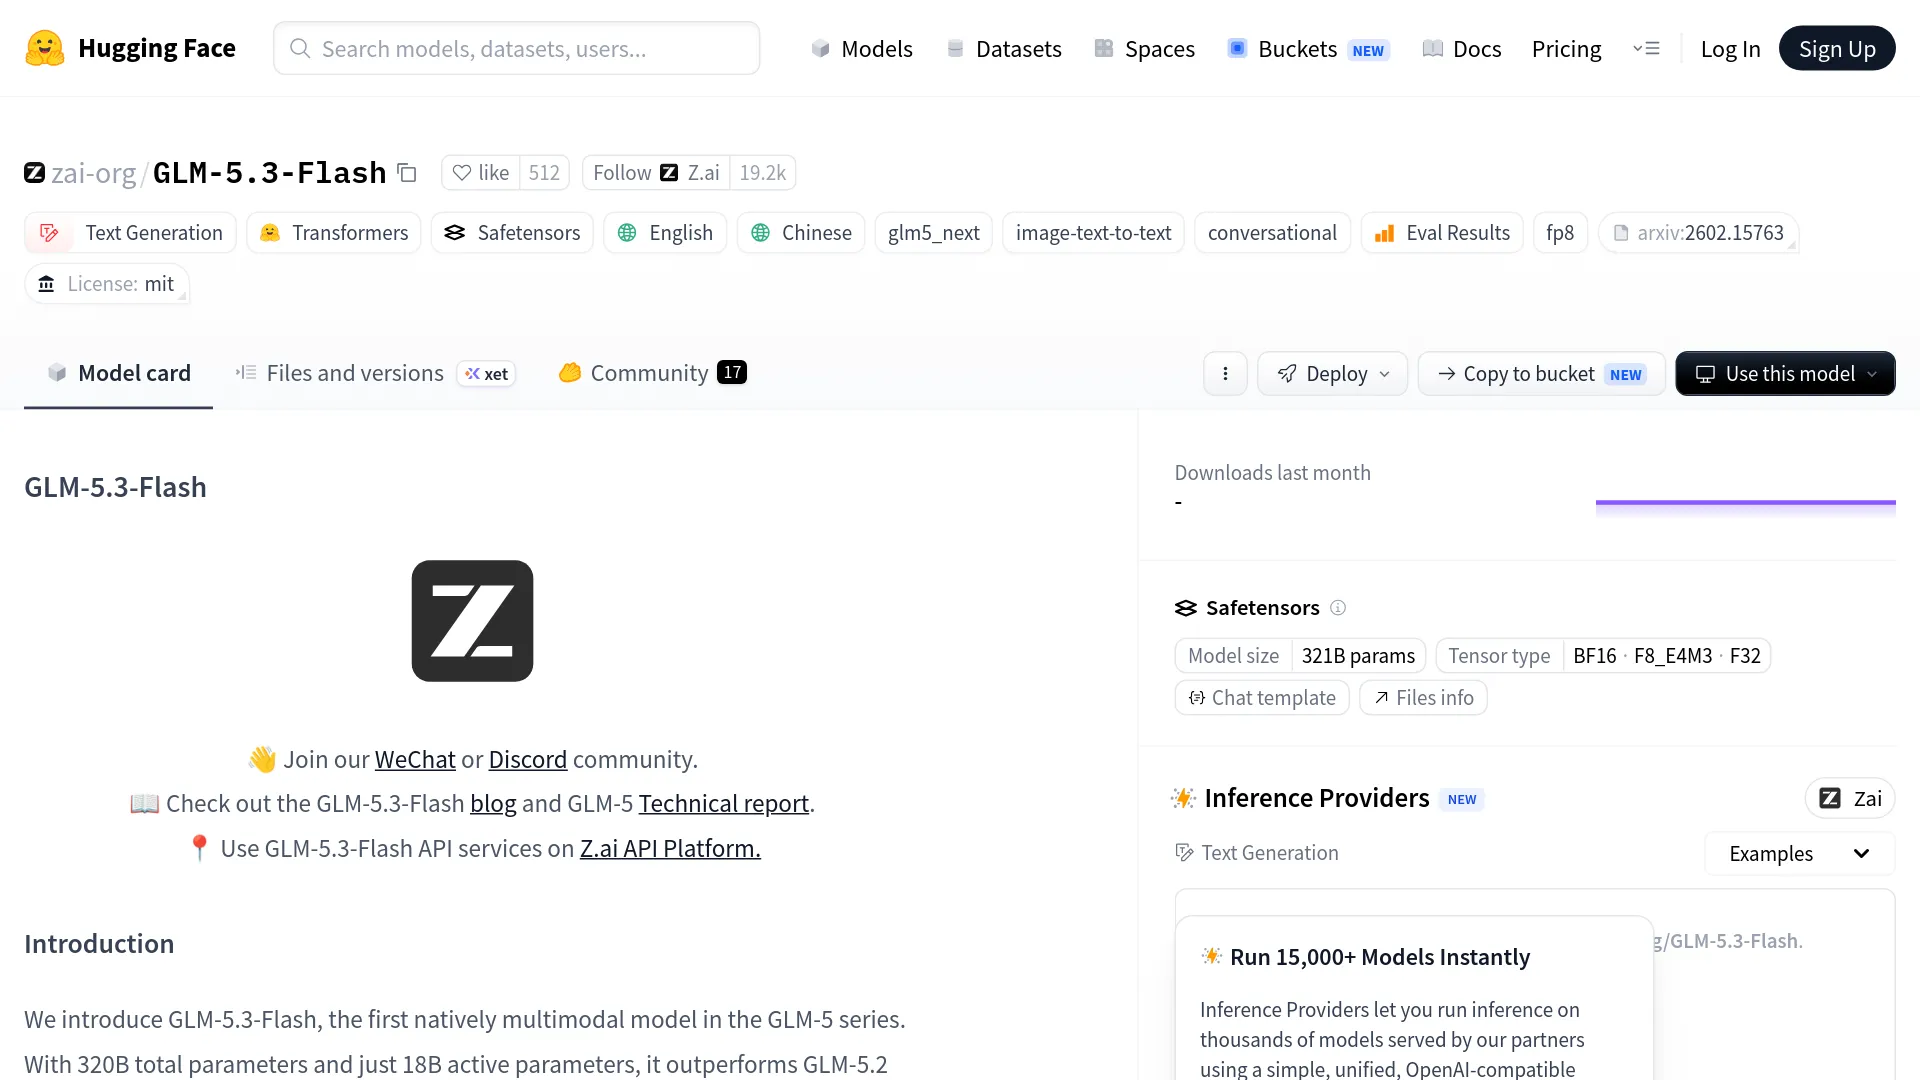
In der Ankündigung vom 26. August 2026 bestätigt Z.ai, dass GLM-5.3-Flash zuvor anonym als Ox Alpha auf OpenCode und OpenRouter getestet wurde. Die offizielle Model Card auf Hugging Face führt inzwischen den öffentlichen Checkpoint, die MIT-Lizenz, multimodale Eingaben und Hinweise zum lokalen Betrieb auf.
Berichte über Ox Alpha sollte man als Hinweise aus der Vorschau und nicht als endgültige Spezifikationen des veröffentlichten Modells verstehen. Ox Alpha lief unter eigenen Routing-, Traffic- und Betriebsbedingungen. Frühe Angaben zu Geschwindigkeit, Kontingenten und Richtlinien müssen daher nicht für jeden GLM-5.3-Flash-Endpunkt gelten.
„Für mich hat sich nichts geändert. Beide Modelle sind für mein System mit 32 GB RAM viel zu groß.“ — u/dampflokfreund in r/LocalLLaMA
GLM-5.3-Flash im Überblick
| Spezifikation | GLM-5.3-Flash |
|---|---|
| Offizielle Veröffentlichung | 26. August 2026 |
| Früherer Vorschau-Name | Ox Alpha / ox-alpha |
| Modellaufbau | 320B Parameter insgesamt, 18B pro Token aktiv |
| Kontextfenster | 1.048.576 Token (1M) |
| Eingabe | Text, Bilder und Video |
| Ausgabe | Text |
| Lizenz | MIT |
| Offizieller Checkpoint | zai-org/GLM-5.3-Flash |
| Ausgewiesener API-Preis für Eingaben | $0.15 pro 1M Token |
| Ausgewiesener Preis für gecachte Eingaben | $0.03 pro 1M Token |
| Ausgewiesener API-Preis für Ausgaben | $0.50 pro 1M Token |
Auf der Hugging-Face-Seite wird eine gespeicherte Modellgröße von rund 321B Parametern angegeben, während die Modellbeschreibung die Kurzform 320B-A18B verwendet. Die Angaben beziehen sich jeweils auf die gesamte gespeicherte Kapazität beziehungsweise die pro Token aktive Berechnung. 18B aktive Parameter machen aus dem Checkpoint also kein lokales 18B-Modell.
Was sich zwischen Ox Alpha und dem öffentlichen Modell geändert hat
Z.ai zufolge wurde GLM-5.3-Flash vor der öffentlichen Veröffentlichung anonym als Ox Alpha betrieben. Über OpenCode und OpenRouter sammelte das Unternehmen Feedback aus realen Nutzungsszenarien. Der OpenRouter-Eintrag zeigte die Vorschau als multimodales Modell mit langem Kontext und einem vorübergehenden Preis von $0. Mit dem öffentlichen Release sind nun Anbieter, Checkpoint und Lizenz eindeutig zuordenbar.
Vorschau und veröffentlichtes Modell bleiben dennoch unterschiedliche Betriebsumgebungen. Ein identischer Tokenizer oder ein GLM-typischer API-Fehler kann die gemeinsame Herkunft stützen, beweist aber nicht, dass jede anonyme Anfrage mit den finalen Gewichten oder über dieselbe Routing-Schicht verarbeitet wurde. Für Bereitstellung und reproduzierbare Tests ist jetzt der öffentliche Checkpoint die maßgebliche Referenz.
Die Architektur hinter dem „Flash“-Namen
GLM-5.3-Flash kombiniert eine sparsame Mixture-of-Experts-Architektur mit Änderungen an der Attention, die den Aufwand bei sehr langen Kontexten senken sollen. Z.ai nennt 320B Parameter insgesamt, 18B aktive Parameter, 45 Layer, eine hybride Sparse- und Linear-Attention, IndexPool für den Abruf sowie Manifold-Constrained Hyper-Connections (mHC). Laut Model Card wurde das Modell außerdem mit einem multimodalen Pretraining-Korpus aus 30T Token trainiert.
Z.ai gibt im Vergleich zu GLM-5.3 bei einem Kontext von 1M eine dreimal geringere Attention-Berechnung und einen 4,4-mal kleineren KV-Cache an. Das sind Angaben des Anbieters zur Architektur und keine hardwareunabhängige Garantie für die Latenz. Die tatsächliche Geschwindigkeit hängt weiterhin von Kontextlänge, Parallelität, visueller Vorverarbeitung und dem eingesetzten Serving-Stack ab.
Die native Multimodalität ist für Agenten interessanter als das allgemeine Etikett „Vision-Chatbot“. Z.ai sieht vor, dass ein Agent gerenderte Oberflächen, Browser-Zustände, Dokumente oder andere visuelle Artefakte analysiert und anschließend Code oder Ergebnisse überarbeitet. Die offizielle Model Card zeigt die Bildeingabe; die öffentliche Modell- und Bereitstellungsdokumentation beschreibt zusätzlich die Videoeingabe.
Was die Benchmark-Tabelle aussagt – und was nicht
Die offizielle Veröffentlichung und die Model Card weisen starke Ergebnisse aus, insbesondere bei Coding- und Agentenaufgaben. Zu den sichtbaren Einträgen der Model Card gehören TerminalBench 2.1 mit 84.3, DeepSWE mit 63.4 und HLE mit 55.3. In den Veröffentlichungsunterlagen von Z.ai werden außerdem ein Artificial-Analysis-Intelligence-Index-Wert von 57, 48.8 bei AutomationBench und 29.0 bei Z.ai Code Bench mit maximalem Aufwand genannt.
| Benchmark | GLM-5.3-Flash | Vergleich oder Basiswert | Quelle und Einschränkung |
|---|---|---|---|
| TerminalBench 2.1 | 84.3 | GLM-5.2: 81.0; Claude Opus 4.8: 85.0 | Ergebnis von Z.ai/aus der Model Card; Harnesses und Budgets sind relevant |
| DeepSWE v1.1 | 63.4 | GLM-5.2: 46.2 | Berichtete Evaluation; nicht auf jedes Repository übertragbar |
| AutomationBench | 48.8 | GLM-5.2: 26.2 | Berichtete Evaluation mit einer angegebenen Benchmark-Version |
| Z.ai Code Bench, maximaler Aufwand | 29.0 | Claude Opus 4.8: 29.5 | Nahezu gleichwertiges Ergebnis unter dem Setup von Z.ai |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Laut Z.ai vergleichbar mit Claude Opus 4.8 | Externer Index; der Aufgabenmix ist kein reiner Coding-Score |
Die gemeldeten Ergebnisse basieren auf unterschiedlichen Harnesses, Kontextlimits, Timeouts und Bewertungsverfahren. Man sollte sie daher eher als Richtungsanzeige denn als eine universelle Rangliste lesen. Die faire Schlussfolgerung lautet: Für eine deutliche Verbesserung gegenüber GLM-5.2 bei Coding-Agent-Evaluierungen gibt es belastbare Hinweise – nicht aber dafür, dass GLM-5.3-Flash jedes Frontier-Modell dominiert.
Dasselbe gilt für frühe Community-Tests. @prz_chojecki berichtete, dass Ox Alpha bei allen 226 ErdosBench-Aufgaben besser abschnitt als GLM-5.2. Das ist ein nützlicher Ausgangspunkt für eigene Testfälle, ersetzt aber keine kontrollierte Evaluation mit den eigenen Tools und dem eigenen Repository.
Die praktischen Grenzen, die frühe Nutzer festgestellt haben
„Flash“ beschreibt die aktive Rechenmenge und die Kostenposition verlässlicher als die tatsächliche Interaktivität. In Diskussionen von Nutzern auf r/opencodeCLI wurden sowohl starke Coding-Ergebnisse als auch frustrierend lange Wartezeiten gemeldet – besonders während der anonymen Vorschau. Das sind Beobachtungen zu bestimmten Anbietern und Workloads, keine offiziellen Latenzbenchmarks.
„Wie kann es ‚Flash‘ heißen, wenn es deutlich langsamer als das Hauptmodell ist?“ — u/ahriad in r/opencodeCLI
Das aussagekräftigste Signal aus dem Betrieb ist die Zuverlässigkeit lang laufender Agenten unter Last. @solomonneas berichtete in einem siebentägigen Test von 30 erfolgreichen Builds bei 49 Versuchen; 14 Fehlschläge traten als Timeouts auf. Daraus lässt sich keine feste Fehlerquote für die offizielle API ableiten. Für Aufgaben, die stundenlang laufen können, ist eine Ausweichroute aber durchaus sinnvoll.
Eine weitere Grenze, die Benchmark-Schlagzeilen gern verschweigen, betrifft den lokalen Betrieb: Der offizielle FP8-Checkpoint belegt vor Laufzeit- und KV-Cache-Overhead etwa 306 GiB. Ein Modell mit insgesamt 320B Parametern benötigt daher auch dann eine Infrastruktur mit viel Speicher, wenn pro Token nur 18B Parameter aktiv sind.
API, Hosted-Zugriff und lokale Bereitstellung
Für die Nutzung über die Cloud nennt die Preisseite von Z.ai für GLM-5.3-Flash $0.15 pro 1M Eingabe-Token, $0.03 pro 1M gecachte Eingabe-Token und $0.50 pro 1M Ausgabe-Token. Eine zeitlich begrenzte Aktion mit 50 % Rabatt führt $0.075 für Eingaben, $0.015 für gecachte Eingaben und $0.25 für Ausgaben auf. Sie endet am 9. September 2026 um 24:00 Uhr UTC+8. Vor der Kalkulation sollte man die offizielle Preistabelle von Z.AI prüfen, da die Aktion ein Enddatum hat.
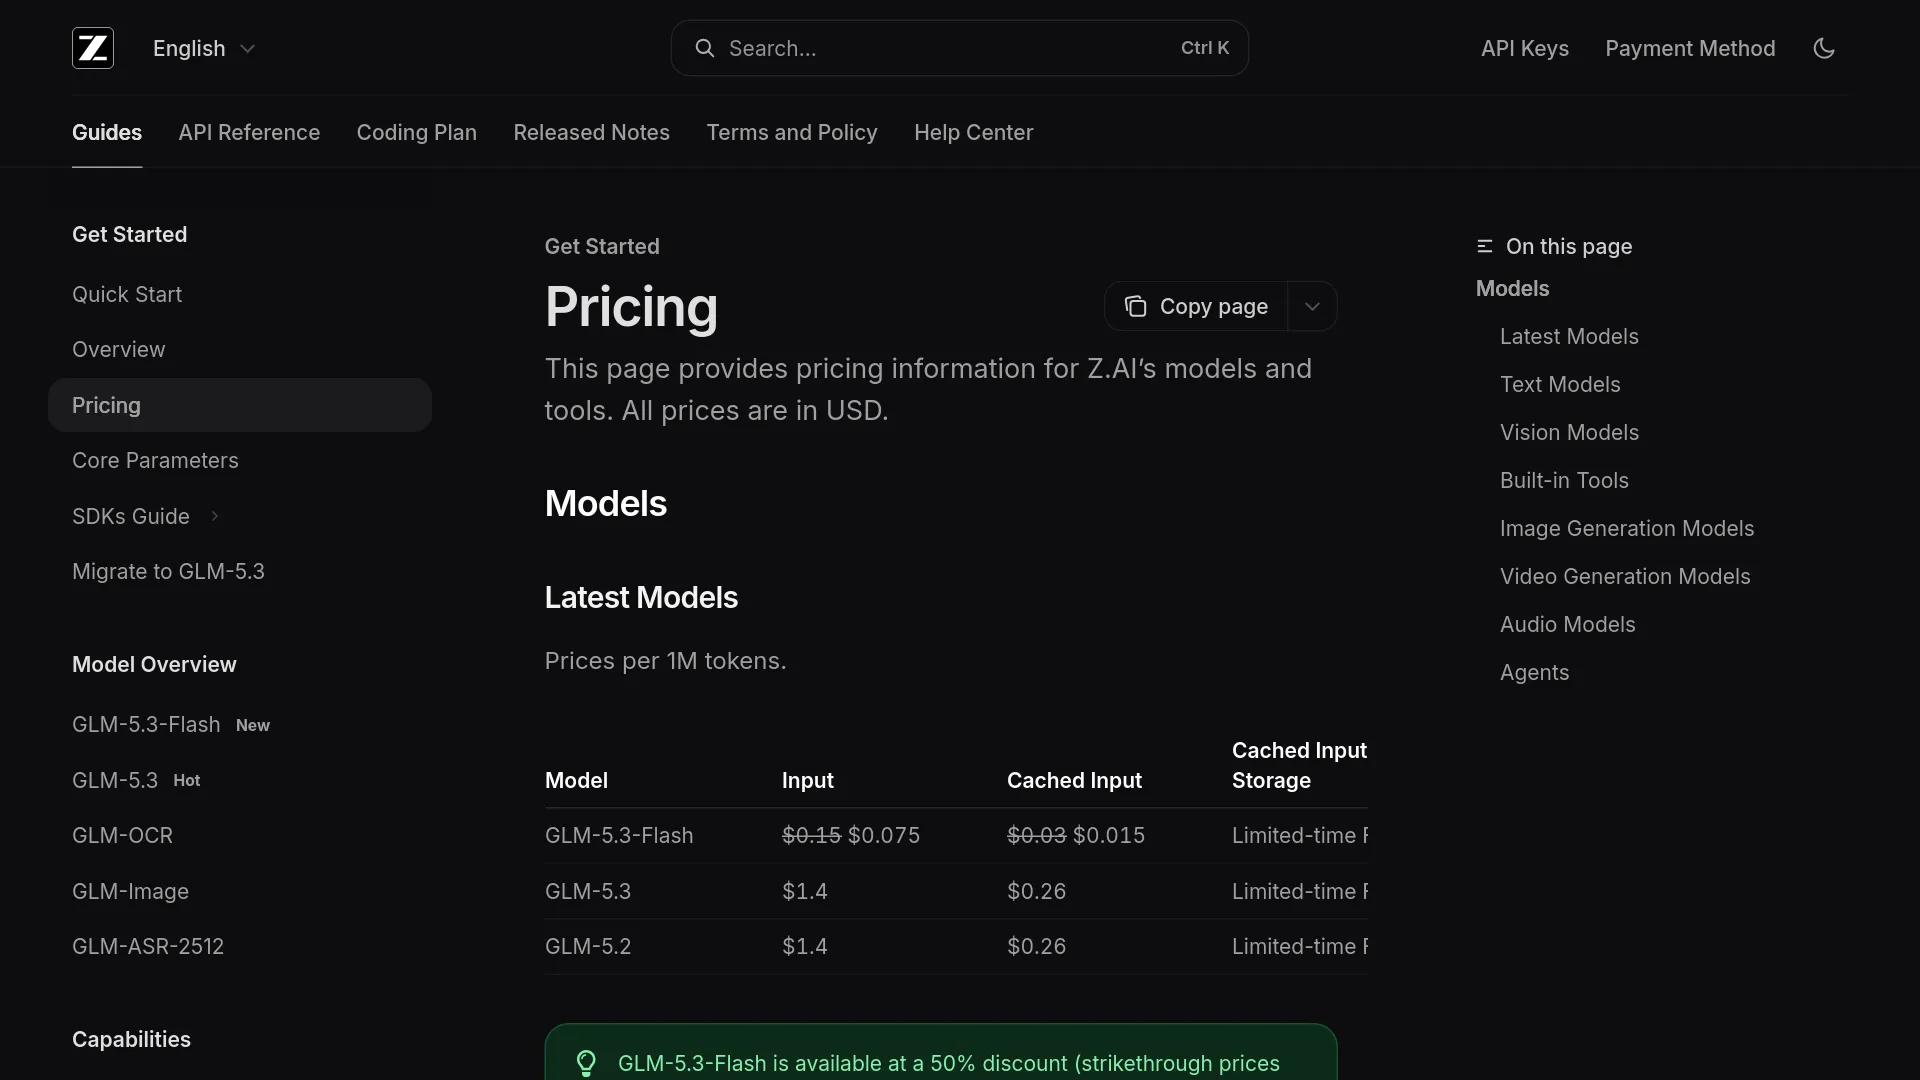
Der reguläre Listenpreis ist nicht mit dem vorübergehenden Preis der Ox-Alpha-Vorschau gleichzusetzen. Ein einfaches Beispiel: 10M Eingabe-Token plus 2M Ausgabe-Token würden zum Listenpreis $2.50 kosten, bevor weitere Gebühren des Anbieters anfallen: 10 × $0.15 + 2 × $0.50. Wenn der Anbieter diese Token als gecacht abrechnet, kann der Anteil für die Eingabe geringer ausfallen.
Der lokale Betrieb ist möglich, aber eher ein Infrastrukturprojekt als ein Download für den Laptop. Das offizielle vLLM-Rezept veranschlagt für die FP8-Gewichte ungefähr 306 GiB und für die standardmäßige FP8-Bereitstellung 386GB VRAM; für BF16 werden 772GB angegeben. Der unterstützte Pfad setzt derzeit NVIDIA-Hopper- oder neuere GPUs, eine aktuelle FlashInfer-Version und ein dediziertes vLLM-Image voraus, während die Integration weiter ausgebaut wird.
Das KTransformers-Tutorial beschreibt heterogene Inferenz über CPU und GPU, die direkte Nutzung der offiziellen FP8-Gewichte und mindestens 350GB freien Systemspeicher. Das dort gezeigte Beispiel mit einer einzelnen GPU ist eine Offload-Konfiguration und kein Beleg dafür, dass eine einzelne Consumer-GPU das Modell vollständig aufnehmen kann. Außerdem verwendet das Tutorial eine validierte Einstellung mit 501.025 Token und begrenzt jede multimodale Anfrage auf entweder acht Bilder oder ein Video.
| Bereitstellungsweg | Was die Dokumentation unterstützt | Wichtigste Einschränkung |
|---|---|---|
| Z.ai API | Abgerechneter Hosted-Zugriff; Listen- und Aktionspreise pro Token veröffentlicht | Rate-Limits, regionale Bedingungen und aktuelle Aktionen prüfen |
| vLLM | FP8-/BF16-Serving, OpenAI-kompatibler Endpunkt, Tensor-Parallelismus, multimodaler Pfad | NVIDIA-Infrastruktur mit viel Speicher; das aktuelle Rezept zielt auf Hopper+ |
| KTransformers | Heterogene CPU-GPU-Inferenz und Laden der FP8-Gewichte | Etwa 306 GiB für die Gewichte; mindestens 350GB Systemspeicher empfohlen |
| Ollama-/LM-Studio-/llama.cpp-Ökosystem | Die Model Card verweist auf quantisierte Distributionen und kompatible Tools | Unterstützung und Geschwindigkeit hängen vom jeweiligen Build ab |
Für wen lohnt sich GLM-5.3-Flash jetzt?
Für kostenbewusste Coding-Agenten und Piloten mit langen Kontexten. Der niedrige Listenpreis, der 1M-Kontext und die gemeldete Verbesserung gegenüber GLM-5.2 machen das Modell interessant für Repository-Analysen, Änderungen über mehrere Dateien, Testgenerierung und wiederholte Agentenaufrufe. Akzeptanztests und ein Fallback-Modell sollten so lange Teil des Prozesses bleiben, bis die eigene Erfolgsquote stabil ist.
Für multimodale technische Aufgaben, bei denen reine Textmodelle zum Engpass werden. Bild- und Videoeingaben können einem Agenten helfen, Browserausgaben, UI-Layouts, Diagramme, Dokumente und gerenderte Artefakte zu prüfen. Das Modell erzeugt keine Videos, sondern verarbeitet visuelle Eingaben und liefert Text oder Code zurück.
Nicht allein deshalb auswählen, weil „18B aktiv“ nach einem Desktop-Modell klingt. Der gesamte Checkpoint umfasst rund 320B Parameter. Für den lokalen Betrieb werden daher bereits ohne Kontext- und Laufzeit-Overhead mehrere hundert Gigabyte Speicher oder Arbeitsspeicher benötigt. Der Zugriff über die Hosted-API ist wirtschaftlich meist einfacher, sofern nicht ohnehin Inferenz-Hardware mit viel Speicher vorhanden ist.
Vertraulichen Code nicht an einen ungeprüften Vorschau-Endpunkt senden. Die öffentliche Veröffentlichung von GLM-5.3-Flash ist Z.ai eindeutig zuzuordnen. Trotzdem bleiben Anbieterbedingungen, Speicherung und Routing wichtige Punkte. Für produktive Zugriffe sollte die aktuelle Datenrichtlinie des Endpunkts dokumentiert und entweder die offizielle API oder ein Anbieter mit prüfbaren Betriebsbedingungen verwendet werden.
FAQ
Ist Ox Alpha exakt dasselbe wie GLM-5.3-Flash?
Z.ai bestätigt offiziell, dass GLM-5.3-Flash zuvor als Ox Alpha getestet wurde. Das Verhalten von Ox Alpha liefert nützlichen Kontext, doch Routing und Limits der Vorschau sollten nicht als Spezifikationen des öffentlichen Modells gelten.
Ist GLM-5.3-Flash Open Source?
Der offizielle Checkpoint auf Hugging Face steht unter der MIT-Lizenz, und Z.ai stellt Hinweise für den lokalen Betrieb bereit. Präziser ist die Bezeichnung „Open Weights“: Die Gewichte sind verfügbar, für den vollständigen Betrieb ist aber weiterhin erhebliche Infrastruktur nötig.
Wie viel Speicher benötigt GLM-5.3-Flash lokal?
Die offiziellen FP8-Gewichte belegen vor Laufzeit- und KV-Cache-Overhead etwa 306 GiB. Das vLLM-Rezept nennt 386GB VRAM für die standardmäßige FP8-Bereitstellung, während KTransformers für die heterogene Inferenz mindestens 350GB Systemspeicher empfiehlt.
Kostet die API wirklich $0.15 pro einer Million Eingabe-Token?
Ja. Auf der offiziellen Preisseite von Z.AI stehen $0.15 für Eingaben, $0.03 für gecachte Eingaben und $0.50 für Ausgaben. Die Aktion mit 50 % Rabatt ist bis zum 9. September 2026, UTC+8, angegeben.
Ist GLM-5.3-Flash schneller als andere Flash-Modelle?
Die verfügbaren Daten belegen keine allgemeingültige Rangfolge bei der Latenz. Frühe Nutzer berichteten von langsamen Agentensitzungen und Timeouts. Deshalb sollte man Zeit bis zum ersten Token, Abschlussdauer, Wiederholungen und die Quote akzeptierter Aufgaben für die eigene Provider-Route messen.
Unterstützt GLM-5.3-Flash Bilder und Videos?
Ja. Z.ai und die offizielle Model Card beschreiben Text-, Bild- und Videoeingaben bei einer Textausgabe. Die Dokumentation für den lokalen Betrieb nennt zusätzlich Grenzen wie bis zu acht Bilder oder ein Video im dokumentierten KTransformers-Setup.
Die Hosted-API ist die einfachere Wahl, wenn die niedrigen Kosten und die Multimodalität von GLM-5.3-Flash ohne den Kauf einer Inferenzmaschine mit mehreren hundert Gigabyte genutzt werden sollen. Ein lokaler Pilot lohnt sich vor allem dann, wenn die entsprechende Infrastruktur bereits vorhanden ist. Für lange Agentenaufgaben sollte ein getestetes Fallback bereitstehen, denn die öffentliche Datenlage ist bei Fähigkeiten und Preisen überzeugender als bei dauerhaft zuverlässiger Interaktivität.