 AIREITER
Ob aus einer Aufnahme ein brauchbares Transkript werden soll oder Live-Untertitel vom Mikrofon gefragt sind: Gemini 3.5 Transcribe ist wegen der Textbereinigung, eigener Fachbegriffe und der mehrsprachigen Verarbeitung interessant. Die beiden API-Wege unterscheiden sich allerdings deutlich bei ihren Limits. Für dauerhafte Transkripte eignet sich die Datei-API, für kurze Sitzungen mit niedriger Latenz die Live-API.
Die praktische Entscheidung: Datei-API nutzen, außer du brauchst Live-Untertitel
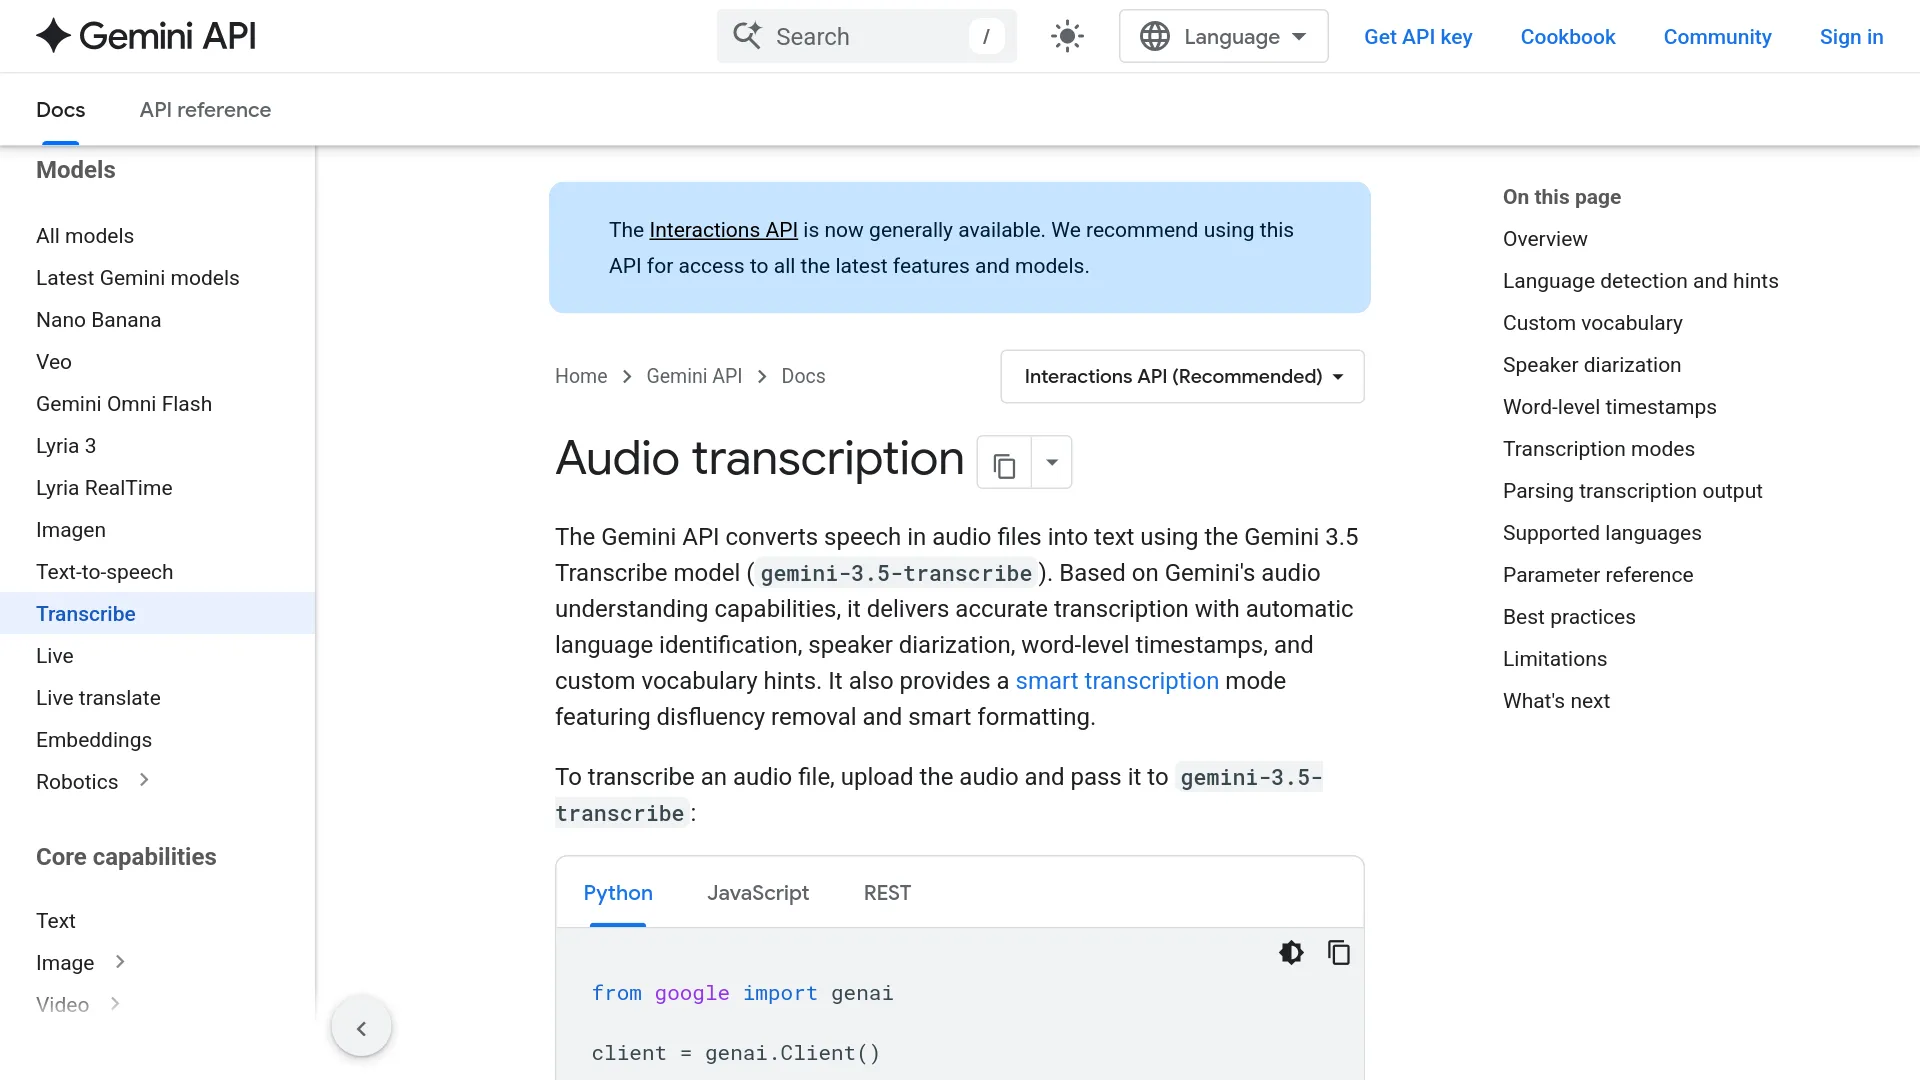
Gemini 3.5 Transcribe ist Googles dedizierte Speech-to-Text-Modellfamilie und seit dem 26. August 2026 als öffentliche Preview verfügbar. Google dokumentiert für aufgezeichnete und Echtzeit-Audios separate Modell-IDs, Übertragungswege, Ausgabeereignisse und Einschränkungen.
| Anforderung | Modell-ID | API-Weg | Wichtige Einschränkung |
|---|---|---|---|
| Meetings, Gespräche, hochgeladene Aufnahmen | gemini-3.5-transcribe | Interactions API | Bis zu 1 Stunde bei einer normalen Unary-Anfrage; 30 Minuten mit Diarisierung oder Wortzeitstempeln |
| Live-Untertitel, Mikrofoneingaben, Sprachoberflächen | gemini-3.5-transcribe-live | Live API | 10-minütige durchgehende Sitzung; keine Live-Diarisierung und keine Zeitstempel auf Wortebene |
Für Meeting-Archive, Gesprächsanalyse oder die Untertitelvorbereitung startest du mit gemini-3.5-transcribe. Für eine Untertitelvorschau oder eine Push-to-Talk-Oberfläche ist gemini-3.5-transcribe-live die passendere Wahl. Googles Leitfaden zur Transkription aufgezeichneter Audiodateien und der Leitfaden zur Live API beschreiben die Abläufe getrennt.
Die Verfügbarkeit ist weiterhin auf die Preview beschränkt
Google hat Gemini 3.5 Transcribe am 26. August 2026 vorgestellt. Die Entwickler-API ist über Google AI Studio und Google Antigravity als öffentliche Preview verfügbar. Auch der Zugriff für Unternehmen über die Gemini Enterprise Agent Platform wird als Preview geführt. Das kann bedeuten, dass regionale Verfügbarkeit, Kontingente und Stabilität von einem allgemein verfügbaren Speech-Dienst abweichen. Wer wichtige Volumen verarbeiten will, sollte deshalb zunächst repräsentative Audiodaten testen.
Gemini 3.5 Transcribe: Preise in der Praxis
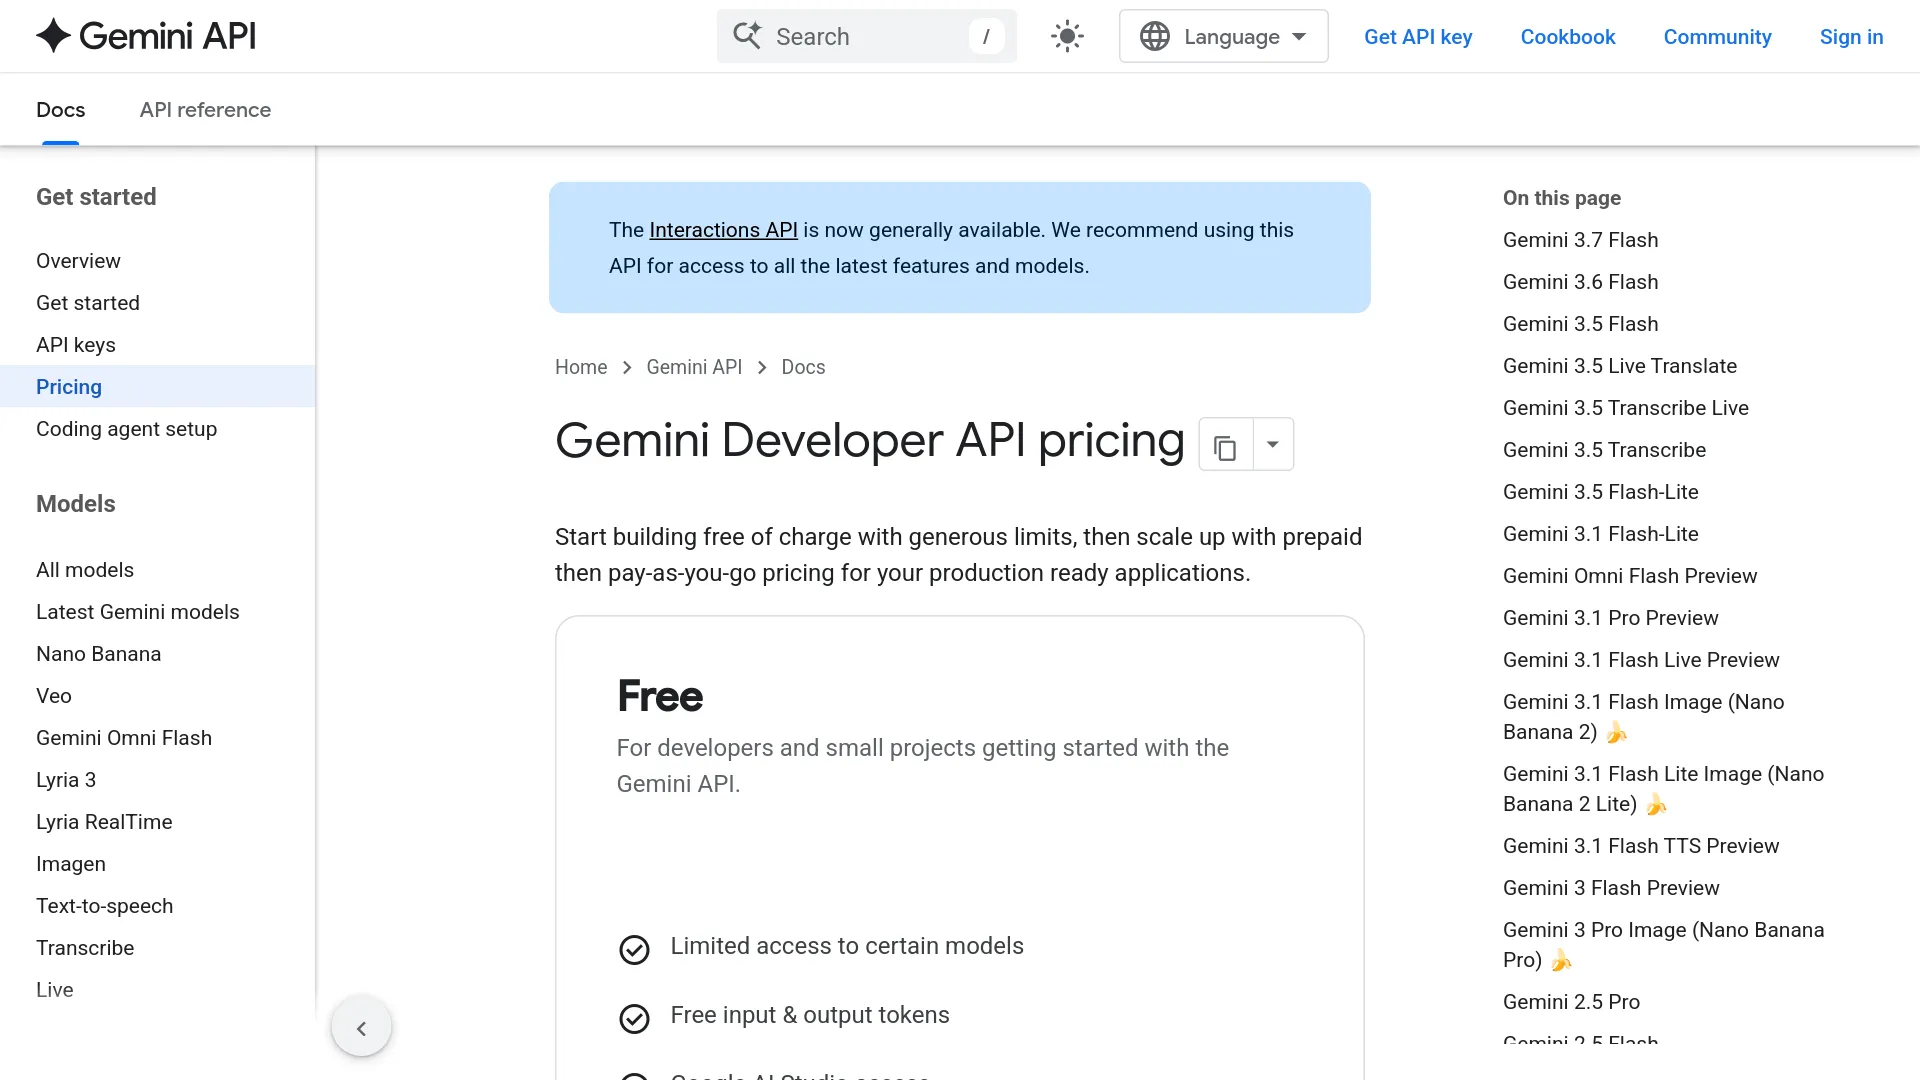
Googles Preisseite für die Gemini API nennt tokenbasierte Tarife statt einer pauschalen Transkriptionsgebühr. Der aktuelle Preisüberblick führt für gemini-3.5-transcribe 2 US-Dollar pro 1 Million Audio-Input-Tokens und 12 US-Dollar pro 1 Million Text-Output-Tokens auf.
In der Audio-Dokumentation erklärt Google, dass Audio mit 32 Tokens pro Sekunde dargestellt wird, also mit 1.920 Audio-Tokens pro Minute. Der Audio-Input allein entspricht bei 2 US-Dollar pro 1 Million Tokens damit ungefähr 0,00384 US-Dollar pro Minute – Textausgabe und weitere abrechenbare Tokens sind dabei noch nicht enthalten.
| Modell | Veröffentlichte Preisgrundlage | Orientierungswert pro Minute | Orientierungswert pro Stunde |
|---|---|---|---|
gemini-3.5-transcribe | 2 US-Dollar/M Audio-Input-Tokens + 12 US-Dollar/M Text-Output-Tokens | Etwa 0,005 US-Dollar/Min. | Etwa 0,30 US-Dollar/Stunde |
gemini-3.5-transcribe-live | Tokenbasierte Verarbeitung von Live-Audio und Text | Etwa 0,009 US-Dollar/Min. | Etwa 0,54 US-Dollar/Stunde |
Die gemischten Werte hängen vom Umfang der Transkriptausgabe ab und sind daher Planungswerte, keine garantierten Minutentarife. Umfangreiche Ausgaben, wiederholter Kontext und zusätzliche Anweisungen können die Rechnung verändern. Prüfe vor einer größeren Nutzung die aktuelle Preistabelle, da sich Preview-Preise ändern können.
Welche Funktionsunterschiede in der Praxis zählen
Wörtlich oder intelligent bereinigt transkribieren
VERBATIM ist in Googles Transkriptionsdokumentation der Standardmodus. Er behält Füllwörter, Wiederholungen, Pausen, Versprecher und die ursprüngliche Selbstkorrektur bei. Dieser Modus eignet sich, wenn das Transkript als Aufzeichnung, Beleg, Untertitelquelle oder Grundlage für eine Qualitätskontrolle dienen soll.
SMART verändert den Text zugunsten der Lesbarkeit. Der Modus entfernt Sprachstockungen, löst Selbstkorrekturen auf, ergänzt Satzzeichen und strukturiert den Inhalt. Auch Datumsangaben, Währungen, Zahlen, Listen und Absätze können formatiert werden. Aus dem gesprochenen „Dienstag – nein, Mittwoch“ kann im bereinigten Ergebnis beispielsweise „Mittwoch“ werden.
Der Smart-Modus ist nicht mit Sprecherdiarisierung oder Wortzeitstempeln kompatibel. Wenn eine Anwendung gut lesbare Notizen und zugleich Nachvollziehbarkeit braucht, solltest du zuerst eine Verbatim-Version anfordern und eine Kopie separat bereinigen.
Eigenes Vokabular und Sprachwechsel
Google dokumentiert eine automatische Spracherkennung für mehr als 85 Regionen, einschließlich Sprachwechseln. Ist die Sprache bekannt, kannst du einen BCP-47-Code wie en-US oder es-ES angeben, um die Erkennung zu unterstützen.
Das benutzerdefinierte Vokabular kann bis zu 1.000 Begriffe enthalten. Googles praktische Empfehlung lautet jedoch, möglichst bei 100 Begriffen oder weniger zu bleiben. Sinnvoll sind markante Produktnamen, Akronyme, Personennamen, medizinische Begriffe oder technische Fachwörter – nicht eine lange Liste ganz gewöhnlicher Wörter.
Sprecherlabels und Wortzeitstempel
Aufgezeichnetes Audio kann Sprecherzuordnungen und Zeitangaben auf Wortebene liefern. Die API-Dokumentation nennt maximal acht Sprecher. In Googles Launch-Beitrag wird dagegen die Zuordnung von bis zu drei Sprechern hervorgehoben; Unterstützung für drei oder mehr Sprecher ist dort als experimentell gekennzeichnet.
Wortzeitstempel werden im Verbatim-Modus aktiviert und liefern Start- und Endpositionen für jedes Wort. Google weist darauf hin, dass Zeitstempel die Genauigkeit der gesamten Transkription beeinträchtigen können. Diarisierung und Zeitstempel reduzieren außerdem das standardmäßige Audio-Limit von einer Stunde auf 30 Minuten.
| Anforderung | Unterstützt? | Einschränkung |
|---|---|---|
| Sprecherlabels bei aufgezeichnetem Audio | Ja | Dokumentiert sind bis zu 8; Zuordnung ab 3 Sprechern ist experimentell |
| Wortzeitstempel bei aufgezeichnetem Audio | Ja | Nur im Verbatim-Modus; kann die Genauigkeit reduzieren |
| Sprecherlabels bei Live-Transkription | Nein | Wenn die Zuordnung wichtig ist, aufgezeichnetes Audio verwenden |
| Wortzeitstempel bei Live-Transkription | Nein | Die Live-Ausgabe erfolgt inkrementell und orientiert sich an Äußerungen |
| Smart-Modus mit Labels oder Zeitstempeln | Nein | Für diese Annotationen den Verbatim-Modus wählen |
So schickst du eine aufgezeichnete Datei an die Gemini 3.5 Transcribe API
Googles Leitfaden für aufgezeichnetes Audio beschreibt drei Schritte: Datei hochladen, die zurückgegebene Datei-URI an die Interactions API übergeben und das fertige Transkript aus interaction.output_text auslesen.
- Audio über die Files API hochladen. Dieser Weg eignet sich für Aufnahmen von mehr als wenigen Sekunden oder Dateien, die du wiederverwenden möchtest.
- Datei-URI und MIME-Typ speichern, etwa
audio/mp3. - Die URI über die Interactions API an
gemini-3.5-transcribesenden. - Textausgabe auslesen und bei Bedarf die
word_info-Annotationen für Sprecher- und Zeitinformationen prüfen.
Der Ablauf mit dem offiziellen SDK lässt sich auf dieses Beispiel zum Hochladen und Transkribieren reduzieren:
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
Nach dem Upload über die Files API und der Rückgabe von FILE_URI sieht eine kompakte REST-Anfrage so aus:
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
Für ein bereinigtes Transkript ergänzt du eine Transkriptionskonfiguration mit aktiviertem Smart-Modus:
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
Für Sprecherlabels und Wortzeitstempel verwendest du stattdessen den Verbatim-Modus:
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
Die Smart-Konfiguration darf nicht mit Diarisierung oder Zeitstempeln kombiniert werden. Die dokumentierten Modusregeln machen daraus eine Architekturentscheidung und nicht bloß eine Frage der Darstellung.
So funktioniert die Live-Transkription
Die Live API öffnet mit gemini-3.5-transcribe-live eine bidirektionale Streaming-Verbindung. Der Client sendet fortlaufend Audio und erhält zwei Arten von Textereignissen:
interim_input_transcription: eine sich ändernde Hypothese mit niedriger Latenz für Untertitel oder eine UI-Vorschau.input_transcription: finalisierter Text, der in das Transkript oder den Anwendungsstatus übernommen werden kann.
Googles Live-Leitfaden verlangt rohes 16-Bit-PCM mit 16 kHz, Mono und Little-Endian-Kodierung. Empfohlen werden Blöcke von etwa 100 Millisekunden mit ungefähr 1.024–2.048 Frames pro Block. Browser- und Mobilclients sollten anstelle eines normalen API-Schlüssels eingeschränkte kurzlebige Tokens verwenden. Googles Beispiele nutzen ein einmal verwendbares Token mit einer Gültigkeit von 30 Minuten.
Der Live-Endpunkt unterstützt automatische Spracherkennung, BCP-47-Hinweise, benutzerdefiniertes Vokabular sowie die Ausgabe im Modus VERBATIM oder SMART. Live-Sprecherdiarisierung und Wortzeitstempel werden nicht unterstützt. Eine durchgehende Sitzung ist auf 10 Minuten begrenzt. Längere Streams benötigen daher eine Sitzungsverwaltung auf Anwendungsebene und das Zusammenführen der Transkripte.
Für die Erkennung von Sprecherwechseln bietet die Live API drei Ansätze:
- Automatische VAD: Der Server erkennt Beginn und Ende der Sprache.
- Hybride VAD: Eine Erkennung auf Clientseite signalisiert das Ende der Sprache, während die Servererkennung als Fallback aktiv bleibt.
- Manuelle VAD: Eine Push-to-Talk-Oberfläche sendet Beginn und Ende der Aktivität ausdrücklich.
Was die ersten Daten zeigen – und was nicht
Google nennt über Artificial Analysis durchschnittliche WER-Werte von 4,0 % für Streaming und 2,6 % für Nicht-Streaming. Im Launch-Beitrag berichtet Google außerdem FLEURS-Ergebnisse von 5,50 % Streaming-WER und 5,04 % Nicht-Streaming-WER sowie eine um 70 % bessere Zeit bis zum finalen Transkript gegenüber Chirp 3.
Diese Werte stammen aus von Google veröffentlichten oder zitierten Ergebnissen und nicht aus einem unabhängigen Direktvergleich von Gemini 3.5 Transcribe. Der öffentliche koedesk-STT-Benchmark hat Gemini 3.5 Flash und andere Engines gemessen, Gemini 3.5 Transcribe jedoch nicht direkt untersucht.
Frühe Nutzer fragen unter anderem nach den Datei- und Live-Limits, Referenztranskripten für WER-Messungen und der Zuverlässigkeit von Telefonnummern oder Bestell-IDs in ruhigen Passagen. Teste daher Namen, IDs, Zahlen, Sprecherwechsel, Timing und Latenz mit repräsentativem Audio, statt dich allein auf einen durchschnittlichen WER-Wert zu verlassen.
Wann sich Gemini 3.5 Transcribe lohnt – und wann du besser wartest
| Szenario | Eignung | Sinnvolle Startkonfiguration |
|---|---|---|
| Saubere Meeting-Notizen oder Diktate | Sehr gut | Datei-API, SMART, bei bekannter Sprache expliziten Sprachhinweis setzen |
| Rechtliche, Compliance- oder Archivaufzeichnung | Bedingt | Datei-API, VERBATIM; kritische Passagen manuell prüfen |
| Aufgezeichnete Gespräche mit mehreren Sprechern | Bedingt | Datei-API, VERBATIM + Diarisierung; Sitzungen auf 30 Minuten begrenzen |
| Untertitel mit synchronisierten Wörtern | Bedingt | Datei-API, VERBATIM + Wortzeitstempel; Timing und Genauigkeit validieren |
| Live-Untertitel | Gut für kurze Sitzungen | Live API, für den festgeschriebenen Text nur finale Ereignisse verwenden |
| Lang laufender Sprachagent | Erfordert Entwicklungsaufwand | Sitzungen vor dem 10-Minuten-Limit segmentieren und Reconnects verwalten |
| Offline- oder vertrauliche lokale Verarbeitung | Schlecht geeignet | Der dokumentierte Ablauf sendet Audio an Googles Dienst; eine selbst gehostete ASR-Lösung erwägen |
Gemini 3.5 Transcribe passt am besten, wenn die Transkription der erste Schritt eines größeren Workflows ist: Sprache bereinigen, technisches Vokabular erhalten, Sprecher erkennen und strukturierten Text weiterreichen. Weniger passend ist der Dienst, wenn lediglich eine günstige wörtliche Transkription oder zwingend eine Offline-Verarbeitung gefragt ist.
FAQ zur Gemini 3.5 Transcribe API
Ist Gemini 3.5 Transcribe kostenlos?
Google führt für die Nutzung der Gemini API eine kostenlose Stufe auf. Kontingente und Modellverfügbarkeit können sich jedoch ändern. Die kostenpflichtige Nutzung wird nach Tokens abgerechnet. Auf der Preisseite stehen derzeit Richtwerte von etwa 0,005 US-Dollar pro Minute für aufgezeichnete Transkriptionen und 0,009 US-Dollar pro Minute für das Live-Modell.
Was unterscheidet die Datei- und die Live-Modelle?
gemini-3.5-transcribe verarbeitet hochgeladene Aufnahmen über die Interactions API und unterstützt bei aufgezeichnetem Audio Diarisierung und Wortzeitstempel. gemini-3.5-transcribe-live streamt rohes PCM über die Live API, liefert vorläufige und finale Ereignisse und ist auf Sitzungen von 10 Minuten begrenzt – ohne Live-Diarisierung oder Zeitstempel auf Wortebene.
Kann ich eine dreistündige Aufnahme in einer Anfrage verarbeiten?
Nicht mit der dedizierten Konfiguration für aufgezeichnete Transkriptionen. Das normale Unary-Limit liegt bei einer Stunde; mit Diarisierung oder Wortzeitstempeln sinkt es auf 30 Minuten. Für längere Aufnahmen brauchst du Chunking auf Anwendungsebene und musst Kontext sowie die Sprecherkontinuität sorgfältig behandeln.
Kann ich Gemini 3.5 Transcribe offline nutzen?
Der dokumentierte Ablauf lädt Audio zu Googles Dienst hoch oder streamt es dorthin. Google beschreibt keine Offline- oder selbst gehostete Version von Gemini 3.5 Transcribe.
Die sicherste erste Integration
Starte mit einem kleinen Ausschnitt aus deinem echten Anwendungsfall, nicht mit einem sauberen Demo-Clip. Verarbeite dasselbe Audio zweimal: einmal im Verbatim-Modus für maximale Nähe zum Original und anschließend im Smart-Modus für bessere Lesbarkeit. Miss Eigennamen, Zahlen, Sprecherwechsel, Zeitstempelabweichungen und Kosten getrennt.
Bewahre das Rohtranskript als maßgebliche Quelle auf, nutze die Smart-Ausgabe für nutzerseitige Notizen und ergänze einen Fallback für fehlgeschlagene Uploads oder Änderungen am Preview-Modell. Wechsle erst zur Live API, wenn dein Client 100-Millisekunden-PCM-Blöcke, vorläufige und finale Ereignisse, kurzlebige Tokens sowie das 10-Minuten-Sitzungslimit zuverlässig beherrscht.