 AIREITER
Seit dem 16. August 2026 rechnet DeepSeek seine API nicht mehr mit einheitlichen Tokenpreisen ab. Für deepseek-v4-flash und deepseek-v4-pro gelten nun Peak- und Off-Peak-Tarife. Eingabetokens ohne Cache-Treffer und Ausgabetokens kosten off-peak jetzt das 1,5- bis 2,4-Fache, zu Peak-Zeiten jeweils doppelt so viel. Besonders kräftig steigen die Kosten für Cache-Treffer: off-peak um das 2,5- bis 6,1-Fache, im Peak bis auf das 12,1-Fache. Entscheidend für die tatsächliche Mehrbelastung ist daher vor allem deine Prompt-Cache-Hit-Rate.
Was sich am 16. August 2026 geändert hat
Die Umstellung erfolgte laut Ankündigungs-Thread und einem Audit mit 650 Calls auf r/DeepSeek am Sonntag, dem 16. August, um 16:00 UTC – also um Mitternacht am 17. August in Beijing. Die offiziellen Models & Pricing-Seiten führen die neuen Tabellen bereits auf. Das ist also keine bloße Ankündigung, sondern die Preise sind aktiv.
DeepSeek unterscheidet jetzt zwischen Peak- und Off-Peak-Fenstern. Die Peak-Tarife liegen dabei exakt beim Doppelten der Off-Peak-Preise. Peak gilt täglich von 01:00–04:00 UTC sowie von 06:00–10:00 UTC: sieben Stunden Peak, siebzehn Stunden Off-Peak. An Modellen (DeepSeek-V4-Flash-0731, DeepSeek-V4-Pro-0813), API-Kompatibilität und veröffentlichten Spezifikationen hat sich laut derselben Dokumentationsseite nichts geändert. Es ist eine Abrechnungsänderung, kein Modell-Update.
Die neuen API-Preise von DeepSeek
Alle folgenden Preise sind USD pro 1 Mio. Tokens und stammen von der offiziellen Preisseite mit Stand vom 16. August 2026.
| V4 Flash | Off-Peak | Peak |
|---|---|---|
| Input, Cache-Treffer | $0.007 | $0.014 |
| Input, kein Cache-Treffer | $0.22 | $0.44 |
| Output | $0.66 | $1.32 |
| V4 Pro | Off-Peak | Peak |
|---|---|---|
| Input, Cache-Treffer | $0.022 | $0.044 |
| Input, kein Cache-Treffer | $0.66 | $1.32 |
| Output | $1.98 | $3.96 |
Abgesehen davon bleiben die Abrechnungsmechaniken unverändert: Maßgeblich ist stets der Preis zum Zeitpunkt der Ausführung einer Anfrage. DeepSeek behält sich zudem ausdrücklich weitere Preisänderungen vor.
So stark sind die DeepSeek-API-Preise tatsächlich gestiegen
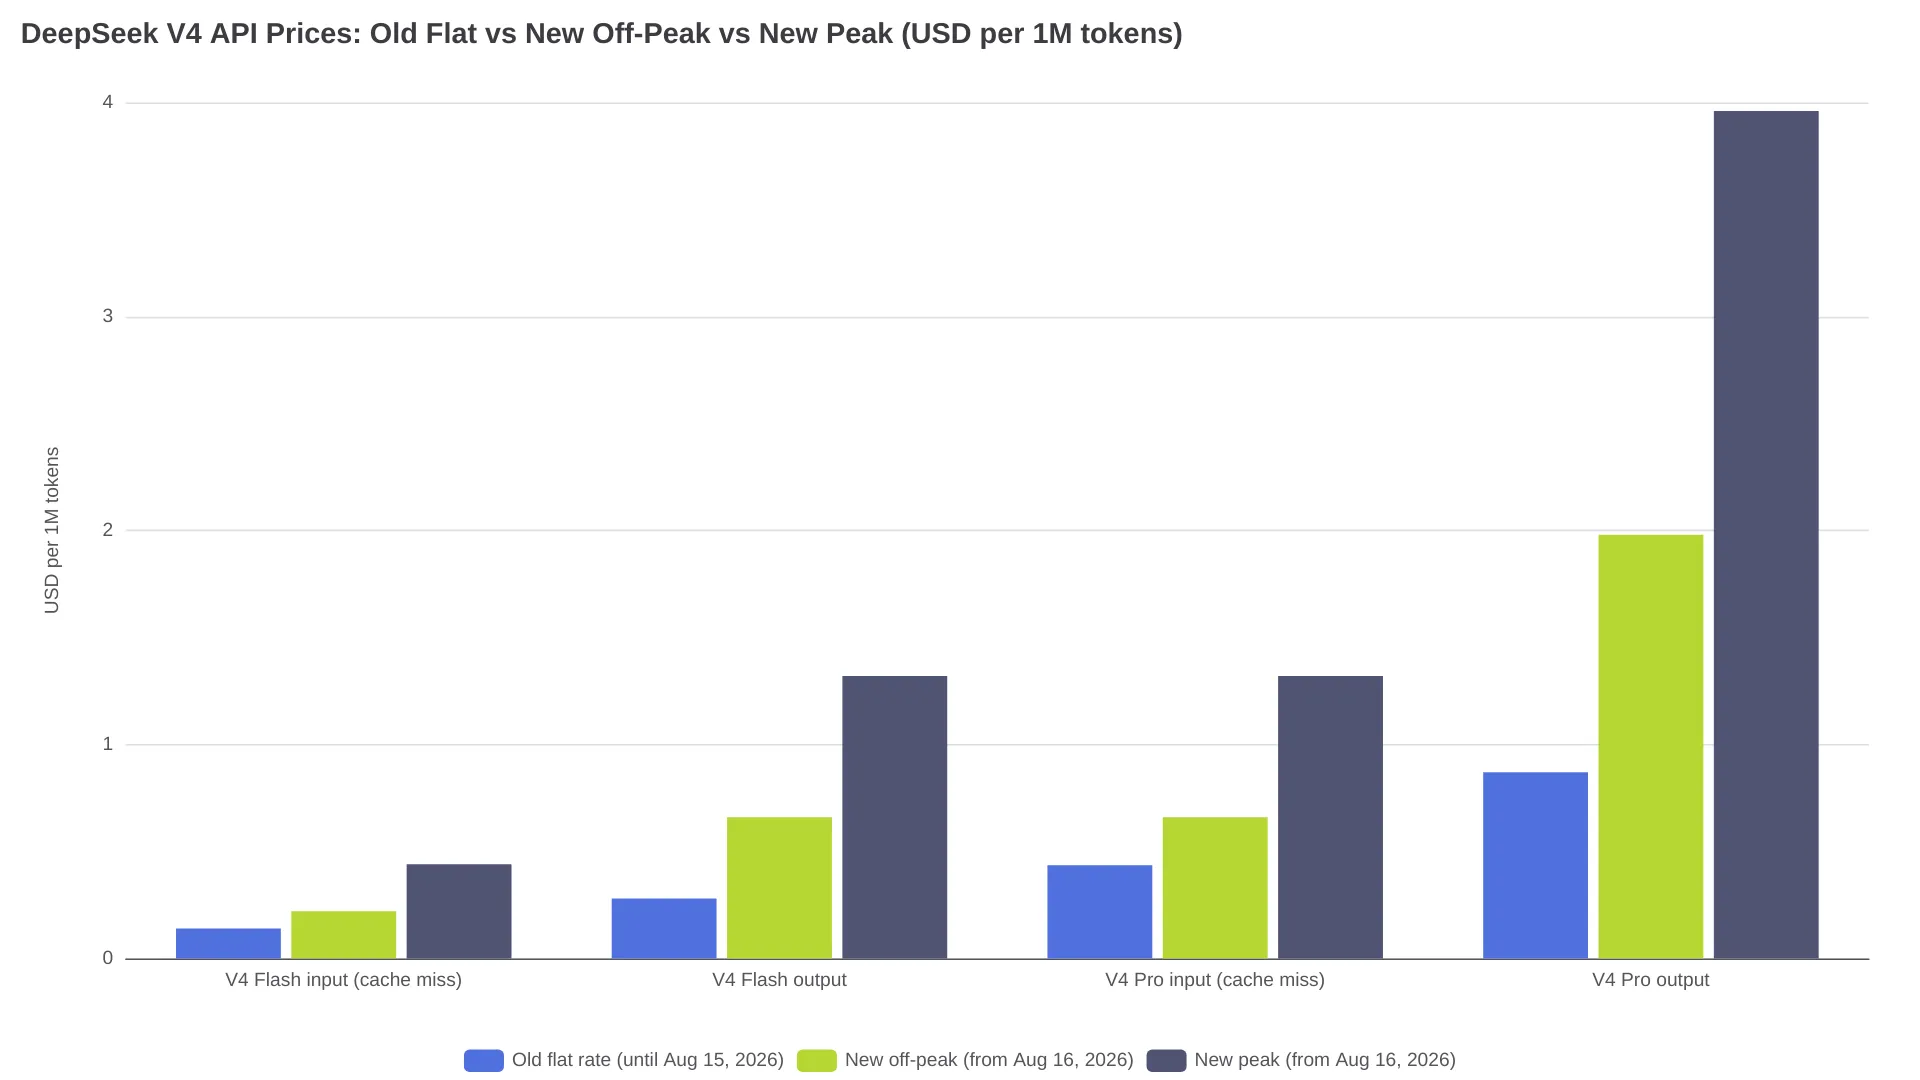
Die bisherigen Einheitstarife wurden von Drittanbieter-Trackern bis zum 31. Juli 2026 bestätigt: Flash kostete $0.14 für Input ohne Cache-Treffer, $0.0028 für Cache-Treffer und $0.28 für Output; bei Pro waren es $0.435 / $0.003625 / $0.87 (TLDL, BenchLM). Im direkten Vergleich ergibt sich:
| Pro 1 Mio. Tokens | Alter Einheitspreis | Neuer Off-Peak-Preis | Neuer Peak-Preis | Off-Peak vs. alt | Peak vs. alt |
|---|---|---|---|---|---|
| Flash Input, Cache-Treffer | $0.0028 | $0.007 | $0.014 | 2.5× | 5.0× |
| Flash Input, kein Cache-Treffer | $0.14 | $0.22 | $0.44 | 1.57× | 3.14× |
| Flash Output | $0.28 | $0.66 | $1.32 | 2.36× | 4.71× |
| Pro Input, Cache-Treffer | $0.003625 | $0.022 | $0.044 | 6.07× | 12.14× |
| Pro Input, kein Cache-Treffer | $0.435 | $0.66 | $1.32 | 1.52× | 3.03× |
| Pro Output | $0.87 | $1.98 | $3.96 | 2.28× | 4.55× |
Die auf Reddit kursierende Schlagzeile von einer „1.114% increase“ stimmt, beschreibt aber nur einen engen Sonderfall: Cache-Treffer beim V4 Pro Input zur Peak-Zeit ($0.003625 -> $0.044). Ein Workload ohne Cache-Treffer landet off-peak eher beim 1,5- bis 2,3-Fachen. Wo du zwischen diesen Extremen landest, bestimmt letztlich deine individuelle Kostensteigerung.
Warum Workloads mit viel Cache-Nutzung besonders betroffen sind
Während sich Cache-Treffer um das 2,5- bis 12-Fache verteuert haben, stiegen Preise für Inputs ohne Cache-Treffer und Outputs nur um das 1,5- bis 4,7-Fache. Wer bisher besonders stark von der extrem günstigen Cache-Schiene profitiert hat, sieht deshalb prozentual den größten Sprung. Ein Nutzer auf r/DeepSeek rechnete 650 reale API-Calls aus 16 Sessions mit 155.9 Mio. Prompt-Tokens und einer Cache-Hit-Rate von 98.09% nach beiden Preislisten neu ab. Sein Ergebnis stimmte bis auf 2% mit der Konsolenabrechnung von DeepSeek überein:
"the better caching works for you today, the bigger your increase" - u/Swimming-Soup-1173, r/DeepSeek-Audit mit 650 API-Calls
Der Agent-Workload dieses Nutzers kostete off-peak nach der Neuberechnung das 2.7×-Fache; ohne Cache-Treffer wären es für denselben Workload 1.5× gewesen. Ein weiterer Nutzer modellierte einen Long-Context-Workload, der off-peak von $33 auf $100 und im Peak auf $200 steigt – ein Sprung um das 3- bis 6-Fache. Batch-Jobs, RAG-Pipelines und Agenten mit statischen System-Prompts trifft die Änderung am stärksten. Einmalige Zusammenfassungsanfragen ohne Cache liegen dagegen eher nahe der Off-Peak-Untergrenze von 1,5–2,3×.
Peak-Zeiten in deiner Zeitzone
Die offizielle Seite nennt nur UTC-Fenster. Umgerechnet für August, wenn Sommerzeit gilt:
| Zeitzone | Peak-Fenster (lokal) | Dein 9-bis-5-Arbeitstag |
|---|---|---|
| Beijing (UTC+8) | 09:00–12:00, 14:00–18:00 | Peak, außer während der Mittagspause von 12:00–14:00 |
| Mitteleuropa (UTC+2) | 03:00–06:00, 08:00–12:00 | Vormittags Peak |
| London (UTC+1) | 02:00–05:00, 07:00–11:00 | Vormittags Peak |
| US East (UTC-4) | 21:00–00:00, 02:00–06:00 | Komplett Off-Peak |
| US West (UTC-7) | 18:00–21:00, 23:00–03:00 | Komplett Off-Peak |
Die Peak-Fenster decken den chinesischen Arbeitstag ab, ausgenommen die Mittagspause: Von 12:00–14:00 Beijing-Zeit gilt Off-Peak. US-Teams arbeiten damit während ihres gesamten Arbeitstags zu Off-Peak-Tarifen. Europäische Teams zahlen dagegen für morgendliche Batches den doppelten Preis – 08:00–12:00 CEST fällt in die Peak-Zeit – und sollten diese Arbeit auf Nachmittag oder Nacht verschieben.
Lohnt sich Prompt Caching noch?
Ja, eindeutig. Der Rabatt ist kleiner geworden, aber keineswegs verschwunden. Ein Cache-Treffer war bei Flash zuvor etwa 50× günstiger als ein Input ohne Cache-Treffer, bei Pro sogar 120×. Jetzt sind es bei beiden Modellen noch rund 30×: off-peak 31× für Flash und 30× für Pro ($0.007 gegenüber $0.22, $0.022 gegenüber $0.66). Auch der Autor des Audits mit dem 2.7×-Anstieg kommt deshalb zu diesem Schluss:
"Caching is still absolutely worth it" - dasselbe r/DeepSeek-Audit
In seinem Workload reduzierte Caching die Kosten gegenüber dem ungekürzten Senden desselben Kontexts weiterhin um ungefähr das 15-Fache. Caching erfolgt nach Best Effort, eine bestimmte Trefferquote wird also nicht garantiert. Nicht verwendete Einträge werden üblicherweise nach Stunden bis Tagen gelöscht (BenchLM). Miss deshalb vor der Budgetplanung deine realen Werte und protokolliere die Felder prompt_cache_hit_tokens und prompt_cache_miss_tokens im Usage-Objekt, wie BenchLM empfiehlt. Daraus lässt sich dein tatsächlicher Cache-Anteil berechnen.
Ist DeepSeek nach der Erhöhung noch die günstige Wahl?
Off-peak: ja. In der Peak-Zeit schmilzt der Preisvorteil von Flash gegenüber GPT-5.6 dagegen auf null. Die regulären Preise pro 1 Mio. Tokens:
| Modell | Input | Output | Hinweise |
|---|---|---|---|
| DeepSeek V4 Flash (Off-Peak) | $0.22 | $0.66 | 1 Mio. Kontext |
| DeepSeek V4 Flash (Peak) | $0.44 | $1.32 | Teurer als Luna beim Output |
| GPT-5.6 Luna | $0.20 | $1.20 | Preissenkung um 80% am 30. Juli |
| DeepSeek V4 Pro (Off-Peak) | $0.66 | $1.98 | Weiterhin etwa 6× günstiger als Terra |
| DeepSeek V4 Pro (Peak) | $1.32 | $3.96 | Etwa 3× günstiger als Terra |
| GPT-5.6 Terra | $2 | $12 | |
| Claude Sonnet 5 | $2 | $10 | Einführungstarif bis 31. August, danach $3/$15 |
Mit $0.66 pro 1 Mio. Output-Tokens unterbietet V4 Flash im Off-Peak GPT-5.6 Luna um 45% und Terra um das 18-Fache. Für Output-lastige High-Volume-Workloads bleibt DeepSeek damit am günstigsten. Im Peak schlägt Luna Flash aber bei beiden Standardtarifen: $1.20 statt $1.32 für Output und $0.20 statt $0.44 für Input. Lunas Cache-Read-Tarif von $0.02/M im AI Price Index Changelog ist allerdings zu jeder Tageszeit teurer als die Cache-Treffer-Schiene von Flash. Außerdem weist Flash in der offiziellen Spezifikationstabelle weiterhin 1 Mio. Tokens Kontext und 2,500 parallele Anfragen aus. Ein Kommentar im Ankündigungs-Thread bringt es treffend auf den Punkt: "DS4 is good but when cheap."
Was du diese Woche tun solltest
- Erst die eigene Rechnung neu kalkulieren. Zieh die Nutzungslogs des vergangenen Monats heran und berechne: Cache-Treffer-Input × Trefferquote × Trefferpreis + Input ohne Cache-Treffer × Fehlerrate × Fehlpreis + Output × Output-Preis. Wende je Anfrage den Peak- oder Off-Peak-Tarif ihres Zeitfensters an. Die Endpunkte aus dem Audit zeigen die Spannweite: 1.5× ohne Cache-Treffer, 2.7× bei 98% Trefferquote.
- Verschiebbare Jobs aus der Peak-Zeit holen. Cronjobs, Evaluierungen und Dokumentenverarbeitung – alles, worauf kein Nutzer wartet, kann in den 17 Off-Peak-Stunden laufen. Für US-Teams ist das fast kostenlos, weil der Arbeitstag ohnehin Off-Peak ist. EU-Teams sollten morgendliche Batches auf den Nachmittag verschieben.
- Weiterhin Cache-Treffer erzeugen. Behalte die Prompt-Struktur bei, die bei dir bereits Cache-Treffer liefert. Diese Schiene liegt noch immer rund 30× unter dem Preis für Input ohne Cache-Treffer.
- Flash für Routineanfragen testen. Pro kostet durchgehend das 3-Fache von Flash, bei Cache-Treffern das 3.1-Fache. Wenn du Flash seit dem Post-Training-Update 0731 nicht erneut evaluiert hast, leite einen Teil deines Routine-Traffics dorthin. Die Modell-Trade-offs behandeln wir in unserem Vergleich V4 Flash vs V4 Pro.
- Ein Wechsel kann wenig Aufwand bedeuten. Bei OpenAI-kompatiblen Clients musst du womöglich nur Base-URL und Modell-ID ändern. Drittanbieter-Hosts und Relay-Plattformen haben eigene Preislisten. DataLLM Lab dokumentierte Hosts, die V4 Pro schon vor dieser Erhöhung mit rund $1.74/$3.48 pro 1 Mio. Tokens abrechneten. Vergleiche daher den effektiven Preis, nicht nur den Listenpreis.
Die Entscheidung auf einen Blick:
| Dein Profil | Empfehlung |
|---|---|
| US-Zeitzone, Cache-lastiger Agent-Traffic | Bleiben – Off-Peak-Tarife und die rund 30× günstigere Cache-Schiene halten die Input-Kosten für Cache-lastigen Traffic niedrig |
| EU-Zeitzone, morgendliche Batch-Jobs | Bleiben, aber umplanen – Peak-Nutzung ist selbst verursacht und vermeidbar |
| Nur Peak-Zeiten, qualitätssensitives Coding mit Pro | Neu bewerten – Pro-Output im Peak ($3.96) liegt weiter unter Terra ($12), aber der Abstand beträgt jetzt 3× statt 14× vor dem 16. August |
| Einmalige Workloads ohne Cache | Bleiben – 1.5–2.3× im Off-Peak ist der kleinste Anstieg in der Tabelle |
FAQ
Wann genau traten die neuen DeepSeek-Preise in Kraft?
Am 16. August 2026 um 16:00 UTC, entsprechend Mitternacht am 17. August in Beijing. Das geht sowohl aus dem Ankündigungs-Thread als auch dem Audit mit 650 Calls auf r/DeepSeek hervor. Die offizielle Preisseite enthielt die neuen Tabellen noch am selben Tag.
Um wie viel steigt meine DeepSeek-Rechnung?
Ein Workload ohne Cache-Treffer steigt off-peak auf etwa das 1.5-Fache, ein gemessener Workload mit 98% Trefferquote auf das 2.7-Fache. In Peak-Stunden verdoppeln sich diese Werte; bei Pro-Input mit Cache-Treffer sind bis zu 12× möglich. Die Multiplikator-Tabelle weiter oben enthält alle Preispaare.
Welche Zeiten gelten in den USA als Peak?
US Eastern: 21:00–00:00 und 02:00–06:00. US Pacific: 18:00–21:00 und 23:00–03:00. Die üblichen US-Geschäftszeiten liegen vollständig in Off-Peak-Fenstern.
Sind deepseek-chat und deepseek-reasoner noch verfügbar?
Nein. Die Frist zur Abschaltung der alten Aliasse endete laut BenchLMs Historie der Modell-IDs am 24. Juli 2026. Neue Integrationen sollten deepseek-v4-flash oder deepseek-v4-pro aufrufen.
Ist DeepSeek weiterhin günstiger als GPT-5.6 und Claude?
Off-peak ja: Der Flash-Output liegt 45% unter GPT-5.6 Luna und um das 18-Fache unter Terra. Im Peak unterbietet Luna mit $1.20/M Output jedoch Flash mit $1.32/M. Die Antwort hängt also davon ab, wann dein Traffic läuft.