 AIREITER
如果你要跑长链路编程或 Agent 工作流,Kimi K3.1 Pro 的 API 定价颇有竞争力:100 万 Token 未缓存输入仅需 $2,100 万 Token 输出为 $10,同时提供 100 万 Token 上下文。以本文记录的发布首周工作负载来看,按量付费 API 的成本远低于 $39 订阅。
Kimi K3.1 Pro 到底是什么模型
Kimi K3.1 Pro 是 Moonshot AI 推出的首款 K3.1 系列模型,于 2026 年 10 月 23 日发布,是 Kimi K3 的后训练继任版本。Moonshot 将其定位为 3T 级混合专家模型,面向长周期编程、3D 与 CAD 工具工作流、财务文档分析以及多步骤 Agent。
它的上下文窗口为 1,048,576 Token,由输入、推理 Token 和输出共同占用;并不是“100 万输入再加 100 万输出”。通过 Moonshot 产品,模型可接收文本、图片和视频;API 则返回文本、代码与工具调用。Blender、游戏引擎、PDF 工具等外部软件负责生成最终视觉产物。推理功能始终开启,reasoning_effort 可选 low、high 和 max,默认值是 max。
Moonshot 曾承诺在 11 月 4 日前开放权重,但 TheQuery 在 10 月 24 日的核查中尚未确认可下载的检查点或最终许可证,ArtificialWatch 也将许可证状态列为未知。在检查点和许可证正式发布前,应按托管 API 使用来规划。
定价拆解:标准版与 Highspeed 差在哪
在 Kimi API 平台上,标准版 Kimi K3.1 Pro 的未缓存输入价格为每 100 万 Token $2,输出为每 100 万 Token $10。Kimi K3.1 Pro Highspeed 的按量计费 Token 价格翻倍,即输入 $4、输出 $20;但缓存输入读取仍维持每 100 万 Token $0.20。ArtificialWatch 和 AI/ML API 的价格表也列出了同样的 $2/$10 与 $4/$20 定价。
| 操作(每 100 万 Token) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| 未缓存输入 | $2.00 | $4.00 |
| 输出(含推理) | $10.00 | $20.00 |
| 缓存输入读取 | $0.20 | $0.20 |
| 缓存写入,5 分钟有效期 | $2.00 | $4.00 |
| 缓存写入,1 小时有效期 | $4.00 | $8.00 |
比起标价,真正影响账单的是三个细节。第一,所有上下文长度统一计价,默认缓存有效期为五分钟。在此期间复用提示词前缀,重复输入的价格会从 $2.00 降至 $0.20。第二,推理 Token 按输出费率计费,因此长 Agent 轨迹下的 max 推理强度可能成为账单大头。第三,API 消费与 Kimi 会员、Kimi Code 订阅完全独立;而且 TheQuery 对 Batch API 文档的核查发现其中未列出 K3.1 Pro,因此不要默认它可以享受批处理折扣。
按固定 Token 量计算,成本确实很低:100,000 个未缓存输入 Token 为 $0.20,加上 10,000 个输出 Token 的 $0.10,合计 $0.30。该数字尚未计入缓存写入、工具调用、重试和税费。
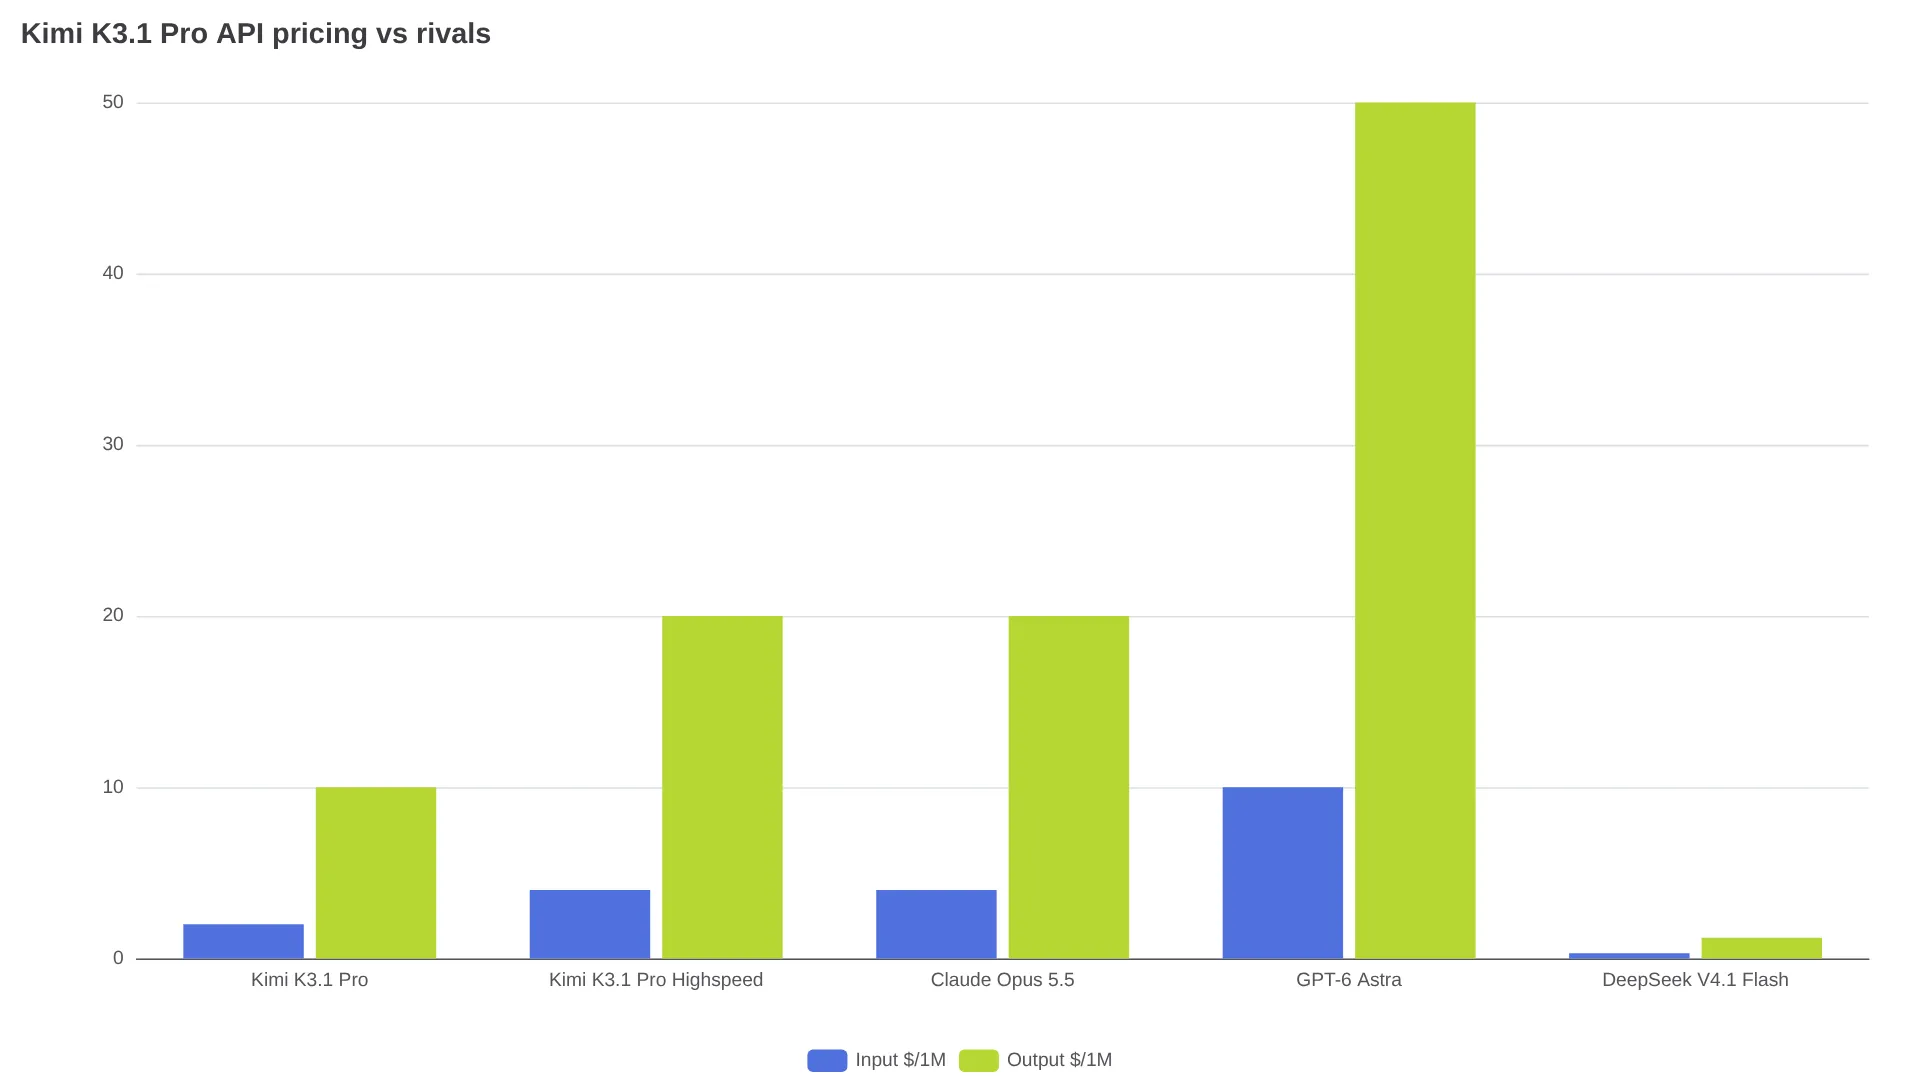
与竞品相比,标准版 K3.1 Pro 比 Kimi K3 定价($3/$15)低 33%,是 Claude Opus 5.5($4/$20)的一半,也是 GPT-6 Astra($10/$50)的五分之一;以上比较来自 ArtificialWatch。根据 AI/ML API 的价格表,DeepSeek V4.1 Flash 以 $0.30/$1.20 低于这里列出的所有竞品,但其基准成绩与下一节模型相比存在明显差距。Highspeed 的价格恰好与 Opus 5.5 持平,因此只有在其宣称的 2-3 倍速度提升能显著缩短延迟受限任务、足以抵消双倍 Token 成本时,才值得选择。
$39 订阅为何很快耗尽,API 却不会
发布当天,API 的价格看起来合理;订阅则并非如此。多位付费用户反映,5 小时额度在一两个提示词后就被耗尽,甚至一次编程任务就消耗了整月配额。
“Kimi K3.1 Pro 是目前全球最强的开源模型,没有竞争对手。但单靠它自己的订阅几乎无法使用。我订的是 $39 套餐,做了一次 ship 测试……它吃掉了我月度配额的 11.6%。这意味着我一个月大约只能做 8 次这样的东西……这是最糟糕的订阅……瓶颈不在质量,而在算力。”—— @Da7_Tech,用户报告的配额消耗情况
“Kimi K3.1 Pro 的使用限制实在令人恶心和羞耻。我的 5 小时限制在提示词刚开始 1 分钟后就用完了,而且什么都没做出来!”—— @MiaAI_lab,$39 套餐订阅用户
有用户称自己为四个提示词花了 $400 订阅费,估算通过 API 完成同样工作只需 $29;另有用户报告,单个动画任务消耗了大部分 5 小时配额。对开发者而言,结论很直接:应通过按量付费 API 来评估 K3.1 Pro,例如 Moonshot、OpenRouter 或 Vercel AI Gateway。在这里,100k 输入加 10k 输出的成本是 $0.30,未计入重试和工具调用;而不应依赖订阅配额,因为它对同样的推理工作计量严格得多。
怎么看基准成绩:先把厂商口径算进去
除非特别说明,以下主要分数均由 Moonshot 报告,测试采用最高推理强度、temperature 1.0 和 top-p 0.95。小幅差距应谨慎解读,因为竞品成绩使用了不同测试框架:Kimi 使用 Kimi Code,其他模型使用 Claude Code,而 GPT-6 Astra 在 OfficeQA 上使用 Codex,具体见 AI/ML API 的说明。
| 评测 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | 40.0% |
| Agents' Last Exam v1.1 | 43.2% | 42.6% | 32.8% | 37.7% |
| OfficeQA Pro v2 | 64.4% | 62.2% | 54.4% | 40.4% |
| BenchCAD with tools | 92.7% | 96.2% | 95.9% | 81.6% |
Kimi 在五项中领先三项;在 Terminal-Bench 上则落后 0.7 个百分点。正如 TheQuery 所指出,这一差距小于 Anthropic 为 Opus 报告的 2.6 个百分点标准误差。BenchCAD 的 92.7% 指的是 1,000 个案例开放模型子集上的体素重叠率;Claude 的成绩则直接引自系统卡,并非在统一环境下重新运行,详见 AI/ML API 的方法说明。
在事实准确性上,根据 AI/ML API 的 Hallu 表格,Moonshot 内部 Kimi Hallu Bench 显示,K3.1 Pro 在标准集上的主张级错误率为 5.4%,GPT-6 Astra 为 4.2%;在带工具的 Hard 集上,二者分别为 8.3% 和 5.5%。相较于 K3 在 Hard 集上的 23.4%,K3.1 Pro 实现了 65% 的相对下降,但 Astra 在两个划分上仍然领先。因此,如果单个错误主张就会毁掉最终结果,Astra 仍应留在候选清单中。这些测试都属于对抗性压力测试,并不等同于日常使用中的错误概率。
发布时唯一的独立数据来自 Artificial Analysis:该机构在 Intelligence Index 中给 K3.1 Pro 打出 55 分,并将其总排名列为第 4,排在 Claude Opus 5.5、Sonnet 5.5 和 Muse Wonder Full 之后。这个位置支持“以半价获得接近前沿能力”的说法,而不只是依赖厂商自测。
如何接入,同时避免多花钱
Kimi K3.1 Pro 兼容 OpenAI API,因此迁移通常只需要更换 base URL 和模型 ID。根据 TheQuery 的端点核查及 AI/ML API 接入指南,官方 base URL 为 https://api.moonshot.ai/v1,模型 ID 为 kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed。第三方网关会使用带命名空间的 ID,例如 Requesty 上的 moonshot/kimi-k3.1-pro,或 Vercel 上的 moonshotai/kimi-k3.1-pro。
根据 TheQuery 对 API 行为的说明,快速入门将 temperature 固定为 1.0、top-p 固定为 0.95,并建议省略这两个参数而不是自行调节。成本控制应通过 reasoning_effort 完成:探测任务先用 low,任务失败后再升到 high,最终运行才使用默认的 max。即使设置了 8,192 Token 的 max_completion_tokens,可见回答仍可能很短,因为隐藏推理会消耗同一预算,并按每百万 $10 的输出价格收费。
依据 AI/ML API 的工具调用和 Token 使用建议,可按以下清单控制成本:
- 工具调用步骤之间要保留完整的 assistant 消息;使用流式输出时还应保留
reasoning_content,并在下一次调用前返回工具结果。 - 在 5 分钟缓存窗口内复用提示词前缀,可将重复输入降至每 100 万 Token $0.20。
- 衡量每个被接受结果的成本,而不是只看每 Token 单价。
- 单价更低、却需要重试两次的模型,并不是真的更便宜。
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
根据 TheQuery 对 API 行为的核查,充值 $1 即可开通访问权限,但仍受分层速率限制约束;企业访问默认关闭,需由管理员启用。隐私方面,Opper 对 Moonshot 路由的审计称,该路由默认保留内容,并将客户数据用于训练,且不提供零数据保留选项。未经合同层面的保障,不要通过该路由发送机密或受监管数据。
该不该用:真正需要权衡的点
| 你的需求 | 选择 | 原因 |
|---|---|---|
| 最低成本的前沿级编程运行 | Kimi K3.1 Pro API | 以 Opus 一半价格领先 SWE-Marathon,支持 100 万共享上下文 |
| 最低延迟 | Kimi K3.1 Pro Highspeed | 宣称速度提升 2-3 倍,但 Token 成本恰好翻倍 |
| 最少事实错误 | GPT-6 Astra | 标准 Hallu 为 4.2%,Kimi 为 5.4%,但价格为其 5 倍 |
| 最低 Token 成本,接受较弱分数 | DeepSeek V4.1 Flash | $0.30/$1.20,但在列出的五项基准中有四项最低 |
| 自托管 | 等待 | 权重承诺于 11 月 4 日前发布,许可证未知 |
如果 Moonshot 在 11 月 4 日前以宽松许可证发布完整权重,自托管可能会彻底改变“配额还是 API”的成本计算。比较长上下文编程模型的开发者,也应在决定前查看 2026 年最佳编程 Agent LLM。
Kimi K3.1 Pro API 常见问题
Kimi K3.1 Pro API 怎么收费?
标准版 Kimi K3.1 Pro 的未缓存输入为每 100 万 Token $2,输出为每 100 万 Token $10,缓存输入读取为每 100 万 Token $0.20。Highspeed 的输入、输出和缓存写入费率均翻倍,但缓存读取仍为每 100 万 Token $0.20。
K3.1 Pro 与 Highspeed 有什么区别?
Highspeed 宣称在相同智能水平下提供 2-3 倍服务速度,输入/输出价格则翻倍,分别为 $4/$20 和 $2/$10。Vercel 的实时提供商表格显示 Highspeed 具有更低延迟和更高吞吐量,但 Moonshot 的加速说法尚无独立的任务完成时间对比支持。
API 模型 ID 是什么?
官方 Kimi API 使用 kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed;第三方网关则使用带命名空间的对应名称,例如 moonshot/kimi-k3.1-pro。已有 K3 集成必须显式切换模型 ID。
Kimi 会员包含 API 使用额度吗?
不包含。API 费用与 Kimi 会员和 Kimi Code 订阅分开计算,发布首周的用户发现:面对同一工作量,订阅配额比按量付费 Token 严格得多。
能关闭推理吗?
不能。Kimi K3.1 Pro 始终进行推理;low、high 和 max 只能降低思考强度,默认是 max。短小且不需要推理的请求,应使用其他模型。
API 是否兼容 OpenAI?
兼容。将 OpenAI SDK 客户端指向 https://api.moonshot.ai/v1(或网关 base URL),设置模型 ID,并通过 stream=True 启用流式输出即可。快速入门固定使用 temperature 1.0 和 top-p 0.95;应改为调节 reasoning_effort 和 max_completion_tokens。