 AIREITER
如果你这周就要拿到可自托管的模型 checkpoint,答案很明确:两者中只有 MiniMax M3.1 Flash 能下载。它的开放权重现已上线;Kimi K3.1 Pro 目前尚未发布权重,Moonshot 承诺将在 2026 年 11 月 4 日前放出。
目前 Hugging Face 上只有 MiniMax 可下载
MiniMax 在 2026 年 10 月 22 日至 23 日前后,于 Hugging Face 发布 M3.1 Flash 权重,采用 minimax-community 许可;发布报道显示 ModelScope 也可获取(Cocoloop)。Kimi 官方技术博客则表示,Kimi K3.1 Pro 现可通过 Kimi.com、各端应用、Kimi Code 和 Kimi API 使用,完整模型权重将在 2026 年 11 月 4 日前发布(kimi.com)。
MiniMax M3.1 Flash 与 Kimi K3.1 Pro:关键规格对照
MiniMax M3.1 Flash 是原生多模态 MoE 开放权重模型,总参数量约 4280 亿,每个 token 激活 230 亿参数;支持文本、图像和视频输入,文本输出,最长上下文可达 100 万 token(MiniMax 发布文章)。官方将 Kimi K3.1 Pro 描述为 3T 级 MoE,拥有 100 万 token 上下文窗口(kimi.com)。至于 2.8T 总参数、104B 激活参数,这些数据来自发布报道(ArtificialWatch、ExplainX),并非 Moonshot 官方披露。
| 项目 | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| 总参数 / 激活参数 | 约 428B / 每 token 23B | 3T 级;发布报道为 2.8T / 104B 激活 |
| Hugging Face 仓库 | MiniMaxAI/MiniMax-M3.1-Flash,已上线 | 截至 2026 年 10 月 24 日尚无;预计 11 月 4 日前发布 |
| 下载体积 | 约 252 GB | 未知;若按 MiniMax 的密度计算(约每 B 参数 0.59 GB),2.8T checkpoint 将达到 TB 级 |
| 上下文 | 最高 100 万 token(取决于部署配置) | 100 万 token |
| 输入 / 输出 | 文本、图像、视频输入;文本输出 | 多模态、文本输出;自托管时的确切模态尚未确认 |
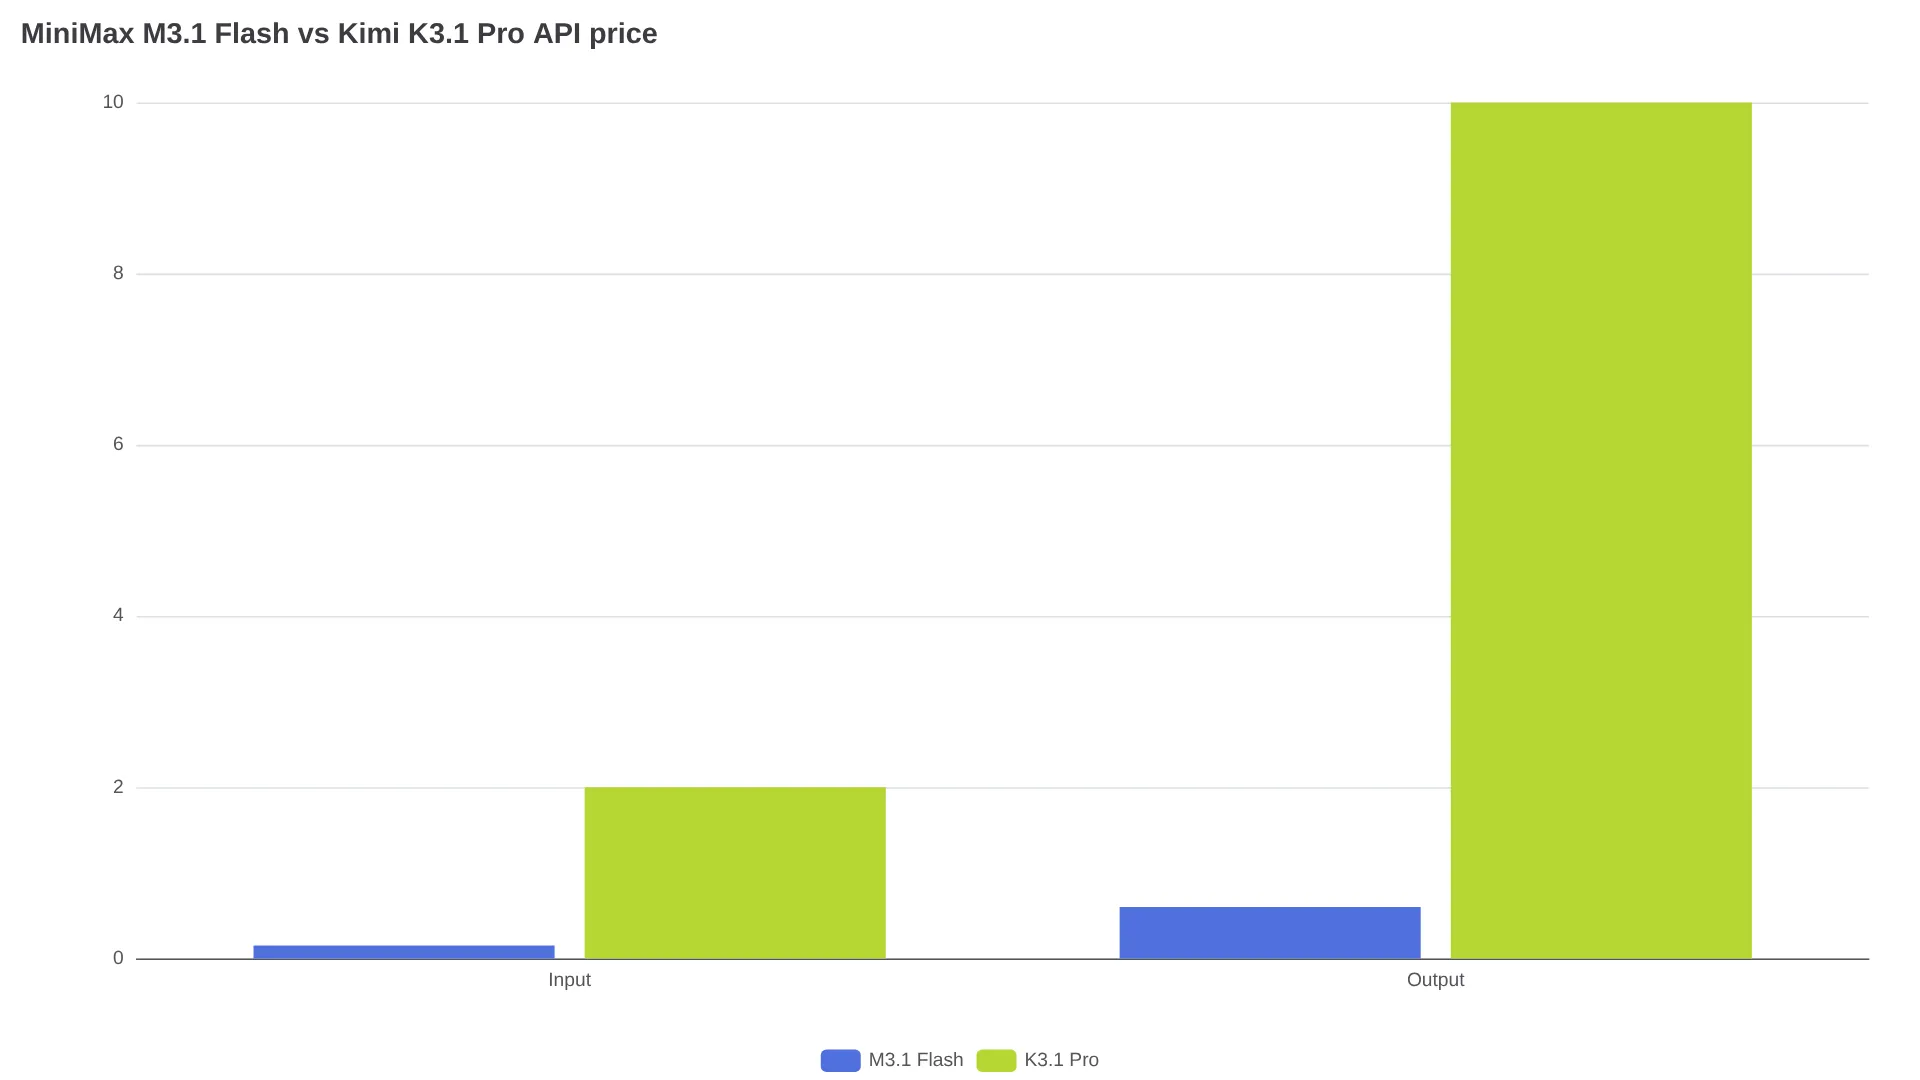
| 官方 API 价格 | 每 100 万 token:输入 $0.15 / 输出 $0.60 / 缓存 $0.015(MiniMax) | 报道价格为每 100 万 token:输入 $2 / 输出 $10(ArtificialWatch) |
| 推理部署方案 | SGLang、vLLM、TokenSpeed;多芯片可用 FlagOS | 尚未公布;API 模型 ID 为 kimi-k3.1-pro / kimi-k3.1-pro-highspeed(Kimi 文档) |
| 推荐采样参数 | Temperature 1.0、top-p 0.95;推理档位 low–max | Kimi 基准配置为最高推理强度、temp 1.0、top-p 0.95 |
可通过官方命令拉取 MiniMax checkpoint:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash开始跑基准前,请确认文件集完整,其中包括 DSpark draft head、tokenizer 和配置文件。MiniMax 提醒,相关结果适用于官方权重,第三方量化版本的表现可能不同。
下面的基准分数除特别标注外,均应视为厂商自行报告:
| 基准测试 | M3.1 Flash(厂商数据) | 厂商引用的对手成绩 |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017:60.5 |
| BankerToolBench | 76.2 | Opus 5:76.2(并列) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol:60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017:77.0 |
| OSWorld 2.0 | 61.7 | Opus 5:70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5:51.8 |
一份被引用的独立快照显示,M3.1 Flash 以 53.78% 排在 26 个模型中的第 16 位,长周期任务得分偏弱(Vals)。Kimi 自己的图表则称,K3.1 Pro 在展示的 14 项测试中有 6 项领先,包括 Agents' Last Exam(43.2)和 SWE Marathon(51.7);其 Terminal-Bench 4.0 得分为 65.7。
下载 252 GB 后,自托管到底要花多少
该仓库体积约 252 GB。按每个权重 4 bit 计算,仅 428B 参数就约为 214 GB,尚未计入 KV cache 和运行时缓冲区。因此,要获得真正可用的上下文长度,应预留多张 80 GB 级 GPU。NVIDIA 的 RTX Spark 账号建议本地运行使用 DGX Station,或由 4 台 DGX Spark 128 GB 组成的集群(X post)。X 上的自托管用户也指出,252 GB 的下载量加上这一硬件门槛,已将普通桌面设备排除在外,而 API 仍然相当便宜(@bufcapy)。
先算 API 账通常更实际,因为 MiniMax API 的价格异常低。按每 100 万 token 输入 $0.15、输出 $0.60 计算,一天消耗 1000 万输入 token 加 200 万输出 token,成本为 10 × $0.15 + 2 × $0.60 = $2.70,即每月约 $81。
盈亏平衡的计算方式很简单:用每月集群成本除以每 token 的 API 成本。按每 100 万输入 token $0.15 计算,每月 $150 的租赁费用相当于 10 亿输入 token;按每 100 万输出 token $0.60 计算,每月 $600 相当于 10 亿输出 token。把你自己的租赁报价和工程人力投入代入即可:只有当按这些价格计算的月度 API 账单超过总成本,或者政策要求权重必须留在你的安全边界内时,自托管才更划算。Kimi 的差距更明显:其报道中的 API 价格为每 100 万 token $2/$10,输入约为 MiniMax 的 13 倍,输出约为 17 倍。因此,未来若要自托管一个 2.8T 参数 checkpoint,必须具备非常高且持续的吞吐需求,才能抵消 TB 级存储和多节点集群的成本。
第一天自托管,能用到哪些能力
首发当天的框架支持确实存在,但并不完整。模型卡列出了 SGLang、vLLM、TokenSpeed,以及面向多芯片部署的 FlagOS,并提供 SGLang Docker 镜像;Transformers、KTransformers、unsloth 和 ATOM 的集成在发布时仍在推进中。一位部署者指出,vLLM 的 H100/H200 示例配置目标上下文为 256K,而非完整的 1M;同时关闭了视频输入,也没有启用 DSpark 推测解码(@sancaksofttech)。下载的是同一套权重,但并非所有部署方案都能解锁全部特性。
r/LocalLLaMA 社区中反复出现的担忧是:“Flash”说的是推理经济性,并不意味着模型体积小:
量化后能塞进 256GB 吗?祈祷中 —— u/BawbbySmith,来自 r/LocalLLaMA
比硬件更早决定能否使用的许可条款
M3.1 Flash 是开放权重,不是开源模型。仓库的 LICENSE 文件标注为 minimax-community,详见 LICENSE file:非商业用途可自由使用;商业使用须显著展示 "Built with MiniMax M3.1-Flash",并向 MiniMax 发送一次性通知。年收入超过 $20M 的组织或产品需要事先取得书面授权,军事用途则被禁止。
对内部工具而言,这些要求负担不大;但对于商业托管服务,标识要求和收入门槛可能成为实质障碍。Kimi 的许可要等到 11 月 4 日权重发布后才能确定。Moonshot 已在技术博客中说明,开放 checkpoint 将与 API 模型不同,因为与网络安全相关的训练数据已从开放权重中移除(kimi.com)。动手构建前,请先阅读两者的 LICENSE 文件。
按你的场景怎么选
| 你的情况 | 建议选择 |
|---|---|
| 这周就需要权重做本地评测、微调底座或隔离网络部署 | MiniMax M3.1 Flash——两者中唯一可下载的选择 |
| 在意成本、负载波动较大的编程 Agent | MiniMax API,价格为 $0.15/$0.60——只有持续高用量时才考虑自托管 |
| 追求前沿的长周期编程能力,并且可以等待 | 现在评估 Kimi K3.1 Pro API;等到 11 月 4 日权重、许可和实际体积公布后,再决定是否自托管 |
| 商业托管产品 | 先让法务确认 MiniMax 的署名要求和 $20M 授权门槛;Kimi 在许可发布前无法判断 |
| 消费级 GPU 或单台 Mac | 没有经过验证的单设备方案——除非准备测试不受支持的配置,否则使用 API |
常见问题
MiniMax M3.1 Flash 的官方权重在哪里下载?
官方仓库位于 Hugging Face,名称为 MiniMaxAI/MiniMax-M3.1-Flash,同时提供 ModelScope 镜像;可通过 hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash 下载。
Kimi K3.1 Pro 有官方 Hugging Face 仓库吗?
没有。截至 2026 年 10 月 24 日,尚无公开的 K3.1 Pro 权重仓库;Moonshot 技术博客承诺将在 2026 年 11 月 4 日前发布完整权重。
MiniMax M3.1 Flash 可以用于商业用途吗?
可以,但有条件:须展示 "Built with MiniMax M3.1-Flash",发送一次性通知;年收入超过 $20M 时还需事先取得书面授权。军事用途被禁止。请让法律顾问依据仓库 LICENSE 确认具体要求。
它能运行在消费级 GPU 或 Apple Silicon 上吗?
所引用的部署指引没有提供经过验证的单张消费级 GPU 方案;估算显示,量化权重加 KV cache 需要多张 80 GB GPU。NVIDIA 建议使用 DGX Station,或 4x DGX Spark 128 GB 集群。
现在能通过 vLLM 或 SGLang 部署吗?
可以,两者都有首发部署方案,另有 TokenSpeed 和用于多芯片运行的 FlagOS。不过,示例配置可能将上下文限制在 256K、关闭视频输入,或不启用 DSpark——请根据你的硬件查看模型卡中的最新方案。
自托管时能用满 100 万 token 上下文吗?
标称上限是 100 万 token,但实际可用长度取决于 GPU 显存和推理服务配置。运行长上下文任务时,应明确为 KV cache 预留空间。
延伸阅读:MiniMax M3.1 Flash Open Weights: Download, Run, Cost Guide、Kimi K3.1 Pro API Pricing Guide、Kimi K3 Open Weights