 AIREITER
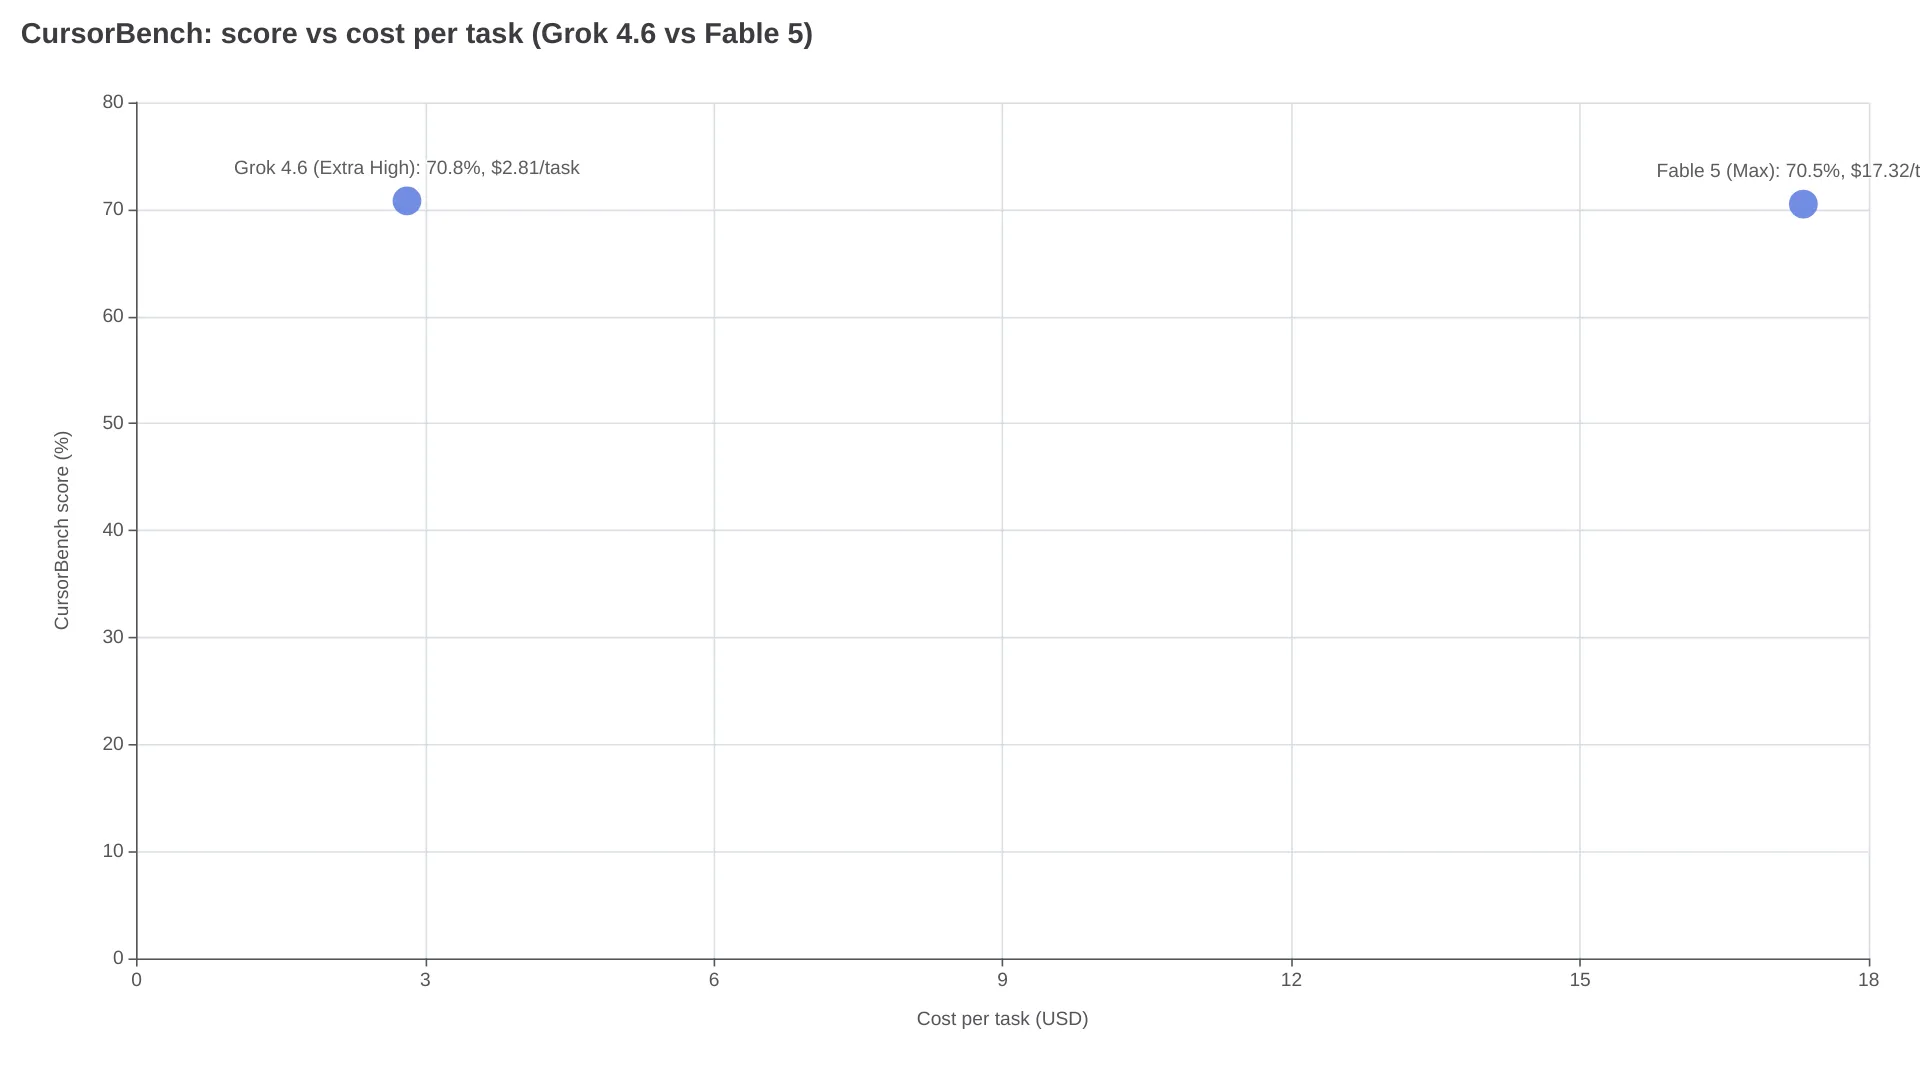
如果只看 CursorBench,Grok 4.6 Extra High 和 Fable 5 Max 已经难分高下:前者完成任务的得分为 70.8%,单任务成本 $2.81;后者得分 70.5%,成本却达到 $17.32。编程 Agent 的成绩几乎打平,但每完成一个任务的花费相差 6 倍。Fable 5 仍保有两项关键优势:它继续位居更广泛的 Artificial Analysis 智能指数榜首,上下文窗口也是 Grok 的两倍。
Grok 4.6 如何追近 Fable 5
两个月前,这组对比的结论还很明确。2026 年 7 月,Artificial Analysis 给 Grok 4.5 的 Intelligence Index 评分是 56,Fable 5 则为 62,双方相差 6 分。2026 年 8 月发布的 Grok 4.6,依据已报道的基准测试变化,估计提升了 5 分至约 59 分,与 GPT-5.6 Sol 大致持平,Fable 5 的领先幅度由此缩小至约 3 分。
到了编程 Agent 场景,差距又进一步收窄。Fable 5 于 2026 年 6 月进入 Cursor 时,在 CursorBench 创下 72.9% 的新纪录(r/accelerate),比此前最佳成绩高出 8 个百分点。Grok 4.6 发布后,r/cursor 在 8 月发布的一次正面对比中,Grok 4.6 Extra High 得到 70.8%,Fable 5 Max 为 70.5%。两者使用同一套 Agent 测试框架,实质上可以视为平局。不过,参与测试的一位 Cursor 用户提出了一个值得记住的疑问:
“Grok 4.6 让我开始思考:CursorBench 的成绩究竟有多少来自模型,又有多少来自测试框架?”——r/cursor 讨论帖,2026 年 8 月
基准分数衡量的是完整的 Agent 栈,包括提示词脚手架、工具与重试机制,并非单纯反映底层模型。Fable 5 首发时的 72.9% 与 8 月对比中的 70.5% 也来自不同配置,因此两项结果更适合用于判断趋势,而非直接下定论。
单任务成本:Grok 4.6 的优势最明显
8 月这次对比中,真正拉开差距的是单任务成本:
| 指标(CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| 得分 | 70.8% | 70.5% |
| 单任务成本 | $2.81 | $17.32 |
| 每任务步骤数 | 46 | 72 |
Fable 5 要用多 57% 的 Agent 步骤才能达到相近得分;更多步骤以及随之产生的推理 Token,也与成本差距相互印证。因此,在两个模型间切换过的开发者开始质疑,只看标价是否还合理:
“$/token 正在变成比较 AI Agent 的错误方式。”——r/grok 帖子标题,2026 年 8 月
按 Token 计费的公开标价可以解释部分差异。Fable 5 在 Anthropic API 上的价格是每百万输入 Token $10、每百万输出 Token $50。xAI 公布的 Grok 4.5 API 价格为:提示词低于 200K Token 时,每百万输入 $2、输出 $6;xAI 尚未公布单独的 4.6 价目表,而 r/grok 社区称 4.6 达到了“Sol 级别性能,但 API 价格只是其中一小部分”。如需了解 Fable 5 各档位的完整费率,可查看Fable 5 API 定价拆解。
但实际使用中,有两点会缩小这一优势。按 xAI 已公布的费率,提示词超过 200K Token 后,Grok 的价格大致翻倍,达到每百万输入 $4、输出 $12;此外,如果你的工作流本就高度依赖 Fable 5,也可以先通过一些结构性方法降低 Fable 5 的 Token 成本,再决定是否换模型。
Fable 5 依然领先的地方
| 维度 | 依据 | 对你的意义 |
|---|---|---|
| 智能指数 | Fable 5 仍位居 AA Intelligence Index 第 1:62 分,对比 Grok 4.6 的约 59 分 | 4.6 的提升抹去了旧有 6 分差距中的一半,Fable 5 仍领先约 3 分 |
| 上下文窗口 | Fable 5 提供 1,000,000 Token 上下文;Grok 为 500,000 | 大型代码库加上任务历史可一次装入上下文,而 Grok 超过 200K Token 后的价格优势也会缩小 |
| 高难任务可靠性 | 在 TryAI 的构建测试中,Fable 5 首次尝试就渲染出 3D 魔方,并产出最佳 SVG;Grok 4.5 需要重新运行。Goldie Bench 在 47 项一次性任务中以 20 比 17 判定 Fable 5 领先,后者在着色器和 GPU 物理构建任务上领先 0.8 至 1.6 分 | 任务模糊且只能一轮完成时,Fable 5 的推理上限更能体现出来 |
响应速度、延迟与吞吐量
以下是 TryAI 的实测数据:相同供应商路由、400 Token 上限、每种提示词类型运行三次。
| 指标 | Grok 4.5 | Fable 5 |
|---|---|---|
| 首 Token 时间 | 0.44 秒 | 3.47 秒 |
| 吞吐量 | 110 tok/s | 28 tok/s |
| 每次回复成本 | $0.00002 | $0.00009 |
| 成功率 | 100% | 100% |
Grok 的生成速度达到 110 tok/s,大约是 GPT-5.5 和 Opus 4.8 的两倍,也约为 Fable 5 的 28 tok/s 的四倍。Artificial Analysis 给出的 Fable 5 高强度推理数据更严苛:其首个回答 Token 需要 113.68 秒,而 Grok 为 8.68 秒;不过开始流式输出后,Fable 5 的解码速度略快,为 63.1 tok/s,Grok 为 58.9 tok/s。换成实际体验来说,Grok 在交互式循环中更利落;Fable 5 会先投入较长时间思考,并将代价反映在总耗时上。
接入方式、订阅与 Agent 工具生态
Fable 5 可通过 Anthropic API、Claude Code 和 Cursor 使用;对于多数非 API 使用场景,Claude Pro 的固定订阅费即可覆盖。Claude Code 生态经过多年发展,CLAUDE.md、插件、skills 和 MCP servers 都相当成熟。
Grok 4.6 可通过 xAI API 和 Grok Build CLI 使用(curl -fsSL https://x.ai/cli/install.sh | bash),X Premium 则捆绑提供聊天访问权限。根据 ClockedCode,Grok Build 无需任何配置,就能读取现有的 CLAUDE.md 文件、Claude Code 插件、skills、MCP servers、agents 和 hooks;它还可通过 -p 参数以无头模式运行,用于 CI,并提供 Agent Client Protocol 供嵌入集成。它的生态更年轻,但对 Claude Code 的兼容性使兼容环境下的迁移成本几乎为零。
两者还有一个共同的计费现实:Claude Pro 和 X Premium 订阅用户支付的是固定费用,因此在真实工作负载下,使用额度限制往往比价目表更重要。
按使用场景选择
| 你的场景 | 推荐 | 原因 |
|---|---|---|
| 高频、需求明确的编程任务 | Grok 4.6 | CursorBench 得分打平,但单任务 $2.81,对比 $17.32 |
| 大型代码库中对正确性要求极高的工作 | Fable 5 | 1M 上下文窗口、智能指数第 1、首轮尝试可靠性最佳 |
| 交互式 Agent 会话和快速迭代 | Grok 4.6 | 首 Token 仅 0.44 秒,吞吐量 110 tok/s |
| 需求模糊的一次性构建、高难推理 | Fable 5 | 赢得 TryAI 最难任务及 Goldie Bench 正面对比 |
| API 预算受限 | Grok 4.6 | 输出 Token 单价约为 Fable 5 的八分之一 |
我的看法是:范围明确、重复性高的工作,默认使用 Grok 4.6;一旦错误答案的代价高于 Token 成本,则留给 Fable 5。真正有一定调用量的团队应同时运行两者,再根据典型任务规模、重试率和完成任务成本进行路由——这比只押注其中一个更划算。
常见问题
Grok 4.6 编程能力比 Fable 5 更强吗?
在 CursorBench 上,两者打平:8 月对比中,Grok 4.6 Extra High 为 70.8%,Fable 5 Max 为 70.5%。不过,Fable 5 在更广泛的 Artificial Analysis 智能指数中仍领先,62 分对约 59 分,并且在最难的一次性任务中胜出。因此,谁“更强”取决于你的瓶颈是单任务成本,还是正确性上限。
Grok 4.6 比 Fable 5 便宜吗?
是的。按完成一个 CursorBench 任务计算,Grok 4.6 大约便宜 6 倍:$2.81 对 $17.32。按 Token 的比较采用的是 Grok 4.5 已公开费率,即每百万输出 Token $6,对比 Fable 5 的 $50,因为 xAI 尚未发布独立的 4.6 价目表;超过 200K Token 后,Grok 的价格大致翻倍,价差会随之缩小。
哪个模型的上下文窗口更大?
Fable 5,为 1,000,000 Token;Grok 为 500,000 Token。对于需要把整个代码库保留在上下文中的工作负载,这项差异可能比 Grok 的价格优势更重要。
Grok Build 能使用我的 Claude Code 配置吗?
可以。Grok Build 会自动读取 CLAUDE.md、Claude Code 插件、skills、MCP servers、agents 和 hooks,无需迁移;它还新增了自己的 .grok/ 目录,用于 Grok 专属配置。
Grok 4.5 的基准成绩可以代表 Grok 4.6 吗?
不能用于判断能力。相较 4.5,Grok 4.6 的 Intelligence Index 约提升 5 分,将相对 Fable 5 的 6 分劣势缩小至约 3 分;在 CursorBench 上,它也追平了 Fable 5 Max,而 4.5 此前明显落后。本文的速度和按 Token 计费数据仍来自 Grok 4.5 测试,因为目前尚未公布对应的 Grok 4.6 数据。
这项取舍不会有简单答案
这组对比中的任何一项基准测试,都无法回答这样的问题:当代码库达到 50,000 行、工单描述模糊、一次失败意味着要花一小时调试时,成本优势是否还成立?Fable 5 的 1M 上下文和更高智能上限,恰恰就是为这种情况准备的——一边是昂贵的确定性,一边是 Grok 4.6 低成本的执行步骤;两者差异足够大,因此多数团队会同时保留两个模型。
相关阅读:Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5