 AIREITER
在 Artificial Analysis Intelligence Index 上,Grok 4.6 以约 61 分对阵 GPT-5.6 Sol 的 58.9 分,整体能力已相当接近;但按输出 token 计费,Sol 的价格高出 5 倍。不过,这并不意味着 Grok 在所有场景都更划算:Sol 的上下文窗口约为其两倍,在智能体效率相关评测中也表现更强,实际价值仍要结合工作负载判断。
综合智能分数接近,但它没有说明全部问题
Artificial Analysis Intelligence Index v4.1 将推理、编程和知识类任务汇总为单一分数。根据 OpenAI 公布的数据,GPT-5.6 Sol 得分为 58.9;而引用 Artificial Analysis Arena 数据的社区报告称,Grok 4.6 得分约为 61。这个社区数据尚未获得独立确认,但与 Artificial Analysis 将 Grok 4.6 视为 Sol 同级模型的判断方向一致。
单一综合分数会掩盖上下文长度、智能体执行效率和具体基准波动等差异。按照 OpenAI 公布的结果,Sol 在 Terminal-Bench 2.1(88.8%)和 DeepSWE v1.1(72.7%)等重度智能体评测中优势明显;Grok 4.6 对应的具体分数目前尚未独立公开。Intelligence Index 表明两者通用智能接近,但智能体基准可能会得出不同结论。
| 规格 | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| 开发商 | xAI | OpenAI |
| 上下文窗口 | 500K tokens(x.ai/api) | 约 1,050,000 tokens(openai.com) |
| API 输入价格(每 1M) | $2.00(x.ai/api) | $5.00(openai.com) |
| API 输出价格(每 1M) | $6.00(x.ai/api) | $30.00(openai.com) |
| Intelligence Index v4.1 | 约 61(社区报告) | 58.9(官方数据) |
| 云服务可用性 | Azure AI Foundry、Oracle OCI、Google Vertex(x.ai/api) | Azure、AWS Bedrock(openai.com) |
API 定价:输入便宜 2.5 倍,输出便宜 5 倍
xAI 的 API 页面显示,Grok 4.6 的输入价格为每百万 tokens $2.00,输出为 $6.00。根据 OpenAI 的 GPT-5.6 页面,Sol 的输入和输出价格分别是每百万 tokens $5.00 与 $30.00。
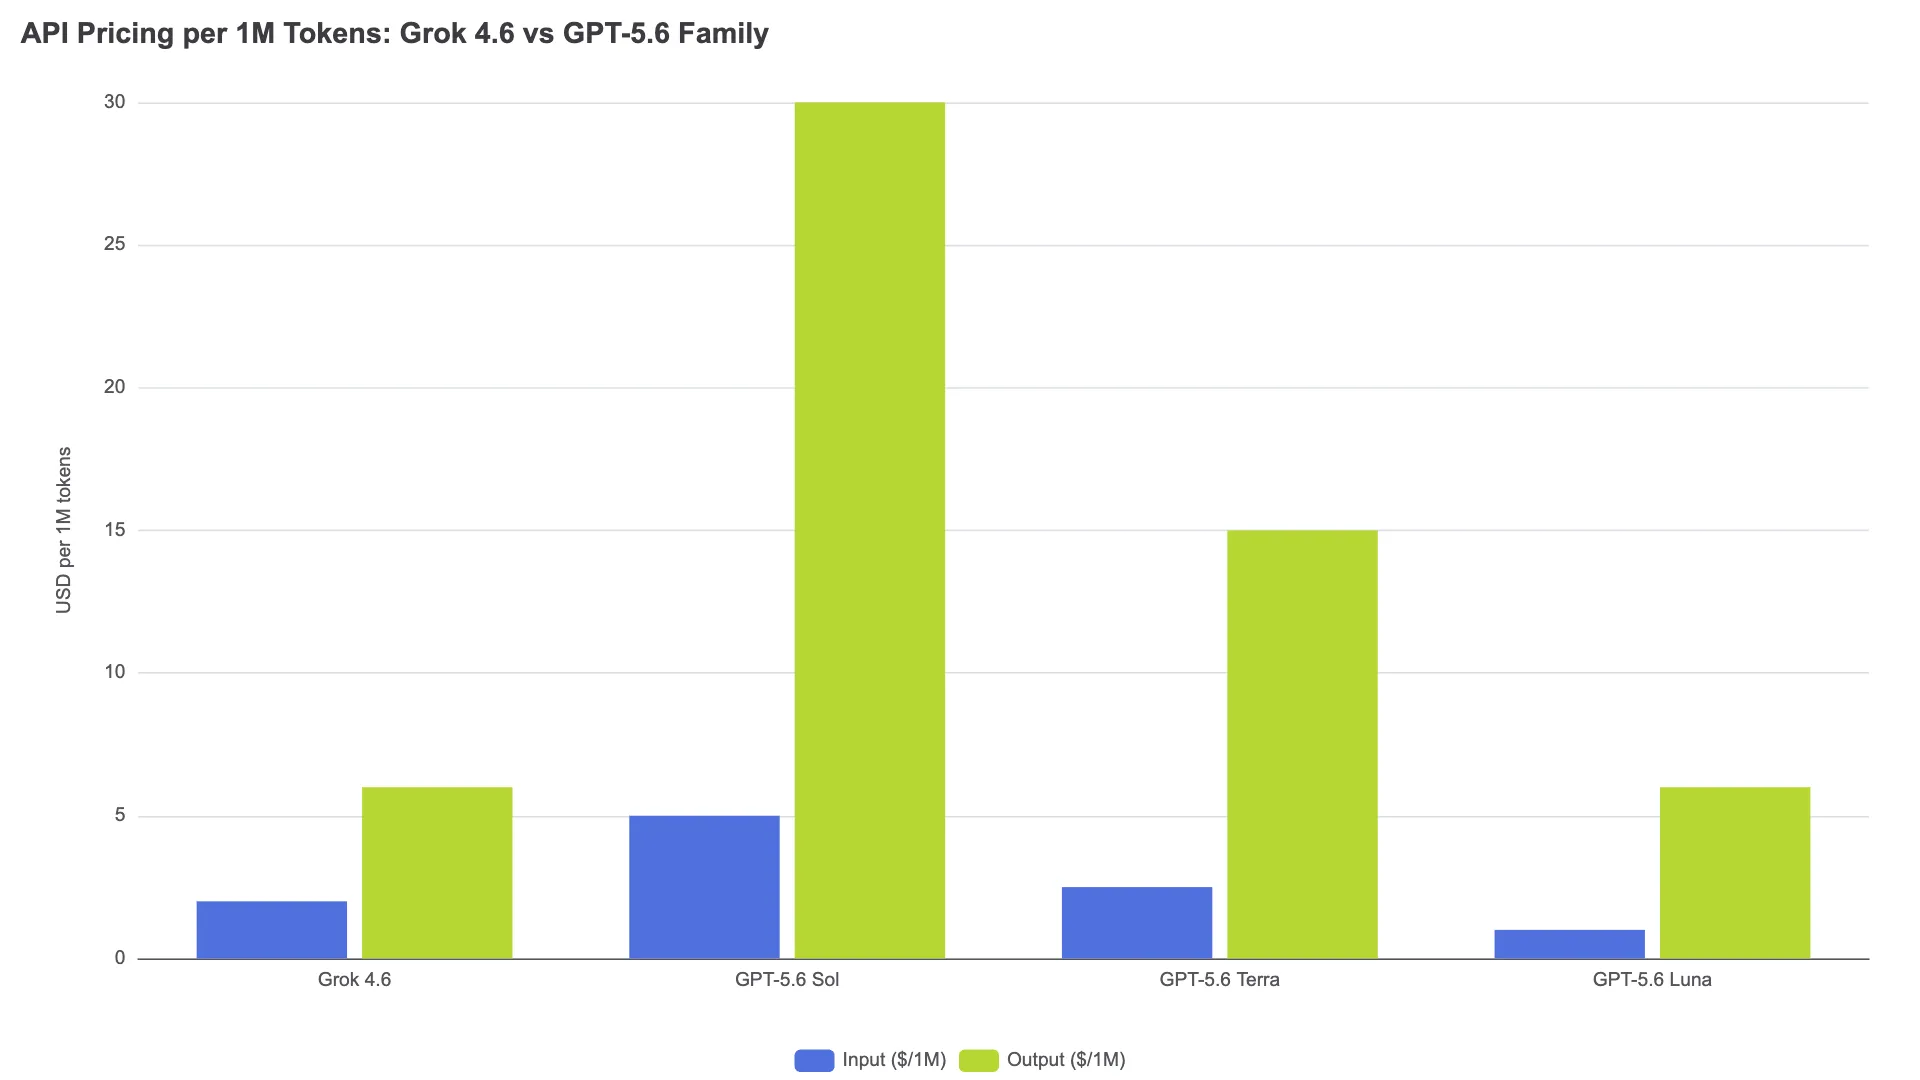
假设每月工作负载消耗 50M 输入 tokens 和 10M 输出 tokens,Grok 4.6 的费用是 $160,Sol 则为 $550。两者相差 3.4 倍,且这还未计入 Sol 的推理模式在单项任务中可能消耗更多 tokens。
OpenAI 也提供更便宜的档位:GPT-5.6 Terra 的价格是 $2.50/$15.00,GPT-5.6 Luna 则为 $1.00/$6.00(Luna 的价格于 2026 年 7 月 30 日下调 80%)。Luna 的输出价格与 Grok 4.6 相同,输入价格还更低,但它是更小的模型,各项基准分数也更低。若要比较智能水平接近的模型,Grok 4.6 与 Sol 才是更诚实的对照;在这个前提下,Grok 的成本优势很显著。
上下文窗口:500K 对 1M tokens
根据 xAI 的 API 页面,Grok 4.6 的上下文窗口为 500K tokens;按照 OpenAI 文档,Sol 约为 1.05 million tokens。500K tokens 足以覆盖常规组件、模块以及大部分服务级编程任务。只有在需要把整个 monorepo、多份大型文档,或很长的对话历史一次性塞进提示词时,Sol 的 1M 窗口才会真正拉开差距。若你的智能体工作流要单次分析 800K tokens 的代码库上下文,Sol 可以处理,Grok 4.6 则不行。
另一个关键点是检索可靠性。OpenAI 称,Sol 在 1M tokens 长度下的 GraphWalks BFS 得分为 77.1%。Grok 尚未发布可对照的长上下文检索分数。如果你的场景是“在这个 600K-token 代码库里找 bug”,Sol 更大的窗口不只是容量更高,也关系到模型能否从如此深的上下文中实际找回所需信息。
编程与智能体基准:差距主要在哪里
Intelligence Index 的接近并不代表两者在编程专项基准上同样接近。下表列出 OpenAI 公布的 GPT-5.6 Sol 官方成绩,以及 Fritz.ai 报道的 Grok 4.5 结果作为参考。Grok 4.6 的专项编程基准尚未独立发布,因此 Grok 一列只能视作前代参考,不能当作 Grok 4.6 的直接对比结果:
| 基准测试 | GPT-5.6 Sol(官方) | Grok 4.5(参考值) | 差距 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1 | 58.9 | - | Grok 4.6:约 61(基本持平) |
| Coding Agent Index v1.1 | 80.0 | - | 暂无 Grok 4.6 数据 |
| Terminal-Bench 2.1 | 88.8% | 83.3% | Sol +5.5 分 |
| DeepSWE v1.1 | 72.7% | 53.0% | Sol +19.7 分 |
| SWE-Bench Pro | 64.6% | 64.7% | 基本持平 |
| GPQA Diamond | 94.6% | 93.1% | Sol +1.5 分 |
Sol 在 Terminal-Bench 和 DeepSWE 上的领先最值得关注。Terminal-Bench 衡量智能体完成真实终端任务的能力,包括安装包、运行测试和排查失败原因;DeepSWE 则评估模型处理真实 GitHub issue 的端到端软件工程能力。Sol 相比 Grok 4.5 在 DeepSWE 上高出 19.7 分,意味着在需要规划、执行并从错误中恢复的复杂多步骤编程任务里,它可能明显更强。Grok 4.6 的后训练改进能否缩小这一差距,仍有待观察。
基准测试只能提供方向,不是最终定论。智能体框架、工具、提示词和执行环境都会影响结果:一个模型在某套框架下分数较低,换到另一套框架后也可能更高。
别只看 token 单价:应比较每项任务的成本
从价目表看,Grok 4.6 的每 token 价格极具优势;但智能体真正购买的是完成任务的结果,而不是 tokens。若 Sol 能以 3,000 个输出 tokens 完成一项编程任务,而 Grok 4.6 完成同一任务需要 6,000 个输出 tokens——例如更多重试、更长推理链或更低效的工具调用——两者的成本差距就会缩小。
按当前价格做一组敏感性分析:假设 Sol 完成一项编程任务需要 10K 输入和 4K 输出 tokens,而 Grok 4.6 需要 12K 输入和 8K 输出 tokens,也就是 Sol 的 token 效率高出 2 倍:
| 成本项 | GPT-5.6 Sol | Grok 4.6 |
|---|---|---|
| 输入成本 | $0.05 | $0.024 |
| 输出成本 | $0.12 | $0.048 |
| 单项任务总成本 | $0.17 | $0.072 |
即使在 Grok 4.6 的 token 效率处于 2 倍劣势的情形下,它的单任务成本依然低 2.4 倍。引用 Artificial Analysis 的Reddit 用户估算,Grok 4.6 每项 Intelligence Index 任务的成本约为 $0.86。若在你的实际工作负载中,Sol 级别的 token 效率能否消除 Grok 的成本优势,取决于任务复杂度和所使用的智能体框架。
真正的风险不在 token 经济性,而在任务能否完成。Sol 在 Terminal-Bench 和 DeepSWE 上更高的分数意味着:面对复杂的智能体任务,它可能成功,而 Grok 可能直接失败,继而需要重试或人工介入。无论单价多低,失败的任务都比成功完成的任务更贵。
接入方式与生态
两款模型都不再局限于单一供应商的 API。以下信息主要来自 xAI 的 API 页面和 OpenAI 文档:
| 接入渠道 | Grok 4.6 | GPT-5.6 Sol |
|---|---|---|
| Azure | AI Foundry(x.ai) | Azure OpenAI(openai.com) |
| AWS | 未列出 | Bedrock(openai.com) |
| Google Cloud | Vertex Model Garden(x.ai) | 未列出 |
| Oracle | OCI Generative AI(x.ai) | 未列出 |
| IDE 集成 | Cursor、Devin | Cursor、Codex |
| SDK 兼容性 | OpenAI + Anthropic SDKs(x.ai) | OpenAI SDK |
| 面向消费者的聊天产品 | SuperGrok($30/mo)、X Premium+ | ChatGPT Plus($20/mo)(fritz.ai) |
| 是否使用消费者数据训练 | 默认允许;需手动退出 | API/Business 数据默认不用于训练 |
根据 xAI 文档,Grok 同时支持 OpenAI 和 Anthropic SDK,因此迁移通常只需更换 API key 和 endpoint。对于敏感或专有代码,OpenAI 默认不使用 API 和 Business 数据训练的政策,在采购层面更有优势;而依据 Fritz.ai 的隐私分析,Grok 消费者需要自行退出训练。
该选哪一个模型?
| 工作负载 | 推荐 | 原因 |
|---|---|---|
| 高吞吐量编程智能体 | Grok 4.6 | 规模化使用时 token 成本低 2.5-5 倍 |
| 复杂多步骤智能体任务 | GPT-5.6 Sol(暂定) | 智能体基准优势对比的是 Grok 4.5,而非 4.6 |
| 大型代码库分析(>500K tokens) | GPT-5.6 Sol | 上下文窗口大 2 倍 |
| 对成本敏感的批处理 | Grok 4.6 | 智能水平接近,但每 token 成本更低 |
| 实时社交平台/Web 研究 | Grok 4.6 | 原生支持 X 和 Web 搜索(x.ai) |
| 敏感 / 专有代码 | GPT-5.6 Sol | API 数据默认不用于训练 |
| 企业 Azure 部署 | 两者都可 | 均已进入 Azure AI Foundry |
最可靠的决策方式,是用两套 API 跑一批具有代表性的真实任务,并比较任务成功率、每项成功任务的中位成本、重试次数和延迟。
常见问题
相比 Sol,我是否应该拿 Grok 4.6 与 GPT-5.6 Terra 对比?
Terra($2.50/$15.00)的价格更接近 Grok 4.6,但在所有已发布基准上都低于 Sol:Intelligence Index 为 55.0、Coding Agent Index 为 77.4、Terminal-Bench 为 87.4%(据 OpenAI 数据)。如果按智能水平匹配,Grok 4.6 对比 Sol 才公平;如果按价格匹配,Grok 4.6 对比 Terra 时,Grok 在成本和基准分数上都占优。Luna($1.00/$6.00)比两者都便宜,但会显著牺牲质量。
想进一步了解 Grok 4.6 的规格和能力,可以阅读我们的 Grok 4.6 指南。如果你想将 GPT-5.6 与更早版本的 Grok 对比,我们的 GPT-5.6 Sol vs. Grok 4.5 分析涵盖了这组前代机型的对比。