 AIREITER
Grok 4.6 在 2026 年 8 月 12 日上线,比 Elon Musk 所说“两周后”的推算日期晚了五天。乍看之下,价格没有任何变化:每百万 token 输入 $2.00、输出 $6.00、上下文 500K,与 Grok 4.5 完全一致。但实际账单并不会保持不变:缓存输入价格比 4.5 高 67%,独立测量还显示,模型完成相同工作时会生成更多 token。
8 月 12 日上线了什么
新模型 ID 为 grok-4.6。SpaceXAI 的更新日志显示,它于 2026 年 8 月 12 日通过 API 提供服务。官方给出的规格如下:
| 项目 | Grok 4.6 |
|---|---|
| 模型 ID | grok-4.6 |
| 上下文窗口 | 500K tokens |
| 输入 | 文本和图像 |
| 输出 | 仅文本,未说明输出上限 |
| 推理强度 | low、medium、high(默认)、xhigh |
| 知识截止日期 | 2026 年 2 月 1 日 |
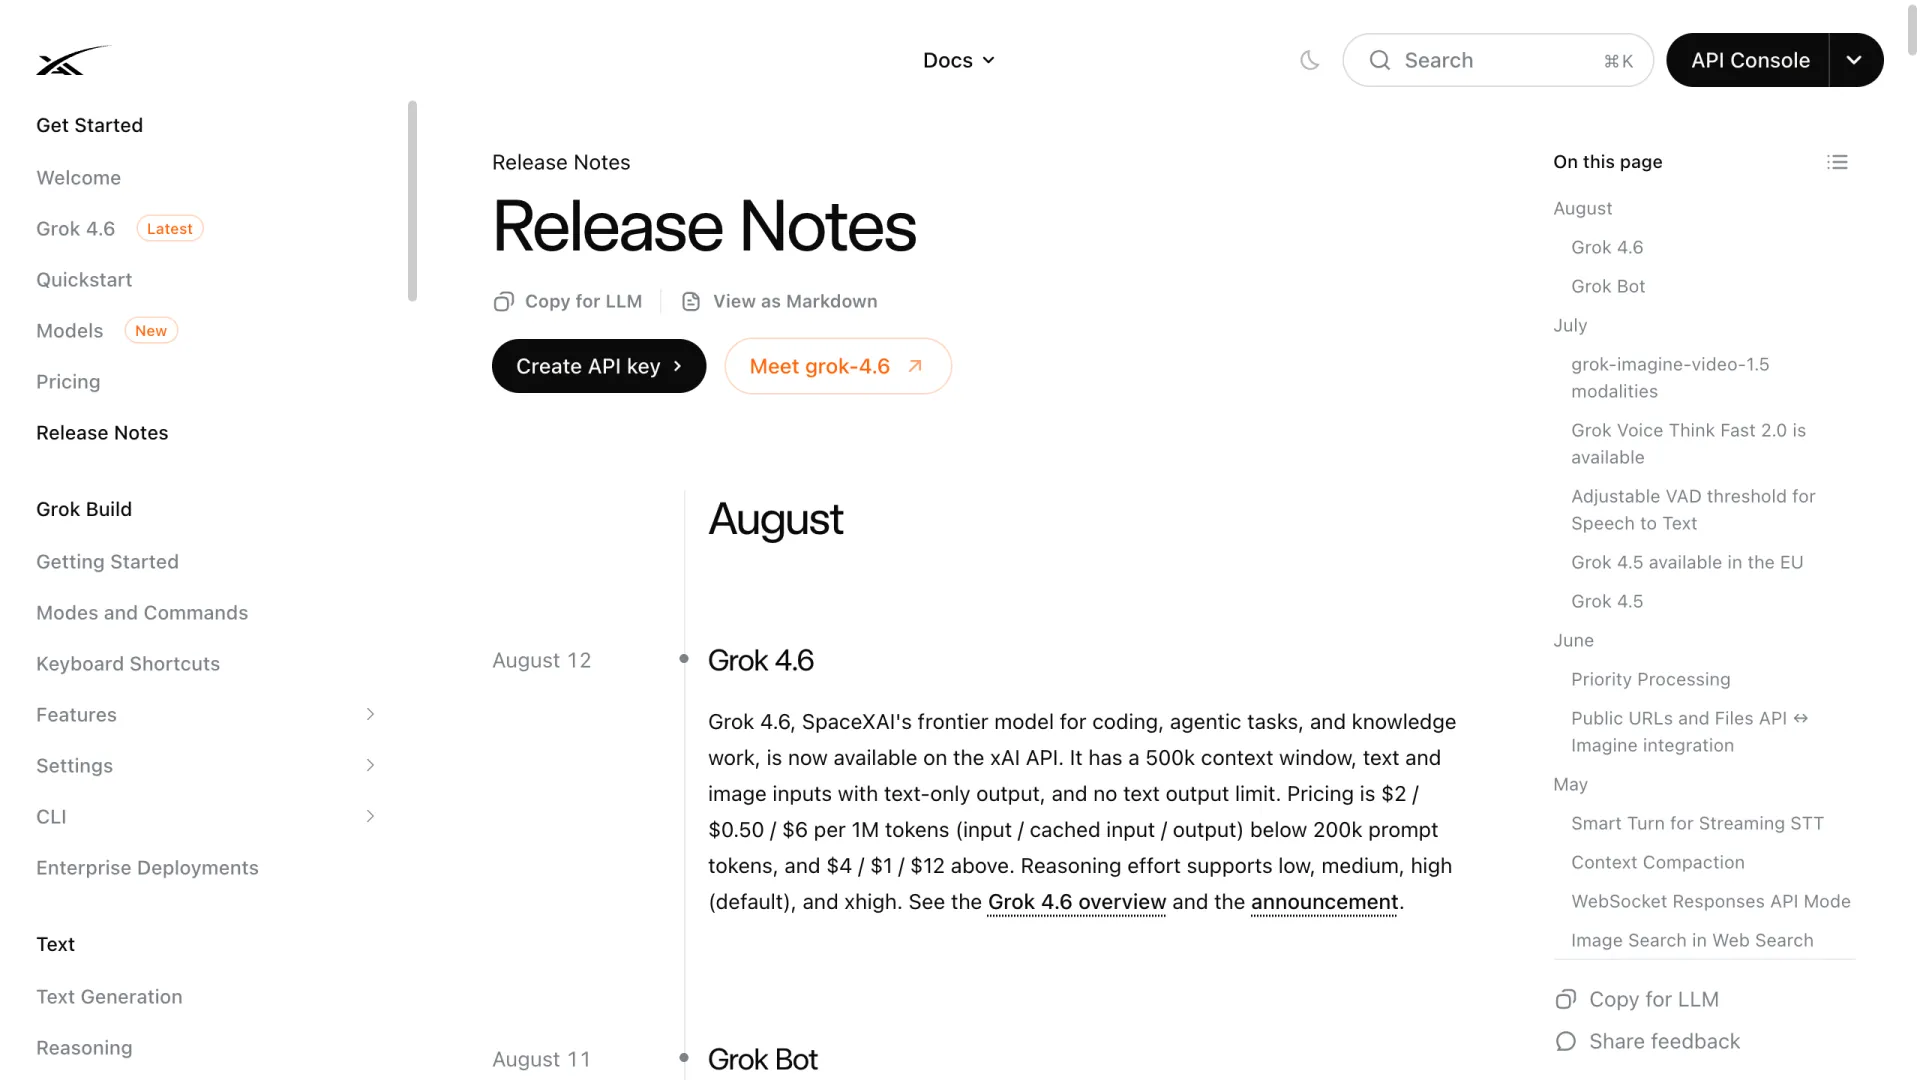
其中有两项是新增内容。首先,xhigh 成为第四档推理强度,Grok 4.5 最高只有 high。其次,文档现在标注了 2026 年 2 月 1 日这一知识截止日期;如果你此前会为带有明确时间要求的问题绕开模型知识盲区,这一点就很关键。
模型目录将 Grok 4.6 列为代码与对话场景的旗舰模型,侧边栏标注 Latest,页面日期为 2026 年 8 月 12 日。Grok 4.5 并未下线,价格页上仍保留着它自己的定价。
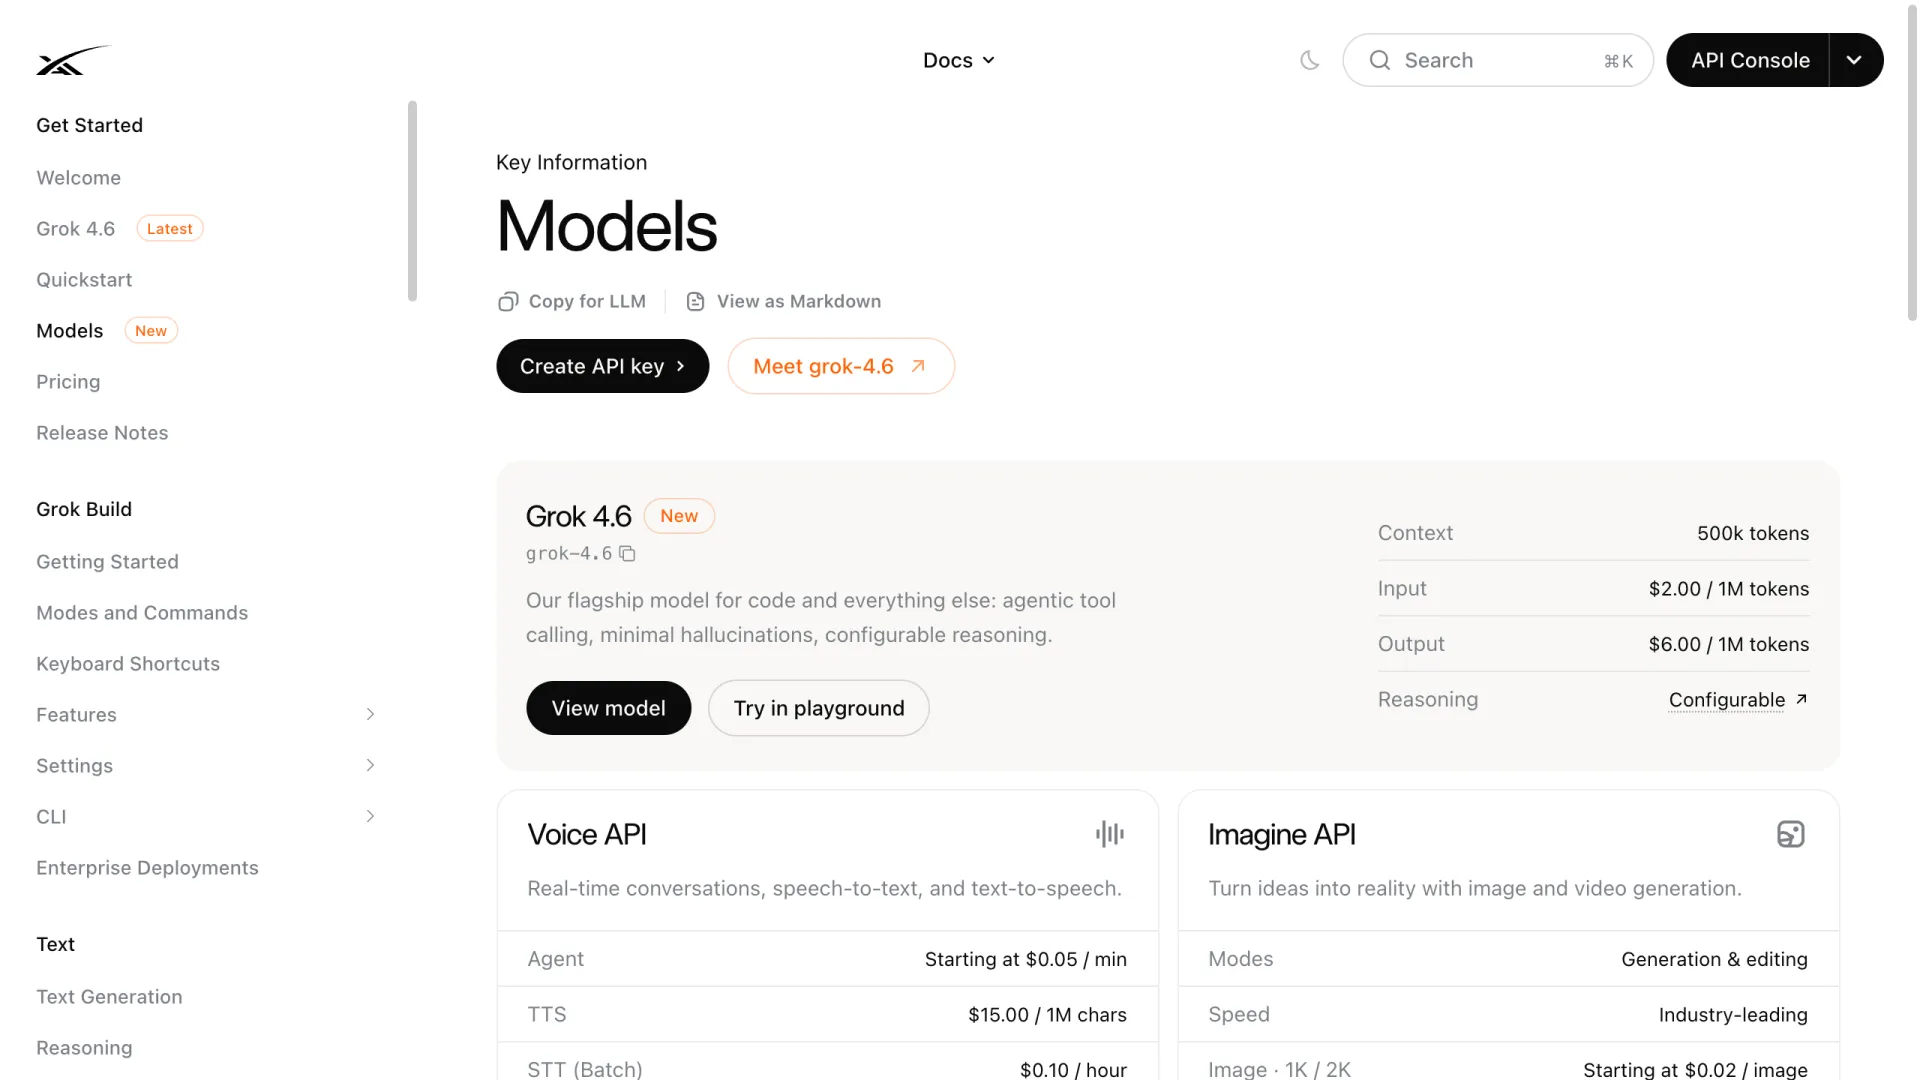
首日分发范围很广。SpaceXAI 的公告列出了 Cursor 和 Grok Build,两者首周都提供 2 倍包含用量;此外还可通过 API 以及 OpenRouter、Vercel、Cloudflare 等合作方使用。公告还提到一个价格翻倍的快速版本,但公共价格页尚未列出该版本,因此“2 倍”应视为公告中的说法,而不是已发布的标准费率。
标价没变,缓存输入却贵了
Grok 4.6 的输入和输出单价沿用 Grok 4.5,缓存输入则没有。
| 每 1M tokens 费率 | Grok 4.5 | Grok 4.6 |
|---|---|---|
| 输入(低于 200K) | $2.00 | $2.00 |
| 缓存输入(低于 200K) | $0.30 | $0.50 |
| 输出(低于 200K) | $6.00 | $6.00 |
| 输入 / 缓存 / 输出(200K+) | $4.00 / $0.60 / $12.00 | $4.00 / $1.00 / $12.00 |
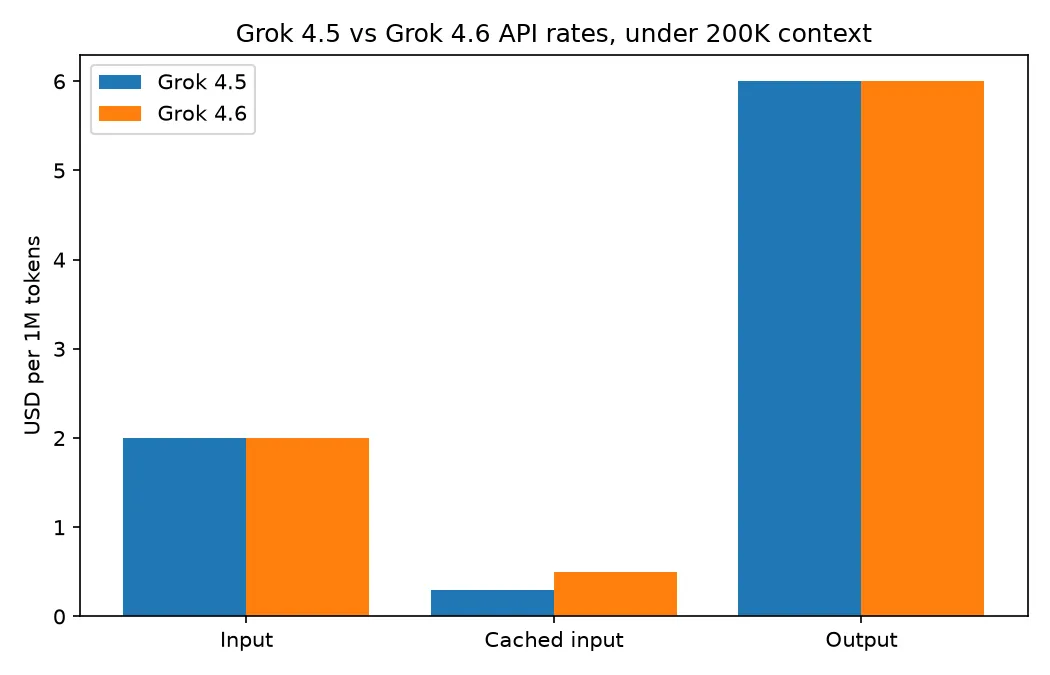
缓存输入折扣从 85% 缩至 75%,即每百万 token 多 20 美分。对于 agent 而言,这项费用随步骤数增长,而不是随任务数增长。一个每天重放 50M 缓存 token 的测试框架,在 4.6 上需支付 $15.00,而在 4.5 上只需 $9.00。
长上下文计费规则没有改变,但仍然容易被忽略。只要一次请求的 prompt 达到 200K tokens,整次请求的所有 token 都按更高档位收费。换句话说,一个 210K-token 请求的全部输入都按每百万 $4.00 计费,并不是两个档位混合计算。OpenRouter 的公开模型页也列出了相同费率和相同的 200K 覆盖规则,因此经由第三方路由并不会改变这笔账。
官方评测中,Grok 4.6 赢在哪里、输在哪里
SpaceXAI 发布了一张包含十项评测的对比表,对手包括 Grok 4.5、GPT-5.6 Sol Max 和 Fable 5 Max。Grok 4.6 在其中三项拿到最高分:GDPVal-AA v2(1753)、AA-Briefcase(1577)和 Harvey LAB(15.8%)。其余七项均未登顶。以下八项与模型路由最相关:
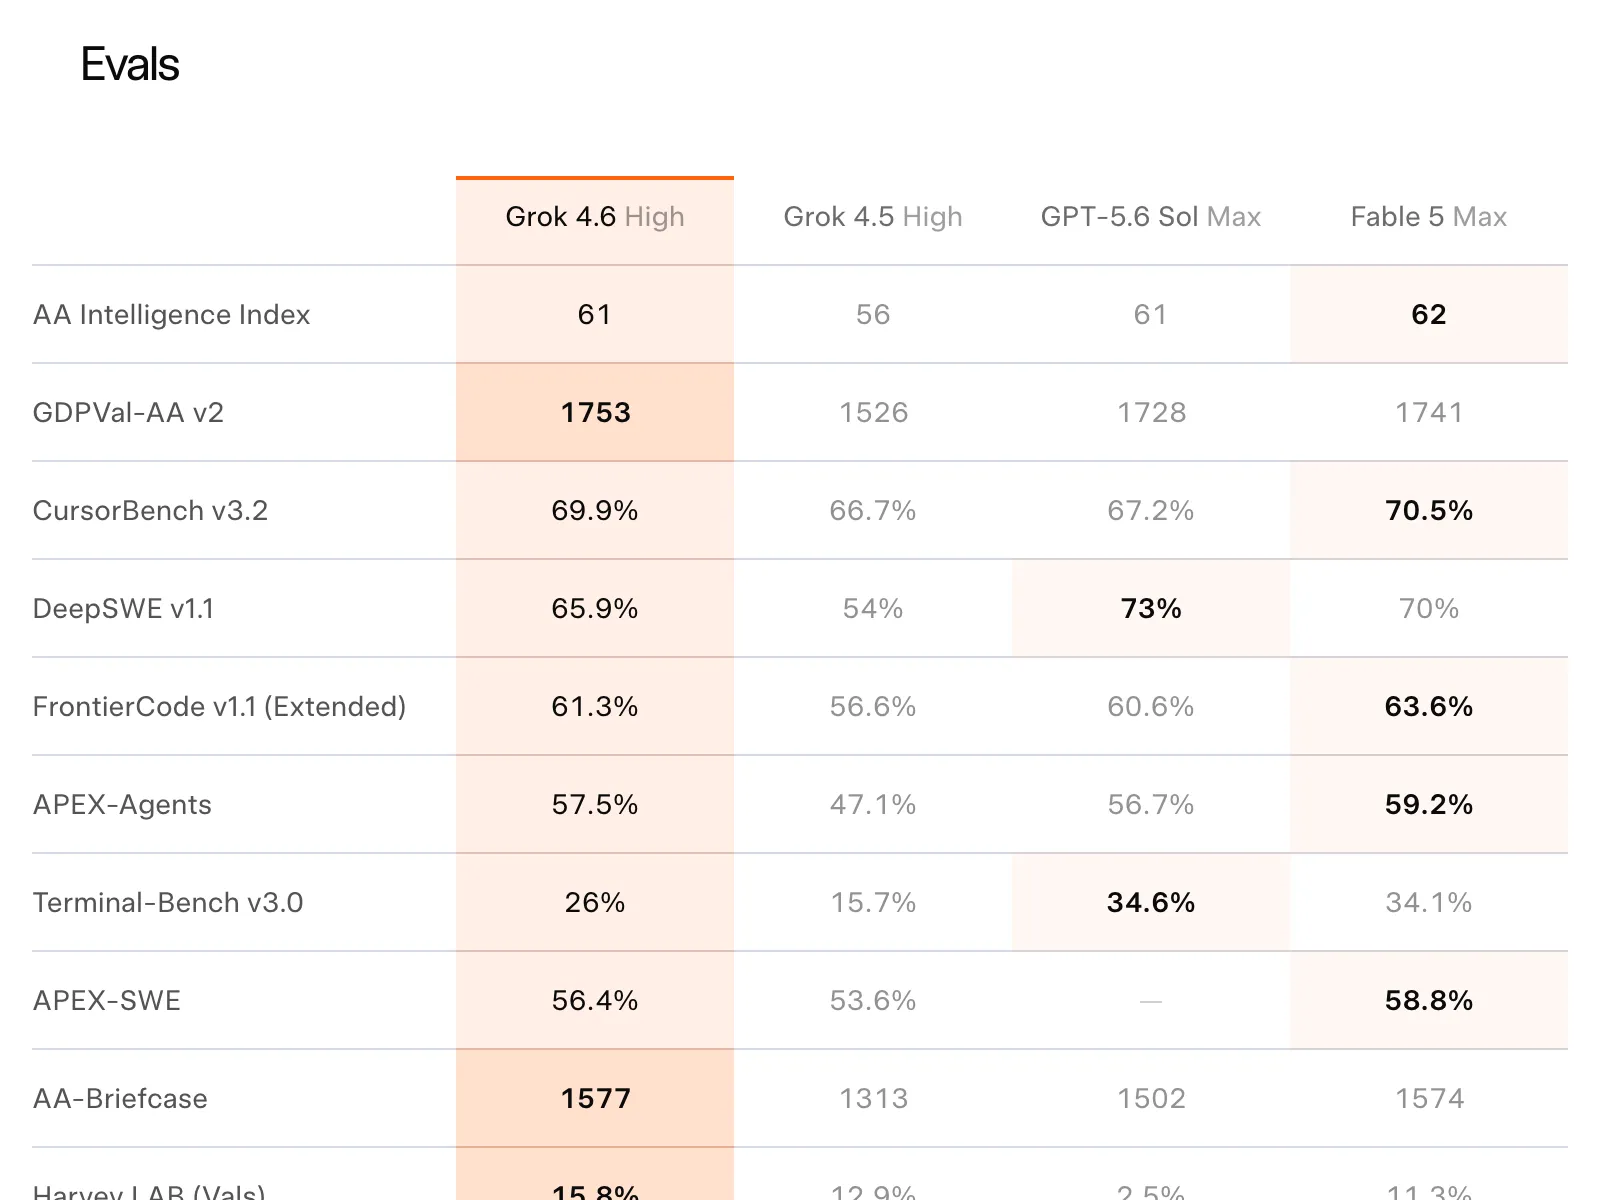
| 评测 | Grok 4.6 | Grok 4.5 | GPT-5.6 Sol | Fable 5 |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54% | 73% | 70% |
| FrontierCode v1.1 | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26% | 15.7% | 34.6% | 34.1% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
Terminal-Bench 的差距尤其值得关注。Grok 4.6 得分为 26%,而 GPT-5.6 Sol 为 34.6%,Fable 5 为 34.1%。在这项最接近 agent 操作 shell 的评测中,它以约八分之差排在第三。DeepSWE 也反映出同样的问题,只是数字不同:Grok 4.6 为 65.9%,Sol 为 73%。如果你的负载主要是终端驱动型 agent,厂商自己的表格已经说明,它并不是领先选择。
不过,相比 Grok 4.5 的进步确实存在,而且每一项都有提升。APEX-Agents 从 47.1% 升至 57.5%,Terminal-Bench 从 15.7% 升至 26%,增幅都超过十个百分点。SpaceXAI 将其归因于更长的补充训练、重新生成的 SFT 轨迹,以及覆盖编码和知识工作环境的 agentic RL。需要注意的是,公告从未给出参数量;与该模型关联的 2 万亿参数说法来自 Musk,而非正式发布材料。
能力提升的真实成本
厂商评测表会展示得分,却不会展示获得这些得分要花多少钱。Artificial Analysis同时公布这两类数据,其 8 月 13 日的测量结果正好揭示了 Grok 4.6 的真实取舍。
| 同一指数下的测量结果 | Grok 4.5 (high) | Grok 4.6 (high) |
|---|---|---|
| Intelligence Index | 56(184 个模型中第 16) | 61(184 个模型中第 6) |
| 输出速度 | 56.9 tokens/s(第 102) | 67.6 tokens/s(第 74) |
| 生成的输出 tokens | 60M | 72M |
| 完成整套评测的成本 | $579.21 | $1,068.47 |
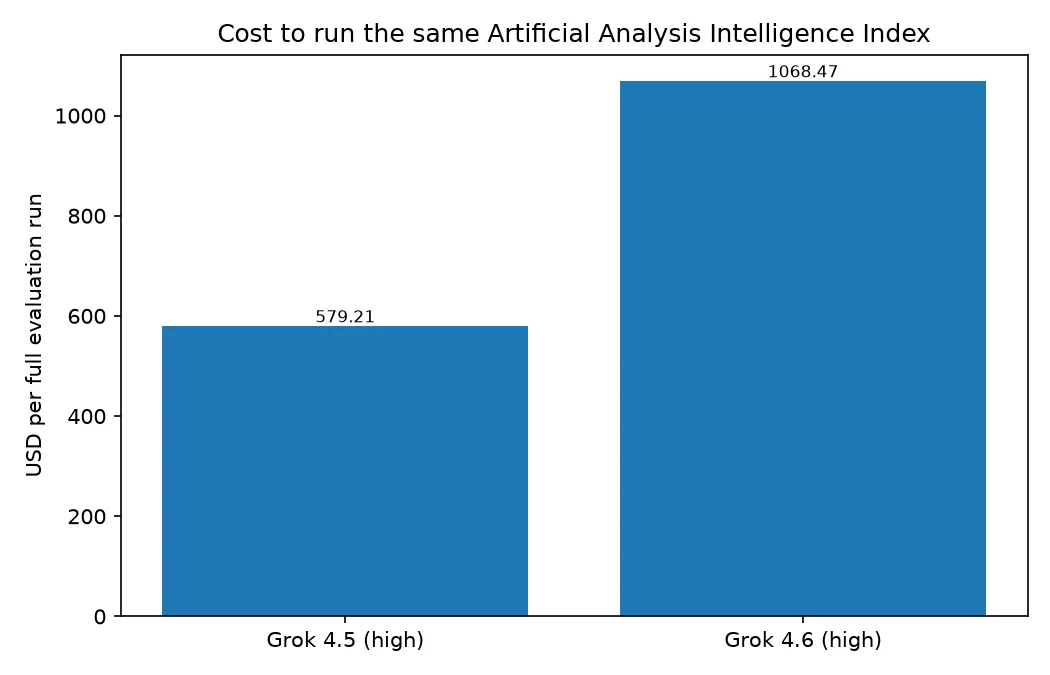
智能指数提高五分,成本却达到 1.8 倍。尽管表面费率相同,同一套基准测试多花了 $489:一部分来自更高的输出量,Grok 4.6 输出 72M tokens,而 4.5 为 60M;另一部分则来自前文提到的缓存价格上调。Artificial Analysis 未公布此次测试的逐项费用拆分,因此 1.8 倍是观察到的总成本,而不是可以自行反推的公式。
速度则有所改善:Grok 4.6 的输出速度为每秒 67.6 tokens,高于 4.5 的 56.9 tokens/s。这使它从该类别 184 个模型的后半区,来到大致中位的位置。
Musk 的说法与实际发布的差异
这个名字最早以三个词的回复进入公众视野。7 月 18 日,Musk 在回复@minchoi 时写道:“我们的 2T 模型在各方面都优于 1.5T 模型,将于下周完成初始训练。它或许能超越 Kimi,同时速度和 token 效率接近我们的 1.5T 模型,也就是 Grok 4.5。”Andrew Curran 问这是否就是 Grok 4.6,Musk 回复:“Yeah, Grok 4.6。”
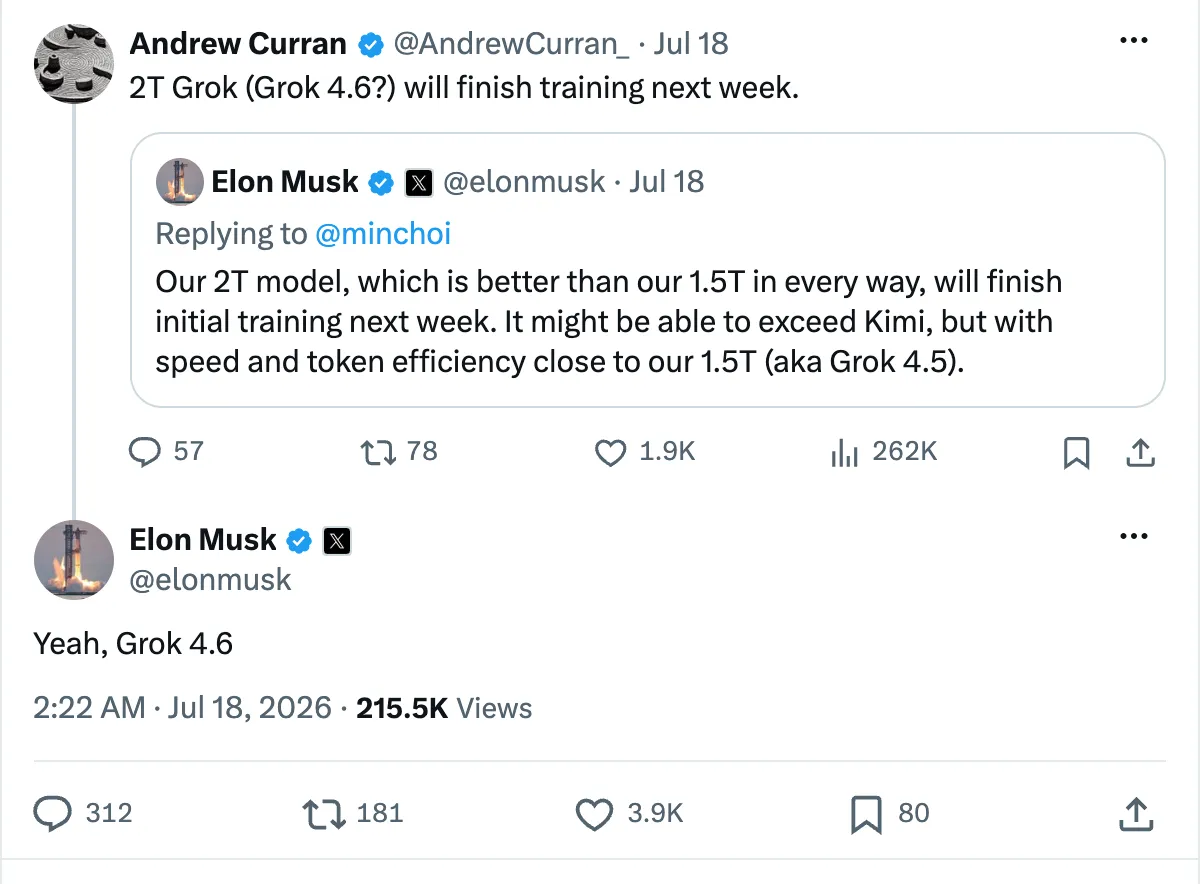
7 月 24 日,他又给出了时间表:“Grok 4.6 两周后推出,Grok 4.7 四周后推出。”从这一天算起,两周大约落在 8 月 7 日,而模型实际在 8 月 12 日发布,晚了五天。
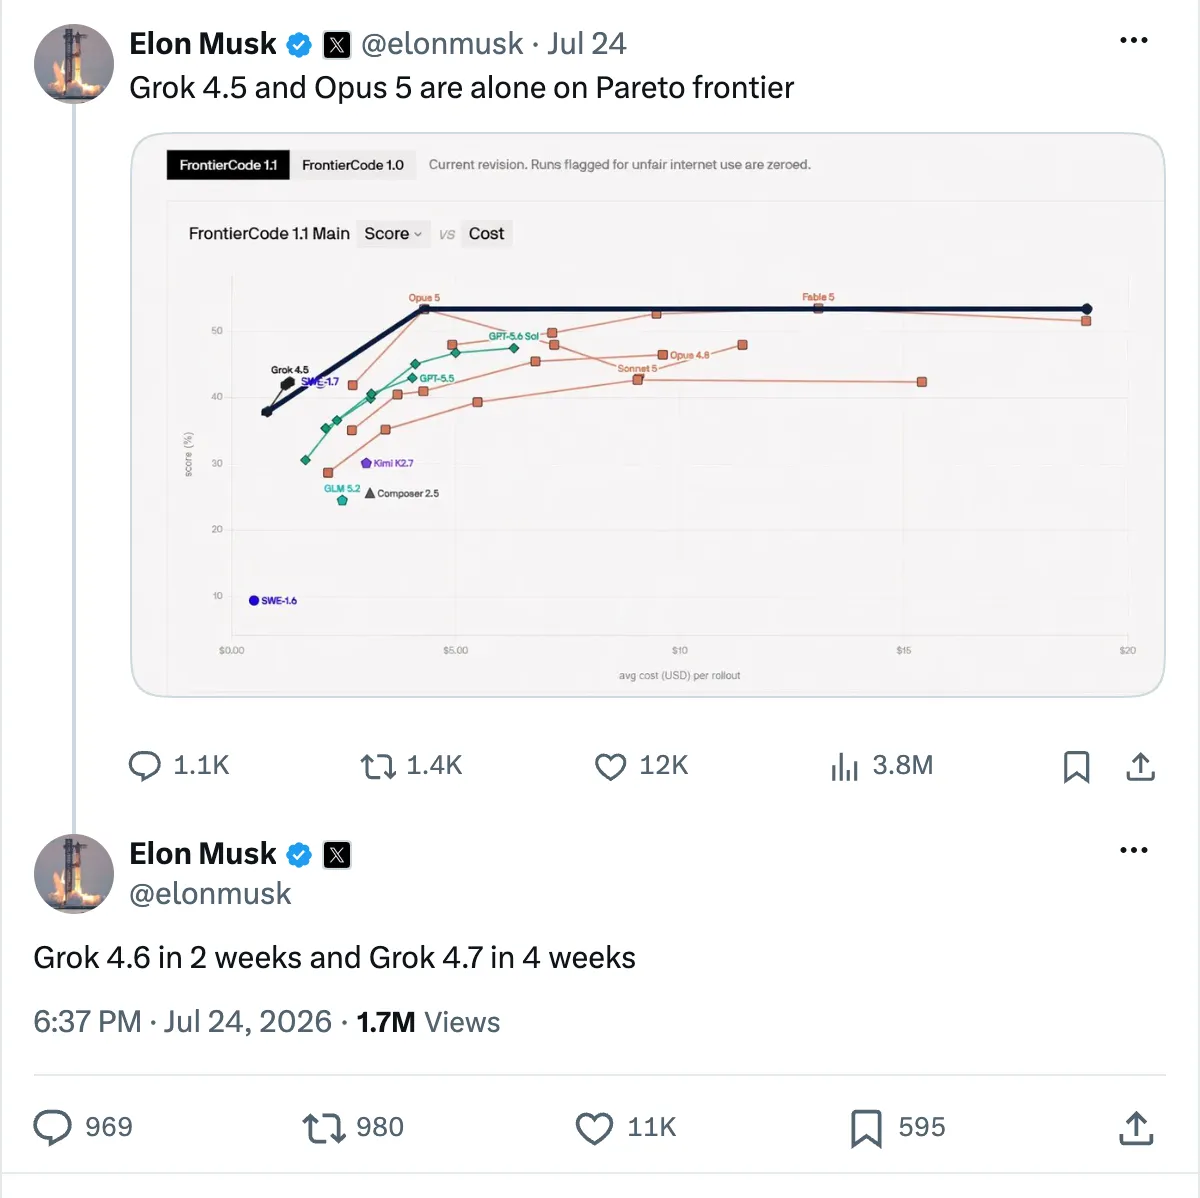
这些帖子中的三项说法,在发布后都未能得到完整印证:
- 2 万亿参数仍未获证实。SpaceXAI 的公告、模型文档和更新日志均未给出 Grok 4.6 的参数量。
- “token 效率接近 Grok 4.5”与 Artificial Analysis 的测量结果相矛盾:在相同评测中,Grok 4.6 输出了 72M tokens,而 Grok 4.5 为 60M。
- “或许能超过 Kimi”仍未经过验证。SpaceXAI 的表格没有将它与 Moonshot 的 K3 对比,只比较了 GPT-5.6 Sol 和 Fable 5。
该不该从 Grok 4.5 迁移到 Grok 4.6
如果你目前使用 Grok 4.5,且工作负载偏向 agent 和知识任务,答案是可以迁移;但不要在迁移时看一次账单就下结论,最好运行一周后再核查 token 成本。Grok 4.5 仍按原费率提供,因此切换是可逆的,值得实测而不是想当然。
若你的工作是长周期 agent 或知识任务,可以现在迁移:APEX-Agents 提升 10.4 分,GDPVal-AA 提升 227,生成速度提高后,在多步任务中的收益还会累积。若流量高度依赖缓存且对价格敏感,则建议留在 4.5:缓存读取价格提高 67% 是实打实的退步,而 4.5 的得分也不会因为 4.6 发布而下降。终端 agent 则应考虑其他选择,SpaceXAI 自己的表格显示,Grok 4.6 比 GPT-5.6 Sol 和 Fable 5 低八分。
在生产环境切换路由前,先检查以下三件事:
- 两个 ID 都是别名。SpaceXAI 的别名规则中,
grok-4.6指向最新稳定版本,grok-4.6-latest指向最新版本;只有带日期的<modelname>-<date>ID 才会固定。模型目录和 OpenRouter 都没有列出带日期的 4.6 变体,因此目前无法为可复现工作流锁定版本。 - 重新测试推理强度设置。新的
xhigh档位不是免费升级。该模型本身已被测得比前代更易生成冗长输出,xhigh 会消耗更多 token。默认的high才是与 4.5 做同等比较的设置。 - 确认你的服务商已经接入。SpaceXAI 首日可用,不代表所有平台首日可用。8 月 13 日查询
/v1/models时,官方 API 和 OpenRouter 都返回了grok-4.6;但我测试的一个 OpenAI 兼容转售商端点最高仍只支持grok-4.5,并以model_not_found拒绝新 ID。路由流量前,请用自己的 key 确认准确的模型 ID 能正常响应。
常见问题
Grok 4.6 API 怎么收费?
上下文低于 200K 时,每百万输入 tokens $2.00、每百万输出 tokens $6.00,缓存输入为 $0.50。prompt 超过 200K tokens 后,整次请求按每百万输入 $4.00、缓存 $1.00、输出 $12.00 计费。公告提到一个价格翻倍的快速版本,但公共价格页尚未列出。
Grok 4.6 比 Grok 4.5 更好吗?
按照 SpaceXAI 公布的全部基准测试,是的:AA Intelligence Index 从 56 升至 61,最大的提升出现在 agent 评测中。但独立测量也给出了限定条件:在相同评测中,它生成了 72M 输出 tokens,而 Grok 4.5 为 60M,因此完成相同任务的成本更高。
Grok 4.6 有多少参数?
未公开。Musk 在 2026 年 7 月 18 日描述过一款 2 万亿参数模型,并确认其名称是 Grok 4.6;但 SpaceXAI 的发布材料没有给出参数量、架构细节,也没有说明每个 token 会激活多少参数。
Grok 4.6 的上下文窗口和知识截止日期是什么?
上下文窗口为 500K tokens,支持文本和图像输入,仅输出文本。文档标注的知识截止日期是 2026 年 2 月 1 日;若未启用服务端 Web Search 或 X Search,模型无法获知之后发生的事件。
Grok 是 xAI 还是 SpaceXAI 开发的?
两个名称指向同一家公司。开发者文档标题为“SpaceXAI Docs”,而在 2026 年迁入 SpaceX 后,公告页脚仍显示 X.AI LLC。x.ai 域名和 grok-* 模型 ID 均未改名。
Grok 4.7 什么时候发布?
尚未公布日期。Musk 在 7 月 24 日的帖子中称 Grok 4.7 大约四周后推出,按此推算约为 2026 年 8 月 21 日;而 Grok 4.6 已比其自身暗示的日期晚了五天。
延伸阅读
价格、模型 ID 和基准测试数据已于 2026 年 8 月 13 日根据 SpaceXAI 文档、Grok 4.6 公告及 Artificial Analysis 核实。