 AIREITER
LongCat 2.5 API 的每百万输入 Token $0.30 看起来极具性价比,但这只是未注明结束日期的限时促销价。而 Preview 用户报告的循环问题,可能让原本便宜的 Token 变得昂贵。在衡量出每个可接受结果的成本前,我会先跑一轮以高缓存命中为主的小规模测试,而不是直接迁移生产环境。
正式版价格落地,可靠性仍待验证
LongCat 2.5 已正式发布。美团于 2026 年 11 月 1 日发布 LongCat-2.5 博文,并在 2026 年 11 月 2 日于 API 平台启用 LongCat-2.5,支持 OpenAI Chat Completions、OpenAI Responses 和 Anthropic Messages 接口。
不过,正式发布并没有消除信任疑虑。Preview 版在 OpenCode 中的测试体验不够理想,因此生产环境买家仍在问:11 月 2 日的版本是否解决了循环执行和破坏性修改问题?基于公开证据,诚实的答案是尚未得到验证。绝大多数详细故障报告针对的是 9 月下旬至 10 月期间的 LongCat-2.5-Preview,截至 11 月 3 日,也没有独立实验室重新测试正式版检查点。
“我测试了 LongCat 2.5:纸面实力很强,但我的测试中暴露了一个真实缺口。”—— @prompt48,其在免费聊天页面进行圣诞树 HTML 测试后发现,装饰物散落到了树外。
这条反馈与 Reddit 上的情况一致。真实 OpenCode 用户描述的并非聊天演示中的问题,而是 Agent 执行过程中的另一种故障:
“我用它搭建 VM,它多次在执行简单的 ls 命令时不断陷入循环。”—— u/Such_Competition8263,发表于 r/opencode
“它以极其随机的方式修改了与任务完全无关的代码。”—— u/Avernite,同一讨论帖。
你买到的是什么:仅 API 可用,权重仍显示 Coming soon
LongCat 2.5 目前的实际交付形态是:通过 API 访问一款超大混合专家模型,不能下载权重。LongCat 2.5 总参数量为 1.6 万亿,每个 Token 约激活 480 亿参数;支持文本、图像和视频输入,只输出文本;上下文窗口为 1,048,576 Token,最高可输出 262,144 Token。简而言之:上下文极大,输出仅限文本。
它的多模态能力并非后接模块。图像会被转换成与文本位于同一序列中的离散 Token。单次请求最多可传入 100 张图片,每张最大 10 MB,支持 PNG、JPG、JPEG、WebP 和 GIF;还可通过公开 URL 输入最多 10 段视频,每段最大 100 MB、时长不超过 3,600 秒。思考预算最高为 262,144 Token,并通过 reasoning_content 返回;开启思考时 temperature 固定为 1.0,关闭时固定为 0.7。
9 月 25 日 Preview 与 11 月 2 日正式版:差异在哪
LongCat-2.5-Preview 与 LongCat-2.5 的区别,是许多搜索结果令人困惑的根源。LongCat-2.5-Preview 于 2026 年 9 月 25 日上线,提供 100 万上下文和图像理解;正式版 LongCat-2.5 则在 11 月 1 日至 2 日发布,增加视频输入、利用失败 Agent 运行轨迹进行的 Trajectory2Task+ 训练,以及采用 4-bit W4A4 推理服务,相比 8-bit 宣称将 Prefill 吞吐量提升 43.3%。
模型发布并不意味着权重同步开放。上线后,GitHub 和 Hugging Face 的按钮仍显示“Coming soon”;LongCat-2.0 仍是可下载的最大 LongCat 模型,采用 MIT 许可证。对于大多数团队而言,1.6T 总参数量也意味着自托管近期并不现实。
LongCat 2.5 API:每百万 Token $0.30 到底怎么计费
LongCat 2.5 API 的促销定价包含三档价格,其中输出 Token 是成本的主要拉力。
| Token 类型 | 每 100 万 Token 促销价 | 价格倍数 |
|---|---|---|
| 未缓存输入 | $0.30 | 1x |
| 缓存输入 | $0.006 | 0.02x |
| 输出 | $1.20 | 为输入的 4x、缓存输入的 200x |
计费公式为 (未缓存输入 x 0.30 + 缓存输入 x 0.006 + 输出 x 1.20) / 1,000,000。推理 Token 计入输出 Token,不会单独收费。若 100 万输入 Token 中有 80% 命中缓存,输入成本会从 $0.30 降至 $0.0648。这相当于输入成本节省 78.4%,而不是 98%,因为 98% 的折扣只适用于命中缓存的 Token 本身。
两个按促销价计算的工作负载,足以说明输出为何主导成本。一次包含 20,000 输入和 2,000 输出 Token 的摘要任务,成本为 $0.0084,即每千次 $8.40。一次重复上下文的 Agent 请求,包含 200,000 未缓存输入、800,000 缓存输入和 40,000 输出 Token,成本为 $0.1128,即每千次 $112.80。
失败后的工具重试、过长回答,以及虽然返回 HTTP 200 但实际不可用的结果,都会推高账单。应以总尝试次数的已计费成本除以被接受的结果数,来衡量每个可接受结果的成本。
促销没有截止日期,预算别只按折扣价算
LongCat 2.5 促销价的限制在于时间,而非功能。美团将 $0.30/$1.20/$0.006 标为限时价格,但没有公布结束日期,也没有公布常规定价。美团保留修改价格的权利,并以平台计费记录为准。
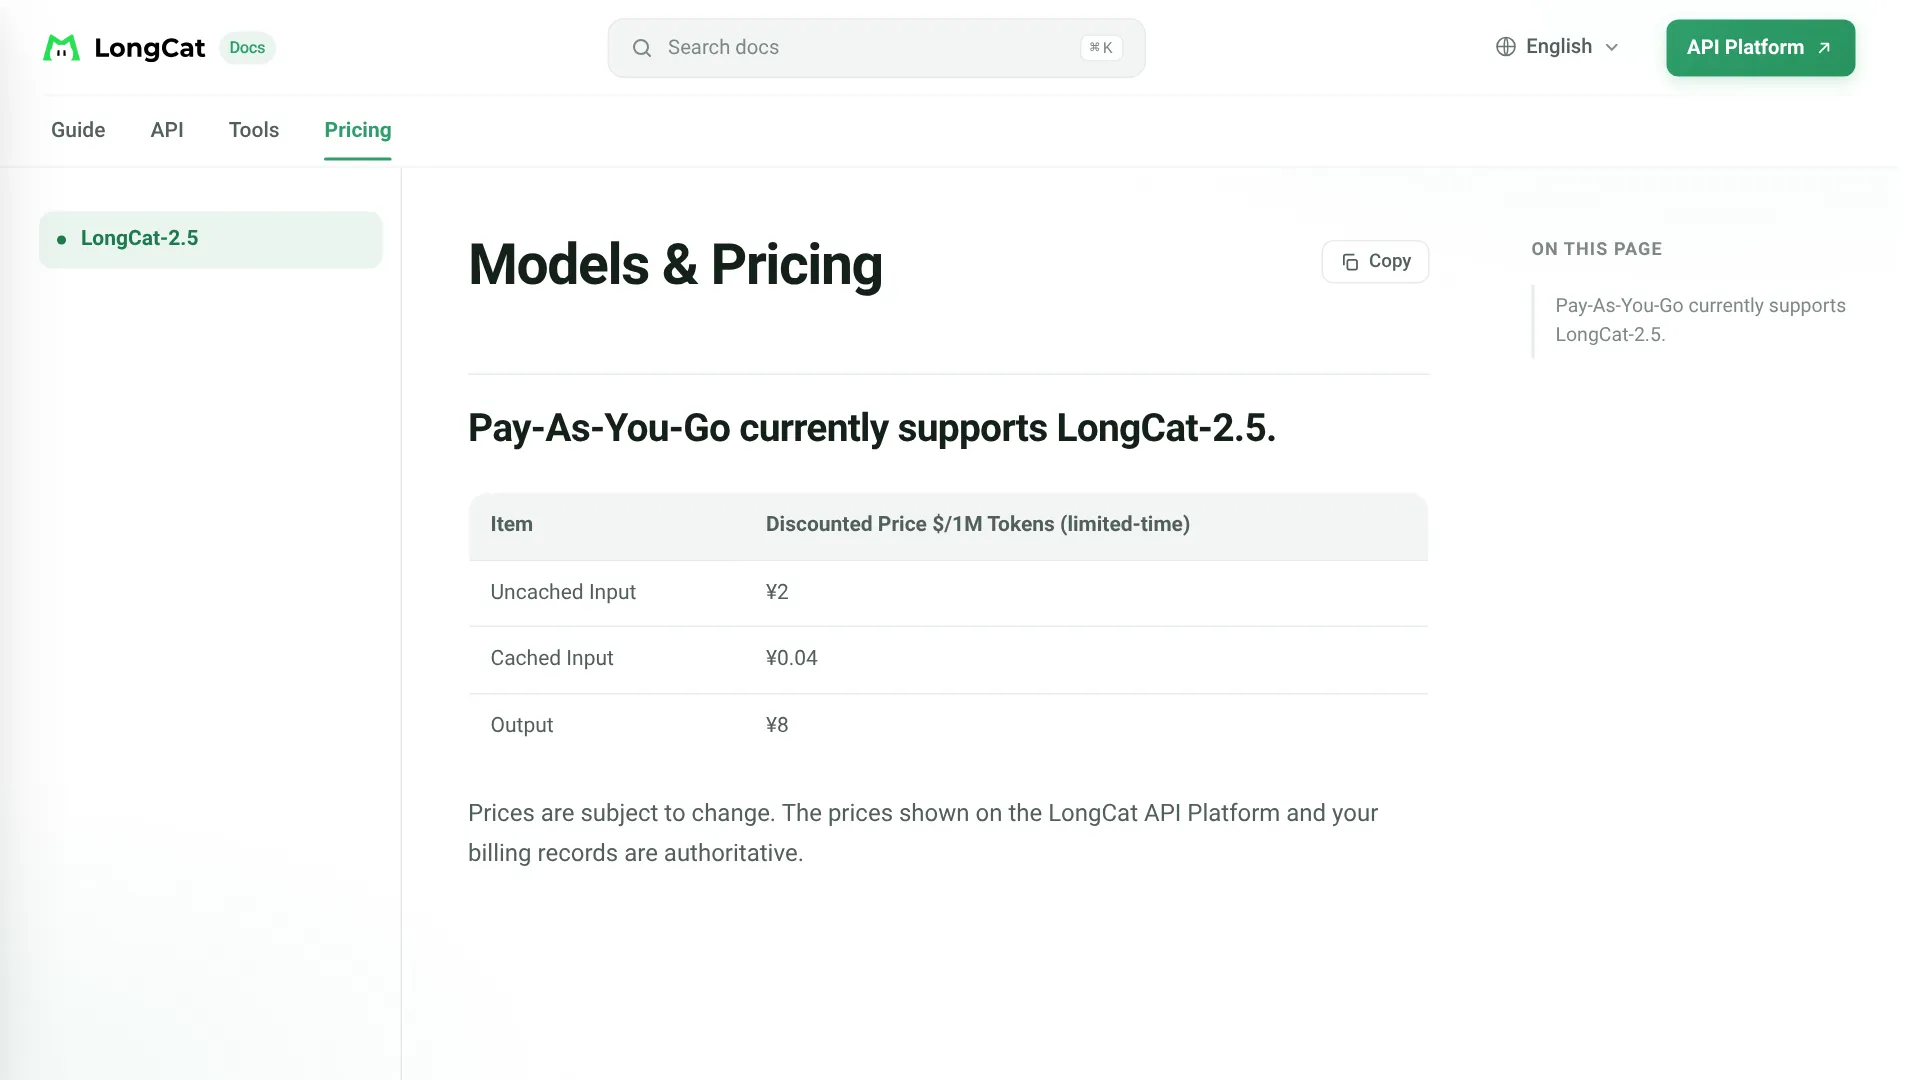
已有迹象表明,未来价格可能显著上调。ZenMux 显示的 Preview 折扣前价格为输入 $0.75、输出 $2.95;Artificial Analysis 列出的 LongCat-2.0 也是相同的 $0.75/$2.95。这个价格约为促销价的 2.5 倍,意味着促销价大约是潜在常规价的 40%。Hokai 在 11 月 3 日核查的 美团中文定价页显示,每百万 Token 的未缓存输入为 CNY 2、缓存输入为 CNY 0.04、输出为 CNY 8。
Token Packs 与企业折扣档位
| 每月消费额 | 企业折扣 |
|---|---|
| $75+ | 10% |
| $300+ | 20% |
| $1,200+ | 30% |
| $6,000+ | 40% |
- Token Packs:固定额度,有效期 30 天,包含闪购窗口;优先消耗套餐额度,缓存命中免费,缓存未命中和输出会消耗额度,未使用的额度自动退款。
- 按量付费:余额不会过期,支持银行卡和 Google Pay;失败的 401/403/429/500 请求不计费。
- 企业档位:每月重置,不包含 Token Pack 消费和促销赠金。
不同接入渠道:价格相同,风险不同
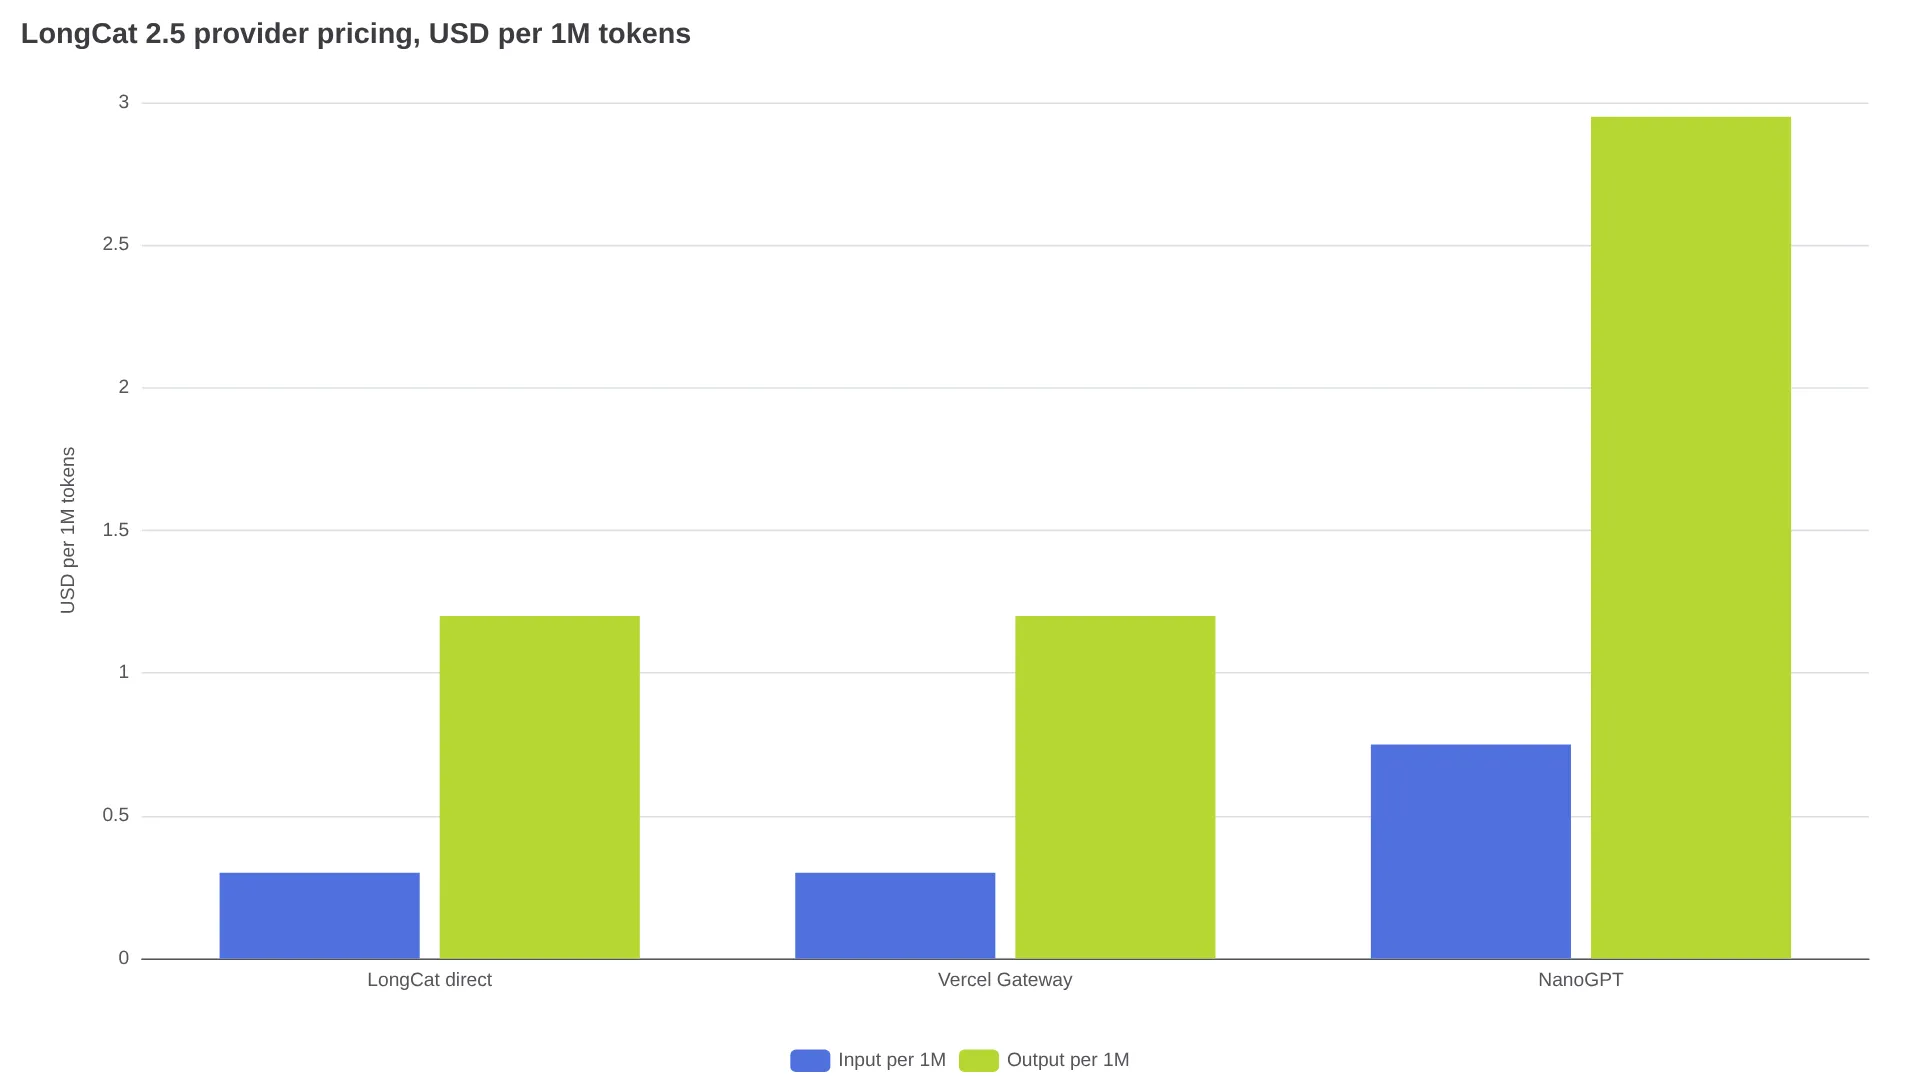
LongCat 2.5 的服务商定价对比表面上很平,但将质量和条款纳入考虑后,差异就会浮现。
| 接入渠道 | 输入 / 100 万 | 缓存 / 100 万 | 输出 / 100 万 |
|---|---|---|---|
| LongCat 直连 | $0.30 | $0.006 | $1.20 |
| Vercel AI Gateway | $0.30 | $0.006 | $1.20 |
| NanoGPT | $0.75 | $0.015 | $2.95 |
LongCat 官方 API 是第一方渠道,可直接查看缓存统计并购买 Token Pack。Vercel 在相同 Token 价格之上,额外引入网关积分、路由、限额和服务商条款。OpenCode 的 Preview 免费窗口是独立客户端促销,不代表第一方 API 免费。
对高缓存命中用户而言,混合成本很有吸引力,但前提是缓存确实生效。TokenPricing 按输入与输出 3:1、且一半输入命中缓存计算,得出每百万 Token $0.4147;Hokai 则按无缓存的 3:1 比例计算,得出 $0.525,并将 LongCat-2.5 排在 94 个同类模型中的第 27 位,对比中位数为 $1.63。只要你的测试框架报告低缓存命中,或者生成很长的推理轨迹,这两种混合成本都会失效。
选择接入渠道前,至少确认三件事:列出的模型 ID 是 LongCat-2.5,还是某个 preview 别名;缓存命中是否会显示在 usage payload 中;数据条款、输出上限和重试策略是否与官方 LongCat API 文档一致。
基准测试均由厂商运行,应这样解读
评估 LongCat 2.5 的基准成绩,首先要对来源打折。美团表格中的全部 LongCat-2.5 分数都由厂商自行运行。部分竞品数据来自公开报告,另一些则由美团重跑,但仅供参考。截至 11 月 3 日,Artificial Analysis 和 OpenRouter 都尚未列出 LongCat-2.5。
| 基准测试 | LongCat-2.5 | 列出的最佳竞品 |
|---|---|---|
| Terminal-Bench 2.1 | 88.4 | 90.6 DeepSeek V4.1 Flash |
| Terminal-Bench 4.0 | 38.5 | 53.9 Opus 5 |
| DeepSWE 1.1 | 64.6 | 74.2 DeepSeek Flash |
| NL2Repo | 60.5 | 75.3 Opus 5 |
| BrowseComp | 91.9 | 91.5 DeepSeek Flash |
| VideoMME | 85.2 | 90.0 Kimi K3 |
整体规律很清楚:在较早版本的 Terminal-Bench 和 BrowseComp 上接近第一梯队,但在更深层的终端、代码仓库和程序开发测试中存在明显差距。对比中还遗漏了 Kimi K3.1 Pro、GPT-6 Astra 和 Claude Opus 5.5 等更新竞品。
团队最容易忽略的条款:数据复用、温度锁定、没有 SLA
对于是否适合处理公司代码而言,LongCat 2.5 的数据与运维条款往往比基准分数更有决定性。除非企业协议或单独书面协议另有约定,API 条款授予 LongCat 免费、全球范围内使用输入、输出和反馈的许可,用于服务优化、品牌推广和营销。API 服务器可能位于法兰克福、香港和中国大陆,适用新加坡法律并接受 SIAC 仲裁。
- 固定采样意味着无法使用低 temperature 实现可复现输出;不支持音频输入和图像生成。
- 未公布数据保留期或 SLA;自托管仍要等待没有日期的权重发布。
- 认证失败、限流和服务器错误不计费;成功返回但无用的响应照常收费。
“不得不说,100 万 Token 上下文窗口实在太强了。我一直在用 LongCat2.5,它凭借这个上下文窗口确实很擅长找 Bug。”—— @alexokita
把它定位为 Bug 猎手,才是使用 100 万上下文窗口的稳妥方式:针对明确错误码开展边界清晰的修复,并由人工审核,而不是让它无人监督地进行重构。
你的 Agent 应该调用 LongCat 2.5 吗
LongCat 2.5 是否适合,取决于你能接受多少监督成本,以及对保密性的要求。它适合对成本敏感、使用 Claude Code、Codex 或 OpenCode 的用户:运行高缓存命中的长链路 Agent,处理截图转代码的前端工作,或执行浏览加构建的研究任务——视觉输入能省去文字描述这一步。
| 适合使用 LongCat 2.5 的情况 | 更应考虑其他方案的情况 |
|---|---|
| 重复的大上下文能带来高缓存命中 | 没有企业条款保障的受监管或高度保密代码 |
| 任务是基于明确错误码的边界清晰 Bug 修复 | 任务是自主进行多文件重构 |
| 你可以审查 diff,并衡量每个可接受结果的成本 | 你需要固定低 temperature、SLA 或立即自托管 |
尚未解决的核心取舍,是促销价格与可靠性证据之间的权衡。以 $0.30/$1.20 和 $0.006 缓存价计算,LongCat-2.5 的输入成本比 Claude Opus 定价的 $5/$25 低约 16 倍。但在美团自己的表格中,Opus 5 在难度更高的终端和代码仓库测试上仍然领先。先在自己的测试框架中跑一次可计费试用,和 DeepSeek V4.1 Flash、GLM 这类低价模型比较可接受结果成本,再决定折扣是否值得付出额外监督成本。
延伸阅读:DeepSeek V4.1 Flash 1017 编程评测、GLM 5.3 基准测试与定价、Kimi K3.1 Pro API 定价指南。
LongCat 2.5 API 定价 FAQ
LongCat 2.5 API 的价格是多少?
促销期间,LongCat 2.5 API 的未缓存输入为每百万 Token $0.30,缓存 Token 为每百万 $0.006,输出 Token 为每百万 $1.20。输出价格是未缓存输入的 4 倍,因此很长的推理轨迹会主导账单。
$0.30 的价格会永久有效吗?
不会。美团将 LongCat 2.5 定价标为限时价格,没有给出结束日期或常规价格。预算规划可将 Preview 时期的 $0.75/$2.95 作为可能上调时的参考情景。
LongCat 2.5 是开源模型还是仅 API 可用?
截至 2026 年 11 月初,LongCat 2.5 仅可通过 API 使用。GitHub 和 Hugging Face 显示 Coming soon,尚未给出日期或许可证;LongCat-2.0 仍是可下载的 MIT 选项。
LongCat 2.5 能在 Claude Code 和 OpenCode 中运行吗?
可以。LongCat 2.5 支持 OpenAI Chat Completions、OpenAI Responses 和 Anthropic Messages,模型 ID 为 LongCat-2.5。将 base URL 和模型名称指向 LongCat 直连或网关后,还应确认所选渠道会报告缓存使用情况。
LongCat 2.5 能安全处理公司代码吗?
LongCat 2.5 是否适合公司代码,取决于合同条款而非基准测试。默认 API 条款允许将输入和输出用于优化及营销,因此受监管或机密性要求高的工作,需要签订包含数据使用例外条款的企业协议。
正式版 LongCat 2.5 与 Preview 版不同吗?
不同。Preview 于 9 月 25 日发布,提供图像理解;正式版于 11 月 1 日至 2 日发布,增加视频输入并重新训练了 Agent 行为。公开故障报告大多针对 Preview,因此正式版的可靠性仍需要独立复测。