 AIREITER
代码 Agent 的单次调用看起来可能很便宜,但上下文一旦跨过计费门槛,或推理预算挤占了输出上限,实际成本就会迅速变化。Grok 4.6 和 Opus 5 之间怎么选?如果工作负载的提示词通常低于 200K tokens,且成本敏感,选 Grok 4.6;如果确实需要 1M-token 上下文窗口、128K 输出,或依赖其已文档化的 Agent 控制能力,则应选择 Claude Opus 5。
先看工作负载的边界条件,再谈模型强弱
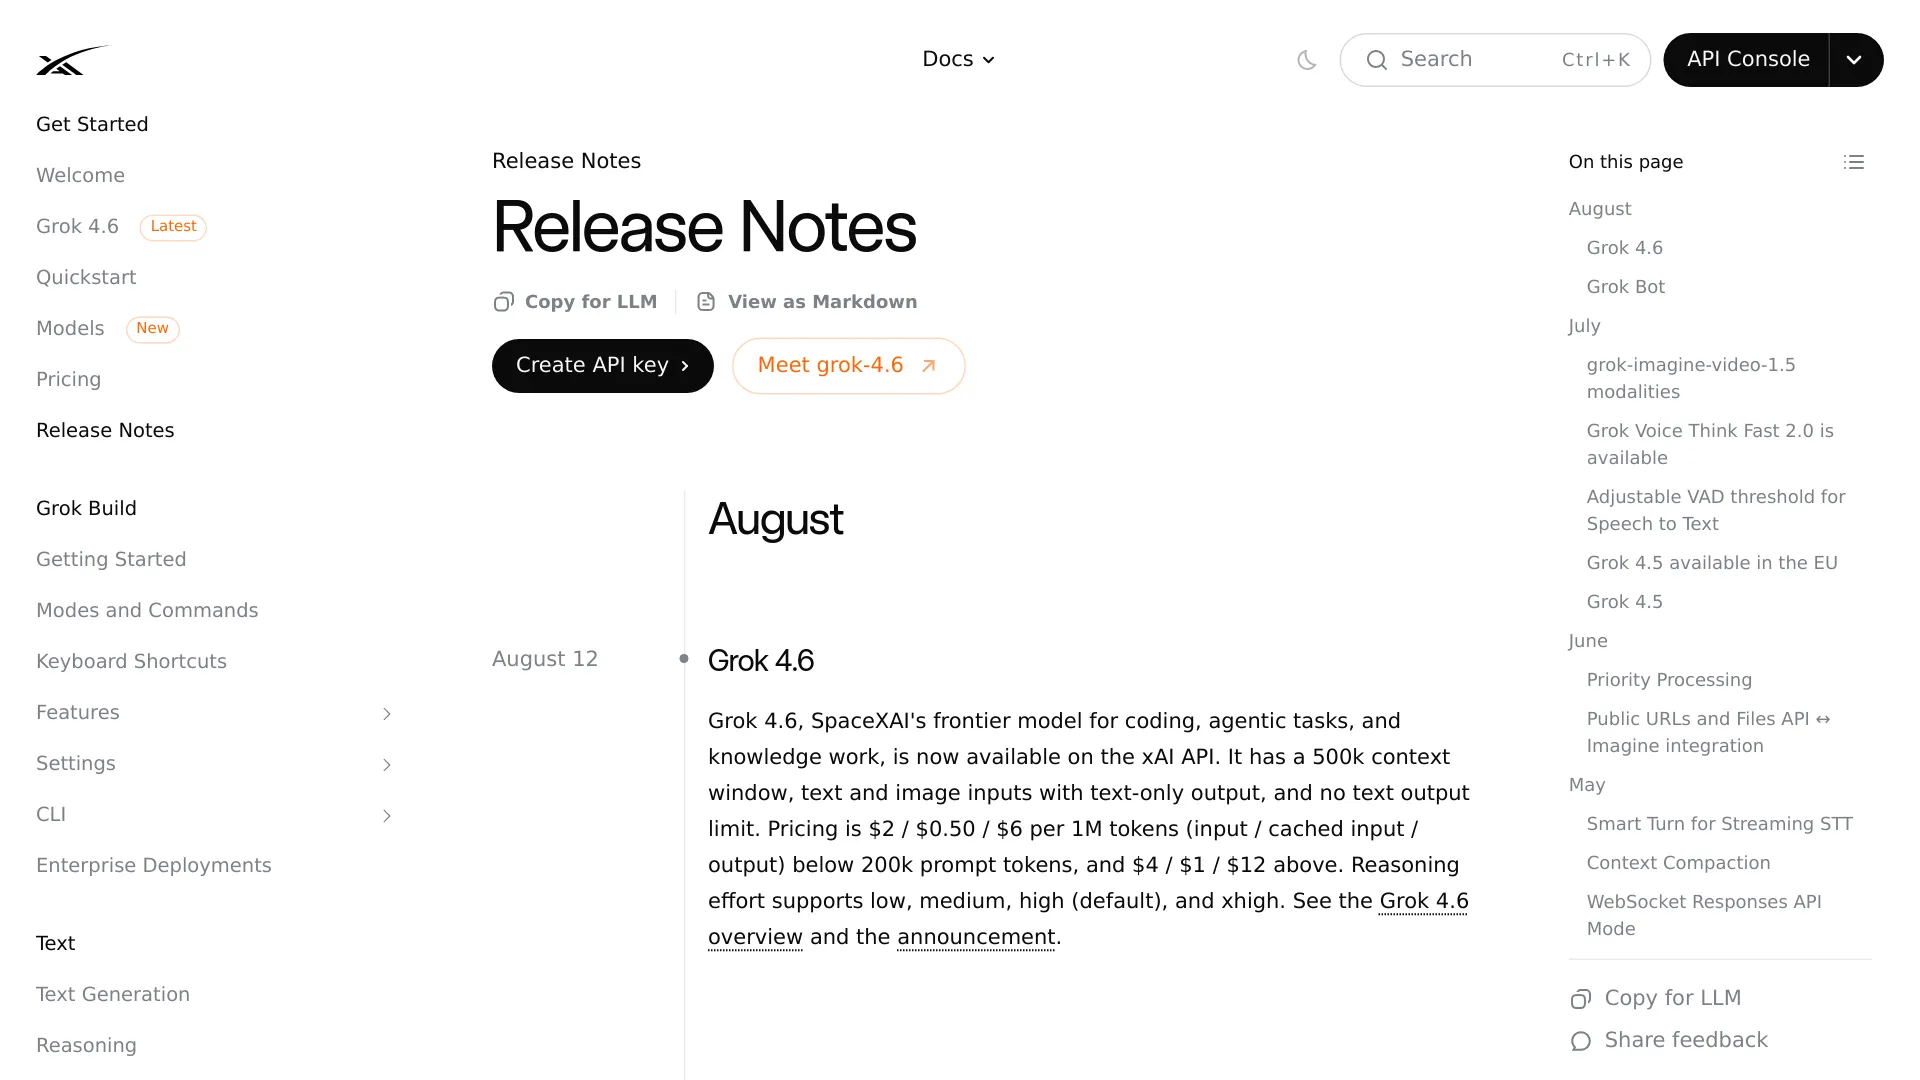
对于以文本产出为主的编程或知识工作 Agent,只要提示词规模不超过 xAI 的 200K-prompt-token 定价门槛,Grok 4.6 是更务实的默认选择。xAI 在 2026 年 8 月 12 日的发布说明中列出了 500K 上下文窗口、文本和图像输入、文本输出,以及从 low 到 xhigh 的四档 effort 设置。最权威的规格来源仍是 xAI 的开发者发布说明。
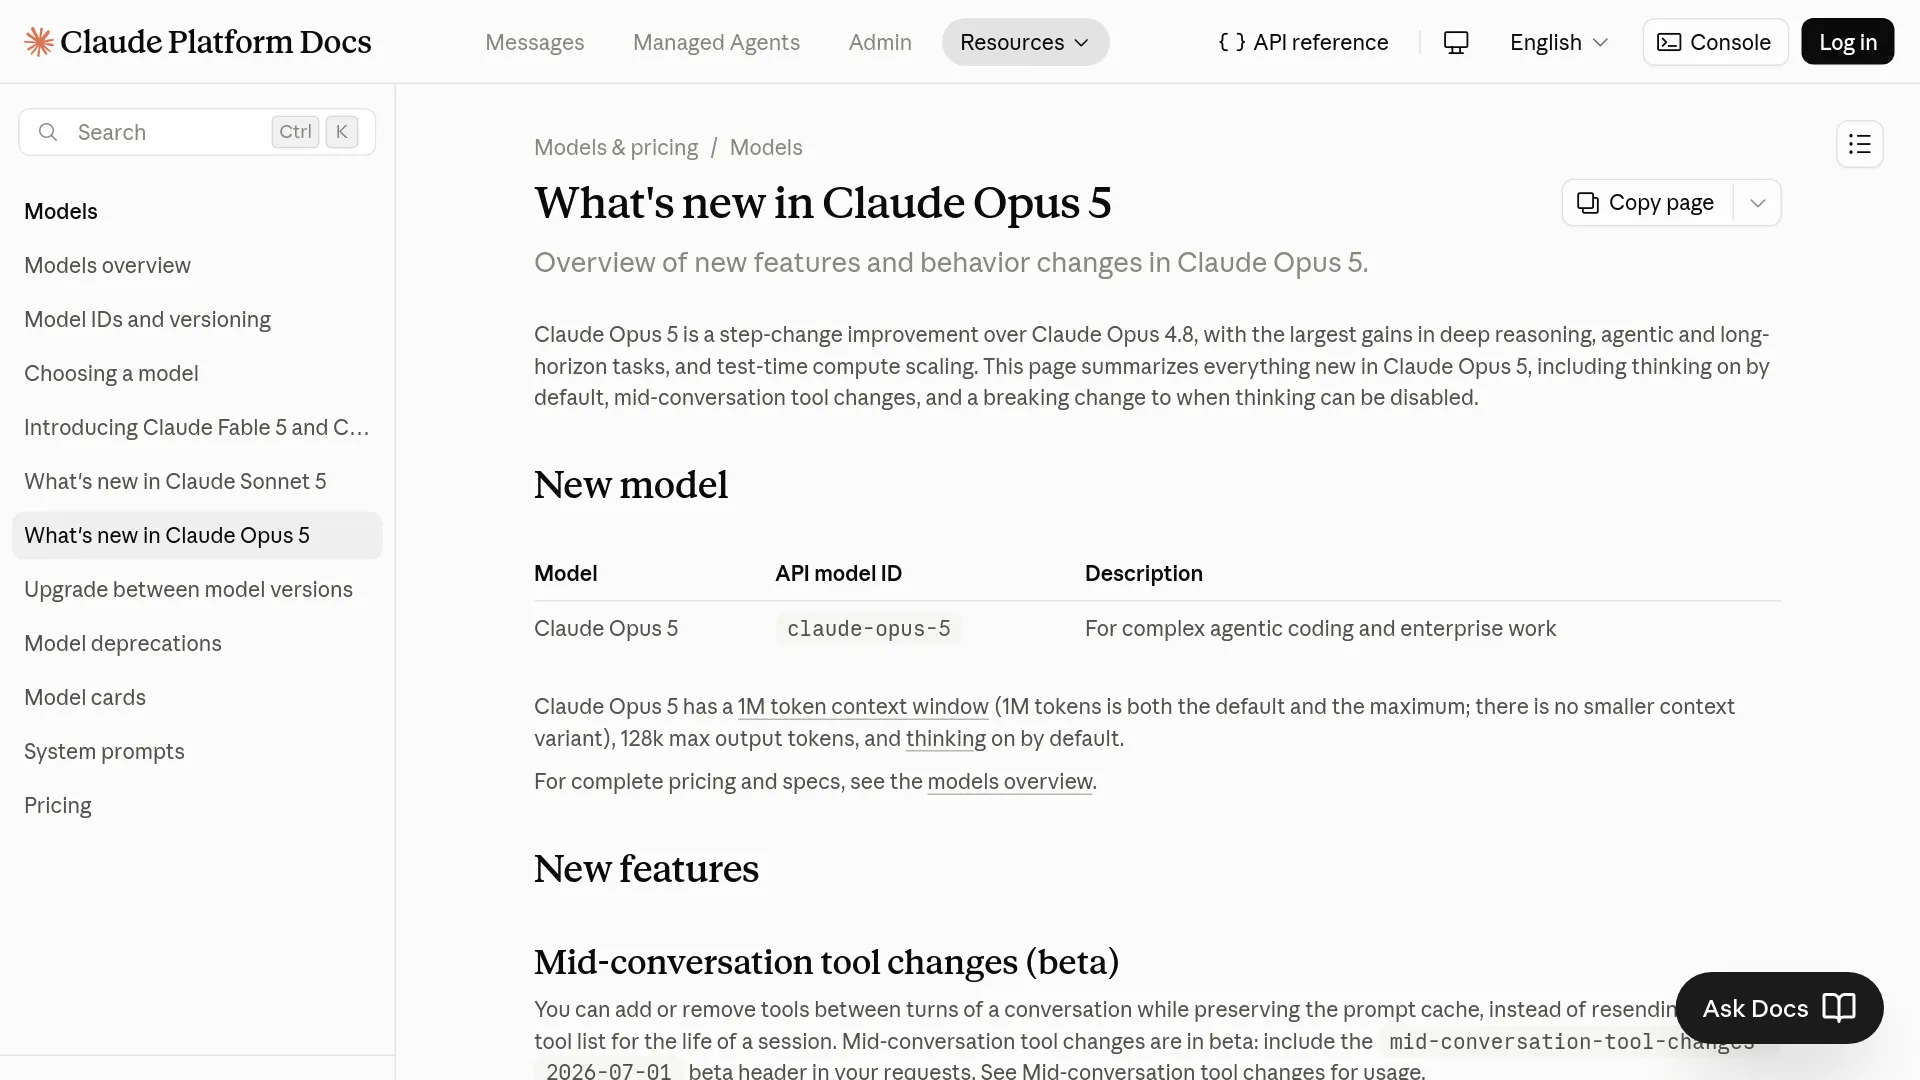
如果 500K tokens 不够用、工作流需要最多 128K 输出 tokens,或者集成方案依赖 Anthropic 的 fallback 与动态工具列表能力,Claude Opus 5 会更合适。Anthropic 的文档说明,它拥有默认且最高均为 1M tokens 的上下文窗口、默认开启的 thinking,并可通过 API 和主要云合作伙伴使用 claude-opus-5。相比一个微小的排行榜分差,Claude Platform 的 Opus 5 文档对实际选型更有决定性。
本文引用的资料并未给出一项能判定所有编程任务胜负的统一基准测试。更合理的起点,是先在自己的测试框架中核对最大提示词长度、所需输出长度、工具调用契约,以及单个完整任务的成本。
先把 API 约束列清楚,别急着对比分数
Grok 4.6 和 Claude Opus 5 都支持文本与图像输入,并生成文本。真正拉开差距的,是上下文容量、长上下文计费方式、输出约束和集成控制能力。
| API 属性 | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| 上下文窗口 | 500K tokens | 1M tokens |
| 输入模态 | 文本、图像 | 文本、图像,以及 Anthropic 所述的 PDF/文档工作流 |
| 输出模态 | 文本 | 文本 |
| 最大文本输出 | xAI 发布说明未给出数值上限 | 128K tokens |
| Effort 设置 | low、medium、high、xhigh | low、medium、high、xhigh、max |
| 默认 effort | high | high |
| 标准输入价格 | $2/M tokens | $5/M tokens |
| 标准输出价格 | $6/M tokens | $25/M tokens |
| 长提示词规则 | 提示词超过 200K tokens 后,输入 $4/M、输出 $12/M | Opus 5 发布文档未说明类似门槛 |
| 缓存输入 | 低于 200K 时为 $0.50/M;高于 200K 时为 $1/M | 最小可缓存提示词为 512 tokens,缓存价格另有文档说明 |
Grok 4.6 的标价单价更低,但提示词超过 200K 后会翻倍;Opus 5 虽然更贵,但对于确实需要的工作流,1M 上下文可能省去分块或检索带来的额外开销。
Grok 4.6:200K 门槛如何改变成本
当提示词低于 200K tokens 时,Grok 4.6 的标价为每百万输入 tokens $2、每百万输出 tokens $6。提示词一旦超过 200K tokens,xAI 标出的价格变为输入 $4/M、输出 $12/M;缓存输入则分别为 $0.50/M 和 $1/M。相比宣传中的低价起点,这条计费分界线更值得关注。xAI 的发布说明明确列出了两个价格档位。
按标价计算,100K 未缓存输入 tokens 加 20K 输出 tokens,成本为 $0.32;250K 输入加 20K 输出 tokens,在适用高价档后成本为 $1.24。这只是单次请求的计算,并不是对 Agent 整体运行成本的估算,因为重试、工具调用、缓存前缀和不断累积的上下文,都可能主导最终账单。
一则近期 r/grok 讨论报告了特定配置下的 CursorBench 3.2 数据:Grok 4.6 Extra High 为每任务 $2.81、46 步;Opus 5 Max 则为 $8.23、78 步。应将这些数字视为作者报告的测试框架结果,而不是供应商中立的保证;同一帖子还指出,Grok 4.6 在 Terminal-Bench 3.0 上为 26.0%,落后于其他被点名的模型。
Opus 5:影响集成设计的不是价格而是控制面
Claude Opus 5 默认启用 thinking。max_tokens 是隐藏思考与可见输出共用的硬上限,因此,从不使用 thinking 的 Opus 4.8 请求迁移过来时,可能需要提高输出预算。Anthropic 还说明,若将 thinking: {"type":"disabled"} 与 xhigh 或 max 结合使用,API 会返回 HTTP 400。迁移说明给出了两种处理方式:关闭 thinking 时降低 effort,或移除关闭 thinking 的设置。
Claude Opus 5 还将最小可缓存提示词从 Opus 4.8 的 1,024 tokens 降至 512 tokens。其 beta 控制能力支持在对话中途修改工具而不使提示词缓存失效,并提供托管的 fallbacks: "default" 模式。对于权限或工具集经常变化的 Agent,这些能力很有价值;对于简单的无状态 completion 接口,则没有实际意义。
Fast mode 是仅限 API 使用的研究预览版,定价为输入 $10/M、输出 $50/M,正好是标准 Opus 5 价格的两倍。Anthropic 表示,它无法通过 Amazon Bedrock、Google Cloud 或 Microsoft Foundry 使用,因此不能想当然地同时获得可移植性与速度。Anthropic 的发布公告列出的标准价格为输入 $5/M、输出 $25/M。
编程 Agent 实测只能指明方向,不能选出通吃的赢家
Anthropic 报告称,Opus 5 在最高 effort 下的 CursorBench 3.2 得分约为 70.0%,每个任务成本约 $8.50;与 Fable 5 报告的最佳分数相差不超过 0.5 个百分点,但成本约为其一半。这些是 Anthropic 图表中的结果,应理解为供应商的评测证据,而非跨供应商审计。Opus 5 发布公告说明,其 Frontier-Bench 方法是在 Anthropic 内部运行中,对每项任务尝试五次。
对于代码审查,更有参考价值的是一项看似独立、但范围较窄的测试。CodeRabbit 使用了来自真实开源 pull request、约 100 种经验证的错误模式,每个配置运行三次,并对经过过滤的审查评论进行评估。在 xhigh effort 下,其 Opus 5 配置找出了 55.2% 的已知问题,而生产基线为 61.1%;可操作精度则为 39.3%,高于基线的 35.2%;但同时产生了 92 条吹毛求疵式评论,而基线只有 23 条。CodeRabbit 的 Opus 5 评估建议为 Opus 5 分配一个特定的、以精度为核心的角色,而不是把它作为唯一的安全保障。
这些证据支持一条明确原则:应在多个 effort 档位下评估 Opus 5,并在自己的 pull request 上衡量召回率、精度、token 消耗和审查噪声。至于 Grok 4.6,xAI 当前发布说明提供了 API 契约和价格,但没有发布可直接对比的代码审查研究。不要根据编程 Agent 分数,直接推断它在代码审查上获胜。
按部署场景选模型
对于提示词通常低于 200K tokens、并且优先考虑较低 API 标价的 Agent,推荐 Grok 4.6。测试预算应围绕这一门槛设置:即使初始提示词不大,仓库 Agent 也可能因工具输出和重试而越过它。
如果仓库、文档或 Agent 会话需要超过 500K tokens 的活跃上下文、最多 128K 输出,或需要 Anthropic 已文档化的工具变更和 fallback 控制能力,推荐 Claude Opus 5。先从 high 开始,再测试更低的 effort,别一开始就认定 max 值得额外成本。
自动化代码审查不应根据通用编程排行榜来选择任何一款模型。应运行带标注的 pull request 集合,记录问题召回率与误报负担,并为并发、API 使用和验证缺陷保留第二条审查路径。CodeRabbit 发现,对于其测试的 Opus 5 配置,这些类别的表现相对较弱。其分类结果的意义在于提醒你验证任务匹配度,而不是对所有 Claude 部署做出结论。
| 部署场景 | 默认选择 | 决策依据 |
|---|---|---|
| 提示词低于 200K tokens、成本敏感的编程 Agent | Grok 4.6 | 其标价为输入 $2/M、输出 $6/M |
| 上下文超过 500K 的长仓库或文档会话 | Claude Opus 5 | 1M 上下文窗口与 128K 输出上限 |
| 工具会动态变化的 Agent | Claude Opus 5 | Beta 的对话中工具变更可保留缓存 |
| 频繁出现超过 200K tokens 提示词的任务 | 同时评估两者 | Grok 4.6 在该门槛处的标价 token 费率翻倍 |
| 代码审查流水线 | 在带标注的 PR 上评估两者 | 召回率、精度、重试和审查噪声比宣传分数更重要 |
常见问题
Grok 4.6 比 Opus 5 更便宜吗?
在提示词低于 200K tokens 时,xAI 列出的 Grok 4.6 价格为输入 $2/M、输出 $6/M;Opus 5 则为输入 $5/M、输出 $25/M。但 Grok 4.6 的标价在超过 200K tokens 后会翻倍,因此应比较完整任务成本,而不只是首次请求的价格。
编程应该选哪个模型?
如果 Agent 通常低于 200K prompt tokens,且你希望获得更低的 API 标价,选 Grok 4.6。若必须使用 1M 上下文、128K 输出或 Anthropic 的 Agent 控制能力,则选 Opus 5;无论选哪个,都应在实际运行的编程语言、仓库形态和工具循环中验证。
下一步:用真实任务跑一轮部署测试
为每个候选模型运行同样的 20 到 50 个代表性任务,固定工具、固定重试上限,并记录 token 使用情况。选择以更低的完整任务成本达到所需通过率的模型;同时保留另一个模型作为路由选项,用于其上下文或控制面优势具有决定性的工作负载。
延伸阅读:Claude Opus 5 API pricing guide、Grok 4.6 release details 和 Grok 4.6 vs GPT-5.6。