 AIREITER
GLM-5.2 在 Arena 的 Code Arena Frontend 榜单上以 1,595 Elo 位列第 2,在 FrontierSWE 上也只比 Claude Opus 4.8 低 1 分;但开发者依然在主动寻找替代品。问题通常不在能力。自 2026 年 6 月发布以来,下文引用的开发者讨论不断指向三道门槛:Coding Plan 额度任务做到一半就耗尽、高峰时段报错,以及长 Agent 循环中惊人的 Token 消耗,让标价 $1.40/$4.40 看起来远没有那么便宜。最适合的 GLM-5.2 替代方案,取决于你刚碰上的是哪一道门槛。
先看结论:不同切换理由该选谁
先给出五个直接结论,依据详见后文:
- 额度消耗快 / 单次 Agent 循环成本高:DeepSeek V4 Flash,输入 $0.14/M、输出 $0.28/M,支持 1M 上下文。
- Agent 循环不稳定:Kimi K2.7 Code,输入 $0.95/M、输出 $4.00/M。
- 最难任务需要更高上限:Claude Opus 4.8,SWE-Marathon 得分是 GLM-5.2 的两倍,但价格属于闭源模型档位。
- 需要自托管或数据控制:Qwen3-Coder(Apache 2.0);如果你有 372–475 GB 内存可运行 4-bit 版本,也可以使用 GLM-5.2 自己的 MIT 权重。
- 模型没问题,只是想用更新版本:GLM-5.3,价格仍为 $1.40/$4.40,Z.ai 已在发布当天确认。
GLM-5.2 的优势,以及真正的使用成本
Z.ai 官方文档将 GLM-5.2 定位为纯文本旗舰模型:上下文窗口 1M Token,最大输出 128K Token;API 价格为输入 $1.40/M、输出 $4.40/M、缓存输入 $0.26/M。模型权重采用 MIT 许可证,2026 年 6 月 16 日发布;此前 6 月 13 日的首轮上线阶段,模型一度仅向 GLM Coding Plan 用户开放。模型卡数据显示:Terminal-Bench 2.1 为 81.0(Opus 4.8 为 85.0),SWE-bench Pro 为 62.1(Opus 4.8 为 69.2),FrontierSWE 为 74.4,对比 Opus 4.8 的 75.1。
这些成绩让它以开放权重的价格触及闭源前沿模型的能力边缘。但用户抱怨的重点在运行层面。GLM Coding Plan 的 Pro 档在 5.2 发布前后从不足 $35/月涨至 $65/月,@bridgemindai在涨价当天记录了这一变化。相比价格本身,计划内额度引发的抱怨更强烈:
“GLM 5.2 一天就能把你一周的速率额度用光。”—— u/intl_spy,r/opencode
“我喜欢 GLM-5.2,但天啊,它实在太能吃 Token 了。”—— @atomtanstudio
一位用 GLM-5.2 运行自演化 Agent 处理实际工作的开发者称,自己一个周末烧掉了 $500+;他还指出,任务运行中途切换模型会丢失 KV 缓存,已有上下文必须重新付费(@Xianbao_QIAN)。另一位开发者则直白地概括了这套价值主张的上限:
“GLM 5.2 很棒,但我的 $200/月 Codex 订阅,能提供的使用量还是比 $200 的 GLM 5.2 API 调用更多。它很适合作为补充模型……但无论如何都谈不上替代品。”—— @mweinbach
再加上高峰时段的容量问题:从 GLM-4.5 起就是套餐订阅用户的 @gengdaJ表示,晚间服务器会“爆掉”,只能退回旧模型。这也解释了为什么喜欢 GLM-5.2 的人,仍会搜索“GLM-5.2 alternatives”。
替代模型一览:按价格和痛点匹配
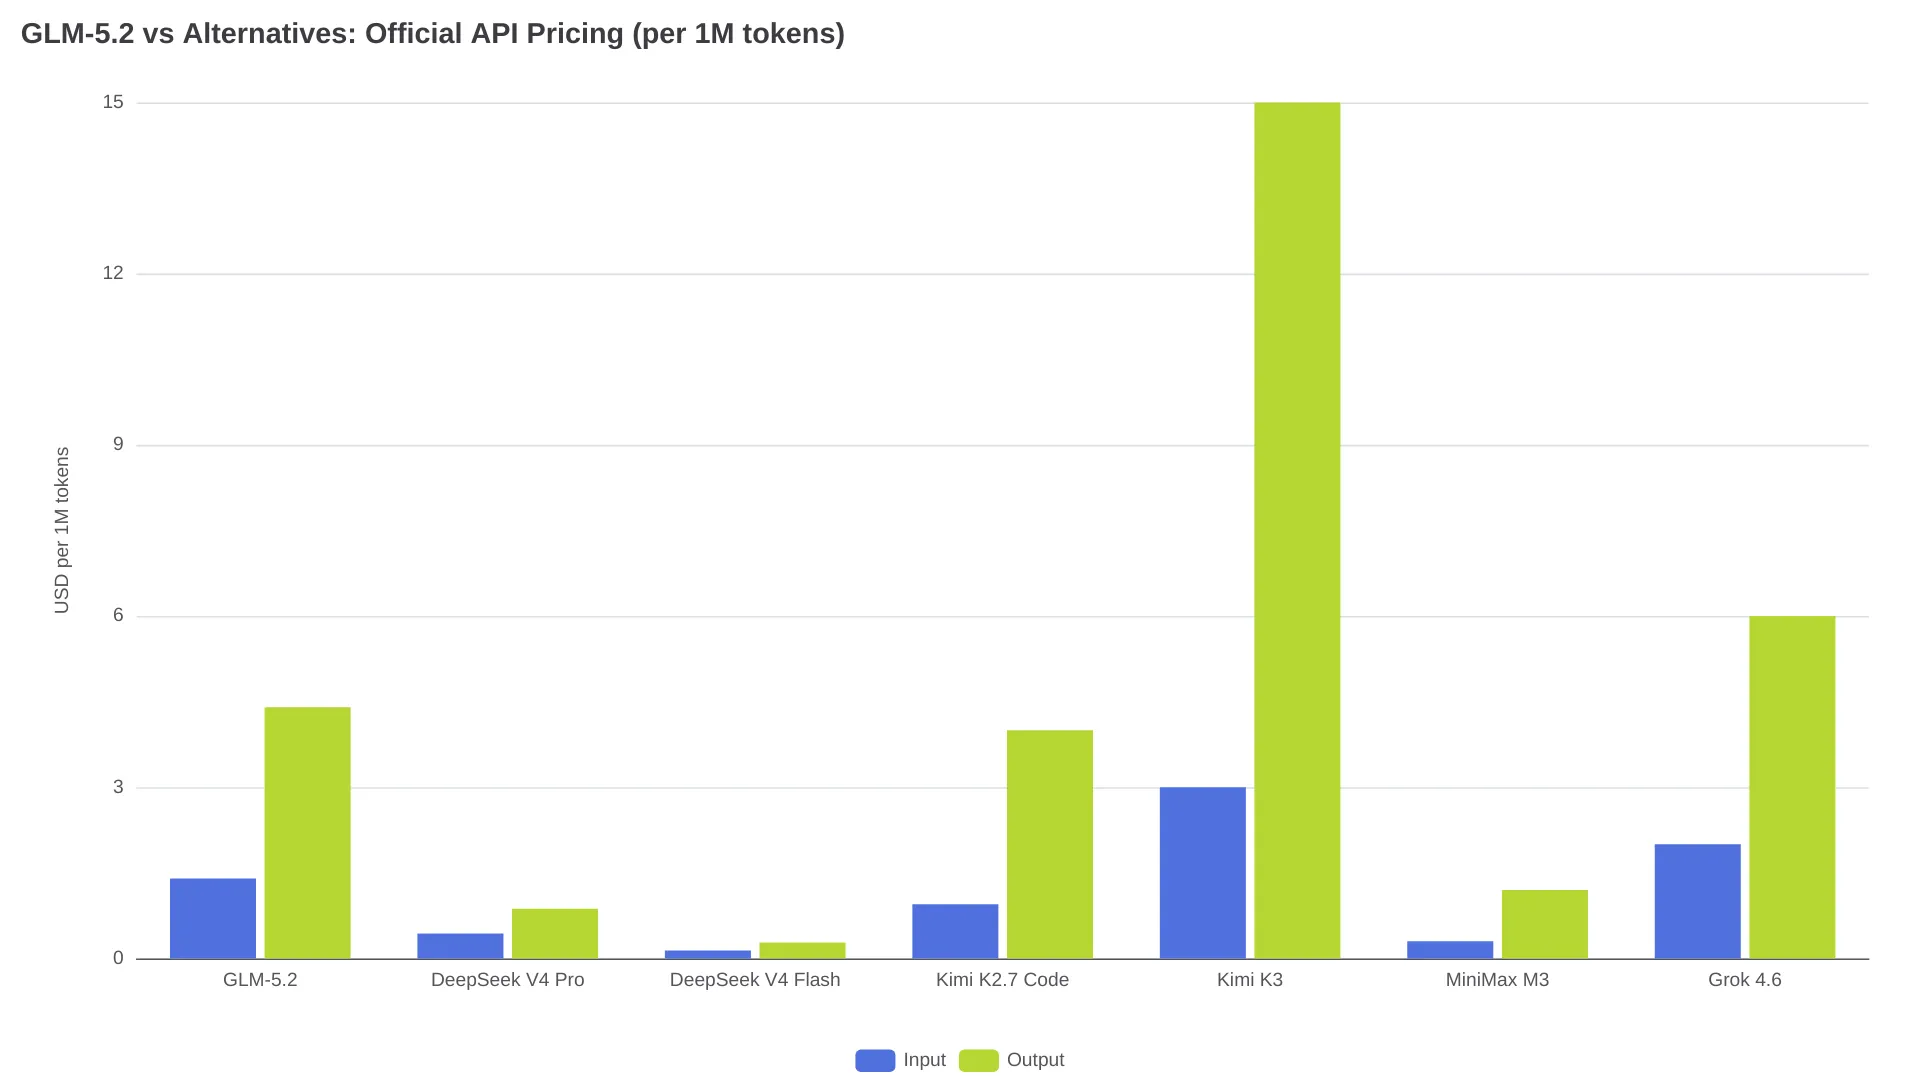
以下价格均来自厂商自身的定价页面,采集于 2026 年 8 月。Kimi K3 与 MiniMax M3 所列均为缓存未命中时的输入价格,缓存命中价要低得多。
| 模型 | 上下文 | 权重 / 许可证 | API 价格($/1M,输入 / 输出) | 适合切换的情况 |
|---|---|---|---|---|
| GLM-5.2(基准) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | 开放(据 Layer3 Labs 为 MIT) | $0.435 / $0.87 | 希望在相同上下文规模下,以更低成本处理高难推理 |
| DeepSeek V4 Flash | 1M | 开放 | $0.14 / $0.28 | 额度消耗是唯一或核心问题 |
| Kimi K2.7 Code | 256K | 开放(Modified MIT) | $0.95 / $4.00 | 比起上下文规模,更看重 Agent 循环的可靠性 |
| Kimi K3 | 1M | 闭源 | $3.00 / $15.00 | 既要 Kimi 的稳定性,也需要 1M 上下文 |
| MiniMax M3 | 1M | 闭源 | $0.30 / $1.20* | 需要多模态输入,或有高吞吐、成本敏感的工作负载 |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | 权重免费;托管价格各异 | 目标是自托管或微调 |
| Grok 4.6 | 500K | 闭源 | $2.00 / $6.00 | 优先追求速度,同时需要大但可控的上下文 |
除这七款之外,下文还会介绍两条升级路径:总在最难任务上失败的团队可考虑 Claude Opus 4.8;想以相同价格留在同一模型家族的用户可升级至 GLM-5.3。
\* MiniMax M3 这一档适用于输入 ≤512K Token;超过该阈值后价格翻倍。根据 Z.ai 的发布公告,GLM-5.3 与 GLM-5.2 定价完全相同,因此未纳入成本对比。
按症状选模型:该换到哪一款
额度烧得太快:把执行循环交给 DeepSeek V4 Flash
账很好算。缓存未命中的输入,GLM-5.2 为 $1.40/M,是 DeepSeek V4 Flash $0.14/M 的10 倍;输出端 $4.40 对 $0.28,差距达到15.7 倍。对于 Agent 循环里的执行环节——编辑文件、修复测试、生成样板代码——每一轮都会累积这项差价。DeepSeek 还提供同样 1M Token 的上下文和 384K 最大输出。V4 Pro 的输入/输出价格为 $0.435/$0.87,仍保留大部分成本优势,同时面向更困难的推理任务;我们的GLM-5.2 vs DeepSeek V4 Pro 对比分析了各自胜场,V4 Flash 正面对比则聚焦预算档选择。
OpenCode Go 订阅用户逐渐形成的模式并非彻底替换,而是分工:GLM-5.2 负责规划和审查,更便宜的模型承担重复执行工作。u/narkeeso写道:“我只用 OpenCode Go GLM 5.2 做规划。”同一生态中的 u/Endoky 也表示:“只把 GLM 5.2 当作升级模型或用于规划。”
Agent 循环不稳定:Kimi K2.7 Code
当问题不在模型能力而在服务质量时,Kimi 是我们所查讨论中最常被提及的替代选择。一位用户的总结原本以中文发布:
“模型能力差不多,但无法稳定提供服务,是我选择 Kimi 而不是 GLM 的原因。”—— @wonjder
Kimi K2.7 Code 是面向编程的专用选择:输入 $0.95/M、输出 $4.00/M,缓存命中时为 $0.19/M;上下文为262,144 Token,仅有 GLM-5.2 窗口的四分之一,这正是实际的取舍。它支持文本、图像和视频输入,也补上了 GLM-5.2 作为纯文本模型留下的多模态空缺。如果 256K 容不下你的代码仓库,Kimi K3 可提供 1M 窗口,但价格是 $3.00/$15.00。注意 $15 的输出价格是 GLM-5.2 的 3.4 倍,因此选择 K3 是为稳定性付费,不是为了省钱。基准测试部分可参阅Kimi K2.7 Code vs GLM-5.2 对比。
最难任务需要更高上限:Claude Opus 4.8
根据 Z.ai 的模型卡,在 SWE-Marathon——包括编译器构建、内核工作和多小时自主任务——Opus 4.8 得分为 26.0,GLM-5.2 为 13.0;NL2Repo 则为 69.7 对 48.9。同一模型卡也指出,GLM-5.2 在这两个榜单上仍是排名最高的开放模型,但任务越长,差距越明显。Opus 是闭源模型,无法自托管,且价格昂贵;我们的GLM-5.2 vs Opus 对比详细说明了何时这部分溢价值得支付。
自托管与数据控制:Qwen3-Coder,或直接部署 GLM 权重
Qwen3-Coder 和 Qwen3.8 Max 均采用Apache 2.0许可证,支持 1M Token 上下文,也提供适合单 GPU 部署的小型变体。Layer3 Labs和glm5.app都将其列为自托管首选。若目标是微调和私有化部署,它们是这些替代方案中最务实的选择;我们的Qwen 3.8 Max 开放权重文章介绍了这一模型家族。
一个看似反直觉的选项是直接自托管 GLM-5.2,因为 MIT 许可证允许这样做。但硬件要求并不友好:BF16 权重占用1.51 TB,即使使用Unsloth 的 GGUF 版本进行 4-bit 量化,加载也需要372–475 GB内存。实际部署中,4-bit 版本已属于多 GPU 服务器范围,完整 BF16 则需要集群级资源;本地工具链也尚不成熟:llama.cpp 到 2026 年 7 月 24 日才加入 GLM-5.2 的 indexer 支持(PR #25407)。自托管 GLM-5.2 是数据主权方案,不是图方便的方案;没有集群时,Qwen 的紧凑变体才是工作站级替代选择。
多模态与低成本高吞吐:MiniMax M3
MiniMax M3 结合了 1M 上下文和多模态输入,价格为输入 $0.30/M、输出 $1.20/M(适用于 ≤512K 的档位;超过该阈值两项价格都会翻倍,预算时需注意)。团队预算方面,MiniMax 的Token 套餐为 $20/$50/$120 每月,覆盖公司旗下 M3、M2.7、图像与语音产品线,额度按 5 小时滚动窗口和周度窗口计量。
速度优先:Grok 4.6
Grok 4.6 的标价为输入 $2.00/M、输出 $6.00/M,上下文为 500K。xAI 的 API 页面宣称其编程和工具调用能力业界领先,但并未公开基准测试表,因此这类定位只能当作定位来看。不过,用户层面的信号确实存在:@bourneliu66认为,GLM 在他“前三大模型”中的位置已被 Grok 取代——按他的说法,Grok 更强、更快也更便宜。在接受这种排序前,仍应先用自己的工作负载验证。
没有故障,只想用最新 GLM:GLM-5.3
根据Z.ai 的公告,GLM-5.3 于 2026 年 8 月 18 日上线 API,价格与 GLM-5.2 完全相同。如果你浏览替代方案只是出于版本升级焦虑,而非实际痛点,可查看GLM-5.2 vs GLM-5.3 对比,了解真正发生了哪些变化。
更常见的做法:保留 GLM-5.2,但降低它的职责
上面讨论串里反复出现的落点,不是完整迁移,而是把 GLM-5.2 降级为规划和审查模型,让成本更低的模型负责执行。这与模型特性相符:Z.ai 将它定位为长时间运行的工程 Agent 工作而设计的模型,而它也是预算档中每 Token 最贵的一款。
这种分层架构能否成立,关键看两个机制。第一是 KV 缓存丢失:在任务中途切换模型,或在同一模型的不同服务商之间切换,都会重新为上下文付费。第二是服务商差异:r/opencodeCLI 用户报告,即使服务的是同一模型,Fireworks、NeuralWatt 和 OpenCode Go 之间的速度差距也很大。
单一的 OpenAI 兼容端点可以解决一半运营问题:两段流程都保留相同的GLM-5.2 API请求格式,服务商性能下降时可重新路由,账单也可统一结算。但它不能让上下文免费;缓存复用无法跨模型或跨服务商转移,这正是$500 周末案例背后的成本。因此应在任务边界做路由,而不是在运行中途切换。如果你的分层方案部署在 Claude Code 内,我们的GLM-5.2 在 Claude Code 中的使用指南涵盖了工具框架部分。
30 秒决策表
| 你的症状 | 推荐选择 | 需要放弃什么 |
|---|---|---|
| 一周额度一天没了 | DeepSeek V4 Flash | 相较 GLM,部分 Agent 编程能力的打磨程度 |
| Agent 循环死于服务商错误 | Kimi K2.7 Code | 1M 上下文(改为 256K) |
| 最难的多小时任务总是失败 | Claude Opus 4.8 | 开放权重、低价格、自托管 |
| 必须把权重部署在自己的硬件上 | Qwen3-Coder | GLM 在前端编程上的 Elo 领先表现 |
| 通用任务太“吃 Token” | MiniMax M3 | 输入超过 512K 后价格翻倍 |
| 受监管或受采购流程约束 | 自托管 Qwen 或 GLM 权重 | 托管服务的便利性 |
| 只想用最新 GLM | GLM-5.3 | 无需放弃任何东西;价格相同 |
常见问题
综合来看,最好的 GLM-5.2 替代方案是什么?
DeepSeek V4 Pro 是最接近的全能替代方案:1M 上下文、开放权重,单 Token 成本低 3-5 倍。若长时间 Agent 任务中的稳定性比基准分数差异更重要,Kimi K2.7 Code 是更好的选择。
DeepSeek 编程能力比 GLM-5.2 更强吗?
在高难度算法推理上,glm5.app 的对比将 DeepSeek V4 Pro 排在前面;但在长周期、多文件的 Agent 工作中,GLM-5.2 的 1M 上下文和长程 Agent 训练——这是 Z.ai 明确指出的专长——仍令其保持领先。实际分工可以是:DeepSeek 负责执行,GLM 负责规划。
最便宜的 GLM-5.2 替代方案是哪一款?
DeepSeek V4 Flash,价格为输入 $0.14/M、输出 $0.28/M;缓存命中输入为 $0.0028/M,对于重复上下文而言几乎免费。
哪些替代方案同样支持 GLM-5.2 的 1M Token 上下文?
DeepSeek V4 Pro、V4 Flash、Kimi K3、MiniMax M3 和 Qwen3.8 Max 都标注为 1M Token 窗口。Kimi K2.7 Code(256K)和 Grok 4.6(500K)则不支持。
不切换模型,能否在本地运行 GLM-5.2?
技术上可以,MIT 权重已提供;但 4-bit 版本需要 372–475 GB RAM,且 llama.cpp 支持直到 2026 年 7 月 24 日才合并。对绝大多数团队而言,托管 API 访问仍是唯一现实的路径。
GLM-5.2 替代方案的订阅制每月要多少钱?
MiniMax Token 套餐为 $20–$120/月。根据 Digital Applied 的定价报道,Kimi 的 Code CLI 起价为 $19/月,Z.ai Coding Plan 起价为 $18/月;Z.ai Pro 档自 6 月涨价后为 $65。