 AIREITER
预告了三周之后,Qwen3.8-2.4T-A95B 的权重终于在 2026 年 8 月 12 日上线 ModelScope。它的总参数量达到 2.4 万亿,但每个 token 实际只激活 950 亿参数。不过,模型即便量化到 4-bit,仍需要约 1.2 TB 显存;除了数据中心,几乎没有人能在本地真正跑起来。下面梳理这次发布包含什么、使用成本如何,以及哪些情况下 API 才是唯一理性的选择。
Qwen3.8-2.4T-A95B 权重已可下载
权重已经正式开放。阿里巴巴 Qwen 团队于 8 月 12 日晚些时候通过 ModelScope 社区账号发布了 Qwen3.8-2.4T-A95B checkpoint。这也是首个提供开放权重的 Qwen-Max 级模型;此前的 Qwen3.5-Max、Qwen3.6-Max 和 Qwen3.7-Max 均仅提供 API。
这里首先要分清两个名称相近但并不完全相同的对象:“Qwen3.8”实际上指向两种东西:
| 名称 | 定位 | 获取方式 |
|---|---|---|
| Qwen3.8-2.4T-A95B | 开放权重基础模型 | ModelScope(可下载 checkpoint) |
| Qwen3.8-Max | 具备额外生产能力的云端版本 | Alibaba Token Plan、Qoder、QoderWork |
Qwen3.8-Max 以开放权重的 A95B 模型为基础,但加入了后训练增强。阿里巴巴将其描述为一套三阶段系统,覆盖真实环境扩展、统一奖励信号和在线数据平衡。换句话说,开放权重提供的是基础模型,而不是完整的 Max 生产级能力栈。
因此,仍称这些权重“已承诺但尚未发布”的指南已经过时:它确实在阿里巴巴预告的“8 月 10 日当周”内落地了。
关键规格确认:95B 激活参数与原生 256K 上下文
从 7 月 19 日预览版发布到现在,最受关注却一直缺失的规格,就是激活参数量。不少第三方指南此前都将其标为“未公布”。现在答案明确了:2.4 万亿总参数中,每个 token 激活 950 亿参数。
| 规格 | 已确认数值 |
|---|---|
| 总参数量 | 2.4T |
| 每个 token 的激活参数量 | 95B |
| 架构 | MoE(延续 Qwen3.5 的混合设计) |
| 每个 MoE 层的专家数量 | 512 |
| 每个 token 路由的专家数量 | 10 |
| 每个 token 共享的专家数量 | 1 |
| 原生上下文窗口 | 262,144 tokens(256K) |
| 可扩展上下文 | 1,010,000 tokens(1.01M) |
| 训练方法 | Multi-Token Prediction (MTP) |
| 首个开放权重的 Qwen-Max 发布 | 是(2026 年 8 月 12 日) |
有两个细节尤其值得留意。第一,原生上下文窗口是256K,并非外界普遍以为的 100 万 token。1.01M 指的是可扩展模式,阿里巴巴尚未说明这一模式会带来哪些质量取舍。第二,MoE 路由极其稀疏:每个 token 只会调用 512 个专家中的 11 个,即 10 个路由专家加 1 个共享专家。约 4% 的参数激活比例(95B/2.4T),正是这个 2.4T 模型仍能实现每百万输入 token $2 成本的关键。
MTP(Multi-Token Prediction)训练意味着,兼容的推理引擎可在一次前向传播中预测多个 token,从而有望提升吞吐量。不过阿里巴巴尚未说明具体哪些引擎支持这一能力。
自托管的现实:2.4T 参数究竟要花多少资源
规格很亮眼,但真正尝试加载模型时,门槛就会立刻显现。先看最基本的算账。
2.4 万亿参数在 4-bit 量化下,权重本身就需要约 1.2 TB 存储空间,尚未计入 KV cache、激活内存和运行时开销。单张 NVIDIA H200 的显存为 141 GB,8 张合计 1,128 GB,既放不下全部权重,也无法同时服务任何有实际意义的上下文窗口。
| 部署场景 | 所需显存(估算) | 硬件 | 是否现实 |
|---|---|---|---|
| 全精度(16-bit) | ~4.8 TB | 34+ 张 H200 GPU | 仅限数据中心 |
| 4-bit 量化 | ~1.2 TB | 9+ 张 H200 GPU | 仅限数据中心 |
| 1.5-bit 量化 | ~450 GB | 4+ 张 H200 GPU | 空间紧张;质量损失尚不明确 |
| Qwen3.8-27B(替代方案) | 4-bit 下约 27 GB | 1 张消费级 GPU | 可以 |
950 亿激活参数确实有助于单 token 推理吞吐:每次前向计算只经过一部分专家。但激活参数少,并不意味着存储全部 512 个专家网络所需的内存会减少。正如 GEO Toolbox 所说:“Sparse activation makes the model cheap to run at scale, not cheap to own.”
如果你的目标是本地或单服务器部署,Qwen3.8-27B variant 才是实际可行的选择。它同样属于 Qwen3.8 的训练谱系,在 4-bit 下可装入一张消费级 GPU。至于 2.4T 模型,本质上仍是面向研究和数据中心的产品。
什么时候 API 才是更聪明的选择
对于几乎所有团队来说,自托管 2.4T MoE 模型都遥不可及,真正可用的入口自然是 API。阿里巴巴 Model Studio 给出的 Qwen3.8 Max 定价为:每百万输入 token $2、每百万输出 token $6,比其前代和最接近的中国竞争对手都更便宜。
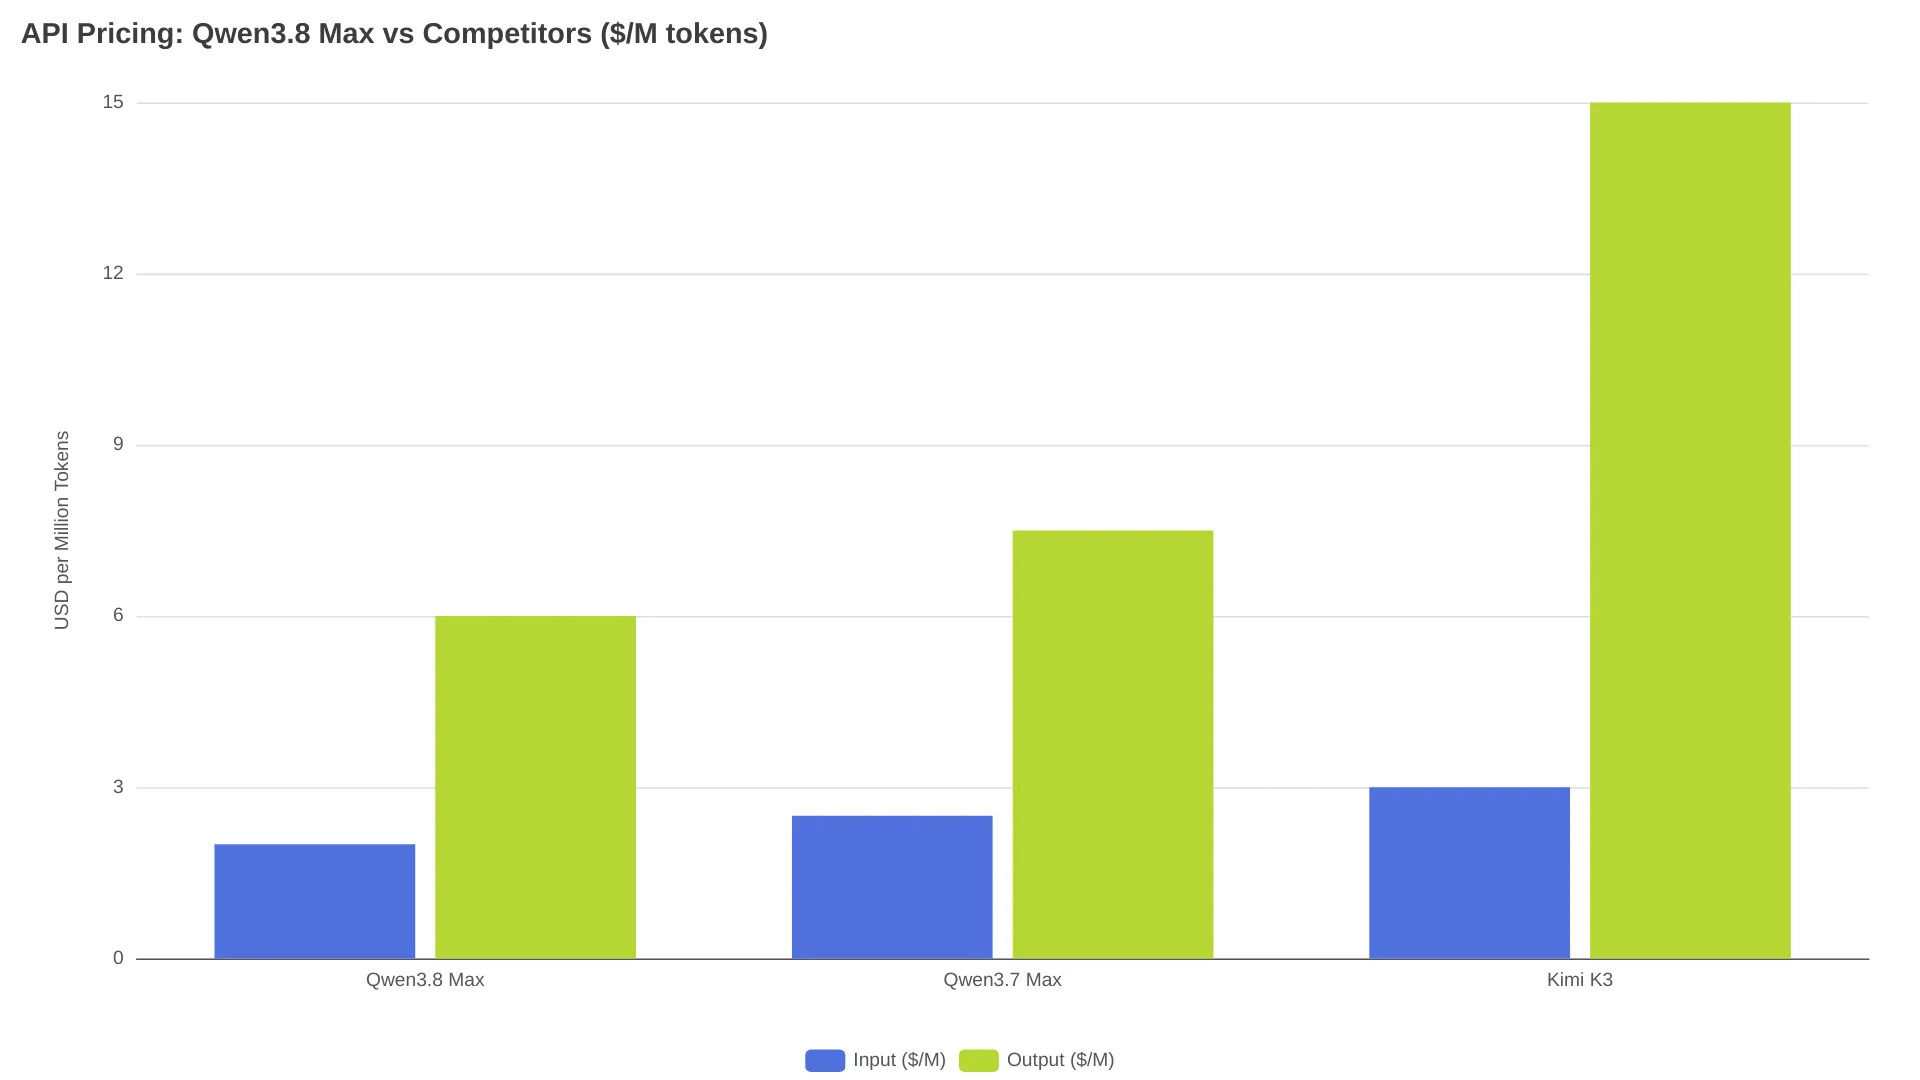
| 模型 | 输入($/M) | 输出($/M) | 上下文 |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 原生 256K(可扩展至 1.01M) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
除按 token 计费的 API 外,阿里巴巴还提供三档订阅:
- Lite:$6/月(约 10,000 credits)
- Standard:$18/月(约 40,000 credits)
- Pro:$68/月(约 160,000 credits)
Token Plan endpoint 同时兼容 OpenAI 和 Anthropic 两种 API 格式,因此 Claude Code、Cursor、OpenCode 等工具无需改动客户端即可接入。阿里巴巴的编程产品 Qoder 在低峰时段(14:00-00:00 UTC)提供最低至标准费率 0.01x 的促销 credits,但这属于上线优惠,并非长期稳定价格。
订阅模式也有一个明显问题:Qwen3.8 Max 的推理模式很容易输出冗长的思考过程,社区关于额度消耗过快的反馈颇为一致:
“Qwen tends to overthink A LOT.” - u/darko, r/Qwen_AI
在同一篇 Reddit thread 中,一位 Lite 订阅用户称,约 5000 万 token 就在不到两天内耗尽了每周额度。另一名 Pro 用户则表示,自己同时运行 7 个并行 agent,即便 cache-hit rate 达到 94%,一天内仍消耗了 5 亿 token。reasoning_effort 参数可设为 low、medium 或 xhigh,它直接决定模型生成多少推理输出,也就决定 credits 消耗得有多快。一名用户测试发现,将其设为 low 后,每次请求的思考时间降至约 10 秒。
如需更详细的成本拆解,可参考我们的 Qwen3.8 Max API pricing guide。
基准测试:Qwen3.8 Max 的强项与短板
阿里巴巴公布了 Qwen3.8 Max 对比 Fable 5 和 GPT-5.6 Sol 的基准成绩。整体表现并不单一,而且厂商自报成绩与独立测试之间的差距大到不容忽视。
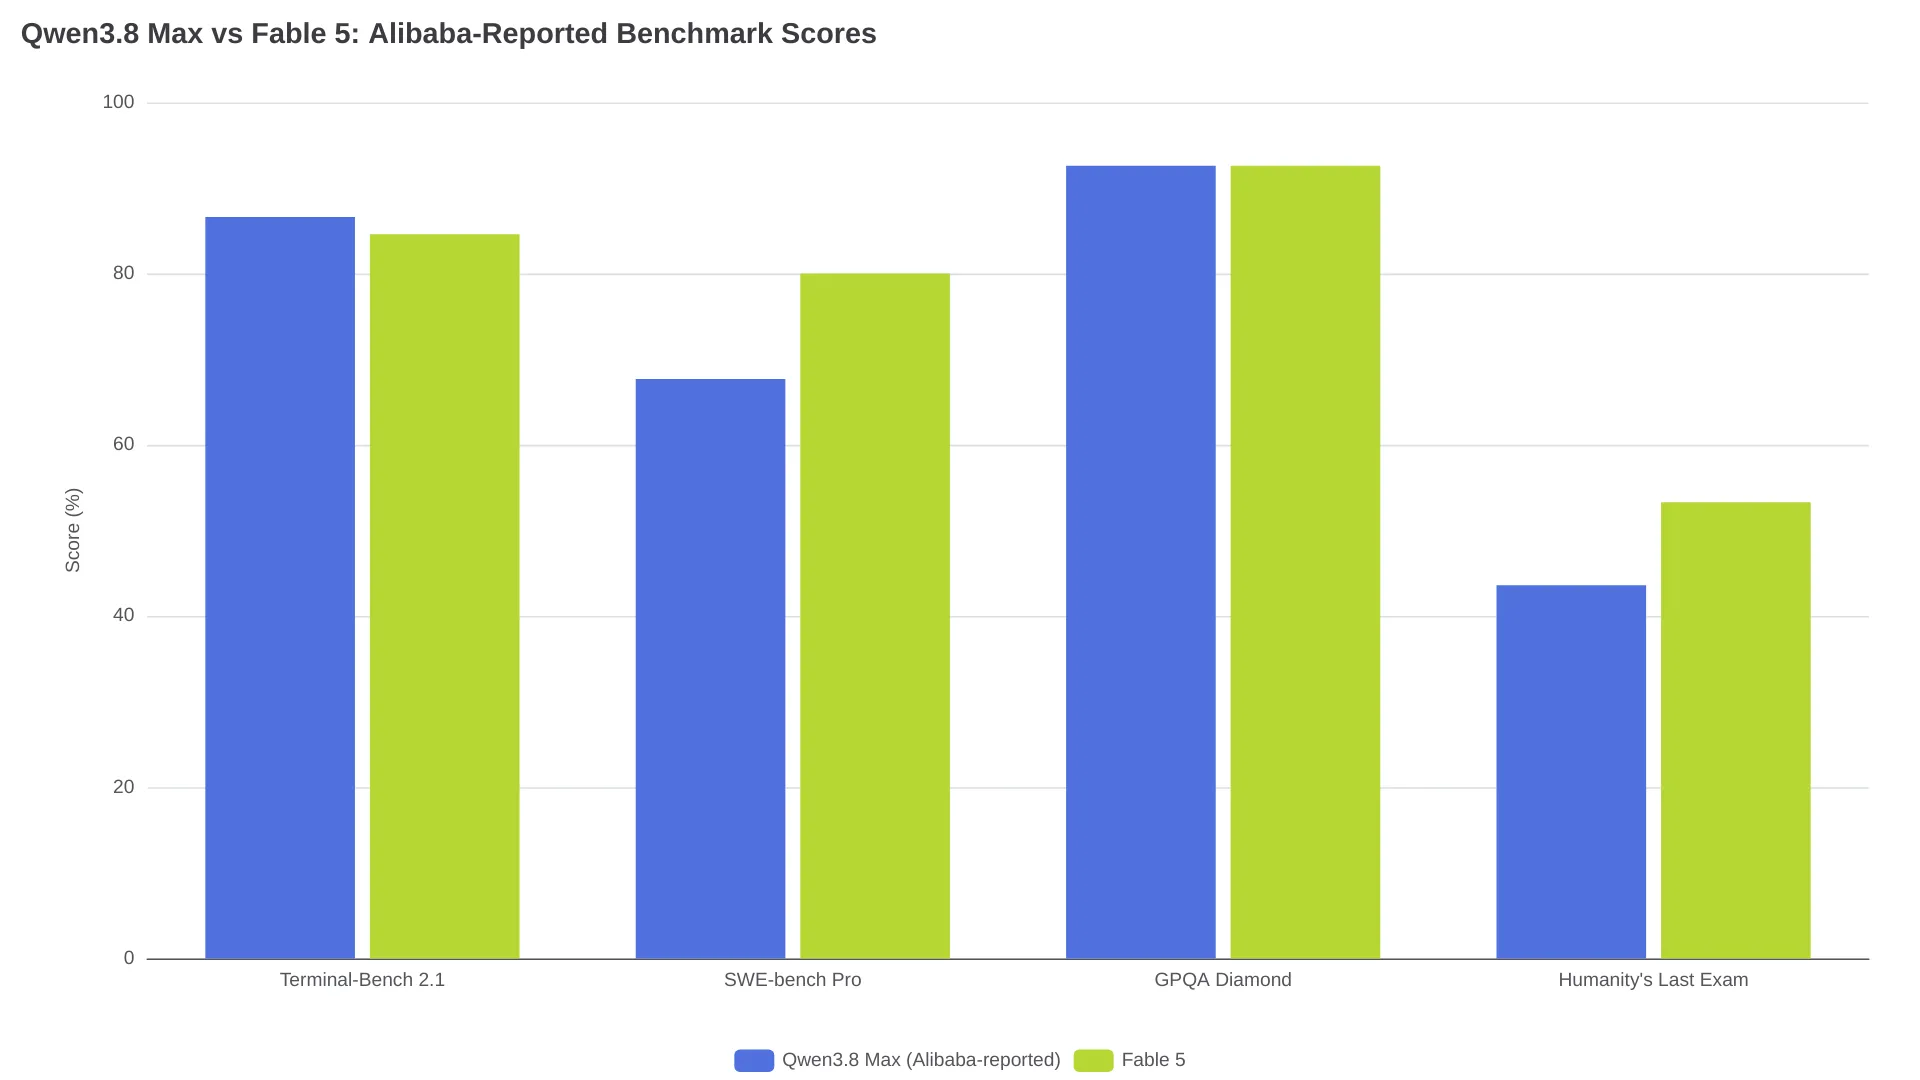
| 基准测试 | Qwen3.8 Max(阿里巴巴) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | 高于 Qwen(未公布具体分数) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | 高于 Qwen |
| Humanity's Last Exam | 43.6 | 53.3 | 未公布 |
独立测试给出的图景有所不同。Artificial Analysis 测得 Qwen3.8 Max 在 Terminal-Bench 2.1 上为 81.3%,比阿里巴巴公布的 86.6% 低 5.3 个百分点。按这一独立成绩计算,Qwen 大致排在总榜第十位,落后于 Fable 5(84.6%)和 Kimi K3(85.0%)。
Qwen3.8 Max 也有明确优势:SWE-bench Pro 的 67.7% 高于 GPT-5.6 Sol 的 64.6%;多模态表现同样强劲,MathVision 为 95.2,对比 Fable 5 的 92.7,LogicVista 则为 91.9,对比 85.7。模型在 DeepSWE 1.1 上也较 Qwen3.7 Max 显著提升(21.6 -> 56.6),说明其在软件工程 agent 任务上确实取得了实质进步。
社区反馈也呈现出这种分化。同一篇抱怨模型过度思考的 Reddit 讨论中,也有人这样评价:
“The output was god tier though.” - u/TangerineLogical9779, r/Qwen_AI
据反馈,模型速度并不稳定,会随负载和时段在 8 tokens/sec 到 60 tokens/sec 之间波动。若想了解它与 Kimi K3 的正面对比,可阅读我们的 Qwen3.8 Max vs Kimi K3 comparison。
常见问题
Qwen3.8-Max 的权重可以下载了吗?
可以。阿里巴巴已于 2026 年 8 月 12 日在 ModelScope 发布 Qwen3.8-2.4T-A95B checkpoint。这是首个开放权重的 Qwen-Max 级模型。云端的 Qwen3.8-Max 则在此基础模型之上提供了额外的生产能力。
开放权重采用什么许可证?
截至本文撰写时,确切许可证尚未确认。从历史先例看,Apache 2.0 的可能性较高——Qwen3.6 使用该许可证发布——但 Qwen3.7 Max 仍保持闭源。在基于它开发任何商业产品前,请先阅读 ModelScope 仓库中的实际许可证文件。
Qwen3.8-2.4T-A95B 和 Qwen3.8-Max 有什么区别?
Qwen3.8-2.4T-A95B 是开放权重基础模型:2.4T 参数、95B 激活参数、MoE 架构、原生 256K 上下文。Qwen3.8-Max 是阿里巴巴基于该模型构建的云端版本,加入了面向生产环境的后训练能力,包括统一奖励系统和在线数据平衡。开放权重提供基础模型,API 则提供增强版本。
我能在本地运行 Qwen3.8-Max 吗?
实际并不可行。模型在 4-bit 量化下约需 1.2 TB 显存,仅权重就要 9 张或更多 H200 GPU,而且没有给上下文缓存留出空间。即使采用 1.5-bit 量化,需求仍是数百 GB。Qwen3.8-27B variant 才是现实的本地替代方案,它可以装入一张消费级 GPU。
Qwen3.8 Max API 的价格是多少?
Model Studio API 的价格为每百万输入 token $2、每百万输出 token $6。订阅套餐从 $6/月的 Lite 起,最高为 $68/月的 Pro。Qoder 在低峰时段提供最高 98% 的促销 credits 折扣,但这属于上线定价,未来可能调整。