 AIREITER
Qwen3.8-Max 已正式可用,输入价格为每百万 Token $2,输出为 $6。单看输出单价,它比 Claude Opus 4.8、Claude Fable 5 和 GPT-5.6 Sol 至少低四倍。不过,模型默认将 reasoning_effort 设为 xhigh,因此从第一笔请求开始,实际账单就可能明显高于表面价格。
Qwen3.8-Max 的 Token 单价
Qwen3.8-Max 是阿里巴巴的新旗舰模型,接替 Qwen3.7-Max。它采用 2.4 万亿参数的混合专家架构,每个 Token 激活 950 亿参数。以下价格来自阿里巴巴模型页面,该页面标注的更新时间为“Updated: Aug 2, 2026”:
| 项目 | 每百万 Token 价格 |
|---|---|
| 输入 | $2.00 |
| 输出 | $6.00 |
| 输入(隐式缓存) | $0.25 |
| 显式缓存写入 | $2.50 |
| 显式缓存读取 | $0.17 |
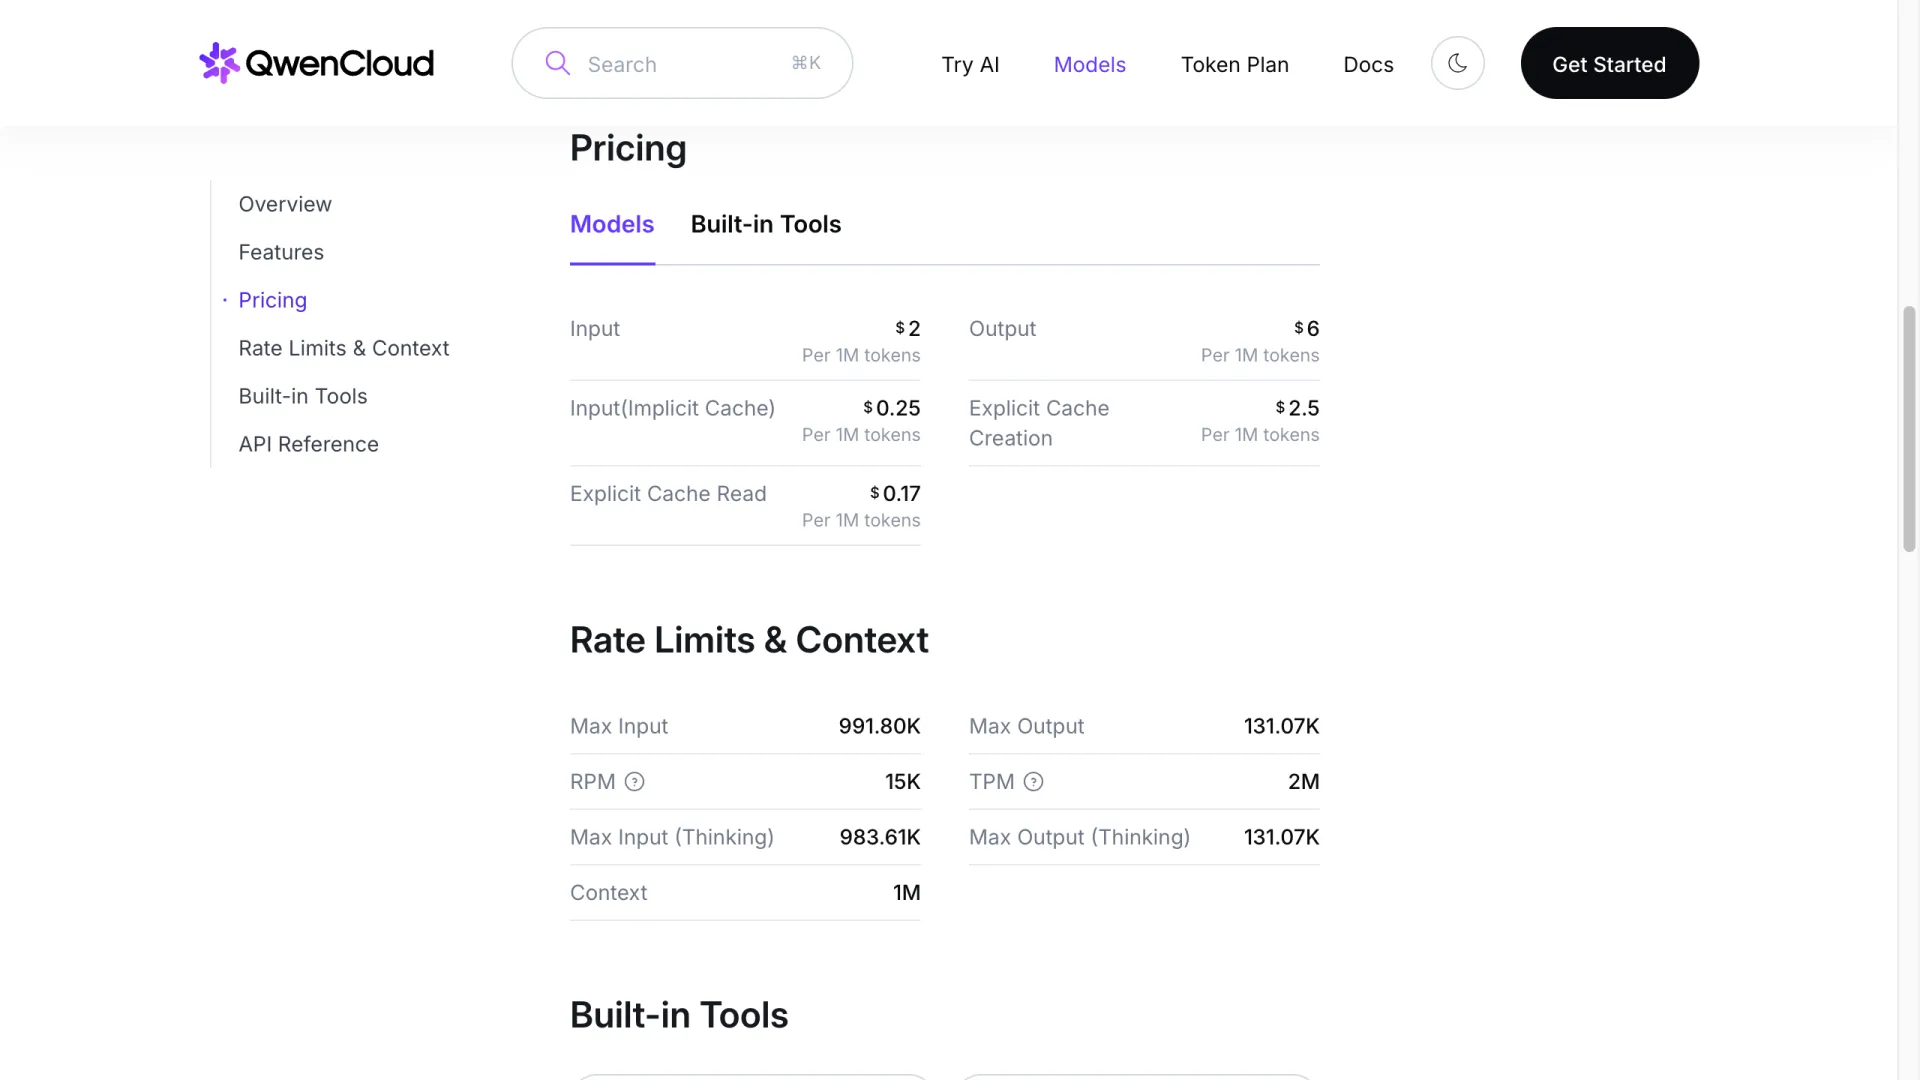
隐式缓存无需额外编程处理。重复前缀会自动按 $0.25 计费,仅为标准输入价格的八分之一。显式缓存则需要主动取舍:写入每百万 Token $2.50,读取 $0.17。相同前缀从第二次读取起,相比未缓存输入已经更划算;但要到约第 30 次读取后,才会优于 $0.25 的隐式缓存价格。对多数应用而言,没必要专门启用显式缓存。
还有一点需要分清:API 已开放,模型权重尚未开放。阿里巴巴的发布文章称,Qwen3.8-Max 权重将于下周登陆 Hugging Face 和 ModelScope。这是经历数周没有日期的“coming soon”表述后,首次给出明确的时间承诺。截至 8 月 3 日,模型页面侧栏仍显示 Open Source: No。
为什么 $6 的输出价并不等于实际成本
阿里巴巴的发布文档提供了三档 reasoning_effort,其中默认值是最高档的 xhigh。其下还有 medium,定位为“平衡准确性和速度”,以及针对速度与成本优化的 low。此外,所有场景默认开启 preserve_thinking。思考 Token 以输出 Token 计费,意味着这两项默认设置会在你还没写完第一个提示词前,就把开支导向 $6 的输出费率。
换言之,影响实际成本的两项关键开关,默认都不利于节省预算;而它们都只需修改一个请求参数。将推理强度调为 medium 或 low,意味着你不必为每个任务都按每百万 $6 的价格购买深度推理,只在任务确实需要时才使用它。
一位早期测试者在r/LocalLLaMA 的帖子标题中,对这种深度思考的实际收益给出了很直接的评价:
Qwen 3.8 max first impressions - model is moderate and it is awful on thinking
这不应被视作基准测试结果,但足以提醒你:在将默认设置标准化之前,应先针对自己的工作负载测试各个推理档位。
1M 上下文不加价,价值在哪
Qwen3.8-Max 的模型页面只列出一档输入价和一档输出价,没有任何按上下文长度分层的价格。Gemini 3.1 Pro 与 GPT-5.6 Sol 则都会在上下文超过某个阈值后切换到更高费率:
| 模型 | 输入(短上下文) | 输出(短上下文) | 输入(长上下文) | 输出(长上下文) |
|---|---|---|---|---|
| Qwen3.8-Max | $2.00 | $6.00 | $2.00(至 1M) | $6.00(至 1M) |
| Gemini 3.1 Pro | $2.00(≤200K) | $12.00 | $4.00(>200K) | $18.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $10.00 | $45.00 |
Gemini 3.1 Pro 在 200K Token 以内的输入价格与 Qwen3.8-Max 完全相同,超过后即翻倍。GPT-5.6 Sol 进入长上下文档位后,输入价格翻倍、输出价格再增加 50%;而这还是在其调整过的价格表基础上。
这意味着上下文越长,价格差距越大,而不是维持不变。一个 400K Token 的提示词,Qwen3.8-Max 的输入成本为 $0.80,Gemini 3.1 Pro 为 $1.60,GPT-5.6 Sol 为 $4.00。文档处理流水线、长时间运行的 Agent 会话和整库代码处理会持续放大这一差异;短聊天轮次中则几乎感觉不到。
与阿里巴巴对标模型相比,成本如何
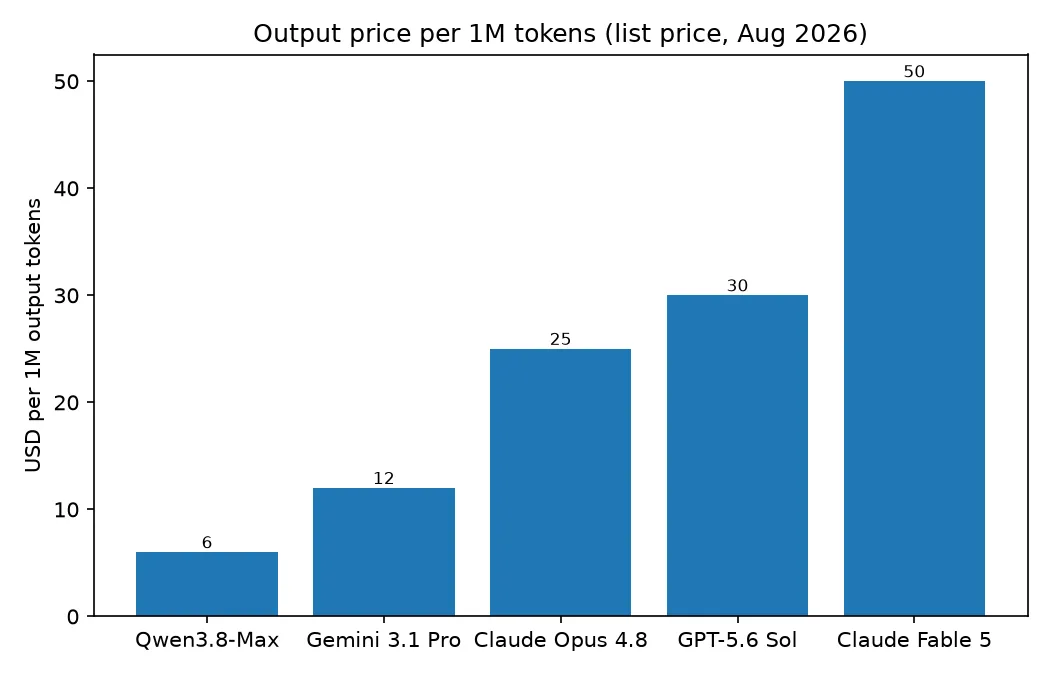
横向比较,Qwen3.8-Max 的 $6 输出价格不到 Claude Opus 4.8 的 $25 四分之一,仅为 GPT-5.6 Sol $30 的五分之一。Claude Fable 5 的输出价格为 $50,超过它的八倍。是否值得为了这一价格差异接受能力取舍,取决于具体任务;阿里巴巴在一份包含 28 行的基准测试表中给出了肯定答案:
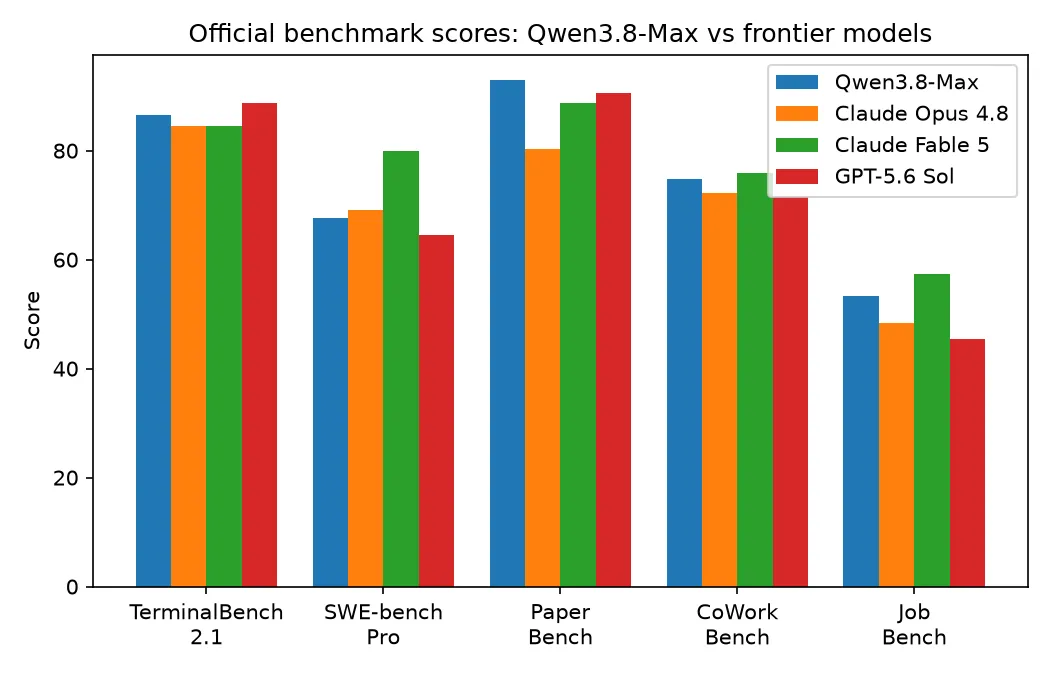
Qwen3.8-Max 在 PaperBench 上领先,得分 93.0,而 GPT-5.6 Sol 为 90.5、Fable 5 为 88.8;在 JobBench 上得分 53.4,高于 Opus 4.8 的 48.4;在 Terminal Bench 2.1 的 86.6 分也略高于两款 Claude 模型。但它在 SWE-bench Pro 上明显落后:Fable 5 的 80.0 比它的 67.7 高出超过 12 分。这些数据均由厂商自行测试,并发布在同一页面上。
选择逻辑因此很清楚。对于输出占比高的 Agent 工作负载,例如长工具调用循环、文档生成,以及 PaperBench 所衡量的研究复现类任务,4 至 8 倍的输出价格折扣足以改变产品本身的单位经济模型。对于 SWE-bench Pro 所代表的仓库级软件工程任务,这个折扣对应的是实际能力下降,支付 Fable 5 的价格仍然有意义。
在自己的业务负载上验证这一点,成本并不高。阿里巴巴的发布文章说明,它支持兼容 OpenAI 的 chat-completions、responses 调用,以及兼容 Anthropic 的接口;这也是 Claude Opus 4.8 和 GPT-5.6 Sol 所接受的两种请求形态。
现在该改哪些代码配置
模型 ID 为 qwen3.8-max。截至 8 月 3 日,它是阿里巴巴模型目录中唯一的 3.8 条目,预览版标识符 qwen3.8-max-preview 已被移除。因此,如果你通过中转服务商调用,不要想当然地认为 GA 后还能保留预览版折扣。
两种接口均通过北京、新加坡和美国弗吉尼亚三个区域的基础 URL 提供服务。最容易先碰到的限制如下:
| 限制项 | 数值 |
|---|---|
| 上下文窗口 | 1M |
| 最大输入 | 991.80K |
| 最大输入(开启思考) | 983.61K |
| 最大输出 | 131.07K |
| 每分钟请求数 | 15K |
| 每分钟 Token 数 | 2M |
注意两个输入上限之间约 8K Token 的差距:开启思考不仅会增加输出 Token,也会压缩可用输入空间。若下周模型权重如期发布,950 亿活跃参数这一数字将成为比较自托管成本与 $2/$6 API 价格的起点。
常见问题
Qwen API 免费吗?
不免费。Qwen3.8-Max 按 Token 计费,输入每百万 Token $2,输出每百万 Token $6。阿里巴巴 API 平台销售的 Token Plan 订阅,是与按 Token API 计费分开的积分制产品。
Qwen Max 要多少钱?
当前这一代的价格为:输入每百万 Token $2,输出每百万 Token $6,隐式前缀缓存为 $0.25。阿里云文档中的旧 qwen-max 条目指的是早期代际,采用不同费率。
Qwen3.8-Max 的 1M 上下文窗口会额外收费吗?
不会。无论输入和输出为 5K Token 还是 900K Token,价格都相同;这是它与 GPT-5.6 Sol、Gemini 3.1 Pro 最明显的定价结构差异。
Qwen3.8-Max 比 Qwen3.7-Max 更便宜吗?
官方页面无法回答这个问题。Qwen3.7-Max 模型页面在标有 50% 折扣的位置将每 Token 价格显示为 --,而没有给出具体费率,因此不存在可供比较的公开数字。
相关阅读
- Claude Fable 5 定价:本文对比的 $10/$50 档位
- 降低 Claude Fable 5 Token 成本:另一家厂商中同样适用的推理强度与缓存优化手段