 AIREITER
下载文件只有 17GB,并不代表它就能轻松胜任本地 Agent。Qwen3.8-27B 是一款采用 Apache-2.0 许可、能力不俗的开放权重模型,但默认的超高强度推理可能让原本几秒钟的任务变成漫长等待。量化方案、上下文预算和推理服务栈,必须与机器配置匹配。
Qwen3.8-27B 值得本地运行吗?
如果你有大约 24GB 的 GPU 显存或统一内存,重视数据留在本地,并能接受交互速度慢于高速托管 API,那么 Qwen3.8-27B 值得考虑。本地部署它的核心理由并非某一项跑分,而是它在可部署的体量内,提供了 Apache-2.0 许可的稠密模型架构、图像和视频输入、262,144 token 原生上下文,以及可调节的推理能力。Qwen 官方模型卡标注的发布时间为 2026 年 8 月 14 日。
不过,它并非所有 API 模型的自动替代品。官方成绩由厂商自行报告,激进量化会同时改变质量和速度,而默认的 xhigh 推理强度,也并不适合作为多数本地交互任务的起点。
先算硬件账,再看跑分
Qwen3.8-27B 是稠密模型,每生成一个 token 都会激活完整模型。因此,内存带宽、KV Cache、量化方式和设定的上下文长度至关重要,单看权重文件大小很容易产生误判。Qwen 的模型卡写明其原生上下文为 262K,但实际本地会话完全可以设得低得多,以换取可用的内存空间和速度。Qwen 的服务示例展示了 262,144 token 的上限;这是能力上限,并不意味着每台消费级设备都该将其设为默认值。
| 可用内存 | 实用起步方案 | 实际体验预期 | 建议 |
|---|---|---|---|
| 12GB | 激进的 Q3 级量化,加 CPU/RAM 卸载 | 上下文很短,延迟代价明显 | 除非目标是本地实验,否则建议换更小的模型 |
| 16GB | 激进 Q3,或谨慎选择 Q4 风格量化 | 可处理短任务并有人监督的工作流,但上下文和速度受限 | 投入 Agent 工作流前先测试 |
| 24GB | Q4 级量化 | 运行编码、工具调用和中等上下文的实用入门档 | 最适合大多数本地 Qwen3.8-27B 用户 |
| 32GB+ | 更高质量的量化,或更充裕的上下文空间 | KV Cache 和长会话方面需要妥协得更少 | 持续运行 Agent 工作时优先选择这一档 |
以上是运行建议,不是厂商给出的最低配置。独立用户报告称,12GB RTX 3060 可以运行本地版本并处理工具调用;也有人警告,这个显存档位运行稠密 Agent 的表现很差。分歧本身说明,“能加载”和“好用”绝不能混为一谈。可参考 r/LLM 中的真实用户讨论。
24GB 显卡只是舒适运行 4-bit 工作流的起点,不代表长上下文也会从容。一份面向部署的评估估计,4-bit 的总内存占用约为 17-19GB,但也指出,在长时间 Agent 会话中,KV Cache 会迅速膨胀。Neoteric 的本地部署分析可作为规划参考,而非官方硬件规格。
为什么默认设置会让 Qwen3.8-27B 显得难以使用
Qwen3.8-27B 默认开启思考。官方模型卡提供 xhigh、medium 和 low 等 reasoning_effort 选项,也可通过 enable_thinking=False 发起非思考请求;同时,preserve_thinking 默认也是开启的。Qwen 的最佳实践说明提醒,降低推理强度不一定能缩短完整任务耗时;但对简单任务而言,高强度推理依然是代价高昂的默认选择。
Simon Willison 的本地测试很直观地展现了这种差异。他在 LM Studio 中运行 Q4_K_M 版本时,第一个 SVG 任务在默认设置下消耗了 22,276 个推理 token,用时 21 分钟;关闭推理后,模型给出了不同的结果,耗时为 137 秒。这套测试环境不能视为通用基准,但它清楚展示了配置选择带来的风险。查看完整测试与对话记录。
“我原本以为,它大概会和 3.6 35b 处于相同水平,只是因为重度量化而更慢;结果它在各方面都明显胜过了它。” u/AltruisticList6000,r/LocalLLaMA,报告了其在 16GB RTX 4060 Ti 上进行 Q3 实验的结果。
但这项积极结果并没有消除取舍。另一份真实用户报告提到,32K 上下文受限,且 Agent 会话会逐渐变得不可靠;还有用户建议,在本地编程工作中使用清晰、原子化的指令。相关工作流讨论在这里。
Qwen3.8-27B 官方提供了什么
Qwen3.8-27B 是稠密的原生视觉语言模型,并非 MoE 模型。官方模型卡说明它支持文本、图像和视频输入,拥有 64 层、5,120 隐藏维度、262,144 个原生上下文 token,并采用 Apache-2.0 许可。文档还介绍了基于 YaRN 的扩展方式,可将上下文延伸至 1M token,同时明确警告静态 YaRN 可能损害短文本性能。官方规格与上下文说明应优先于第三方发布汇总。
官方仓库列出了 Transformers、vLLM、SGLang、TokenSpeed,以及 llama.cpp、Ollama 和 LM Studio 等量化本地运行路径。运行器支持情况很重要,因为该模型采用混合式 Gated DeltaNet 与 Gated Attention 布局;在排查模型故障前,应先更新运行器。Qwen 的快速入门仓库提供了兼容 OpenAI 的服务示例。
官方跑分能说明什么,不能说明什么
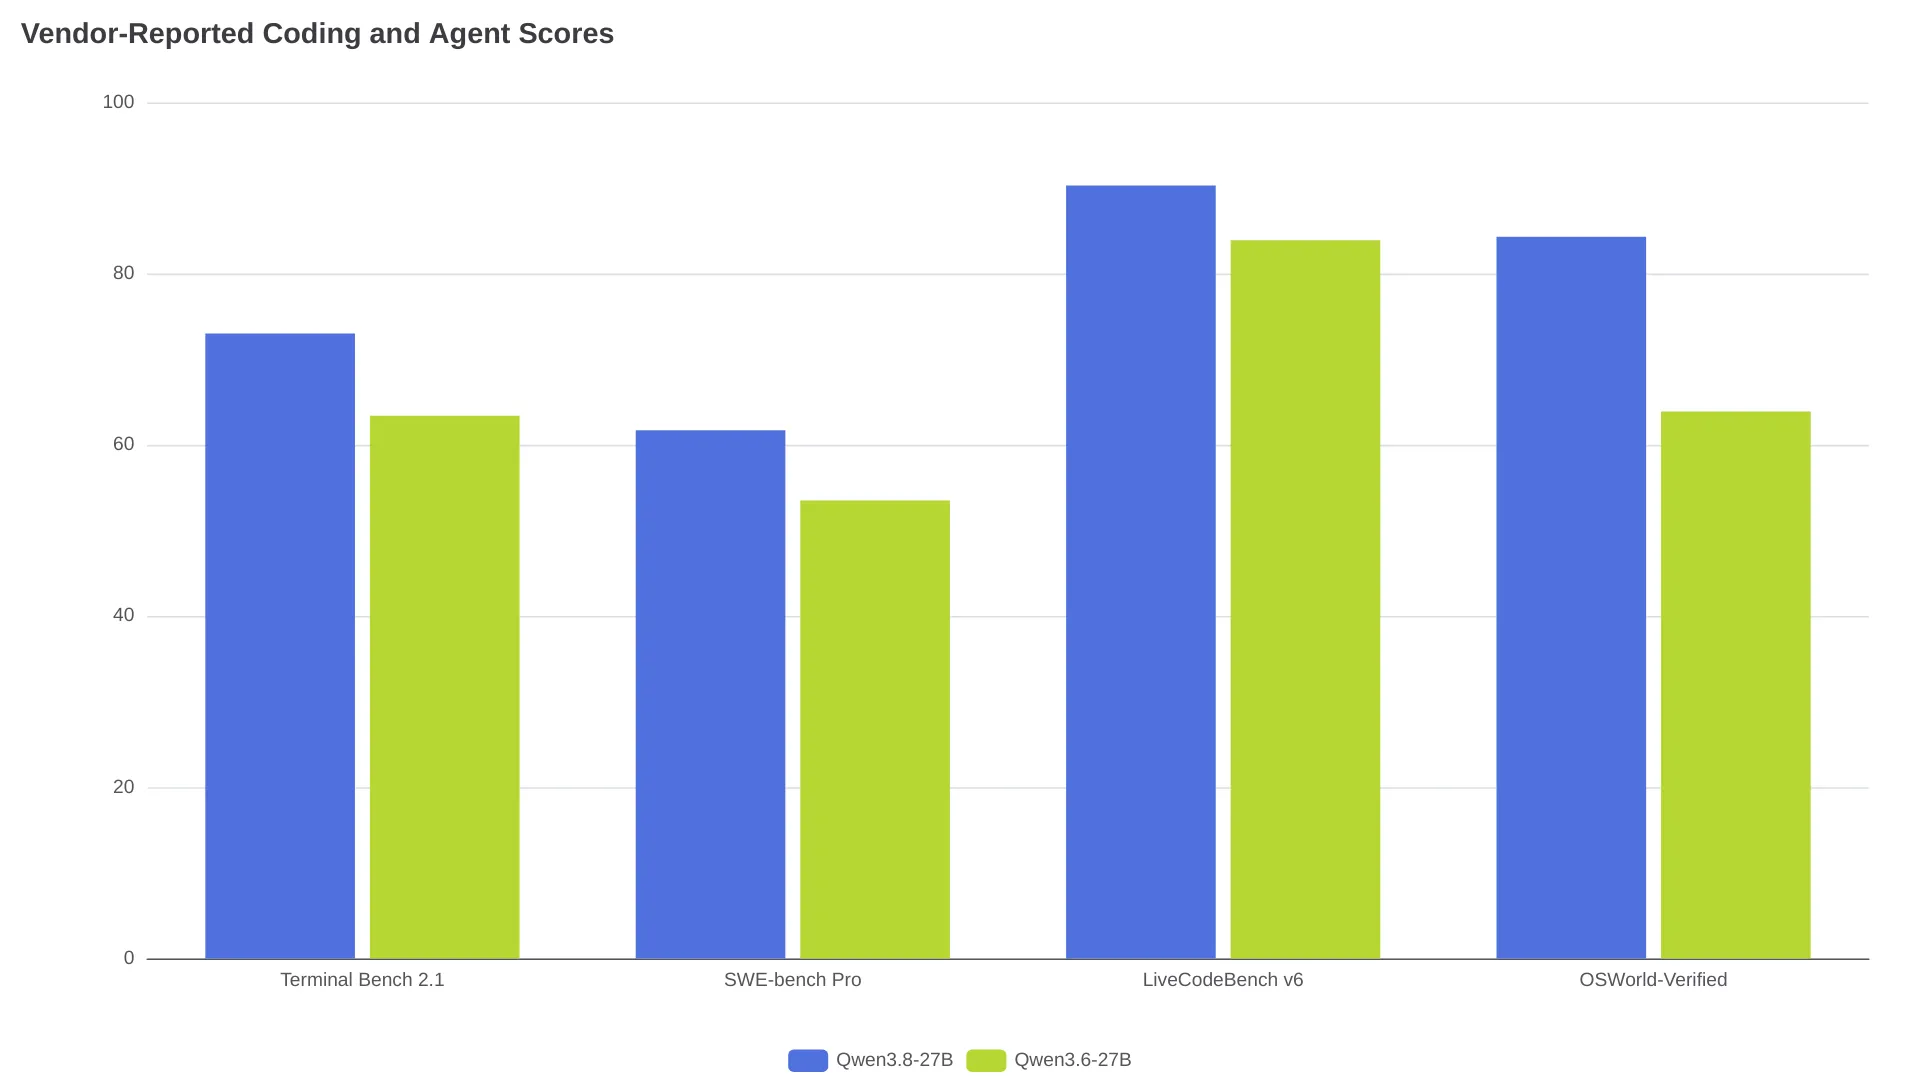
Qwen 报告称,Qwen3.8-27B 在编码和计算机操作评测中较 Qwen3.6-27B 有显著提升。图表列出的是官方模型卡中的四项厂商自报成绩,并非独立复现的成绩。
| 官方基准 | Qwen3.8-27B | Qwen3.6-27B | 参考意义 |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Agent 终端编码能力信号 |
| SWE-bench Pro | 61.7 | 53.5 | 代码仓库 Issue 解决能力信号 |
| LiveCodeBench v6 | 90.3 | 83.9 | 编码评测能力信号 |
| OSWorld-Verified | 84.3 | 63.9 | 计算机操作能力信号 |
模型卡发布了完整对比和测试方法。针对 SWE-bench Pro 与 DeepSWE 1.1,Qwen 表示使用了 Claude Code harness,参数为 temperature=1.0、top_p=0.95 和 256K 上下文;其中还包括 QwenSWEBench 等内部基准。比较模型前请先查看测试方法。这些数字可以支持“它是相较 Qwen3.6-27B 的一次显著官方升级”,但不足以证明“它已被验证可全面取代前沿 API”。
一套合理的本地初始配置
首次本地部署应优先追求可预测的行为,而不是把推理强度拉到最高。选择较新的运行器,在 24GB 级硬件上从 Q4 级量化开始,有意识地限制上下文长度,并先用短 Agent 任务验证,再放开长时间自主循环。
- 用 vLLM 或 SGLang 等受支持的引擎启动兼容 OpenAI 的服务。Qwen 提供了使用
Qwen/Qwen3.8-27B、--reasoning-parser qwen3和--tool-call-parser qwen3_coder的示例。官方命令见仓库。 - 常规分类、信息提取或快速代码修改任务,可设置
enable_thinking=False。Qwen 建议非思考模式使用temperature=0.7、top_p=0.80和presence_penalty=1.5。参见官方 API 示例。 - 对于需要大量推理的调试任务,先尝试
low或medium,再考虑xhigh;然后基于真实任务比较总完成时间和工具调用质量。 - 如果任务彼此独立,关闭思考保留。只有多轮推理上下文的价值足以抵消额外 KV Cache 压力时,才应保留它。
- 无人值守前,测试工具调用、输出格式遵循能力和上下文滚动。单轮提示中能写出好代码的模型,未必能稳定完成长时间 Agent 循环。
哪些情况下不该选 Qwen3.8-27B
如果 12GB 或更低显存是硬限制,响应延迟比本地控制更重要,或者 Agent 必须在严格格式要求下无人值守运行,Qwen3.8-27B 就不是首选。它可以在受限配置中运行,但这不等于能提供可靠的交互吞吐,或为代码仓库工作留出足够上下文。
独立测试还发现,它有输出过长、尾延迟高,以及严格指令遵循不够稳定的倾向。一项结构化评估在其工作站配置上记录到:49 项测试中有 4 次超时,P95 响应时间为 143.32 秒。这些数据不能外推为通用性能保证,但足以提醒我们,不应把本地 27B 模型当作无需审核的自动化组件。CrucibleMark 的测试报告提供了相关配置和局限性。
Qwen3.8-27B 常见问题
Qwen3.8-27B 已正式发布了吗?
是。Qwen 官方仓库列出,Qwen3.8-27B 于 2026 年 8 月 14 日在 Hugging Face Hub 和 ModelScope 发布。Qwen 的发布时间线是第一手来源。
Qwen3.8-27B 能在 16GB GPU 上运行吗?
采用重度量化并限制上下文后可以运行,但这属于受限部署。真实用户报告从 16GB RTX 4060 Ti 上颇有希望的 Q3 成果,到低显存运行稠密 Agent 会面临重大速度和质量取舍的警告都有。LocalLLaMA 讨论。
Qwen3.8-27B 是否拥有 1M token 上下文窗口?
它的原生上下文为 262,144 个 token。模型卡介绍了通过 YaRN/RoPE 缩放实现 1M 上下文的方式,并提醒静态 YaRN 可能降低短文本性能。官方上下文文档。
如何关闭 Qwen3.8-27B 的思考模式?
按照 Qwen 模型卡中的示例,在 API 请求里设置 enable_thinking=False。对于确实需要推理的任务,建议先用 low 或 medium,而非默认认为 xhigh 才合适。官方非思考示例。
Qwen3.6-27B 用户应该升级吗?
如果现有硬件本就能运行同等级部署方案,且工作负载能受益于编码、计算机操作或多模态改进,可以升级。若当前技术栈稳定,而新的运行器、量化方案或推理行为尚未在实际工作流中验证,则继续使用 Qwen3.6-27B。
按最无法妥协的限制来选
| 限制条件 | 下一步建议 |
|---|---|
| 需要本地数据处理,且有 24GB 可用内存 | 以 Q4 运行 Qwen3.8-27B,从低强度或关闭思考开始 |
| 只有 12GB 到 16GB | 为有人监督的短任务测试 Q3 风格版本,或直接选择更小模型 |
| 长时间运行代码仓库 Agent | 预留 32GB+ 空间,并在采用前验证 KV Cache 行为 |
| 追求快速交互响应 | 使用托管 API 或更小的本地模型 |
| 需要严格的无人值守格式或发布 | 保留验证层和人工审核;不要只依赖模型自身的格式遵循能力 |
Qwen3.8-27B 提高了本地可部署 27B 模型的能力上限,但并没有免除系统层面的工作:根据硬件选择量化,主动控制推理强度,并以具有代表性的真实工作流评估模型,而不是只看下载文件的大小。