 AIREITER
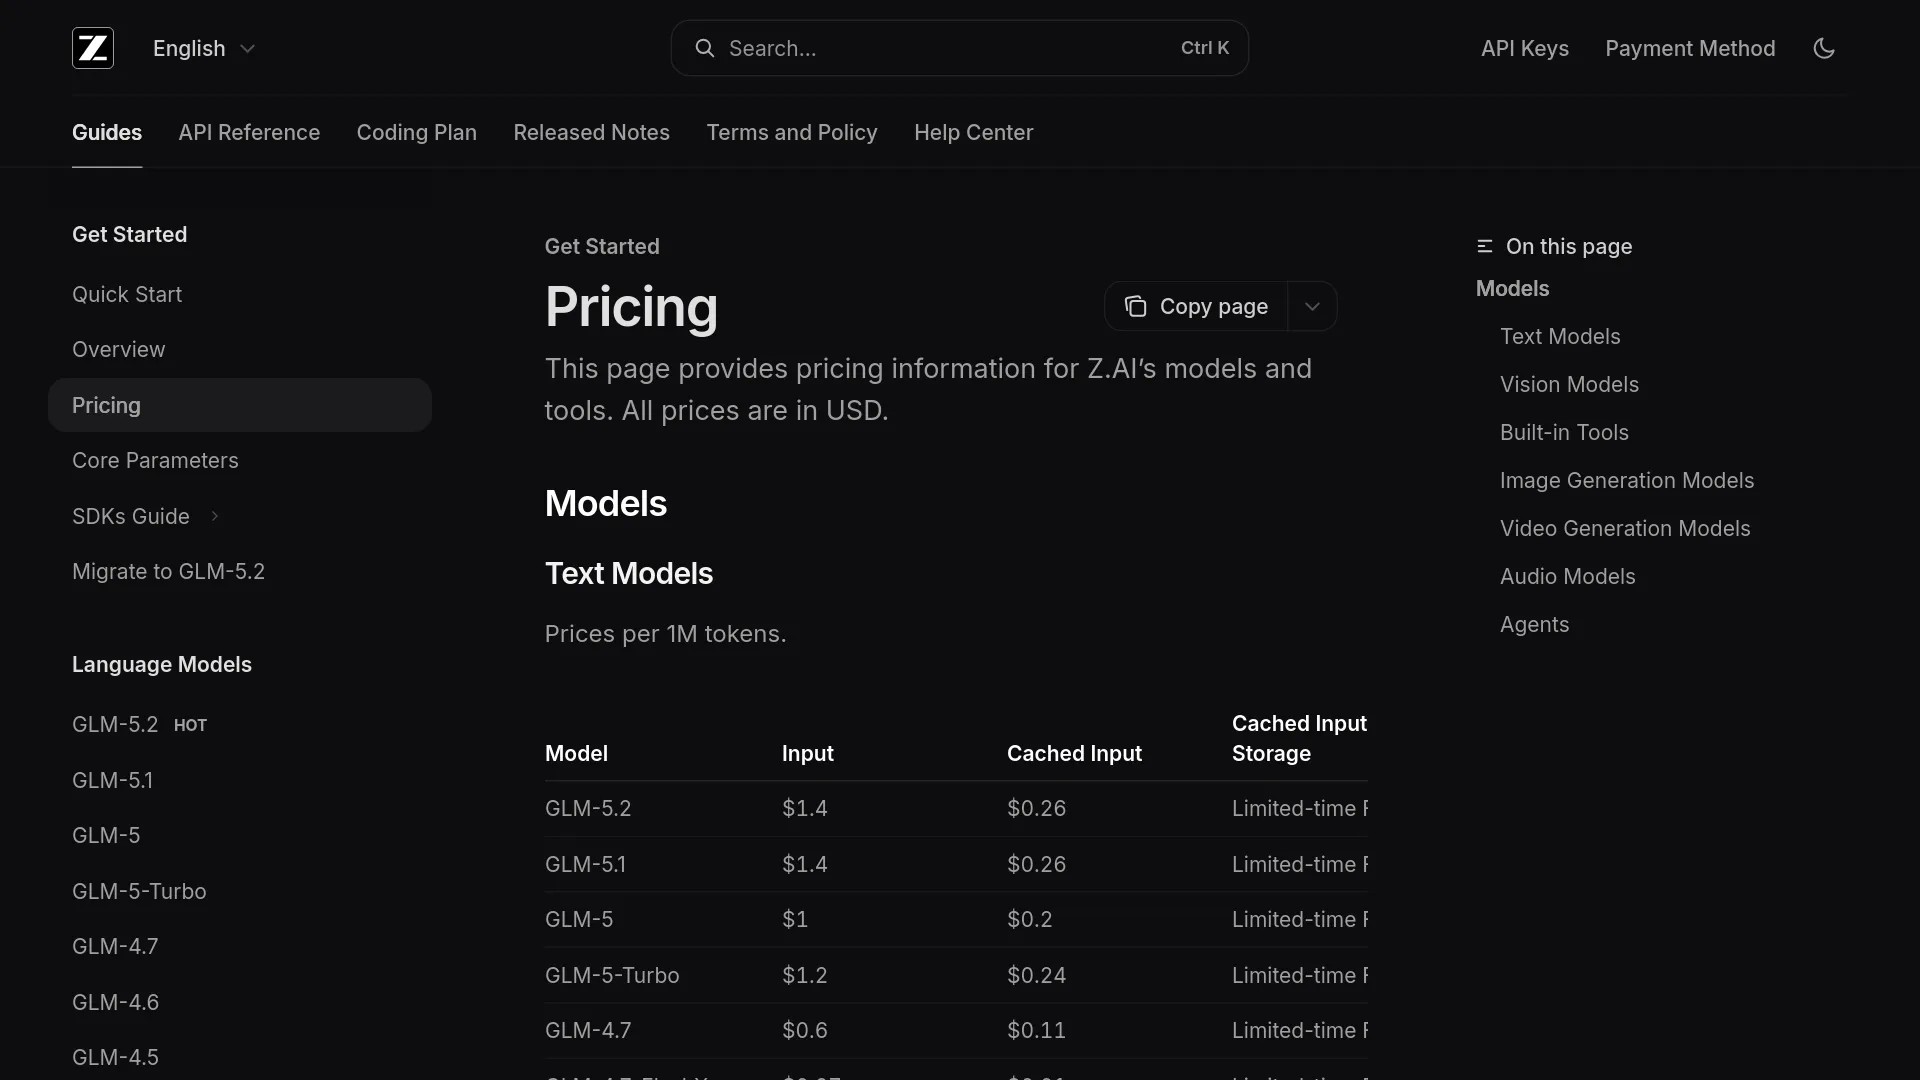
GLM-5.3 的编程能力提升目前仍停留在发布宣称层面。我们于 2026 年 8 月 14 日查阅的公开 Z.ai API 文档与价格表中,列出的仍是 glm-5.2,而非 glm-5.3。Z.ai API 参考文档 Z.ai 定价
结论先说:可以评测 5.3,但别急着替换生产链路
如果你已确认有可用的 GLM-5.3 访问渠道,它值得用于高难度编程 Agent 任务的小范围试点。不过,在确认模型 ID、使用条款,并且它在你自己的验收任务中稳定优于现有方案之前,GLM-5.2 仍应是生产环境的基线。
Z.ai 在同期传播的 GLM-5.3 发布信息中表示,5.3 沿用 GLM-5.2 的基础模型,通过后训练获得能力提升。其宣称在 Z.ai Code Bench 上提升 50%,并在 Terminal-Bench 3.0 和 Agents' Last Exam 上取得领先的开源模型成绩。但相关发布讨论没有提供原始分数、测试配置、价格、上下文长度或许可证信息。GLM-5.3 发布讨论
GLM-5.2 和 GLM-5.3 到底差在哪?
GLM-5.2 是一款已有完整文档和生产级 API 能力的文本模型。Z.ai 标注其支持 1M token 上下文、128K 最大输出、函数调用、结构化输出、缓存、MCP,并在 Hugging Face 提供采用 MIT 许可证的检查点。GLM-5.2 文档 GLM-5.2 模型卡
GLM-5.3 的定位则是面向编程和网络防御的后训练升级。现有发布材料称,它与 GLM-5.2 使用相同基础模型,权重将在完成安全评估和加固后推出;但这并不能证明 GLM-5.2 的上下文长度、输出上限、MIT 条款或公开 API 支持会原样延续到 5.3。GLM-5.3 发布讨论
| 决策维度 | GLM-5.2 | GLM-5.3 |
|---|---|---|
| 基础模型关系 | 已发布开放权重模型卡 | Z.ai 表示其基于 GLM-5.2,能力提升来自后训练 |
| 编程能力证据 | 厂商表格报告其在 SWE-bench Pro 得分 62.1、在 Terminal-Bench 2.1 得分 81.0 | Z.ai 宣称其内部 Code Bench 表现提升 50%;发布材料未给出绝对分数 |
| 长上下文规格 | 已有 1M 上下文和 128K 最大输出的文档说明 | 发布材料未说明 |
| 公开 API 文档 | 聊天补全参考文档中列有 glm-5.2 | 截至 2026 年 8 月 14 日查阅的文档,未列出 glm-5.3 |
| 直连 API 标价 | 每 MTok:输入 $1.40,缓存输入 $0.26,输出 $4.40 | 截至 2026 年 8 月 14 日查阅的公开价格表中未列出 |
| 权重与许可证 | 可下载的 GLM-5.2 权重,采用 MIT 许可证 | 权重被描述为等待安全评估完成;许可证未说明 |
GLM-5.2 的上述信息均有公开文档佐证;而对于 GLM-5.3,发布材料没有提供 API、价格、权重或许可证细节的部分,目前都仍未得到确认。Z.ai API 参考文档 Z.ai 定价 GLM-5.2 模型卡
为什么“编程提升 50%”还不足以触发迁移
这项 Code Bench 提升 50% 的说法没有公开任务集、Agent 测试框架、token 预算和绝对分数,因此无法据此预测它在某个具体代码仓库验收测试上的表现。GLM-5.3 发布讨论
“测试框架的重要性依然高于模型本身。” 来源:Semgrep Security Research
Semgrep 对 GLM-5.2 的 IDOR 实验正说明了这一点:在一份数据集和一次运行中,仅使用提示词的 GLM-5.2 配置取得了 39% F1;而其专门构建的多模态测试框架配合 GPT-5.5 则达到 61%。作者也提醒,不应将这一排序泛化到测试任务之外。因此,试点 GLM-5.3 时应保持现有脚手架不变。Semgrep 方法与结果
GLM-5.2 报告的 FrontierSWE、DeepSWE 和 Terminal-Bench 成绩可以帮助你挑选测试案例,但其模型卡同样记录了模型专属测试框架、token 预算和评测设置。GLM-5.2 模型卡
眼下真正的限制,是可用性
在本次对比中,GLM-5.2 是唯一拥有明确公开 API 合约的版本。Z.ai 的聊天补全参考文档在请求示例中使用 glm-5.2,将其列入可用文本模型值,并注明 reasoning_effort 仅由 GLM-5.2 支持。Z.ai 聊天补全参考文档
社区中的访问反馈,并不能等同于获得受支持的公开 API 集成能力。GLM 5.3 社区讨论
GLM-5.2 用户升级前,先过这三道关
即便两者共享基础模型,测试新版本时也应将其视为一次 Agent 系统层面的变更。首次对比期间,不要调整提示词、工具、权限或重试策略。
- 固定三类代表性任务。准备一个带测试判定条件的受限 Bug 修复任务、一个带禁止修改检查的跨文件重构任务,以及一个长上下文代码审查或迁移任务。锁定仓库提交版本、任务描述、工具和验收标准。
- 发流量前先核实 5.3 接入链路。根据该提供商当前文档记录服务商、准确模型 ID、上下文与输出限制、token 价格、速率限制、数据处理条款和失败行为。不要根据 GLM-5.2 的信息,或一张编程套餐截图去推断这些字段。Z.ai API 参考文档 Z.ai 定价
- 看验收结果,不看单一分数。用同一套脚手架运行两个版本,记录验收通过率、测试失败数、违规修改、端到端耗时、输入/缓存/输出 token、重试次数和人工修复时间。只有当 GLM-5.3 在不带来不可接受的成本或可靠性退化的前提下,提升了已验收结果,才将相应任务类别切换过去。Semgrep 方法
按部署状态做选择
| 你的情况 | 现在该选什么 | 下一步 |
|---|---|---|
| 生产应用使用 Z.ai 有文档支持的公开 API | GLM-5.2 | 保持现有模型字符串和基线指标 |
| 已确认可访问 GLM-5.3,且用于高难度代码 Agent 任务 | 受控试点 GLM-5.3 | 用同一测试框架执行三任务门槛测试 |
| 本地或私有化部署 | GLM-5.2 | 等待 GLM-5.3 权重、许可证和部署指引发布 |
| 需要理解截图、PDF 或图像 | 两者的结果都无法解决这一需求 | 评估已有文档支持的视觉模型;GLM-5.2 是纯文本到文本模型 |
只有在访问方式已有文档确认,且实际验收结果明确优于 GLM-5.2 基线时,才应试点 5.3 并考虑替换。GLM-5.3 发布讨论 GLM-5.2 文档
常见问题
GLM-5.3 是新的基础模型吗?
Z.ai 的发布说法是,GLM-5.3 与 GLM-5.2 使用相同基础模型,能力提升来自后训练。引用的发布材料没有提供新的架构或参数规格。GLM-5.3 发布讨论
GLM-5.3 能通过公开 Z.ai API 使用吗?
截至 2026 年 8 月 14 日查阅的 Z.ai 公开参考文档中,没有列出 glm-5.3;接入 5.3 链路前,应确认所选提供商的最新文档。Z.ai 聊天补全参考文档
GLM-5.3 是否保留了 GLM-5.2 的 1M 上下文和 MIT 许可证?
引用的 GLM-5.3 发布材料尚未确认这一点。GLM-5.2 的 1M 上下文和 MIT 许可证已在官方模型卡中注明;共享基础模型并不能证明两者具有相同的发布条款。GLM-5.2 模型卡 GLM-5.3 发布讨论