 AIREITER
只要提示词不超过 100,000 token,Haiku 5.5 的价格就是 Sonnet 5.5 的二十分之一。但跨过这条线后,价差会缩小至 4 倍,而 Agent 循环往往比团队预想得更快触及这个门槛。短小、可重复的 API 任务交给 Haiku 5.5 已经足够;调试和多步骤编程这类任务,Sonnet 5.5 依然值得它的溢价。
100K token 前差 20 倍,越线后价格逻辑就变了
Claude Haiku 5.5 和 Claude Sonnet 5.5 的纸面能力规格相同,账单却完全不同。两者都提供 1M token 上下文窗口和 128K token 最大输出,模型 ID 分别为 claude-haiku-5-5 与 claude-sonnet-5-5。根据 Anthropic 的 Haiku 5.5 公告和 Anthropic 的 Sonnet 5.5 公告,Sonnet 5.5 于 2026 年 9 月 28 日发布,Haiku 5.5 于 2026 年 10 月 7 日发布。Claude 平台的 Sonnet 5.5 文档也列出了同样的 1M 上下文和 128K 输出上限。
| 规格 | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| 模型 ID | claude-haiku-5-5 | claude-sonnet-5-5 |
| 发布日期 | 2026 年 10 月 7 日 | 2026 年 9 月 28 日 |
| 上下文 / 最大输出 | 1M / 128K | 1M / 128K |
| 100K 以下输入 / 输出 | 每 1M 为 $0.10 / $0.50 | 每 1M 为 $2 / $10 |
| 提示词超过 100K 时的输入 / 输出 | 每 1M 为 $0.50 / $2.50 | 每 1M 为 $2 / $10(无分档) |
| 缓存读取 | 每 1M 为 $0.01 | 每 1M 为 $0.10 |
| 默认努力等级 | medium | high |
以上均为 Anthropic 标价。根据 APIKO 对 Anthropic 定价的汇总,当提示词 token 超过 100,000 后,Haiku 5.5 会对整次请求适用更高价档,缓存读写也包括在内。
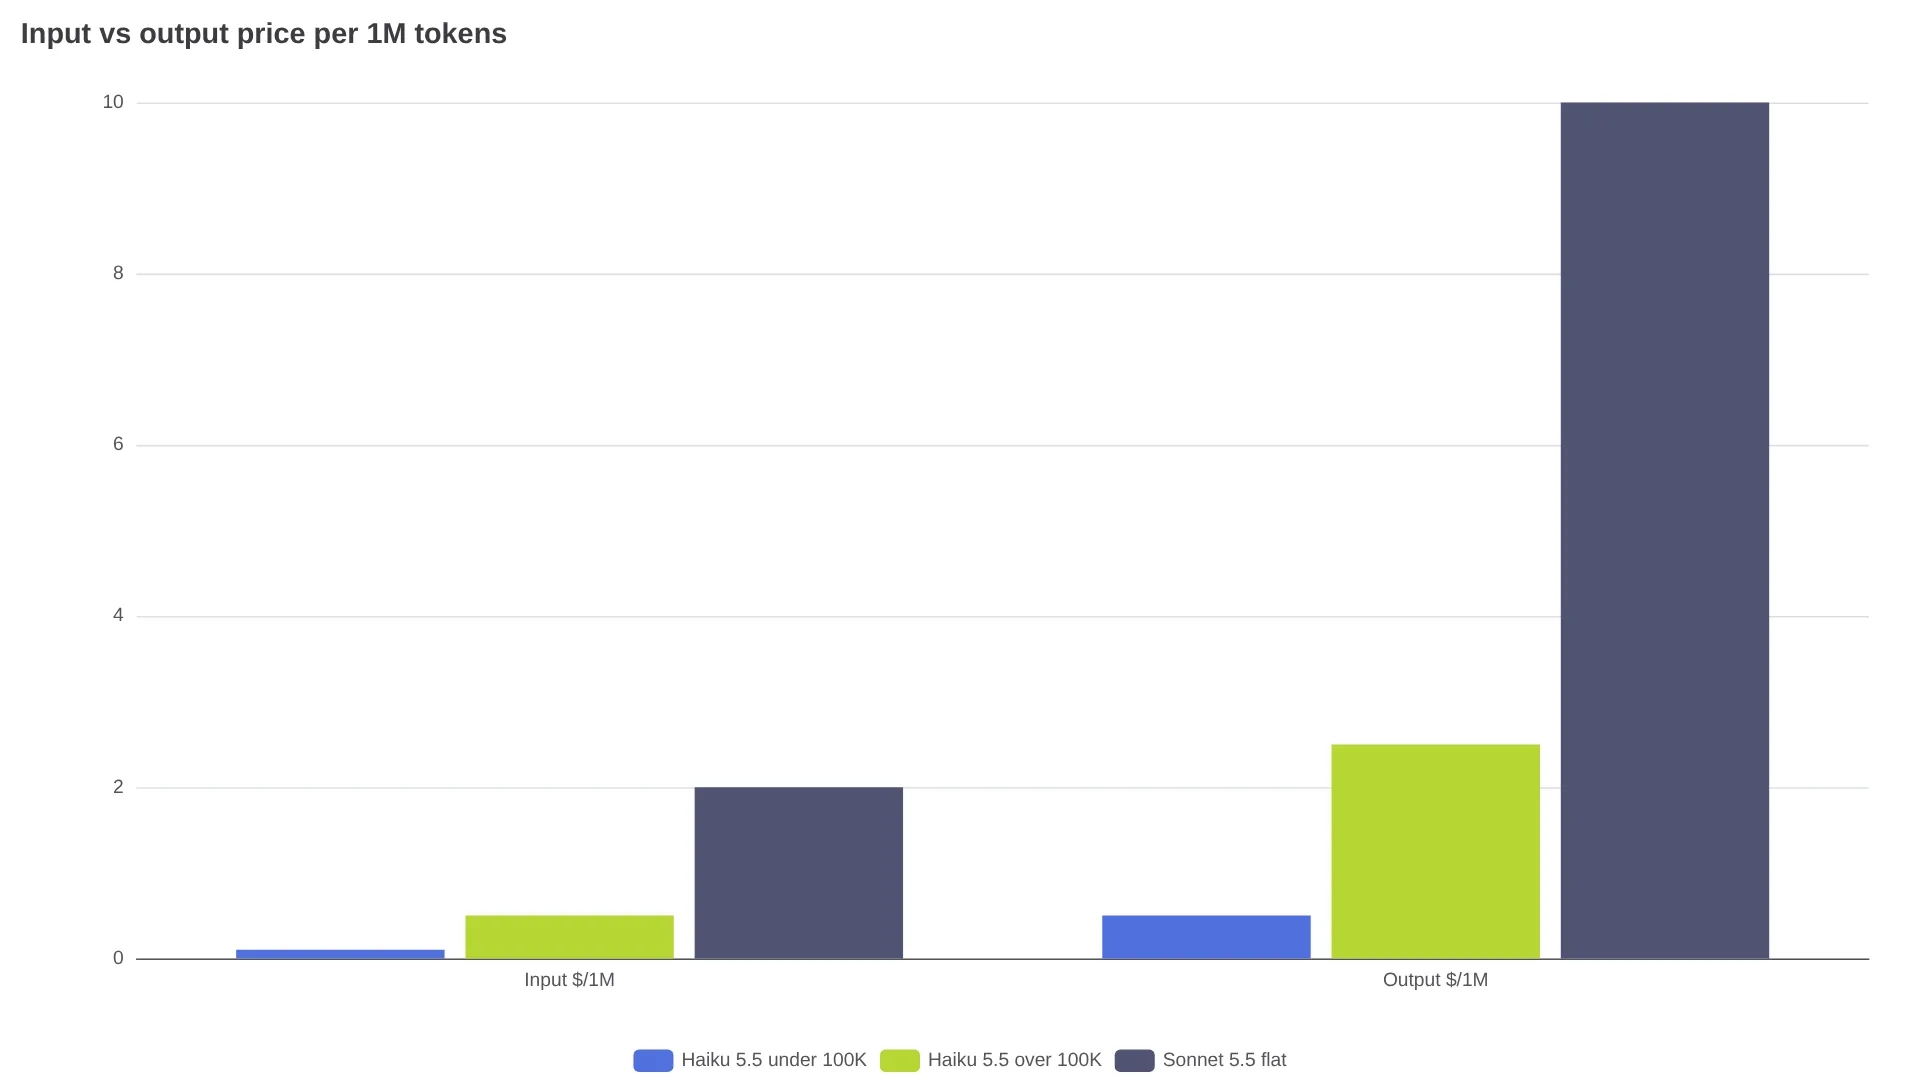
以 1,000 份完全相同的文档为例:每份 99K token 输入、1K token 输出,按标价计算,这一批约需 $10.40(APIKO 按其费率计算为 $4.54);若每份文档变为 101K token,则按标价约为 $53.00。每份仅多出 2,000 token,总成本却增至 5 倍。相比之下,同样的 101K 批次交给 Sonnet 5.5 约需 $212.00。这些计算基于 APIKO 的 Haiku 5.5 与 Sonnet 5.5 测试所列标价。根据 Sim 对 Sonnet 5.5 与 Haiku 5.5 的价格比较,若模拟 1,000 次调用、每次 10K 输入加 1K 输出,Sonnet 5.5 总价为 $30.00,Haiku 5.5 则为 $1.50,降低 95%。
真实的 Agent 循环很容易在无意间越过这条线。在一个讨论 Haiku 5.5 token 用量的 r/ClaudeAI 帖子中,有用户发现运行到约第 20 次模型调用时就跨过了 100K;之后的 164 次调用中,有 145 次按高价档计费,原因是对话历史和工具输出不断累积。该帖建议的做法包括:把工单拆小、限定文件范围、减少测试输出,并使用全新的子 Agent,而不是维持一条不断膨胀的长对话。短任务用 Haiku 依然很便宜;长上下文流水线则要把 Sonnet 的成本纳入预算。
“Haiku 5.5 的低价只在上下文低于 100K 时成立。输入超过 100K 后,价格会涨 5 倍;翻译和摘要等小任务能省钱,长上下文任务应该使用 Sonnet。”—— @zookmas1314
如需深入了解各模型,可继续阅读 Claude Haiku 5.5 API 定价与 Claude Sonnet 5.5 API 评测与定价。
基准测试拉开的差距,主要在 Agent 编程
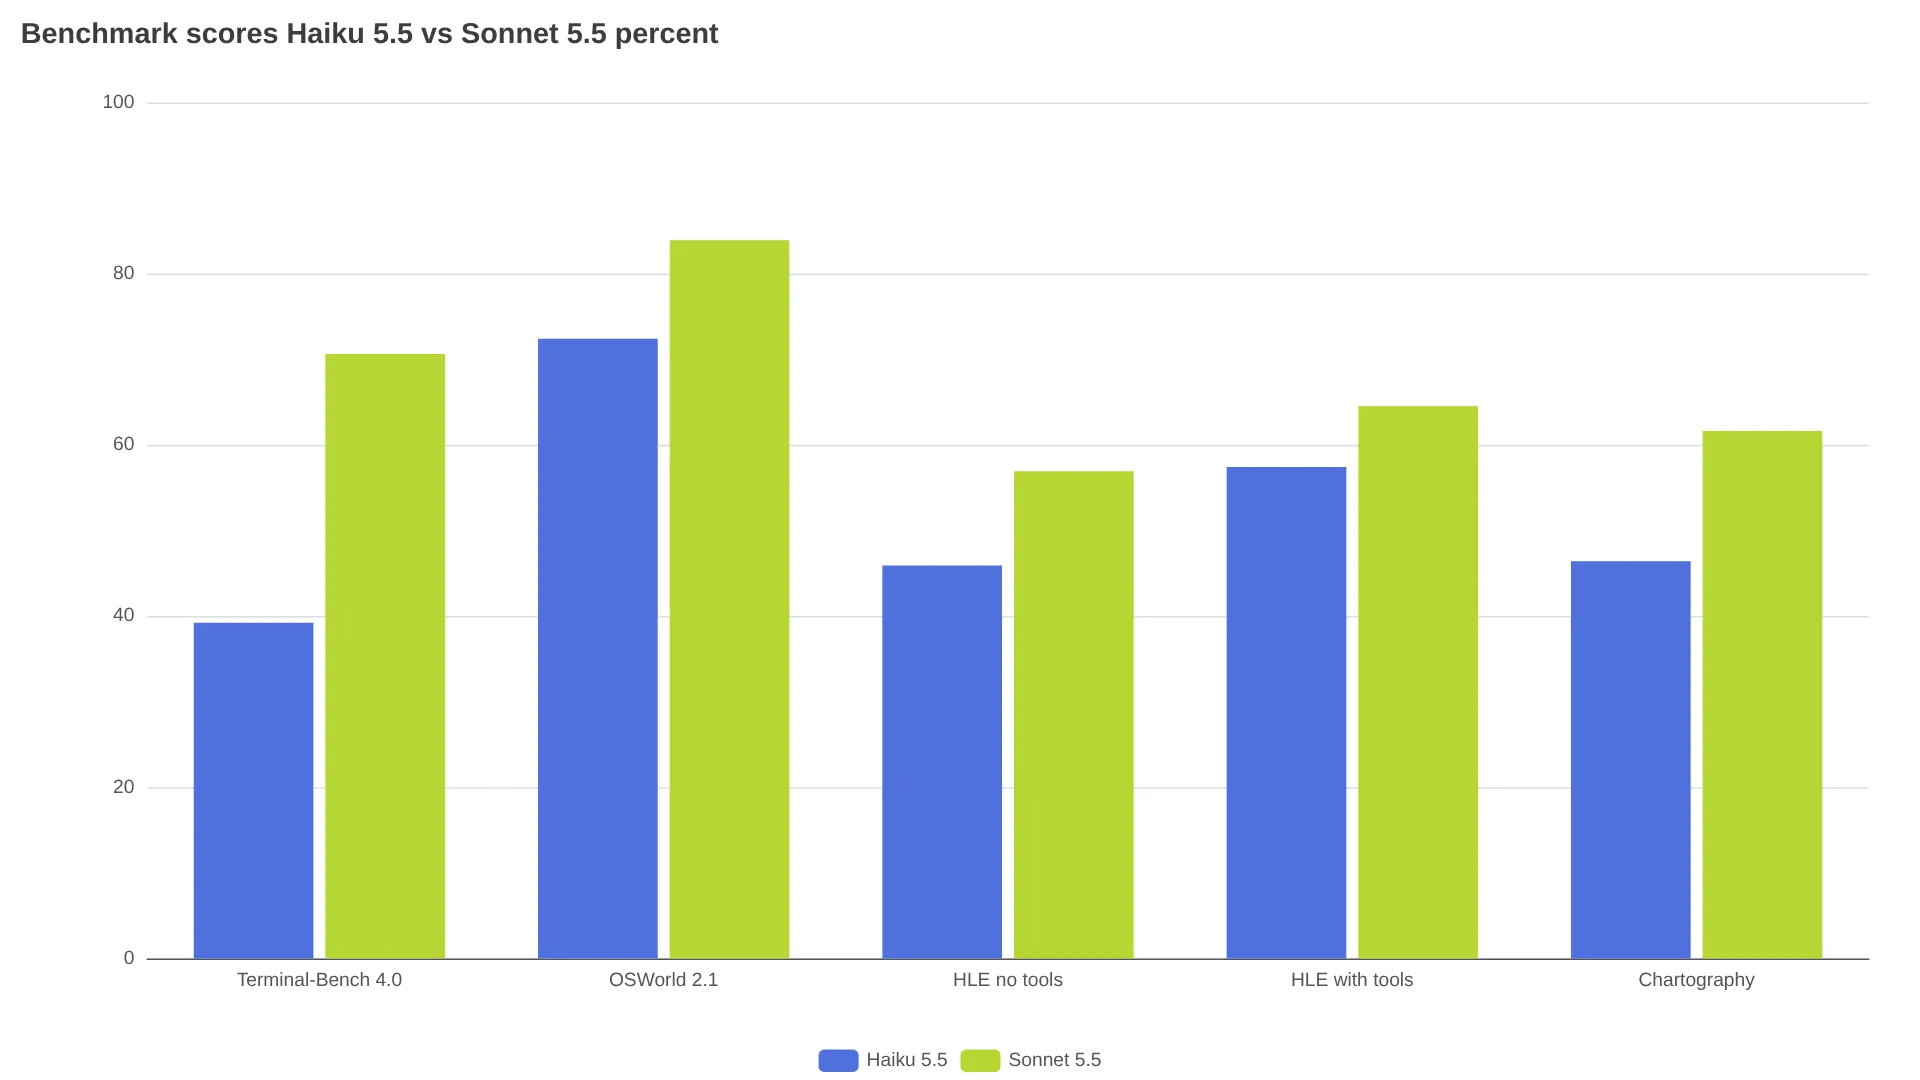
Anthropic 公布的所有正面对比结果中,Sonnet 5.5 都领先;当 Agent 需要编写和执行代码时,差距尤其明显。Agent 编程测试 Terminal-Bench 4.0 中,Haiku 5.5 得分为 39.2%,Sonnet 5.5 为 70.6%。在 OSWorld 2.1 计算机使用测试中,两者距离相对较小,为 72.4% 对 83.9%。根据 APIKO 的对比表,不使用工具时,Humanity's Last Exam 得分为 45.9% 对 56.9%;使用工具后则为 57.4% 对 64.5%。
努力等级会缩小或拉大这些差距。同一篇对比文章引用的 Artificial Analysis 结果显示,Haiku xhigh 和 Sonnet medium 在 Intelligence Index 上都得到 41 分,Terminal-Bench 成绩也几乎一致,分别为 29.3% 和 29.8%。但 Haiku xhigh 每项任务成本为 $0.12,Sonnet medium 为 $0.48;前者耗时 295 秒,后者为 122 秒。在该数据集中,没有任何 Haiku 配置达到 Sonnet 默认 high 的 47 分。这些成本数字未计入 Haiku 超过 100K 的价档,因此长上下文任务应将其视为成本下限。
狭窄的抽取和分类任务,并不需要 Sonnet 的编程优势。但主导 Agent 编程、长工具循环和视觉推理需要它:Chartography 的成绩为 46.4% 对 61.6%。不要把单一 Elo 或指数得分当成通用质量排名。一项 Reddit 测试发现,在混合 Rust 与遗留代码库中,Haiku-medium 的表现可与 Sonnet 持平,成本为 $0.08 对 $1.68;而在同一工作流中,Haiku-high 发起了 385 次请求,却没有带来质量提升。详情见 r/ClaudeCode 的受控 Haiku 5.5 编程测试。
别只看模型名:Haiku low 和 Sonnet low 才是更公平的比较
不少“Haiku 太啰嗦”的抱怨,本质上是默认努力等级造成的。Haiku 5.5 默认使用 medium,Sonnet 5.5 默认使用 high,两者的思考配置也不一样。Haiku 可通过 {"type": "disabled"} 关闭思考;Sonnet 在 high 及以下努力等级使用 {"type": "between_tools"},在 xhigh/max 下则使用 adaptive 或省略思考设置。相关说明见 Claude 平台文档及 APIKO 的行为说明。
APIKO 于 2026 年 10 月 10 日通过 Messages 端点进行了一项评估,涵盖 22 个任务、528 次请求。结果显示,Haiku 在 low 下 66 次运行通过 65 次;Sonnet 视配置不同通过 64 到 66 次。对于这些短任务,Haiku 的网关成本约为 Sonnet 的十八分之一。完全关闭思考后,Haiku 仅通过 56 次,失误集中在推理和严格格式任务,例如 CSV 求和和代码追踪。Haiku 使用默认 medium 时 66 次全部通过,但输出 token 数是 low 的 4.4 倍,主要增加的是思考 token。
结合这些数据和用户反馈,可以采用以下实用规则:
- 受限任务先用 Haiku
low。分类、路由、抽取和短 JSON 等任务,不要一上来就用 Haiku 默认的medium。 - 目标是更高质量但仍保持 Haiku 价位时,先试 Haiku
high或xhigh,再考虑 Sonnetlow。根据 APIKO 对比引用的 Artificial Analysis 数据,Haikumax得分为 43,Sonnetlow为 36,成本约为后者的 60%。 - 调试、多步骤实现和长工具序列使用 Sonnet
medium及以上。在这些场景中,Haiku-high 增加的延迟未必能换来进一步的质量提升。 - 共享代码中要针对不同模型显式配置 thinking。根据 APIKO 的网关测试,若用同一模板向 Haiku 发送
between_tools,或向 Sonnet 发送disabled,上游会返回 400 错误。
“让 Opus/Sonnet 担任主协调者和审阅者,Haiku 作为执行苦力;每项功能都新建一个 Haiku 实例。”—— r/ClaudeAI 用户 u/ohrajaaa
别按任务难度路由,要看漏错的代价
真正该问的不是“这个任务难不难”,而是“如果 Haiku 看起来合理地答错了,又没人复核,会发生什么”。多项用户测试得出了相同的分工:Haiku 在需要判断的任务上可能悄悄出错;当验证成本很高时,Sonnet 的价值就体现出来了。
| 任务类型 | 首选模型 |
|---|---|
| 情感分类、工单路由、许可证转 JSON、日志摘要、OCR 与标注、SQL 选择、压缩子 Agent | Haiku 5.5 |
| 代码库搜索、单文件修改、单轮文档处理 | Haiku 5.5 |
| 主导编程 Agent、真实调试、多步骤重构、事实核查、文档归因 | Sonnet 5.5 |
根据 r/ClaudeAI 的“Haiku 5.5 最适合做什么?”讨论,用户在单轮、高吞吐的 Haiku 工作流中报告了 3 倍速度和显著的用量下降;其中一个案例仅花几美元就处理了数 MB 的文档。
一项涵盖六项任务的子 Agent 对比发现,Haiku 虽然便宜,但在研究和事实判断上可靠性明显较低,会漏掉文件,却“看起来像是干净利落的结果”。详见 r/ClaudeCode 的 Haiku、Sonnet 与 Opus 子 Agent 测试。该帖给出的防线很直接:
“如果输出会触发一个动作……那它要么交给更大的模型,要么由更大的模型检查。”—— r/ClaudeCode 用户 u/vladgladi
还有一个生产环境注意事项:Haiku 的结构化输出合规性并不是零成本获得的。APIKO 的评估记录了一个 low 下的严格格式失败案例:标签内容正确,却被包在 JSON 对象中,而非直接输出数组。根据 同一项受控编程测试,r/ClaudeCode 用户还报告了低努力等级下跳过验证、忽略约束的情况。
一套能扛住生产环境的 Haiku 优先方案
根据 APIKO 于 10 月 10 日对文档化模式进行的网关测试,接入代码必须处理模型特定的思考配置、工具选择和历史记录。Haiku 接受强制 tool_choice,而 Sonnet 会在上游拒绝它,应改用 auto 或结构化输出。Haiku 无法读取 Sonnet 的 thinking block;若历史记录保持只追加,Sonnet 则能读取 Haiku 的内容。重放经过编辑的 Sonnet block 可能返回 400。
用户独立摸索后反复趋同的一种 Haiku 优先模式如下:
- 第一轮使用 Haiku 5.5 的
low努力等级。用于分类、抽取和起草;如果要完全关闭思考,使用thinking: {"type": "disabled"}。 - 仅接受白名单标签或通过 Schema 验证的 JSON。任何不确定、不合法或会产生后果的结果,都升级到 Sonnet 5.5 的
medium。 - 让子 Agent 保持全新且一次性。每个文件或功能使用一个 Haiku 实例,不要把单个对话不断累积到超过 100K。
- 凡是会触发操作、发送消息或修改生产代码的输出,都交由 Sonnet 或 Opus 审阅。
“只要你知道该怎么做,也知道如何审查它的质量,Haiku 就非常好用。”—— r/ClaudeCode 用户 u/Awric
根据 @ClaudeDevs,Anthropic 将 Haiku 5.5 定位为与 Sonnet 或 Opus 配合、处理摘要等高吞吐任务的子 Agent。一套共享方案则让 Haiku 集群负责代码仓库搜索,由 Sonnet 负责处理 diff 和测试,见 @mirku21。
Haiku 5.5 与 Sonnet 5.5 常见问题
Haiku 5.5 比 Sonnet 5.5 便宜多少?
按标价计算,提示词低于 100K token 时便宜 20 倍:每 1M token 的输入/输出分别为 $0.10/$0.50 和 $2/$10。超过 100K 后则便宜 4 倍:$0.50/$2.50 对 $2/$10。缓存读取价格为每 1M $0.01 对 $0.10。
Haiku 5.5 和 Sonnet 5.5 的上下文窗口一样吗?
一样。根据 Anthropic 和平台文档,两者均提供 1M token 上下文窗口和 128K 最大输出。
Haiku 5.5 是否足以用于生产 API?
对于范围明确、高吞吐且便于检查的任务,通常可以,建议使用 low 努力等级并做 Schema 验证。对于主导 Agent 编程和高度依赖判断的研究,用户报告的漏检和误报率高于 Sonnet 5.5。
哪个模型更适合编程 Agent?
主 Agent 和调试选 Sonnet 5.5,Terminal-Bench 得分为 70.6%,而 Haiku 5.5 为 39.2%。搜索、代码录入和单文件子 Agent 工作可使用 Haiku 5.5,但应由 Sonnet 或 Opus 审阅。
怎样避免超过 Haiku 的 100K 定价门槛?
在接近门槛前拆分文档;将子 Agent 限定在目标文件范围;关闭冗长的测试输出;每项任务启动新的子 Agent。Agent 历史记录大约会在 20 次调用后跨过 100K。
能否在对话进行到一半时从 Sonnet 5.5 切换到 Haiku 5.5?
无法顺畅切换。Haiku 无法读取 Sonnet 的 thinking block,因此要么继续使用 Sonnet,要么在 Haiku 上重新开始。若历史记录保持只追加,从 Haiku 升级到 Sonnet 可以保留推理过程。
有一种取舍,路由策略绕不过去
| 你的工作负载类型 | 选择 | 原因 |
|---|---|---|
| 数百次分类、抽取、摘要、JSON 规范化 | Haiku 5.5,使用 low | 经过验证后,短任务通过率接近 Sonnet,成本约为其 1/18 |
| 一个大型代码库、长工具循环、必须正确的调试 | Sonnet 5.5 | Terminal-Bench 领先 31 分,且更少出现静默错误 |
| 跨越 100K 门槛的文档 | 两者都计算价格 | Haiku 的 5 倍价档会抹去大部分优势;越线后 Sonnet 仅贵 4 倍 |
| 任何静默错误会直接上线的场景 | Haiku 起草,加 Sonnet 审阅 | 每次经验证成功的成本,比名义 token 单价更重要 |
Haiku 5.5 胜在单次尝试的价格。可一旦审阅和重试开始主导 token 成本,Sonnet 的总成本反而可能更低。围绕这个区别设计路由器,这两个模型都不再是赌注。