 AIREITER
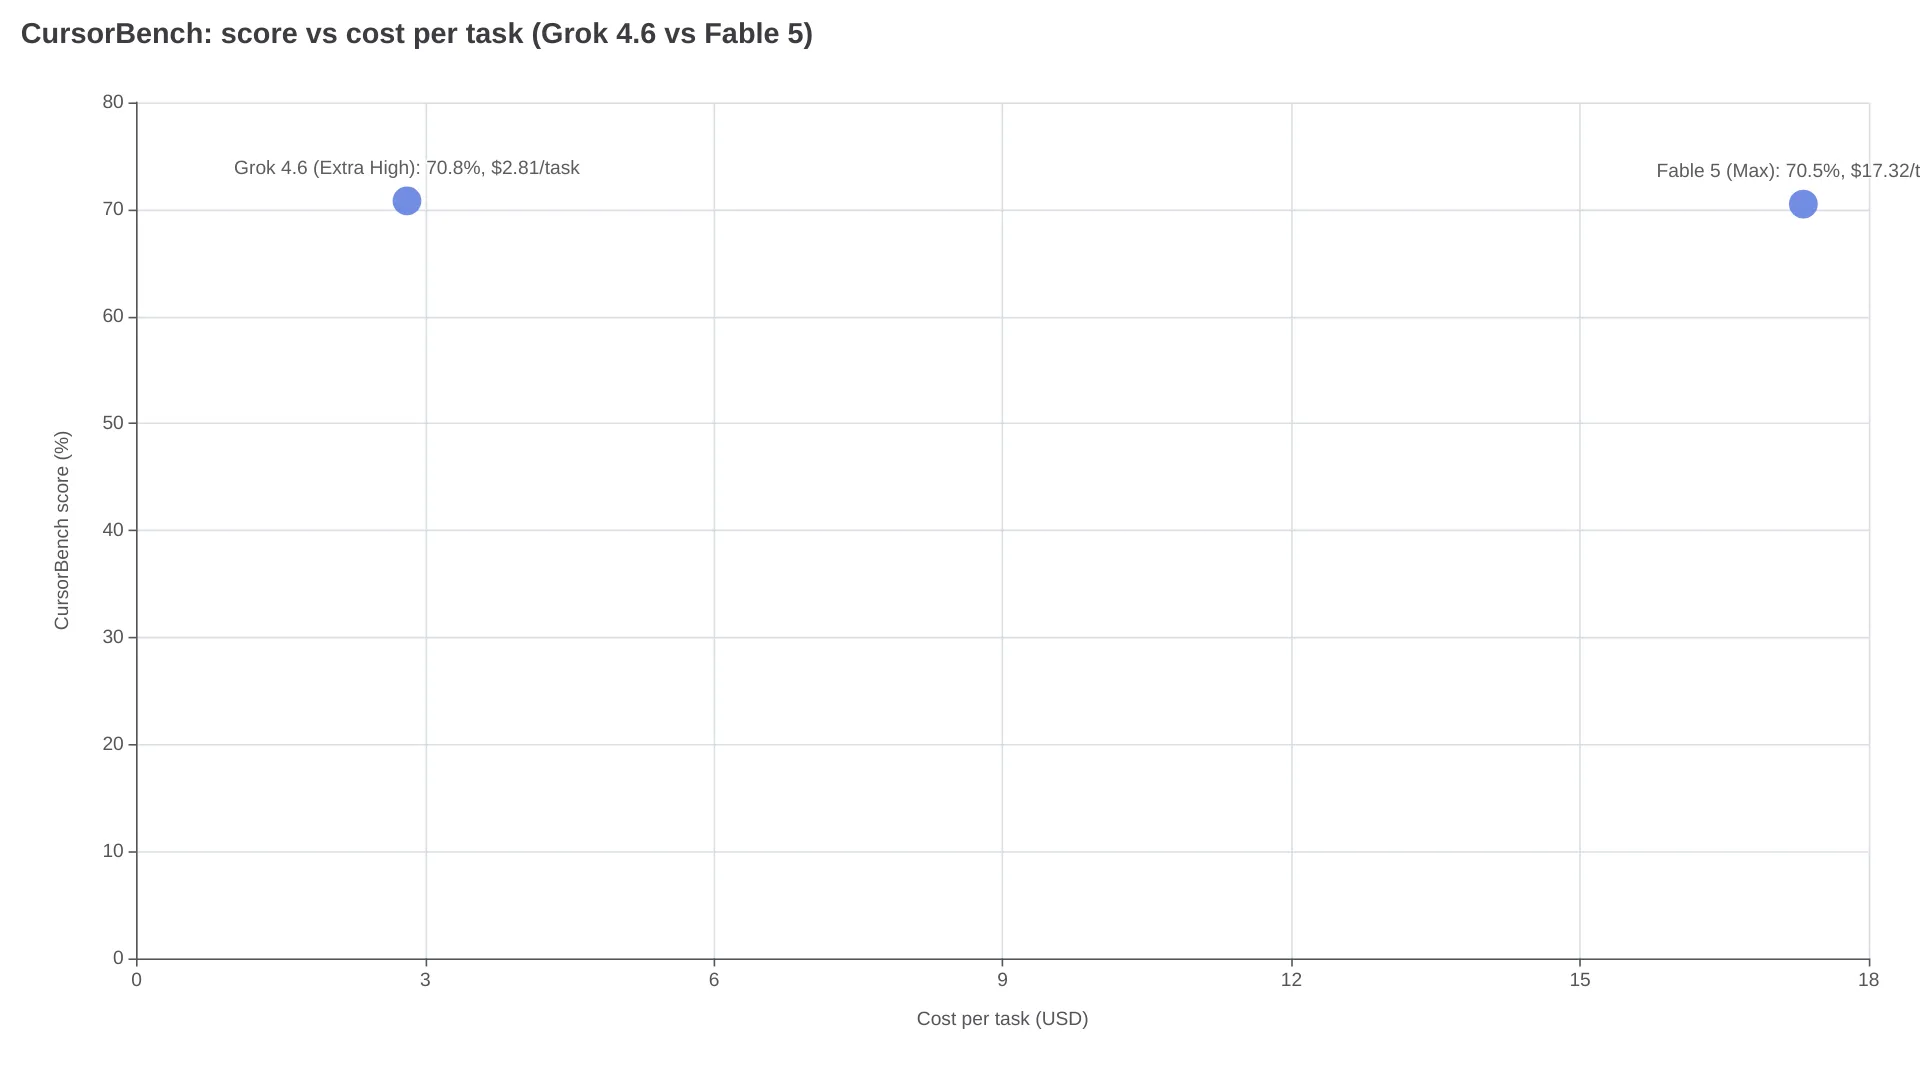
如果你用 AI agent 寫程式,單看 CursorBench,Grok 4.6 Extra High 與 Fable 5 Max 幾乎已經沒有勝負可言:前者拿下 70.8%,後者為 70.5%。但完成一項任務的成本,Grok 是 $2.81,Fable 則高達 $17.32,差距約 6 倍。Fable 5 仍有兩項明確優勢:它繼續位居 Artificial Analysis 整體智慧指數榜首,且 Context 視窗是 Grok 的兩倍。
Grok 4.6 如何追近 Fable 5
兩個月前,這組對決的答案還很清楚。2026 年 7 月,Artificial Analysis 在 Intelligence Index 給 Grok 4.5 56 分、Fable 5 62 分,差距為 6 分。
到了 2026 年 8 月推出的 Grok 4.6,根據外界報告的 benchmark 變化,估計增加約 5 分、來到約 59 分,大致追平 GPT-5.6 Sol,也讓 Fable 5 的領先縮小至約 3 分。
在 coding agent 場景,差距又縮得更小。Fable 5 於 2026 年 6 月進入 Cursor 時,曾在 CursorBench 寫下 72.9% 的 SOTA 成績(r/accelerate),比此前最佳成績高出 8 個百分點。Grok 4.6 發布後,r/cursor 在 8 月公布的正面比較中,Grok 4.6 Extra High 得到 70.8%,Fable 5 Max 為 70.5%;兩者在同一套 agent harness 下測試,實務上可視為平手。不過,參與比較的一位 Cursor 使用者提出了一個值得記住的疑問:
「Grok 4.6 讓我開始想:CursorBench 的成績究竟有多少來自模型,又有多少來自 harness?」-r/cursor 討論串,2026 年 8 月
Benchmark 衡量的是整個 agent stack,包括 prompt scaffolding、工具與重試機制,而不只是底層模型本身。此外,Fable 5 上市時的 72.9%,與 8 月比較中的 70.5%,採用的設定不同;兩組數字都應視為方向性的參考。
真正拉開差距的是每項任務成本
8 月這次比較最值得看的,是以下每項任務數據:
| 指標(CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| 分數 | 70.8% | 70.5% |
| 每項任務成本 | $2.81 | $17.32 |
| 每項任務步數 | 46 | 72 |
Fable 5 為了取得近乎相同的分數,需要多走 57% 的 agent steps;額外步數及隨之而來的 reasoning tokens,也正好解釋了成本差距。也因此,實際在兩者間切換過的開發者,開始質疑只看牌價是否還有意義:
「$/token 正逐漸成為比較 AI agents 的錯誤方式。」-r/grok 討論串標題,2026 年 8 月
每 token 的公開定價可說明部分落差。Fable 5 在 Anthropic API 的價格是每百萬 tokens 輸入 $10、輸出 $50。Grok 4.5 公開的 xAI API 費率,則是在 prompt 低於 200K tokens 時,每百萬 tokens 輸入 $2、輸出 $6;xAI 尚未公布獨立的 4.6 價目表,而 r/grok 社群認為 4.6 提供「Sol-level performance at a fraction of the API price」。若想了解各方案層級完整的 Fable 5 費率,請參考Fable 5 API 定價拆解。
不過,實務上有兩件事會壓縮 Grok 的優勢。根據 xAI 公開費率,prompt 超過 200K tokens 後,Grok 定價約翻倍,該層級為每百萬 tokens 輸入 $4、輸出 $12。其次,若你的工作流本來就高度依賴 Fable 5,切換模型之前,仍可透過一些結構性做法降低 Fable 5 token 成本。
Fable 5 依然領先的三個面向
| 面向 | 依據 | 對你的意義 |
|---|---|---|
| 智慧指數 | Fable 5 仍是 AA Intelligence Index 第 1 名:62 分,Grok 4.6 約為 59 分 | 4.6 的躍升後,原本 6 分的差距仍保留約 3 分 |
| Context 視窗 | Fable 5 提供 1,000,000 tokens Context,Grok 為 500,000 | 大型 repo 加上任務歷史可一次放入;而 Grok 在超過 200K tokens 的價格優勢也會縮小 |
| 最困難任務的可靠性 | 在 TryAI 的建置測試中,Fable 5 第一次嘗試就完成 3D Rubik's Cube 渲染,並產出最佳 SVG;Grok 4.5 則需要重跑。Goldie Bench 在 47 項 one-shot 任務中以 20 比 17 判定 Fable 5 領先,shader 與 GPU-physics 建置項目領先 0.8 至 1.6 分 | 任務模糊、且只有一次機會時,Fable 5 的推理上限更能發揮 |
速度、延遲與吞吐量
TryAI 的實測數據如下:使用相同 provider routing、400-token 上限,每種 prompt 類型各跑 3 次。
| 指標 | Grok 4.5 | Fable 5 |
|---|---|---|
| 首 token 時間 | 0.44 秒 | 3.47 秒 |
| 吞吐量 | 110 tok/s | 28 tok/s |
| 每次回覆成本 | $0.00002 | $0.00009 |
| 成功率 | 100% | 100% |
Grok 的生成速度為 110 tok/s,約是 GPT-5.5 與 Opus 4.8 的兩倍,也是 Fable 5 的 28 tok/s 約 4 倍。Artificial Analysis 還列出一組對 Fable 5 更嚴苛的數字:在最高 effort reasoning 下,Fable 5 要 113.68 秒才輸出第一個回答 token,Grok 則是 8.68 秒。不過,一旦開始串流,Fable 5 的解碼速度略快,為 63.1 tok/s,Grok 為 58.9 tok/s。
換成實際體感來說,Grok 在互動式迭代時反應俐落;Fable 5 則把大量思考放在輸出之前,因此要付出更多實際等待時間。
存取方式、訂閱方案與 agent 工具
Fable 5 可透過 Anthropic API、Claude Code 與 Cursor 使用;多數非 API 使用情境可由固定月費的 Claude Pro 訂閱涵蓋。Claude Code 生態系經過多年發展,包含 CLAUDE.md、plugins、skills 與 MCP servers,成熟度較高。
Grok 4.6 可經由 xAI API 與 Grok Build CLI 使用(curl -fsSL https://x.ai/cli/install.sh | bash);X Premium 則包含聊天存取權限。根據 ClockedCode,Grok Build 能零設定讀取既有的 CLAUDE.md、Claude Code plugins、skills、MCP servers、agents 與 hooks;它也能透過 -p 旗標以 headless 模式執行,適合 CI,並提供 Agent Client Protocol 供嵌入使用。雖然生態系較新,但對 Claude Code 的相容性,讓相容設定的遷移成本接近零。
兩者還有一項共同的帳務現實:Claude Pro 與 X Premium 用戶支付固定費率,因此在真實工作負載下,使用限制往往比價目表更重要。
依使用情境選模型
| 你的情況 | 建議選擇 | 原因 |
|---|---|---|
| 高量、規格明確的程式任務 | Grok 4.6 | CursorBench 分數打平,但每項任務為 $2.81,Fable 5 則是 $17.32 |
| 大型 repo 中、正確性至關重要的工作 | Fable 5 | 1M Context 視窗、智慧指數第 1,以及最佳的首次嘗試可靠性 |
| 互動式 agent session、快速迭代 | Grok 4.6 | 首 token 僅 0.44 秒,吞吐量 110 tok/s |
| 模糊的 one-shot 建置、最困難的推理任務 | Fable 5 | 贏下 TryAI 最難任務與 Goldie Bench 正面比較 |
| API 預算有限 | Grok 4.6 | 輸出 token 價格約為 Fable 5 的八分之一 |
我的看法是:有邊界、重複性高的工作,預設選 Grok 4.6;錯誤答案造成的代價高於 token 成本時,再保留 Fable 5。真正有使用量的團隊,應同時跑兩者,依代表性任務大小、重試率與完成任務成本來路由;這比只押注其中一個模型更省錢。
常見問題
Grok 4.6 寫程式比 Fable 5 好嗎?
以 CursorBench 來看,兩者平手:8 月比較中,Grok 4.6 Extra High 為 70.8%,Fable 5 Max 為 70.5%。不過,Fable 5 在更廣泛的 Artificial Analysis intelligence index 仍領先,為 62 分對約 59 分,且在最困難的 one-shot 任務中勝出。因此,哪個比較好,取決於你的瓶頸是每項任務成本,還是正確性的上限。
Grok 4.6 比 Fable 5 便宜嗎?
是。以完成一項 CursorBench 任務計算,Grok 4.6 約便宜 6 倍,為 $2.81 對 $17.32。每 token 的比較採用 Grok 4.5 已公開的費率,即輸出每百萬 tokens $6,對上 Fable 5 的 $50,因為 xAI 尚未發布獨立的 4.6 價目表。超過 200K tokens 後,Grok 的定價約翻倍,差距也會縮小。
哪個模型的 Context 視窗較大?
Fable 5 較大,為 1,000,000 tokens;Grok 為 500,000。若工作負載需要把整個 codebase 放進 Context,這項差異可能比 Grok 的價格優勢更重要。
Grok Build 能使用我的 Claude Code 設定嗎?
可以。Grok Build 會自動讀取 CLAUDE.md、Claude Code plugins、skills、MCP servers、agents 與 hooks,無須移植設定;它另有自己的 .grok/ 目錄,用於 Grok 專屬設定。
Grok 4.5 的 benchmark 能作為 Grok 4.6 的可靠參考嗎?
若看能力,不行。相較於 4.5,Grok 4.6 的 Intelligence Index 約增加 5 分,讓對 Fable 5 原本 6 分的落後縮減至約 3 分;在原本明顯落後的 CursorBench 上,它也與 Fable 5 Max 打平。本文的速度與每 token 定價數字則是 Grok 4.5 的測量值,因為目前還沒有公開的同等 Grok 4.6 數據。
這個取捨仍沒有定論
這篇比較中的任何一項 benchmark,都無法回答以下情境下 Grok 的成本優勢是否仍成立:repo 有 50,000 行、ticket 描述模糊,而且一次失敗就得多花一小時除錯。Fable 5 的 1M Context 與更高的智慧上限,本來就是為這種情境而存在:用昂貴的確定性,換取 Grok 4.6 的低成本步數。兩者差距夠大,多數團隊仍值得同時維持兩者可用。
延伸閱讀:Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5