 AIREITER
Anthropic 現在把 Claude Opus 5.5 定位成付費方案知識工作的預設模型,實際表現大致支撐這個決定。不過,真正影響使用體驗的問題也很明顯:在 Pro、Max 和 Team 方案上,配額往往比預期更快用完。
Opus 5.5 於 September 22, 2026 發表,是 Claude 5.5 家族的第一款模型。Anthropic 表示,它在多數工作上的表現可達到 Claude Fable 5.1 的水準,但執行成本比 Opus 5 低 40%(anthropic.com)。到了 November 12, 2026,Anthropic 在日常主力指南中把定位說得更直接:研究、分析、寫作、報告、試算表與簡報,先從 Medium 強度的 Opus 5.5 開始,只有不夠用時才往上調整(claude.com)。本文綜合官方建議、獨立基準測試與使用者配額回報,並非 Anthropic 的第一方實驗室測試。
30 秒結論:維持預設,但鎖定 Medium
保留 Opus 5.5 作為預設模型,日常知識工作使用 Medium 強度。先提高推理強度,再考慮換模型;只有在速度或處理量比判斷品質更重要時,才改用 Sonnet 5.5 或 Haiku 5.5。
這個選擇靠的是算術,不是品牌忠誠。Anthropic 的程式設計與知識工作評測顯示,Medium 強度的 Opus 5.5 已經追平或超越 High 強度的 Opus 5;而 Factory 在 Anthropic 的日常主力指南中表示,Medium 可達到 Opus 5 High 的表現,同時少用 20–25% 的輸出 token。Medium 也是 Claude 應用程式與 Claude Code 的預設值,多數訂閱者不必改設定就會採用這套行為。
真正的限制在訂閱配額,而不是 API 表定價格。API 價格為每百萬輸入 token 4 美元、每百萬輸出 token 20 美元,低於 Opus 5 的 5/25 美元;快取讀取則是每百萬 0.20 美元。不過,根據 Anthropic 的日常主力指南,價格較高的模型會更快消耗訂閱使用上限;實際使用者也回報,繁重工作階段可能在 15–30 分鐘內耗盡 5 小時視窗,週配額也比 September 的蜜月期更早見底。
November 的預設切換,對 Pro、Max 與 Team 到底改了什麼
對訂閱者而言,關鍵是新預設背後的配額機制。Anthropic 在發布時表示,會提高 Pro、Max、Team 與按席位計費的 Enterprise 方案之 5 小時使用上限,並讓訂閱者可以儲存速率限制重設操作(anthropic.com);但在 October 下旬,使用者已開始回報配額消耗加速,詳情如下。Anthropic 的指南也指出,除了發布優惠之外,Pro、標準 Team 與按席位計費的 Enterprise 席位,通常不會在一般配額內包含 Fable 5.2;Fable 會改從使用點數中扣除。實際規劃時,應把 Opus 視為方案內的主力模型,把 Fable 當成按量計費的例外。
日常主力定位在哪些工作站得住腳:研究、分析與寫作
經得起逐項核對的研究備忘錄
最嚴格的測試,是撰寫一份有來源的公司業績報告:故意讓業績公告難以找到,而且只要捏造任何數字或引述,整份報告就算失敗。Opus 5.5 在不同推理強度下的 18 份報告中通過 16 份;Anthropic 表示,Fable 5.1 與 Opus 5 在同一測試中一次都沒有達標(claude.com)。Anthropic 的發布文章也引用 Walleye Capital 的外部測試:Opus 5.5 在最低推理強度下就大致解完測試集;提高強度後,甚至抓到評測者自己指令裡的 off-by-one 索引錯誤。Walleye 表示,先前測過的模型都沒有發現這個問題。
實際工作上的含意很簡單:把開放式研究交給模型時,先定義交付成果並附上來源,最後再核對數字,而不是只校對文字表面。
分析工作:試算表、併購計算與複雜圖表
在一個虛構的兩家人力資源軟體公司合併案例中,Opus 5 與 Opus 5.5 都建立了 Excel 模型和高階主管簡報,最後得出相同的交易結論。Opus 5.5 花了 63 分鐘,Opus 5 則是 93 分鐘;前者據報少花 50% 的製作成本,模型更完整,細小錯誤也更少(claude.com)。在更廣泛的金融工作流程中,Hebbia 回報 Opus 5.5 的條件涵蓋率為 86.6%,Opus 5 則為 60.3%;根據 Anthropic 的發布文章,Rogo 也表示 Opus 5.5 在 BigFinance Bench 上勝過 High 強度的 Opus 5,同時少用約 60% 的輸出 token。
視覺能力也是同一組優勢的一部分。Anthropic 稱 Opus 5.5 是目前最擅長視覺工作的 Opus 模型,涵蓋複雜文件、圖表數值、螢幕截圖與示意圖;在最低推理強度下,它讀取複雜圖表的準確度,甚至高於最高強度的 Opus 5(claude.com)。公開的 Chartography 成績,在最高測試設定且不使用工具時為 64.4%(claude.com);發布評分表中,使用工具則為 89.0%。GDPval-AA 專業工作 Elo 為 1846,高於 Fable 5.1 的 1735 與 Opus 5 的 1708(anthropic.com)。
實務上,直接要求模型交付完成的試算表或簡報;有圖表時,附上圖片比手動抄數字更好;並在第一則訊息中講清楚什麼條件下算完成。
寫作重點:交付完整文件與簡報,不只是大綱
這裡的寫作優勢,並不是籠統地說「文筆更好」,而是指令遵循能力與可稽核性。Anthropic 表示,Opus 5.5 能維持工作範圍、先講結論、減少術語、遵守指定的風格規則,並說明自己做了什麼、找到什麼,以及還需要哪些輸入。獨立評測的方向也一致:Hayz Labs 給 Opus 5.5 的寫作與程式設計都是 100 分,研究則為 94 分;截至其 October 的檢查,它在 Arena 的 WebDev 與 agents 排名第一,創意寫作排名第二。
但要誠實說,若要完全貼合特定公司的 house style,仍然需要反覆修改。
推理強度旋鈕,其實就是價格標籤
根據 eesel 的推理強度整理,Opus 5.5 有 Low、Medium、High、Very High/Extra High、Max 五個等級,而且根據 Hayz Labs,無法關閉思考功能。相較於每 token 的單價,真正大幅影響成本的是這個強度旋鈕。
eesel 根據 Artificial Analysis 數據整理的任務成本顯示,同一項困難工作,Low 約 0.55 美元、Medium 約 1.34 美元、Max 約 5.98 美元;對應的 Intelligence Index 約為 42、51 與 58。一次 Max 執行可能產生約 119,000 個輸出 token,以每百萬輸出 token 20 美元計算,費用主要就花在這裡。Hayz Labs 的 Pareto 分析也得到相近結果:14 天內每項 agent 任務的中位數約為 1.61 美元,主表中位數為 1.76 美元;High 約為 1.82 美元。
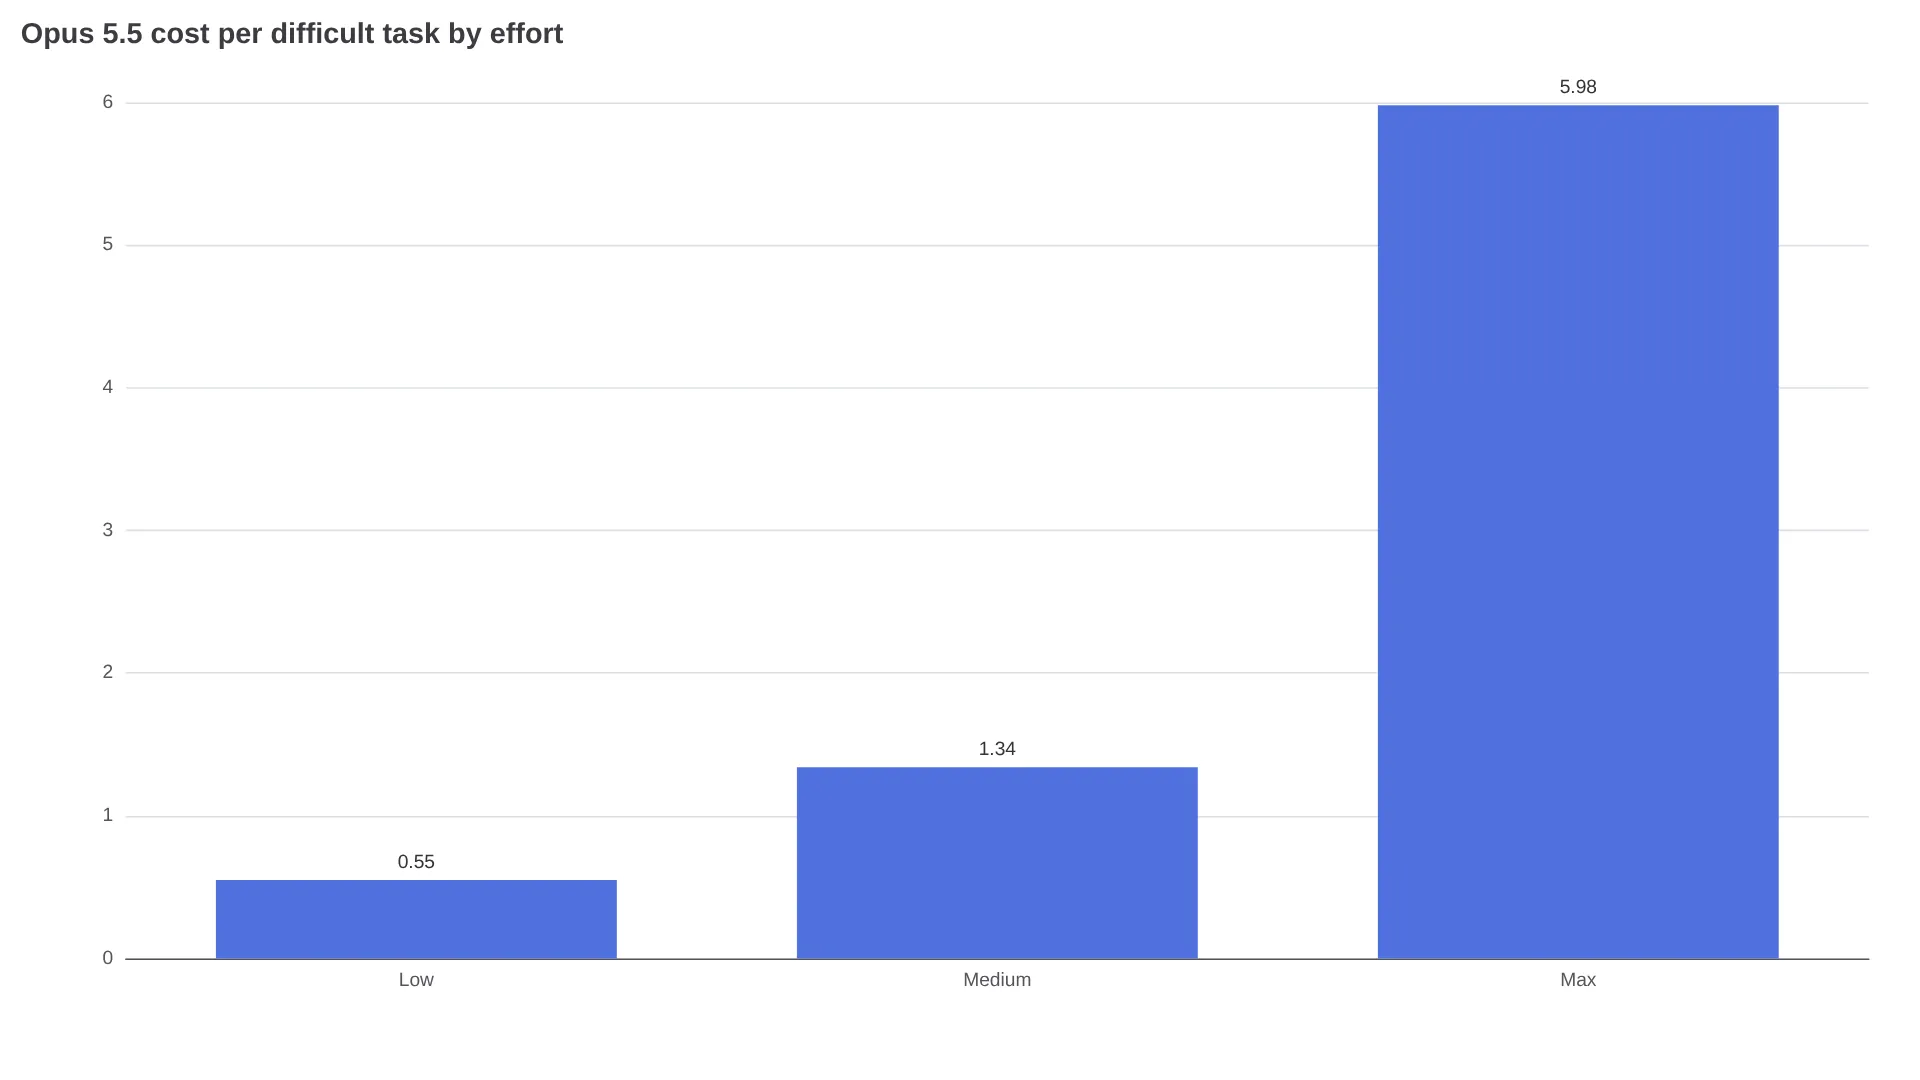
提高推理強度會讓執行時間與成本一起增加,但結果不一定更好。Anthropic 的建議是,別再額外加上「think hard」之類的提示詞:模型本來就會推理,深度由任務與強度設定共同決定;只有在 Medium 明確卡住時,才往上調整。
根據 eesel 的規格表,上下文視窗為 1 million tokens,最多可輸出 128,000 tokens,Batch 則為 300,000 tokens,並支援原生視覺能力。eesel 的價格分析指出,長上下文不另收費;對需要稽核超長文件的工作流程而言,這點很重要。
四模型分工:Opus 5.5、Sonnet 5.5、Haiku 5.5 與 Fable 5.2 怎麼選
Anthropic 的 November 指南與獨立成本分析,最後都指向同一個原則:先調整推理強度,再考慮換模型。以下價格取自Anthropic 的日常主力指南價格表。
| 模型 | 每 1M token 的 API 價格(輸入/輸出) | 適合用在 | 何時換走 |
|---|---|---|---|
| Haiku 5.5 | 最多 100K tokens 時為 $0.10 / $0.50 | 快速查詢、摘要、分類,以及大量且範圍狹窄的工作 | 分析變得複雜或需要大量判斷 |
| Sonnet 5.5 | $2 / $10 | 定義清楚的任務、文件潤稿,以及根據明確簡報需求製作投影片 | 經常需要 Extra High 或 Max 強度 |
| Opus 5.5 | $4 / $20 | 大多數研究、分析、金融工作與完整文件 | 在真正以 High 重試一次後,Medium 仍然卡住 |
| Fable 5.2 | $8 / $40 | 開放式技術工作、科學、程式設計,以及由長時間執行的子 agent 團隊處理的金融工作 | 一般知識工作,通常用得太重 |
需要記住的交叉點是:Sonnet 5.5 一旦推到 Extra High 或 Max,每項任務的成本可能接近 Opus 5.5,但判斷能力仍落後於 Opus。使用 coding plan 的人也回報了相同的訂閱機制:不要習慣性把 Sonnet 停在 Medium 以上,寧可把任務改交給 Low 強度的 Opus 5.5(例如參見 @cupid25157)。這與官方「先調強度、再換模型」的階梯,以及單項任務成本計算相互吻合。
Fable 是天花板,不是日常競爭對手。Anthropic 在 November 的 Fable 5.2 討論串中,把 Fable 與 Mythos 定位在最具挑戰性的開放式技術工作;Opus 5.5 則是大多數程式設計與知識工作的最強日常主力(@claudeai)。在訂閱方案中,差別更明顯:標準 Pro/Team 席位通常會把 Fable 從點數中扣除,因此一時興起改用「更強的模型」,可能最後變成一張點數帳單。
配額求生:為什麼 5 小時視窗一下就空了,該怎麼避免
這是官方基準測試不會告訴你的部分,卻是使用者最在意的問題。大家抱怨最多的不是能力,而是配額消耗。
「Opus 5.5 的限制今晚被徹底榨乾了!好幾個人回報,正常工作階段的 5 小時配額只在 15-30 分鐘內就用光。週配額也消耗得快得多。」—— @TekonBurns,回報 Claude Code 工作階段的消耗情況
有些使用者把這種變化形容成蜜月期突然結束。@kgauravnm 表示「Claude Opus 5.5 的蜜月期正式結束」,並提到模型行為變得敷衍、週配額消耗加速;Team 席位使用者如 @ps_ios_dev 也形容,即使在免費週配額重設後,Medium 強度的使用量仍在「狂飆」。不過,有一點需要保留:@sonuv_dev 分析 67,000 則 Claude Code 訊息後發現,工具呼叫、失敗率與抱怨率大致持平,認為「幾乎沒有模型被削弱的證據」。這表示至少有一部分問題,可能來自更高的預設使用量與更昂貴的推理,而不是暗中降級。模型選擇在頂端能力上也有差異:@mohitsharmadl 回報,有案例顯示 Medium 強度的 Fable 5.2 解決了 High 強度 Opus 5.5 無法處理的錯誤;因此「什麼都用 Opus」反而可能把配額浪費在不適合的能力上限。
綜合官方建議與使用者回報,可以採用以下配額策略:
- 所有工作預設使用 Opus 5.5 Medium;把 High 視為針對問題的升級,不要當成固定個性設定。
- 按子任務分工:Haiku 負責擷取與分類,Sonnet 負責範圍明確的初稿與潤稿,Opus 負責判斷、稽核與最終確認。
- 不要習慣性把 Sonnet 停在 Medium 以上;先算清楚成本交叉點,必要時改用 Opus Low/Medium。
- 附上檔案、連接儲存庫,不要每一輪都重貼相同上下文;長上下文反覆傳送會在每一輪增加 token,進而推高實際用量。
- 把速率限制重設留給真正有截止期限的那一週,不要拿來做實驗。
- 只在 Fable 真正擅長的狹窄場景使用它,也就是長時間、多 agent、開放式技術工作;並先確認該席位是否會從點數中扣除。
FAQ:大家真正會問的日常主力問題
Claude Opus 5.5 夠不夠格當日常主力?
如果你的工作是研究、分析與寫作,而且重視判斷與可稽核性,答案是肯定的。Hayz Labs 將它評為 agents 與 WebDev 第一名,寫作分數也拿到最高;Anthropic 引用的企業測試同樣得出類似方向。不過,最好同時準備一款更便宜的模型處理大量工作。
日常工作中,Opus 5.5 比 Sonnet 5.5 好嗎?
面對模糊或後果重大的工作,是的。若任務清楚、範圍明確,而且需要大量處理,Sonnet 使用 Low 或 Medium 會更快;Anthropic 將 Sonnet 評為 Fast,Opus 則是 Moderate(claude.com),token 價格也約低一半。真正的問題,是預設把 Sonnet 推到 Extra High 或 Max,這會直接抵銷省下來的成本。
什麼時候該用 Opus 5.5,而不是 Fable 5.2?
大多數知識工作與一般程式設計任務都用 Opus。只有在開放式、長時間執行或高度 agent 化的技術專案中,Opus 使用 High 仍然卡住時,才升級到 Fable;另外要先確認方案計費方式,因為標準 Pro/Team 席位通常會把 Fable 從點數中扣除。
1-million-token 上下文處理長文件時可靠嗎?
若是搭配附件進行稽核型工作,這是 Anthropic 推出的最強 Opus 設定,包含 18 份來源報告通過 16 份的測試結果。但超長任務仍會快速消耗訂閱配額,因此應讓 Haiku 負責擷取、Opus 負責判斷,而不是所有工作都塞進最大的上下文。
真正需要留意的取捨
在 Medium 強度下,Opus 5.5 確實是知識工作的正確預設;目前的疑問是,使用者在 October 下旬回報的配額緊縮,是否會變成常態。如果是,代表每週仍有更多工作必須交給 Sonnet,而不是發布時的訊息所暗示的那樣。
延伸閱讀:Claude Opus 5.5 pricing review、Claude Opus 5.5 High review、Claude Opus 5.5 vs GPT-6.1 Sol。