 AIREITER
如果你每天都在跑程式碼 Agent,Gemini 4 Hydrogen 和 Claude Sonnet 5.5 的差異,最後會落在兩件事:成本與需要人工介入的頻率。在輸入、輸出各半的情況下,Hydrogen 每百萬 Token 約便宜 25%($4.50 對 $6.00);但在終端機與電腦操作任務上,Sonnet 5.5 仍更常能在不需要人手協助的情況下完成工作。單看價格或基準測試表,都無法告訴你每個成功完成的任務究竟要花多少成本。
Gemini 4 Hydrogen 與 Claude Sonnet 5.5 都主打 1M Token 上下文,鎖定高速程式開發與 Agent 循環;Hydrogen 另外提供四段可調整的思考層級。
明天把 Sonnet 5.5 換成 Hydrogen,實際會改變什麼?
一天執行 200 個 Agent 任務的團隊,通常會在兩個地方感受到差異:帳單,以及需要介入處理的比例。Hydrogen 不只 Token 單價較低,根據 LLM Leaderboard 的獨立速度測試,它的生成速度約為每秒 198 Token,Sonnet 5.5 則約為 144 Token。這就是典型的「大量執行器」:快速產生草稿、平行讀取檔案,還能迅速完成修補。
Sonnet 5.5 則更像「謹慎的收尾者」。Google 的發布測試表顯示,Sonnet 5.5 在三項偏重終端機與電腦操作的基準測試中領先,包括 Terminal-Bench 4.1、OSWorld 2.1 與 Terminal-Bench-Science,詳情見下表。這些正是 Agent 是否能從失敗指令中恢復、還是直接卡住的關鍵情境。
發布首週的 Reddit 討論,也呈現出相同的任務層級分歧:
「hydrogen 還可以,但老實說,我不覺得它比 sonnet 5.5 好。」— r/GeminiAI 的 u/FewKey5274
這串討論沒有受控的程式開發基準測試,因此應該把它視為提醒,而不是定論:單一任務的勝負,未必能預測完整 Agent 測試框架的表現。正式遷移前,務必讓兩個模型跑同一套工作流程。
帳單:$4.50 對 $6.00,只是混合成本的起點
官方 API 價格本身很簡單。根據 Google 的公告,Hydrogen 每百萬輸入 Token 收費 $1.50,每百萬輸出 Token 收費 $7.50,完整上下文視窗皆採相同價格。Sonnet 5.5 每百萬輸入 Token 為 $2.00、每百萬輸出 Token 為 $10.00,資料則來自 Anthropic 的定價頁面與 OpenRouter 的並列比較。
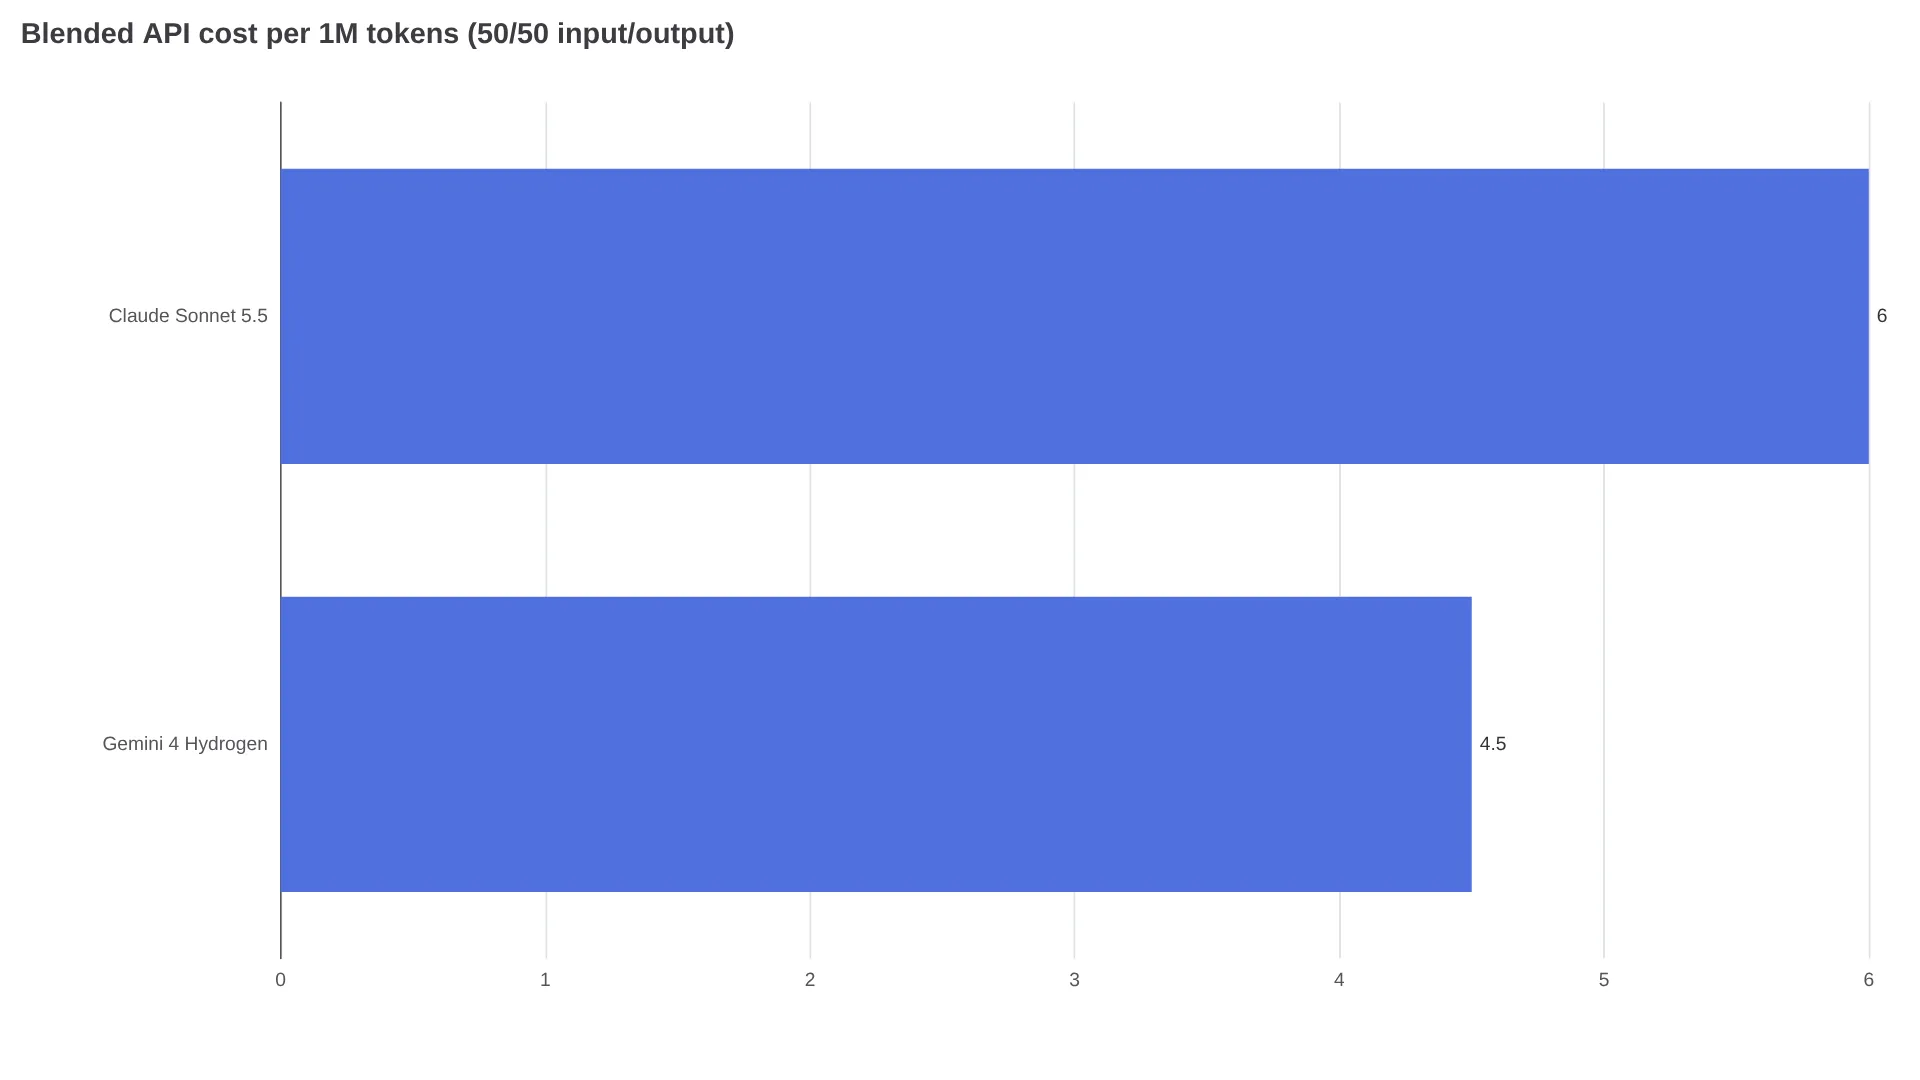
按照 50/50 混合計算,也就是 500K 輸入加上 500K 輸出,Hydrogen 每百萬 Token 為 $4.50,Sonnet 5.5 則是 $6.00。這 25% 的差距確實存在,但是否能真正省下來,還要看以下三點:
- 輸出比例越高,價差越明顯。帶有冗長推理軌跡的 Agent 循環通常偏重輸出,此時 Hydrogen 每百萬輸出 Token 便宜 $2.50 的優勢最明顯。
- 尚未計入快取與批次方案。Anthropic 的提示快取讀取與 Batch API 折扣,可能讓實際帳單上下浮動數個百分點;LLM Leaderboard 也指出,它的 Hydrogen 速度測試不支援明確的快取設定。
- 用實際案例算一次最清楚。假設每次 Agent 往返平均使用 10K 輸入 Token 與 3K 輸出 Token,每天執行 1,000 次,總量就是 10M 輸入加 3M 輸出。按照牌價,Hydrogen 每天約 $37.50,Sonnet 5.5 則為 $50.00;以每月 22 個工作日計算,每個並行 Agent 約可相差 $275,且尚未計入重試成本。
真正決定勝負的是重試。每個成功完成任務的成本,等於每次嘗試的 Token 成本除以成功率,再加上人工修正時間。只作為示意:Hydrogen 每天 $37.50、首次成功率 80%,單看 Token 成本,每 1,000 個完成任務約為 $46.90;Sonnet 每天 $50.00、成功率 95%,則約為 $52.60。只要成功率不同,價差很快就會縮小。因此,比起相信任何一家供應商的測試表,更應該連續兩週追蹤首次合併率。
基準測試不是分出唯一贏家,而是各自在不同工作類型領先
Google 的發布測試表也刊載於 DeepMind 模型卡,比較 Hydrogen、Sonnet 5.5 與 GPT-6.1 Terra 在十項評測中的表現。對上 Sonnet 5.5 時,Hydrogen 在十項中領先七項,Sonnet 5.5 則在另外三項勝出。供應商測試採用各自的測試框架;獨立項目則來自 LLM Leaderboard 的重新測試。
| 工作類型 | 基準測試 | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| 程式庫開發 | SWE-sweep(供應商) | 13.5% | 3.1% |
| 程式庫開發 | Terminal-Bench 4.1,調整作弊因素後(供應商) | 57.0% | 63.9% |
| 知識自動化 | Agents' Last Exam v1.1(供應商,對測試框架敏感) | 71.6% | 60.4% |
| 知識自動化 | AutomationBench-AA(供應商) | 76.1% | 71.8% |
| 知識自動化 | Vending-Bench 2 最終餘額(供應商) | $14,549 | $11,165 |
| 電腦操作 | OSWorld 2.1 離線子集(供應商) | 77.6% | 83.9% |
| 多模態 | MKA Climb WSR(供應商;獨立測試 49.52%) | 53.4% | 52.0% |
| 多模態 | Chartography(來源混合) | 66.6% | 61.6% |
| 科學 | Terminal-Bench-Science 0.1(供應商;獨立測試 49.52%) | 51.4% | 59.9% |
| 推理 | HLE-Diamond(獨立 xhigh) | 58.8% | 53.3% |
Agent 的成敗,往往取決於工具呼叫
基準測試評分的是答案,但 Agent 真正依賴的是工具呼叫:能否批次讀取檔案、選對函式,以及在搜尋沒有結果或指令失敗時恢復運作。
Google 表示,Hydrogen 會平行處理檔案讀取與搜尋,而不是逐一檢查檔案;它也會針對儲存庫進行精準修改,避免重寫無關檔案。發布文章中的合作夥伴報告指出,與 Gemini 3.8 Flash 相比,圖形與 SQL 工作速度提升 2 倍至 2.8 倍,Token 使用量減少 12% 至 23%;在預設的高推理模式下,完成速度則快 2.5 倍。這些都是供應商挑選的合作夥伴數據,能反映方向,但不是保證。
另一面則是測試框架的成熟度。Claude Code 與 Antigravity 討論串中,有使用者反映 Antigravity 的運作時間問題,以及 SSH、可重用 Hooks、Skills、Subagents 等工作流程功能仍有缺口。這些是發布首週的使用者觀感,不是受控測量,而且反映的是測試框架,而非模型權重本身。
在把正式 Agent 搬過去之前,至少要確認三件事:在你的 MCP 伺服器數量下,平行工具呼叫是否可靠;Bash 或瀏覽器步驟失敗後的恢復率;以及權限邊界的行為。Google 的內部測試宣稱,Agent 越權行為最多減少 81%、服務不足減少 79%,在 Agent 誠信評測中達到 96.7%。但仍應使用自有的 50 個任務金絲雀測試,涵蓋遭封鎖的操作與無結果搜尋,進行確認。
思考層級:高階模式當預設,xhigh 留給關鍵任務
Hydrogen 提供 low、medium、high 與 xhigh 四種層級,預設為 high。根據 Google 的思考層級表,Artificial Analysis Intelligence Index v5.0.1 的分數從 low 到 xhigh 依序為 27 / 41 / 51 / 54;預設的 high(51)略高於 Argon(50)。同一張表中,Terminal-Bench 4.0 的 high 為 54.0%,反而勝過 xhigh 的 53.5%;AutomationBench-AA 則從 60.5% 一路升至 76.1%,HLE-Diamond 也從 32.2% 升至 58.8%。
對 Agent 循環來說,實用規則是先從 high 開始,只有在推理成為瓶頸時,才把單一任務升到 xhigh,例如分析、綜合整理或多文件研究,之後再檢查 Token 增幅。根據 DeepMind 模型卡,Hydrogen 在更高思考層級下可能消耗更多 Token;它的知識截止時間為 March 2026,因此對新鮮度敏感的工作,無論如何都需要搭配檢索。
正式遷移前,先驗證測試框架是否撐得住
根據 DeepMind 模型卡,Hydrogen 提供 1,048,576 Token 上下文,支援最多 64K 的同步輸出,背景長解碼則最高可達 1M;Anthropic 文件則顯示,Sonnet 5.5 提供 1M 輸入上下文與最多 128K 輸出。規格表上的上下文視窗看似相近,但大型程式庫工作的關鍵其實在壓縮:與其問規格表能容納多少,不如確認跑過 50 輪後還剩下多少內容。
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| 上下文/輸出上限 | 輸入 1,048,576 Token;同步輸出 64K(背景解碼 1M) | 輸入 1,000,000 Token;輸出 128K |
| 可在哪裡執行 | Gemini API、AI Studio、Antigravity、Gemini app,依 Google | Claude API、Bedrock、Vertex AI、Microsoft Foundry,依 Anthropic |
Antigravity 與 Claude Code 討論串顯示,對遷移來說,測試框架穩定性可能比模型品質更值得擔心:使用者質疑壓縮後的內容能否保留、配額是否持續,以及服務運作時間。讓兩個框架使用相同儲存庫、相同 Commit、相同提示與相同驗收測試,再比較每個訂閱週期能完成多少任務,以及首次合併率。
60 秒選擇指南:三種 Agent 類型
沒有任何一個模型能適合所有 Agent。以下是根據上述基準測試分歧作出的編輯判斷,而非實測結果:平行、重複性的執行工作交給 Hydrogen;對錯誤恢復敏感、需要長時間維持脈絡的工作則交給 Sonnet 5.5。規劃器與執行器採用同一家供應商,有助於維持驗證與壓縮的一致性;至於讓 Claude 規劃器搭配 Hydrogen 工作器,則應先完成單一供應商基準測量後再測試。
| 你的 Agent | 選擇 | 理由(證據層級) |
|---|---|---|
| 大量執行器:批次修補、樣板程式、資料處理、多模態分流 | Hydrogen,使用 high | 在 AutomationBench、Agents' Last Exam、Vending-Bench 的供應商基準測試中領先;獨立速度測試約為 198 對 144 tok/s |
| 長流程完成者:大量終端機除錯、OS/瀏覽器自動化、科學工具 | Sonnet 5.5 | 在 Terminal-Bench 4.1、OSWorld 2.1、Terminal-Bench-Science 的供應商基準測試中領先;Claude Code 的 Hooks 與 Subagents 生態系也較受肯定 |
| 研究整合器:長篇文件、圖表、音訊/影片、以 Sheets 為主的分析 | Hydrogen,使用 high;最艱難的階段再升到 xhigh | 在 HLE-Diamond、Chartography、MKA 的供應商測試中領先;但獨立 MKA 重新測試的結果較低,為 49.52% |
Hydrogen 真的比 Sonnet 5.5 快嗎?
在 LLM Leaderboard 的測試樣本中,Hydrogen 的吞吐量較高,約為每秒 198 對 144 Token;但 OpenRouter 的即時 p50 資料顯示,Sonnet 5.5 的延遲反而較低,中位數為 2.08 秒對 6.92 秒,原因在於供應商、地區與負載不同。最終仍應使用你的供應商環境自行測量。
Hydrogen 能取代 Claude Code 裡的 Sonnet 5.5 嗎?
不是換掉模型 ID 就能完成。Sonnet 5.5 原生運作於 Claude Code,許多團隊依賴其中的 Hooks、Skills 與 Subagents;Hydrogen 則透過 Gemini API、AI Studio、Antigravity 與 Gemini app 運作。所謂取代,實際上代表要遷移整套測試框架。