 AIREITER
Gemini 4 Hydrogen 的帳面單價看起來相當有吸引力:每 100 萬 Token 輸入 $1.50、輸出 $7.50,約是 Opus 5.5 的十分之一。但在 Cursor 裡實際跑起來,真正左右帳單的往往不是牌價,而是你選擇的四種推理強度。Google 於 2026 年 11 月 12 日推出這款主打高速的 Flash 級代理模型;Cursor 已將其列為第三方模型,並在 11 月 12 日的相關報導中提到,它在 CursorBench 取得 54.3%。
在 Cursor 選擇 Hydrogen 後,實際能用到什麼
根據 Google 的發布公告與 DeepMind 模型卡,Hydrogen 已以模型 ID gemini-4-hydrogen 正式推出。在 Cursor 的 Agent 或 Chat 模式中,從模型選單選取它後,還可設定 Low、Medium、High 或 Xhigh 四種推理強度。預設值是 High,公開的 54.3% 成績也是以此設定跑出來的。
有兩件事很容易讓團隊誤判:
- 標示為 100 萬 Token 上下文,不代表 Cursor 一定能完整用到。 Google 標榜 100 萬 Token 輸入窗口,整個窗口採固定價格;在特殊的長輸出模式下,輸出最高也可達 100 萬 Token。不過,預設同步輸出的上限為 65,536 Token。Cursor 內可實際使用的限制仍以Cursor 自己的模型清單為準,因此要做全 Repo 處理前,先確認限制。
- Hydrogen 是另外計費。 Cursor 列出的 Hydrogen 費率為每 100 萬 Token 輸入 $1.50、輸出 $7.50;Argon 與 Carbon 是 $2.00 / $10.00,Opus 5.5 則是 $15.00 / $75.00。第三方模型不計入 Cursor 方案內含的模型額度,因此即使訂閱付費方案,啟用 Hydrogen 也不是免費。
CursorBench 54.3% 到底代表什麼
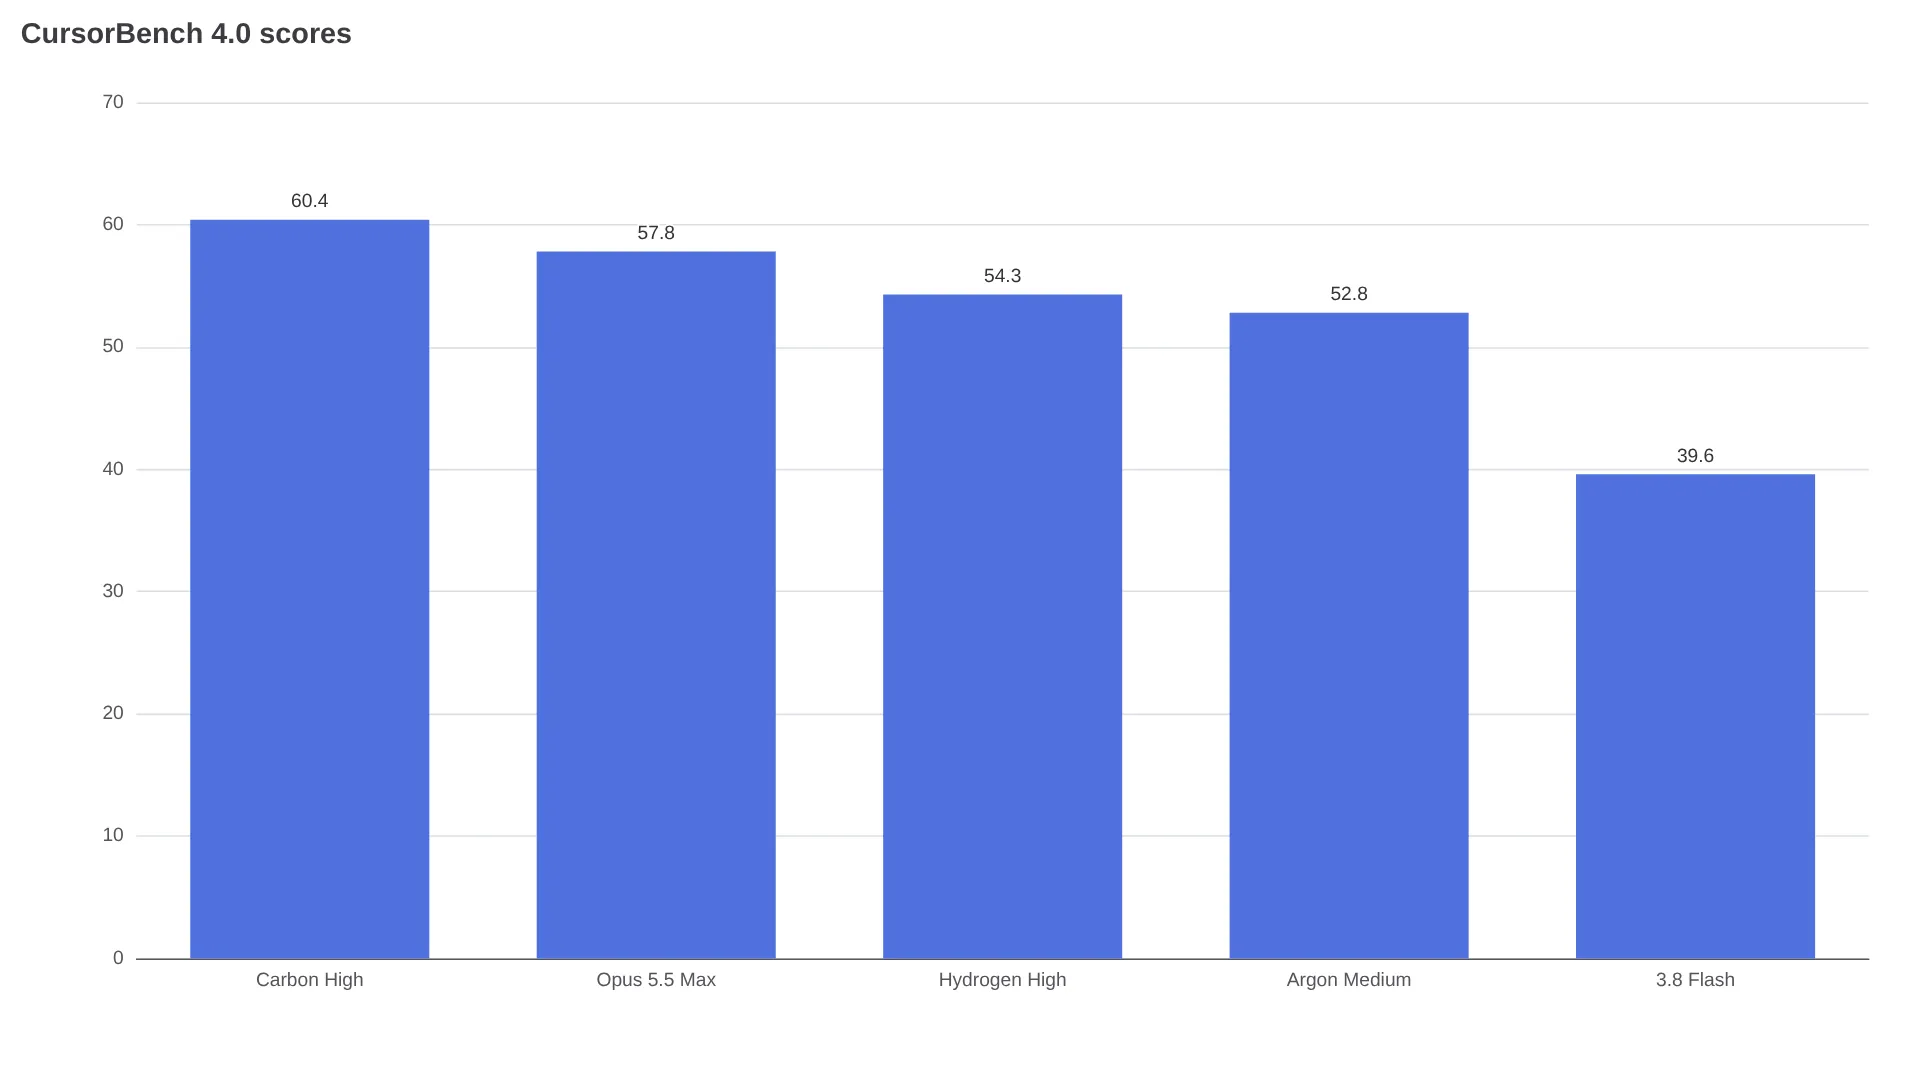
CursorBench 4.0 取樣自真實 Cursor 工作階段,測試的是具模糊條件、涉及多個檔案的工作,包括規劃、工具使用、除錯、程式修改,以及在 Repo 中導航;所有測試都在 Cursor 自家的代理框架內進行。結果本身存在變異,Cursor 也提醒,小幅差距未必具有統計意義。此外,各列採用的推理強度不同,不能將其視為完全受控的排名。
| 模型 | 推理強度 | CursorBench 4.0 |
|---|---|---|
| Gemini 4 Carbon | High | 60.4% |
| Claude Opus 5.5 | Max | 57.8% |
| Gemini 4 Hydrogen | High,預設值 | 54.3% |
| Gemini 4 Argon | Medium | 52.8% |
| Gemini 3.8 Flash | — | 39.6% |
其他基準測試大致也支持一個結論:Hydrogen 仍低於最頂尖的推理模型。根據 Ridge 的 Hydrogen 資料頁彙整及佐證,Hydrogen 在 Artificial Analysis Intelligence Index 的 High 為 51、Xhigh 為 54,Argon 為 50;在 Vals Terminal-Bench 4.0 則為 54.04%。Google 另外宣稱它在 Terminal-Bench 4.1 達到 57%,但這仍屬於廠商自行提出的成績。
為何低牌價不一定等於低單次成本
若只看每 Token 價格,Hydrogen 比 Argon 便宜 25%,比 Opus 5.5 便宜 90%。假設一次執行使用 100K 輸入與 20K 輸出 Token,Hydrogen 約花 $0.30、Argon 為 $0.40、Opus 則是 $3.00;這還未納入推理深度、快取與重試。
不過,若改以完成一個短任務的成本來看,排序可能反過來,因為 thinking tokens 會按照輸出 Token 計費。下表來自 Ranthis 在 11 月 13 日進行的 API 測試:共進行 171 次付費層級呼叫,涵蓋三項各執行三次的辦公任務、合計 45 次檢查,以及 10 道困難數學題。這些是短篇、單輪 API 任務,不是 Cursor Agent 執行結果,因此應將其視為觀察推理額外負擔的參考,而非 Cursor 帳單預估。
| 模型與推理強度 | 辦公任務組成本 | 數學任務組成本 | 觀察到的 thinking tokens | 中位延遲 |
|---|---|---|---|---|
| Hydrogen High | $0.0723 | $0.1134 | 樣本任務為 1,230–1,350 | 5.7s |
| Hydrogen Low | $0.0506 | $0.0927 | 每次呼叫 128–1,438;樣本任務為 813–864 | 3.8s |
| Hydrogen Xhigh | $0.1855 | $0.4995 | 最高達 6,112;一題積分題在 94s 內使用 22,508 | 11.4s |
| Argon 預設值 | $0.0195 | $0.0566 | 樣本任務為 0–236 | 5.4s |
| 3.8 Flash 預設值 | $0.0387 | $0.0381 | — | 8.4s |
| 3.8 Flash Low | $0.0163 | $0.0267 | — | 5.2s |
| Carbon Low | $0.0148 | $0.0445 | 全部 19 次測量呼叫皆為零 | 5.1s |
該測試中,所有 Hydrogen 推理強度在辦公與數學任務上都拿到 45/45 與 10/10;但 Hydrogen High 在辦公任務組的成本約為 Argon 的 3.7 倍,數學任務組則為 2 倍。Carbon Low 在 Hydrogen Low 從未達到零的情況下,則完全沒有使用 thinking tokens。
Google 宣稱 Hydrogen 比 Flash 快 2.5 倍,而合作夥伴報告也指出,在代理工具呼叫工作負載中,執行速度快了 2–2.8 倍、Token 使用量降低 12–23%。但在短篇單輪任務中,Ranthis 測得的差距較接近 1.5 倍,也就是 5.7s 對 8.4s。速度帶來的折扣主要會在大量使用工具或工作可分流時放大。
Cursor 裡該怎麼選推理強度
推理強度改變的是計費 Token 數量,而不是牌價。選擇更高強度不會讓 $1.50/$7.50 上漲,卻會生成更多需要付費的 thinking tokens。
- Low:日常工作先從這裡開始。 在引用的 API 測試中,這是最便宜的 Hydrogen 設定;辦公任務成本比 High 低 30%,成績仍全數通過。它適合小型功能、聚焦修正、規律的重構、平行工作者、Diff 審查與測試分流;之後再針對自己的 Repo 驗證是否需要升至 High。
- High:兼顧品質與成本的預設選擇。 54.3% 的分數就是在此設定下取得。當任務需要跨檔案規劃、處理模糊除錯問題,且 Low 開始漏掉限制條件時,便應保留 High。
- Medium:未見明確成本優勢。 在一次數學測試中,Medium 處理單一高雜訊問題的成本是 $0.1346,反而高於 High 的 $0.1134。不要假定它的成本與品質必然剛好介於 Low 和 High 之間。
- Xhigh:只在卡關時升級。 這是取得 54 指數分數的設定,適合高難度規劃與除錯;日常工作應避免使用。
從這些數據來看,較合理的模式是將 Hydrogen 作為工作者與驗證者,交由更強的協調模型統籌。讓 Carbon(60.4%)或 Opus 5.5(57.8%)負責架構設計與棘手除錯,再把日常實作、驗證與大上下文閱讀分派給 Hydrogen Agent;我們的 Hydrogen vs Sonnet 5.5 agent 選擇指南也有更完整的說明。
本週部署時要留意的狀況
Gemini 生態系的早期回報普遍肯定速度,但在可用性與配額顯示上並不一致。這些都只是單日觀察,不能視為固定限制;Cursor 的實際計費仍應以你的儀表板為準。
「過去 4hr 我一直用它寫一款 3d voxel 遊戲,已經超過 25 個提示詞,週額度只用了 5%。沒有出錯。」— u/More-Secret3587,r/GeminiAI Hydrogen 程式開發討論串
其他早期討論則提到,模型選單中的 Hydrogen 曾出現後又消失,並如這篇可用性討論所述,在 Hydrogen 與 Flash 間即時切換。另有使用者如這篇使用討論提到,PDF 批次處理相當節省配額,但部分回應的配額消耗又比預期快。引用的討論串並未證實原因。
建議做法:
- 模型選單找不到 Hydrogen 時,先檢查 Cursor 的模型清單與方案額度,再重新嘗試。
- 配額看起來不一致時,請追蹤 Cursor 儀表板的實際用量,不要依賴發布當日的平均觀察。
- 延遲突然升高時,先降至 Low、拆分任務並重試,再考慮切換模型。
Hydrogen 適合當你的 Cursor 預設模型嗎?
| 你的工作類型 | 建議選擇 | 原因 |
|---|---|---|
| 日常功能、修正、重構、審查、平行 Agent | Hydrogen Low,卡關再升至 High | 引用的 API 測試中是最便宜的 Hydrogen 設定;品質下降時再升級 |
| 模糊的跨檔案規劃、深度除錯 | 以 Carbon High 或 Opus 5.5 Max 作為協調模型 | 當推理深度主導結果時,60.4% 與 57.8% 都勝過 Hydrogen |
| 成本至上的大量短呼叫 | Argon 預設值或 3.8 Flash Low | API 測試中,辦公任務組的 $0.0195 與 $0.0163 優於 Hydrogen Low 的 $0.0506 |
| 工作負載尚未確定 | 在五個 Repo 任務上比較 Low 與 High | 以完成率、費用、延遲與重試次數決定預設值 |
若你的 Cursor 工作以日常任務和吞吐量為主,Hydrogen Low 是合理的起點;遇到困難規劃時,再一鍵切換至 Carbon 或 Opus。正式固定預設模型前,仍應先以自己的任務驗證實際成本效益。