 AIREITER
如果只看品質,Opus 5.5 勝出;只看牌價,GPT-6.1 Sol 佔優。但這個優勢只在每次請求的輸入 token 不超過 272K 時成立。一旦跨過門檻,Sol 的長上下文附加費會吃掉大部分價差;而且幾位 Codex 使用者表示,Sol 的實際等待時間反而更長。
兩個模型目前都已正式上線。Anthropic 於 2026 年 9 月 22 日推出 Claude Opus 5.5,它是首個 Claude 5.5 模型;OpenAI 則於 2026 年 9 月 29 日推出 GPT-6.1 Sol,API ID 是 gpt-6.1-sol。但光看規格表,會漏掉真正影響帳單的三件事:長上下文的價格斷崖、推理強度設定,以及訂閱方案的額度消耗方式。
先講結論
如果錯誤或過度膨脹的 patch 代價高於 token 成本,例如長時間遷移、多 repo 稽核或無人值守代理,選 Claude Opus 5.5。如果你的工作量大、範圍明確,而且每次請求的輸入 token 都低於 272K,例如工單自動化、PDF 擷取與企業工作流程,則選 GPT-6.1 Sol。
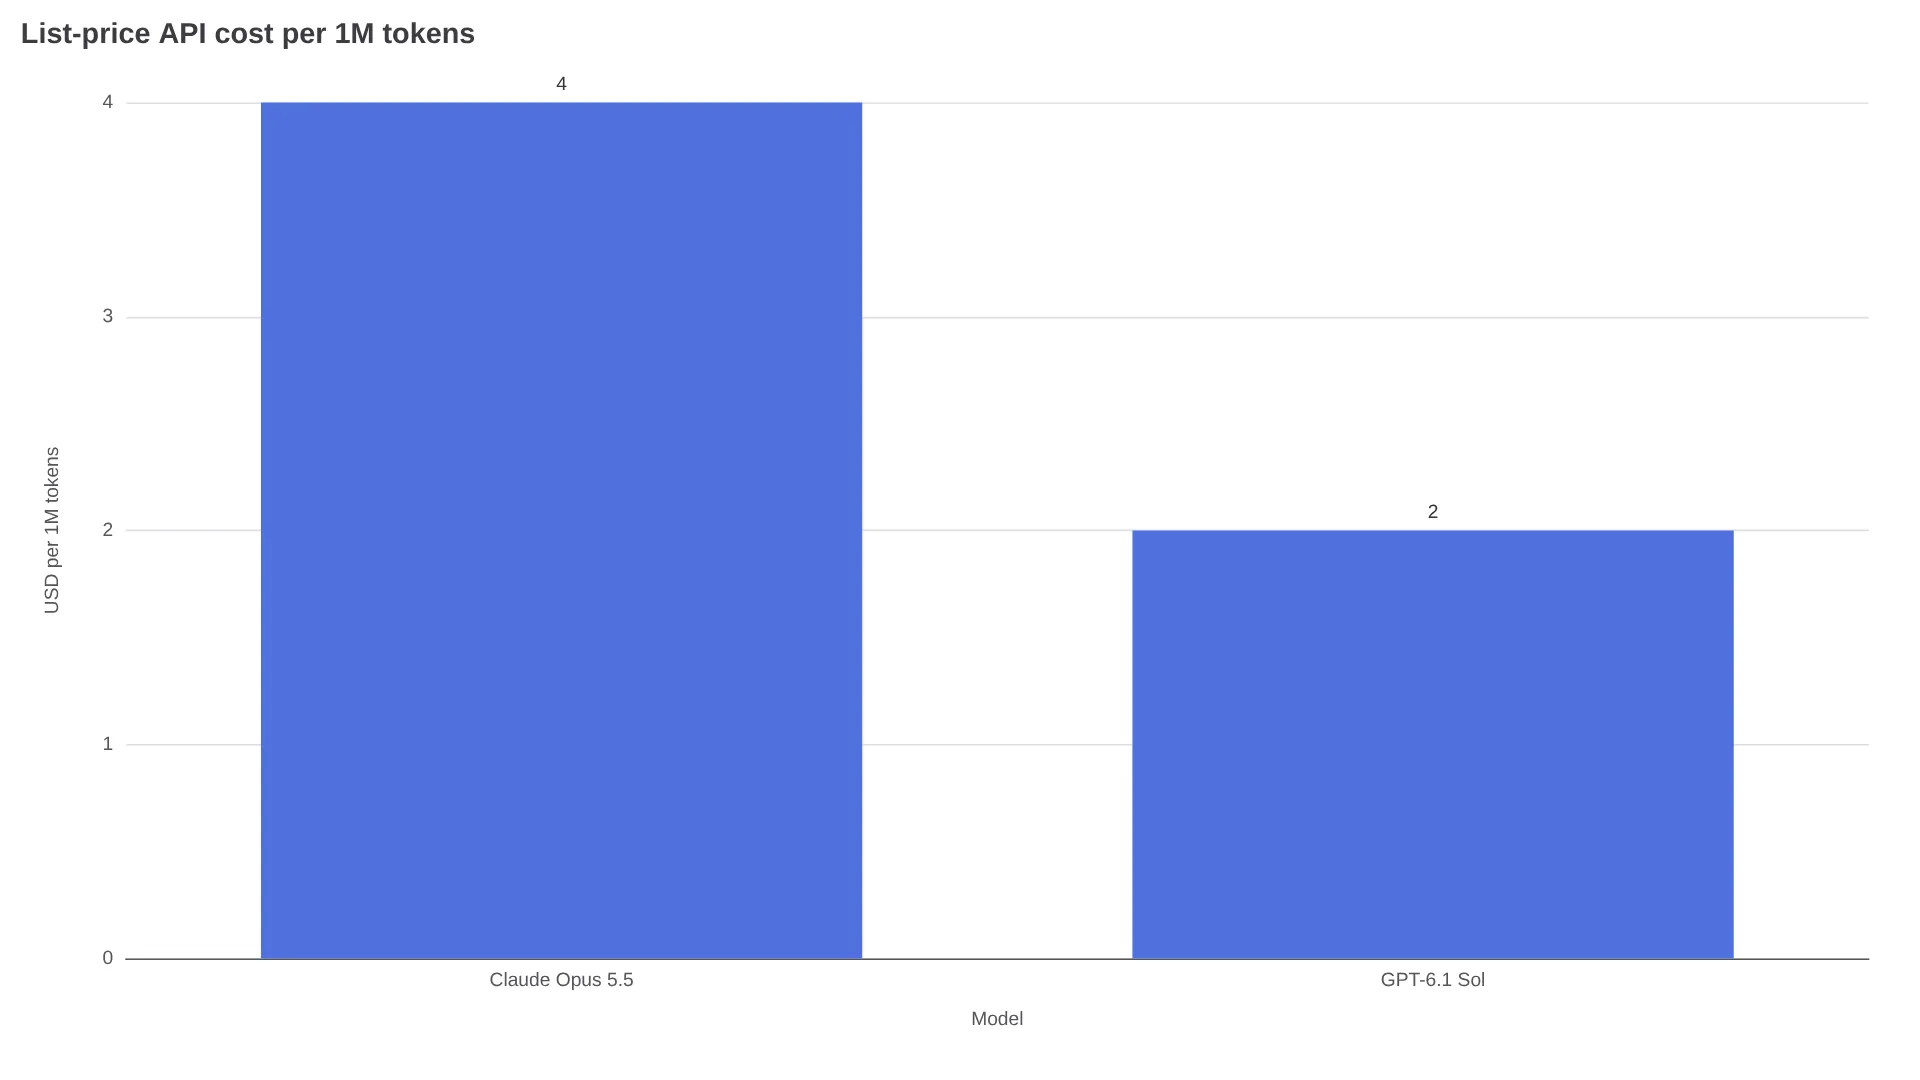
紙面上的規格差距其實不大:上下文容量為 1M 對 1.05M,兩者最大輸出都是 128K;每百萬輸入/輸出 token 的價格則是 $4/$20 對 $2/$10。真正的使用體驗差距更明顯:Opus 5.5 在代理式程式碼測試中拿到較高成績(Terminal-Bench 4.0 為 66.4%、FrontierCode v1.1 為 54.4%、CursorBench 4.0 為 57.8%),Sol 則以約一半的牌價,以及 AutomationBench 三分之一任務成本下的已公開優勢回應。訂閱用戶還得注意另一個變數:Reddit 的額度測試顯示,Sol 消耗額度的速度可能比 API 價格所暗示的更快。
價格、上下文與呼叫方式
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| 供應商 | Anthropic | OpenAI |
| 推出日期 | 2026 年 9 月 22 日 | 2026 年 9 月 29 日 |
| API ID | 大多數 gateway 使用 claude-opus-5-5 系列 | gpt-6.1-sol |
| 每 1M token 的輸入/輸出價格 | $4.00 / $20.00 | $2.00 / $10.00 |
| 每 1M token 的快取輸入讀取價格 | $0.20 | $0.10 |
| 上下文視窗 | 1,000,000 tokens | 1,050,000 tokens |
| 最大輸出 | 128K tokens | 128K tokens |
| 高速方案 | Fast 模式 $8 / $40,速度最高可達 2.5 倍 | Codex 中 Ultrafast 最高可達 8 倍,約為牌價的 2 倍 |
| 可用平台 | Claude Code、API、Bedrock、Vertex、Foundry、OpenRouter | Codex、ChatGPT Work、API、Azure、Bedrock、OpenRouter |
| 不包含 | — | 上市時不支援一般消費者版 Chat |
兩者都只需要更換模型字串即可切換。透過 AIReiter 的單一控制台即可使用兩個模型,不用分別管理兩家供應商的 API key。
實際工作負載到底會花多少
單看牌價,Sol 便宜 50%;但實際成本還要看每次請求的大小與快取使用率。
OpenAI 對每次超過 272K 輸入 token 的請求收取附加費:整個請求的輸入與快取價格變成 2 倍,輸出價格則變成 1.5 倍。Anthropic 列出的完整 1M 上下文視窗仍維持相同價格,目前沒有公布按請求計算的附加費。快取讀取價格是 $0.20 對 $0.10,因此大量依賴快取的迴圈仍能保留 Sol 的部分價格優勢。
| 工作負載 | Opus 5.5 | GPT-6.1 Sol | 差距 |
|---|---|---|---|
| 均衡型助理:1M 輸入/250K 輸出,每次請求低於 272K | $9.00 | $4.50 | Sol 便宜 50% |
| 檢索,每次請求低於 272K:10M 輸入/1M 輸出 | $60 | $30 | Sol 便宜 50% |
| 檢索,每次請求都超過 272K:10M 輸入/1M 輸出 | $60 | 約 $55 | Sol 只便宜約 8% |
| 高快取迴圈:先寫入 100K prefix,接著執行 1,000 次(5K 新輸入 + 100K 快取讀取 + 1K 輸出) | 約 $60.50 | 約 $30.25 | Sol 便宜約 50% |
以上是以牌價計算的總額,尚未納入 tokenizer 差異。Sol 最適合短請求、高頻率的工作;面對一次塞入大量內容的檢索任務時,價格優勢最小。
訂閱方案的計算方式與 API 並不一致。一名使用者以固定 prompt,對 GPT-6.1 Sol、GPT-6 Sol 與 Opus 5.5 進行 128 次比較,結果顯示 Sol 系列消耗的訂閱額度高於 token 價格所推算的程度;後續留言更直接:
「我的 ChatGPT 剛好引用了這篇。總之,它們在使用量上可能差不多,但 Opus 在實際等待時間上快得多,我很後悔這個月換過去。」— u/ebrbrbr,r/ChatGPT 額度測試討論串
另一名 Codex 使用者也回報了類似的額度消耗:
「如果使用量合理,我不介意用 GPT 6.1 Sol;但老實說,雖然它更『有效率』,我的額度還是一直被用光。真的難以置信。」— u/Longjumping_Stop6269,r/codex
預算原則很簡單:如果你的請求中位數超過 272K,遷移前先把附加費算清楚。如果你使用的是 $20 或 $100 的席次方案,應追蹤每個合併 PR 消耗的額度比例,而不是只看每美元換到多少 token。
程式碼與代理:基準測試,加上兩個實作任務
以下第三方測試只能作為方向參考,因為測試框架與推理強度各不相同。資料來源:Anthropic、OpenAI、DataCamp 建置測試、OpenRouter 吞吐量、SpringPrompt 基準測試彙整。
| 基準測試 | Opus 5.5 | GPT-6.1 Sol | 備註 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 未公布 | Anthropic 測試,xhigh |
| FrontierCode v1.1 Main | 54.4% | 與 Fable 5.1 相同,未公布數字 | 報告來源不同 |
| CursorBench 4.0 | 57.8% | 未公布 | Anthropic 測試 |
| DeepSWE v1.1 | 未公布 | 與 Astra 相同,比 GPT-6 Sol 高 6.4 個百分點 | OpenAI 測試,最高推理強度 |
| AutomationBench(47 個工具) | 40.0% | 中等強度下比 Opus 高 2.2 個百分點,成本約為三分之一 | 獨立測試、無 fallback;依 Anthropic 對 Zapier 測試的說明 |
| OSWorld 2.0 partial | 81.8% | 離線資料集約 60.5% | 使用不同子集,供應商測試 |
| GDPval-AA v2.1 | 1,846 Elo | 在 GDP.pdf 上擊敗帶 fallback 的 Opus,成本低於一半 | OpenAI 提出的跨供應商說法 |
Opus 5.5 擁有較完整、已公開的代理式程式碼測試成績;Sol 最具代表性的已公開優勢,則是企業工作流程與文件分析,而且每項任務成本更低。Anthropic 表示,這些成績是在啟用正式環境防護措施的情況下取得。
兩項第三方任務測試則讓結果更立體:
- 單檔 Tetris 建置(DataCamp、OpenCode、相同 prompt、高推理強度、各一次嘗試)。兩個模型都通過了困難的重力翻轉邏輯。Sol 在機制、完整度與遊戲感受上得到 5.0 分,Opus 為 4.3;但 Opus 只用 3 個回合與 2 次工具呼叫便完成,Sol 則用了 6 個回合與 9 次呼叫。成本方面,Sol 為 $0.26,Opus 為 $0.87;Opus 消耗 22.5K 推理 token,Sol 則為 8.1K。
- 128 個 prompt 的額度測試(Reddit、固定 prompt、記錄額度與時間)。在相同工作負載下,Sol 消耗的訂閱額度高於 GPT-6 Sol;Opus 的實際完成時間則更短。
還有一項反覆出現的使用者回報:Opus 更懂得收手。
「對我來說,Opus 5.5 最大的優點甚至不是原始程式碼速度,而是它不會把簡單修正過度工程化。以前的模型,你只要求 3 行 patch,它們卻會重寫 4 個檔案;5.5 會尊重既有架構。」— u/food_fatherr,r/ClaudeAI
但也有極端的過度生成案例:一名開發者表示 Sol 為一個像素級精準的需求寫了 30,000 個測試,要求刪減後也只刪掉 25 個。
規格上的速度,和你實際感受到的速度
規格表在解碼速度上偏向 Opus:根據 SpringPrompt 引用的 Artificial Analysis 數據,約為每秒 96 對 53 tokens;在 OpenRouter 上的中位吞吐量則是 74 對 29。另一方面,SpringPrompt 的低推理強度測試顯示,Sol 的首 token 時間略快,為 1.71 秒對 6.89 秒。可是前述 Codex 使用者報告描述了相反的端到端等待體驗,包括簡單任務也要等上數分鐘,以及長文件工作耗時很久。
這兩組結果可以同時成立:每秒 token 數只測量首段輸出後的解碼速度;實際等待時間還包括推理、排隊與測試框架本身的額外耗時。
- Opus Fast 模式價格為 $8/$40(2 倍),速度最高可提升 2.5 倍;Sol Ultrafast則宣稱在 Codex 中最高可達 8 倍,價格約為牌價的 2 倍。
- 引用的 Codex 與 Work 報告關注的是延遲,而不是 API 解碼速度。一則耗時 40 分鐘的 PDF 任務在單一案例中只用了 5 小時時段的 6%,不能視為典型速度。
- 如果你的工作迴圈是互動式的(Cursor、Claude Code、Codex CLI),正式決定前,先讓兩個模型各自處理三張真實工單。
真正決定帳單的設定
預設值往往比模型名稱更重要:
- Opus 先從 Medium 或 High 開始。引用的使用者報告顯示,在一般 patch 上,Extra High 與 Max 會大量消耗額度,收益卻不大。
- 兩者的思考控制方式不同。Opus 的 thinking 無法關閉,也不接受強制工具使用;較新的帳戶在編輯過的上下文上還可能收到 400 錯誤(DataCamp API 筆記)。Sol 則可從
none調到max,而且能在對話中途調整推理強度,不會讓快取失效(DataCamp 推理控制說明),對有成本上限的迴圈更友善。 - 防護機制可能把任務轉送給其他模型。在 Cyber Verification Program 之外,多數 Opus 資安任務會轉送至 Opus 4.8;生物學工作則需要加入 Life Sciences 計畫(Anthropic)。處理這類任務時,應預期 fallback 會帶來品質與額度上的意外。
不同工作負載該選誰
| 如果你要做的是…… | 選…… | 理由 |
|---|---|---|
| 20 萬行程式碼遷移、多 repo 稽核、執行 9 小時的代理 | Opus 5.5 | 代理式測試分數較高、較少不必要的重寫,且 1M 上下文價格固定 |
| 每天 10K 張工單,每張低於 272K;使用小區塊 RAG | GPT-6.1 Sol | 牌價便宜一半,在 AutomationBench 與 GDP.pdf 的單位成本表現突出 |
| 每次請求都超過 272K 的大型單次檢索 | Opus 5.5,或把內容切塊後使用 Sol | Sol 的附加費會把領先幅度壓縮到約 8% |
| 以 PDF 為主的金融與法律問答 | 先測 Sol | OpenAI 宣稱在 GDP.pdf 上擊敗帶 fallback 的 Opus,任務成本低於一半;仍應用自己的文件驗證 |
| $20 席次方案的訂閱用戶、互動式 CLI | 兩個都測;引用的報告偏向 Opus | 使用者表示 Sol 消耗額度的速度比 token 計算更快,實際等待也更久 |
沒有放諸四海皆準的贏家。Sol 是效率派,Opus 則偏向穩健與自主完成。實務上可以讓 Opus 負責規劃與審查,再交給 Sol 承擔大量執行工作。
Opus 5.5 vs GPT-6.1 Sol 常見問題
透過 API 使用,哪個比較便宜?
牌價是 Sol($2/$10 對 $4/$20,快取則是 $0.10 對 $0.20)。但如果每次請求的輸入都超過 272K,差距會縮小到約 8%。
哪個更適合程式碼代理?
Opus 5.5 在已公開的 Terminal-Bench、FrontierCode 與 CursorBench 成績上領先;Sol 則在 DeepSWE 上追平 Astra,並以三分之一成本拿下 AutomationBench 優勢。
實際使用時哪個比較快?
解碼速度偏向 Opus(約 74–96 tok/s 對 29–53);首 token 時間則略偏向 Sol。2026 年 10 月的 Codex 報告整體上認為 Sol 較慢。
API 模型 ID 是什麼?
gpt-6.1-sol,以及大多數 gateway 使用的 claude-opus-5-5 slug。
GPT-6.1 Sol 能在一般 ChatGPT 使用嗎?
在 9 月 29 日推出時還不行:先提供給 Work、Codex 與 API。若存取權限很重要,請重新確認你的席次方案。
推理強度該怎麼設定?
Opus 5.5 建議先用 Medium 或 High,不要直接開 Max;Sol 則先用 medium,只有重試次數增加時才提高。兩者的推理 token 都會按照相同的每 token 計價方式計入成本(DataCamp 計費說明)。
有些取捨,不是靠 prompt 就能解決
Opus 5.5 會尊重既有 repo,但你得為它的思考付費;Sol 讓 token 變便宜,卻可能產生更多待審查、也需要更久等待的工作。如果一次悄無聲息的錯誤就可能把 bug 帶進正式環境,選 Opus;如果錯誤成本低、最重要的是處理量,就在 272K 以下的請求中把 Sol 的價格優勢用起來。