 AIREITER
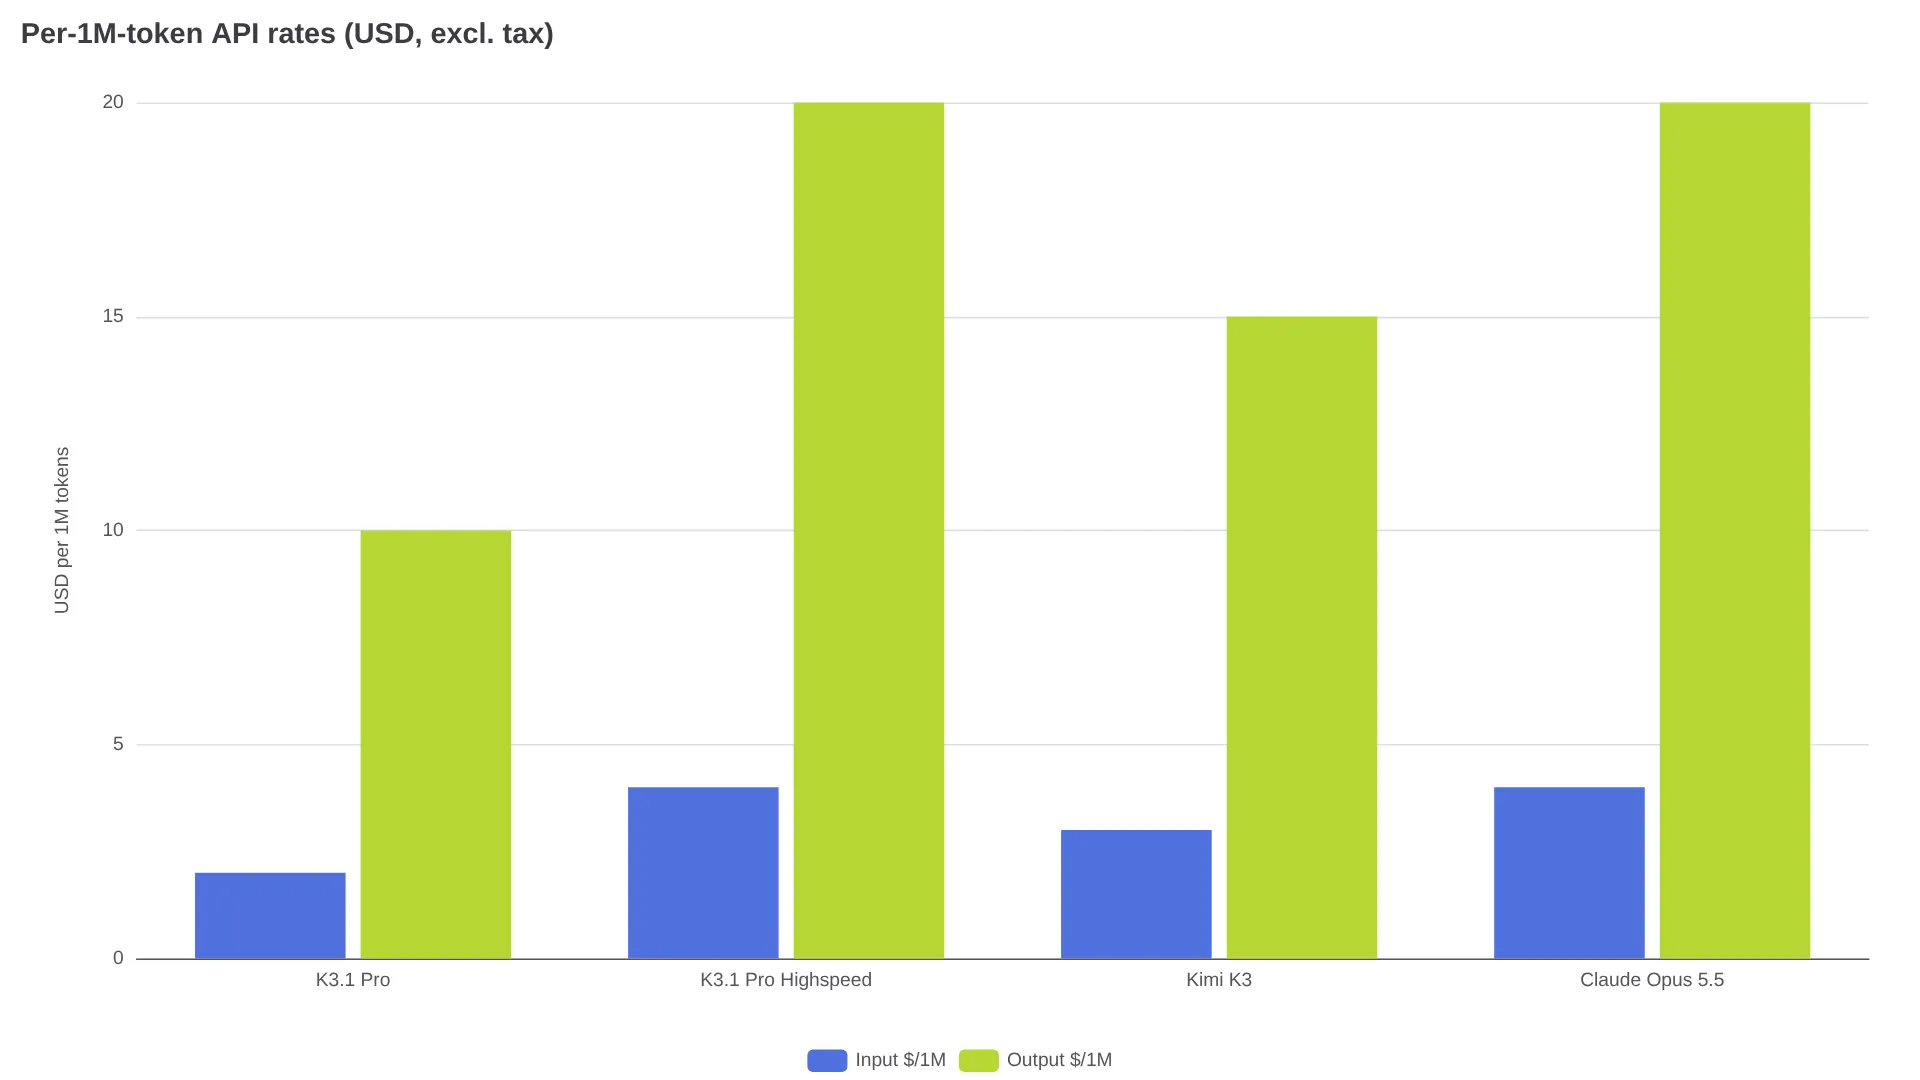
Kimi K3.1 Pro API 的價格,真正需要留意的不只是 $2/$10 這組標價,還包括推理 tokens 和快取命中如何計入帳單。標準版每 100 萬輸入 tokens 收費 $2、輸出 tokens 收費 $10;Highspeed 兩項價格都翻倍換取更快速度,而兩個方案的快取命中讀取費用都維持每 100 萬 $0.20(platform.kimi.ai)。
| 模型 | 輸入/100 萬 | 輸出/100 萬 | 快取命中讀取/100 萬 | 快取寫入 5 分鐘/100 萬 | 快取寫入 1 小時/100 萬 |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3(上一代) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
以上價格均為每 100 萬 tokens 的美元費率,未含稅;完整 100 萬 context 都採相同費率,不另收長 context 附加費。這是 Kimi 官方定價資料所列的標準(kimi.ai)。
10 萬 tokens 的請求表面只要 $0.30,實際帳單還要看這些項目
以一個沒有快取的請求為例:輸入 100,000 tokens、輸出 10,000 tokens,按照官方 $2/$10 費率計算,就是 $0.20 加 $0.10,合計 $0.30。實際使用時可套用以下公式;若使用 Highspeed,輸入、輸出和快取寫入費率都要加倍:
Total = (uncached_in x 2 + cached_read x 0.20 + write_5m x 2
  + write_1h x 4 + (visible_out + reasoning_out) x 10) / 1M
  + searches x 0.004
這個公式涵蓋 Kimi 官方列出的未快取輸入、快取命中、不同 TTL 的快取寫入,以及輸出費用(kimi.ai),另外再加上每次 Web Search 呼叫 $0.004 的費用。API 採逐次請求、隨用隨付(kimi.ai),因此重試一次,計費也會重新跑一遍。K3.1 Pro 永遠啟用推理,且推理 tokens 按輸出費率計算;也就是說,模型看不見的推理內容,同樣會消耗每 100 萬 $10 的輸出額度。若可見回答有 10,000 tokens,另有 40,000 個隱藏推理 tokens,計費輸出就是 50,000 tokens,也就是 $0.50。一名使用者回報 935 個輸入 tokens 加上 56,097 個輸出 tokens,帳單為 $0.5628,幾乎完全符合每 100 萬輸出 tokens $10 的費率(x.com)。
快取則是另一個很容易漏算的項目。首次建立快取前綴時會收取快取寫入費;在有效期間內重用未變更的前綴,讀取費則降為每 100 萬 $0.20。預設快取有效期為五分鐘,也可以在每次呼叫時選擇一小時(kimi.ai)。如果 context 開頭附近的前綴發生變更,後續內容可能全部無法重用(kimi.ai)。要確認快取是否真的命中,應查看每次請求的 usage breakdown,分辨 cached-read 與 uncached tokens;單靠文字相似,不能保證一定命中。
Kimi K3.1 Pro API 價格拆解:標準版和 Highspeed 差在哪裡
Highspeed 使用相同的模型能力與 1M context,官方宣稱速度約快 2–3 倍,但輸入、輸出及快取寫入費率都正好是標準版的兩倍(platform.kimi.ai);Moonshot 的發布文章也如此描述(kimi.ai)。
唯一沒有加倍的是快取命中讀取:兩個版本每 100 萬快取輸入 tokens 都收 $0.20。對於反覆重播長 system prompt 和工具定義的 agent 工作流程,這個差異很關鍵:兩個方案享有相同的重播折扣,但 Highspeed 的新 tokens 和推理成本都會變成兩倍。
估算費用時,先記住三件事:
- API 採隨用隨付,輸入和輸出分開計量,並且與 Kimi 會員及 Kimi Code 訂閱分開計算;會員餘額不能拿來支付 API 呼叫(kimi.ai)。
- API 相容 OpenAI 格式,模型 ID 為
kimi-k3.1-pro和kimi-k3.1-pro-highspeed,可透過https://api.moonshot.ai/v1存取;也能在 OpenRouter 和 Vercel AI Gateway 等閘道使用moonshotai/kimi-k3.1-pro路由。 - Web Search 為選用功能,每次呼叫另收 $0.004;上傳檔案本身不收費,但解析後的內容會按輸入 tokens 計費。API 需要至少充值 $1 才能啟用,並設有分級速率限制(kimi.ai)。
什麼時候值得付 Highspeed 的兩倍價格?
Highspeed 的價值只在等待時間比 tokens 更昂貴時才會顯現。互動式寫程式、即時助理,以及有人盯著載入圖示等待的產品展示,延遲本身就是產品體驗,此時 $4/$20 可能合理。相反地,批次工作、夜間 agent 任務和評測批次通常沒有人等結果,應留在標準版 $2/$10,享受約一半的標示費率。簡單說,只有當節省下來的等待時間價值高於額外 tokens 費用時,Highspeed 才值得;對輸入量較大的工作來說,這個額外費用大約等同再付一張標準版帳單。
降低推理強度,通常比直接換 Highspeed 更省。API 支援 reasoning_effort 設定為 low、high 和 max,預設是 max,Moonshot 公布的基準成績也是以這個設定為基礎(datacamp.com)。簡單任務可以從 max 降到 high,或從 high 降到 low,減少推理 tokens,而不必支付 Highspeed 溢價。不過同一個 session 最好維持固定等級,因為中途變更設定會讓 context cache 失效(datacamp.com)。
社群的實測回報也反映了這個取捨。一名日本使用者在比較相近的工作時,記錄到 Opus 5.5 用時 14:32,Kimi K3.1 Pro 用時 27:53,輸出品質則相當接近,因此認為 Kimi 適合只能等待的工作:
半額のはずが、待ち時間はほぼ倍だった。... Opus 5.5是14分32秒、Kimi K3.1 Pro是27分53秒。出来は正直かなり近い。僕なら、待てる作業だけKimiに回す。 — @rutinelabo (x.com)
Reddit 使用者也描述了類似差異:Highspeed 約 80 tok/s,標準版約 30 tok/s,但快的那一版非常昂貴:
And once again, the model has a high-speed version that costs an arm and a leg and runs at much more speed than eye can read (80t/s), while the normal version will be running at 30t/s if it feels like it. — u/Kiverty (reddit.com)
實用建議是:預設使用標準版 K3.1 Pro,先調低 reasoning_effort,只有在人真的正在等待結果的 session,才考慮付費升級 Highspeed。
11 月 4 日之後自託管:3T 級模型的現實考量
Moonshot 表示,完整的 Kimi K3.1 Pro 模型權重將在 2026 年 11 月 4 日前發布,並將模型描述為 3T 級、支援 1M-token context window(kimi.com)。截至 11 月 2 日,Moonshot 的 Hugging Face 組織頁面 huggingface.co/moonshotai 尚未出現官方 K3.1 Pro repository,目前仍列出 Kimi K3 和更早期模型,搜尋結果也只有非官方 fork。最終授權、檔案格式與量化選項同樣尚未確認;第三方追蹤網站也將這些項目標記為未知,等待官方發布(ctrlaltorion.com)。
自託管很難在這裡打敗 API,關鍵就在模型規模。K3.1 Pro 是 Kimi K3 的後訓練後繼模型,而 Kimi K3 本身是 2.8T 參數的 mixture-of-experts 模型;3T 級的說法也指向相同規模(datacamp.com)。MoE 的總參數量不等於每個 token 實際啟用的參數量,因此在現有資訊下,還無法可靠算出單工作站所需的 VRAM。
與其猜 GPU 價格,不如先用符號公式計算損益平衡點:
API_month = monthly_tokens_1M x blended_$/1M (from formula above)
Self-host wins when cluster_monthly_cost < API_month at sustained utilization
以每 100 萬輸入 tokens $2、每 100 萬輸出 tokens $10 計算,10 億輸入 tokens 加上 1 億輸出 tokens,API 計量費用是 $2,000 加 $1,000,約 $3,000。已經擁有合適叢集、需要長時間高流量推理,或必須讓資料留在本地環境的團隊,才可能從自託管中獲益。沒有現成叢集和穩定使用量的團隊,通常會是按量計費的 API 更划算;在官方 checkpoint 和授權出現前,不要急著規劃自託管。
使用者最常踩到的兩個計費陷阱
第一個陷阱是把推理當成不計費的背景工作,但它其實按輸出計價,前面的公式已經反映這一點。可以用 max_completion_tokens 為工作設定上限,先用 low 進行探測,失敗時才升級到 high,把 max 留給最後真正困難的執行。
第二個陷阱是訂閱額度消耗速度,與 API 按量計費的可預測性之間的差異。多名付費使用者表示,在高負載寫程式工作中,5 小時額度可能幾分鐘就用完;其中一名高階方案使用者更稱每月額度在六小時內耗盡(reddit.com)。Moonshot 在 10 月 25 日承認了速率限制和額度不必要消耗的問題,除了道歉,也一次性補回 25% 額度,同時減少重複的 subagent 呼叫和輸出長度(x.com)。對重度推理與寫程式工作來說,每 10 萬輸入/1 萬輸出 tokens 約 $0.30 的 API 計費,會比可能在單一任務中迅速耗盡的訂閱額度更容易預估。
Kimi K3.1 Pro API 價格 FAQ
Kimi K3.1 Pro API 每 100 萬 tokens 要多少錢?
標準版每 100 萬 tokens 的輸入費為 $2.00、輸出費為 $10.00、快取輸入讀取為 $0.20、5 分鐘快取寫入為 $2.00、1 小時快取寫入為 $4.00,以上均未含稅(kimi.ai)。
K3.1 Pro 和 Highspeed 有什麼差別?
Highspeed 使用相同的模型能力和 1M context,速度約快 2–3 倍;每 100 萬 tokens 的輸入費為 $4.00、輸出費為 $20.00,快取寫入費也翻倍,但快取命中讀取仍維持 $0.20(platform.kimi.ai)。
API 的模型 ID 是什麼?
在 Moonshot 的 OpenAI 相容端點上,標準版使用 kimi-k3.1-pro,高速版使用 kimi-k3.1-pro-highspeed;各類閘道則列為 moonshotai/kimi-k3.1-pro(openrouter.ai)。
API 使用量包含在 Kimi 會員方案內嗎?
不包含。API 計費與 Kimi 會員及 Kimi Code 方案分開,使用不同的金鑰和餘額,因此會員點數不能支付 API 呼叫(kimi.ai)。
可以關閉推理來降低成本嗎?
不行。K3.1 Pro 永遠會進行推理;成本控制要靠 reasoning_effort(low、high、max,預設為 max)和 max_completion_tokens,而不是關閉思考功能(datacamp.com)。
開放權重何時發布?現在應該等嗎?
Moonshot 目標是在 2026 年 11 月 4 日前發布,但截至 11 月 2 日,官方 Hugging Face repository 和最終授權都尚未公開。現階段先使用 API;等官方 checkpoint 和授權出現後,再重新評估自託管。
延伸閱讀:完整基準測試可參考 Kimi K3.1 Pro API:價格、基準測試與 Highspeed 指南;上一代費率請看 Kimi K3 定價;若想用一組金鑰呼叫 Kimi 模型,則可查看 Kimi K3 API 頁面。