 AIREITER
如果你的 API 工作是短小、重複且可驗證的任務,Claude Haiku 5.5 通常已經夠用;但一進入除錯、多步驟程式開發或長時間 agent 迴圈,Sonnet 5.5 的溢價仍有其價值。關鍵在於 100,000 token:在這條線以下,Haiku 5.5 只要 Sonnet 5.5 的二十分之一;一旦跨過,價差會縮至 4 倍,而且 agent 累積上下文的速度,往往比團隊預期更快。
100K token 前有 20 倍價差,跨線後局面就變了
Claude Haiku 5.5 與 Claude Sonnet 5.5 的規格上限相同,但帳單完全不是同一回事。兩者都提供 1M token 上下文視窗與 128K token 最大輸出,模型 ID 分別為 claude-haiku-5-5 和 claude-sonnet-5-5。根據 Anthropic 的 Haiku 5.5 公告與 Sonnet 5.5 公告,Sonnet 5.5 於 2026 年 9 月 28 日推出,Haiku 5.5 則在 2026 年 10 月 7 日推出。Claude 平台的 Sonnet 5.5 文件也列出相同的 1M 上下文與 128K 輸出上限。
| 規格 | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| 模型 ID | claude-haiku-5-5 | claude-sonnet-5-5 |
| 推出日期 | 2026 年 10 月 7 日 | 2026 年 9 月 28 日 |
| 上下文/最大輸出 | 1M/128K | 1M/128K |
| 100K 以下的輸入/輸出 | 每 1M 為 $0.10/$0.50 | 每 1M 為 $2/$10 |
| 提示詞超過 100K 的輸入/輸出 | 每 1M 為 $0.50/$2.50 | 每 1M 為 $2/$10(無分級) |
| 快取讀取 | 每 1M 為 $0.01 | 每 1M 為 $0.10 |
| 預設 effort | medium | high |
以上為 Anthropic 定價表中的牌價。根據 APIKO 對 Anthropic 定價的整理,只要 prompt token 超過 100,000,Haiku 5.5 會將較高級距套用至整個請求,包含快取讀取與寫入。
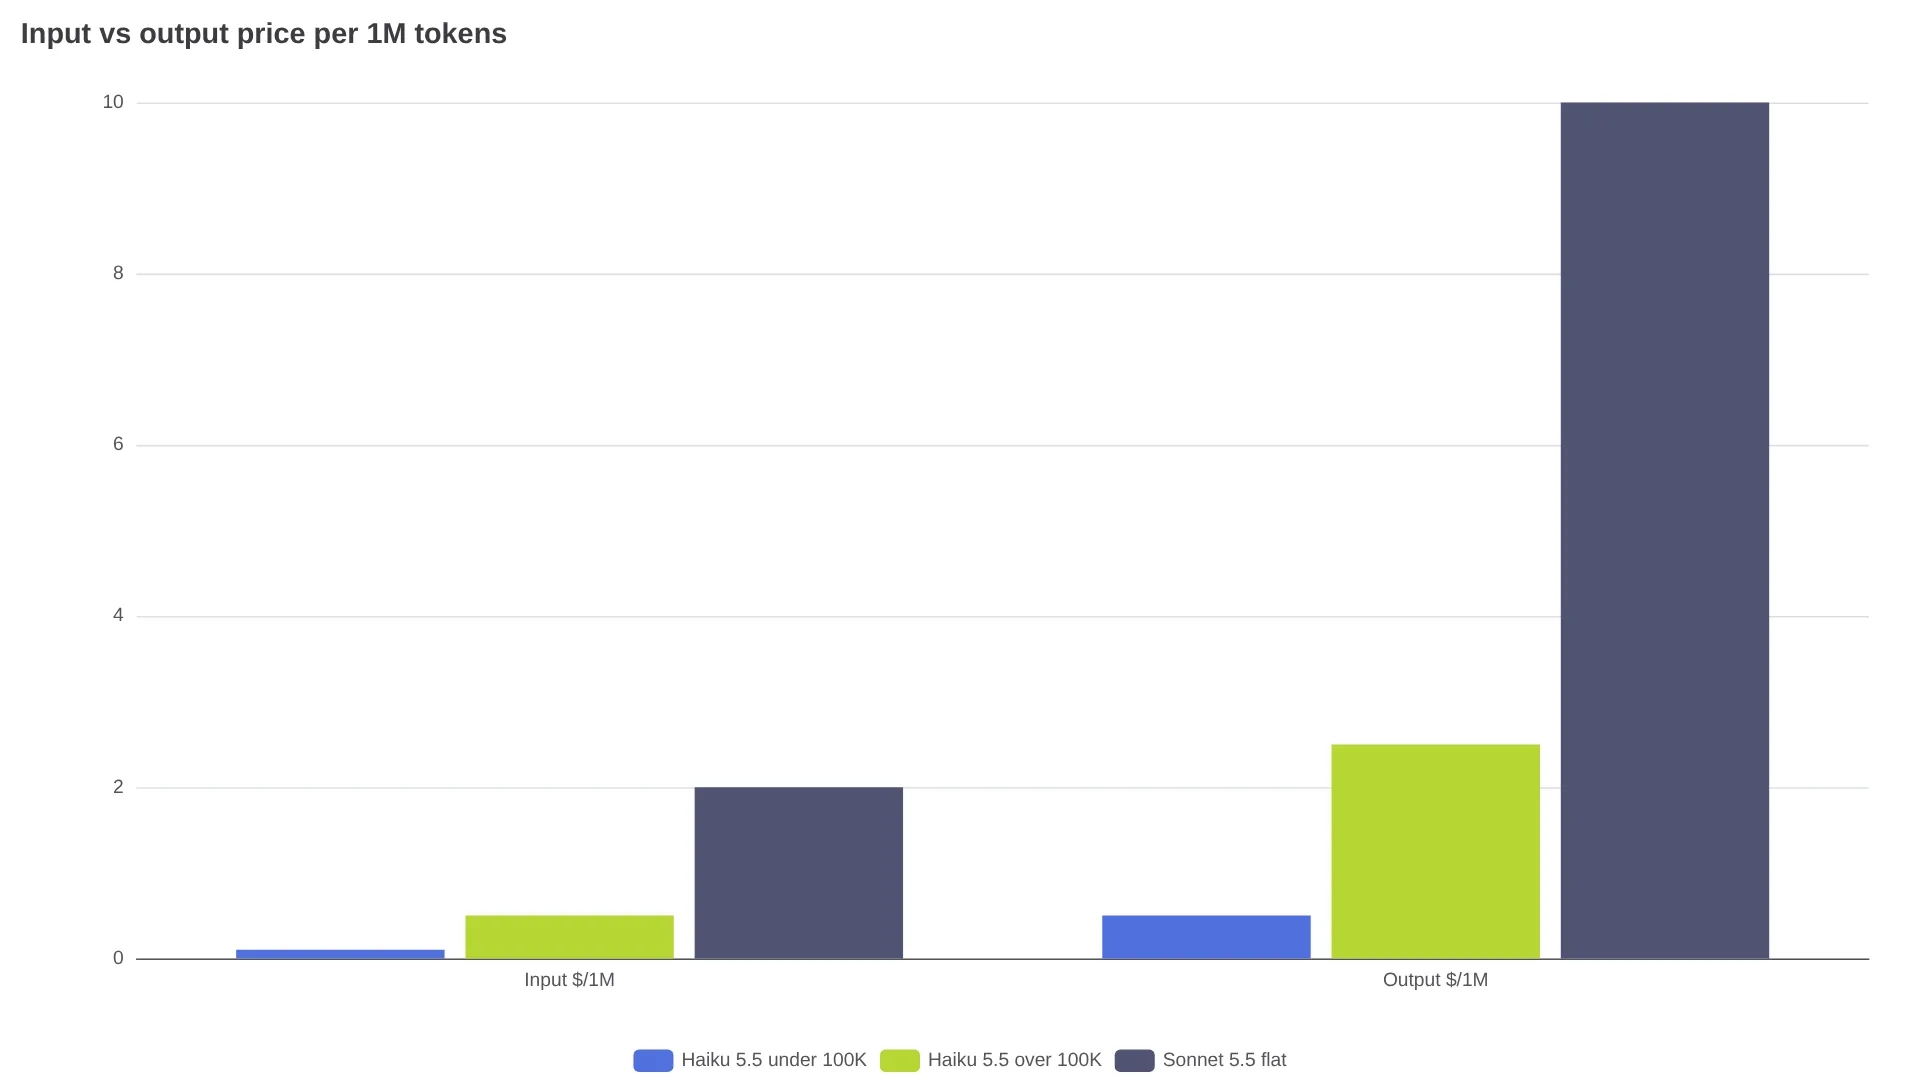
以 1,000 份完全相同的文件計算,每份為 99K token 輸入、1K token 輸出,按牌價批次成本約為 $10.40;APIKO 以其費率計算,同批工作為 $4.54。若每份文件變成 101K token,按牌價處理 1,000 份的成本約升至 $53.00,只因每份多了 2,000 token,成本就增加為約 5 倍;相同的 101K 批次若使用 Sonnet 5.5,約為 $212.00。這些數字是依據 APIKO 的 Haiku 5.5 與 Sonnet 5.5 測試所列牌價直接計算。另一個情境是 1,000 次呼叫、每次 10K 輸入加 1K 輸出:Sonnet 5.5 總成本為 $30.00,Haiku 5.5 則是 $1.50,減少 95%,出自 Sim 的 Sonnet 5.5 與 Haiku 5.5 定價比較。
真實 agent 迴圈很容易在不知不覺中跨過門檻。在一則討論 Haiku 5.5 token 用量的 r/ClaudeAI 討論串中,有使用者發現執行約到第 20 次模型呼叫時就超過 100K;接下來的 164 次呼叫中,有 145 次被套用較高級距,因為歷史訊息與工具輸出會不斷堆積。該討論串提出的做法包括:將工作單切小、限縮檔案範圍、減少測試輸出,以及改用新的子 agent,而不是維持一段無限增長的對話。短任務交給 Haiku 依然便宜;長上下文管線則應將 Sonnet 納入預算。
「Haiku 5.5 的低價只在上下文低於 100K 時成立。輸入超過 100K 後,價格會跳升 5 倍;翻譯、摘要等小型工作能省錢,長上下文工作則應使用 Sonnet。」— @zookmas1314
若想深入了解各模型,可搭配閱讀 Claude Haiku 5.5 API 定價與 Claude Sonnet 5.5 API 評測與定價。
基準測試真正拉開 Haiku 5.5 與 Sonnet 5.5 差距的地方
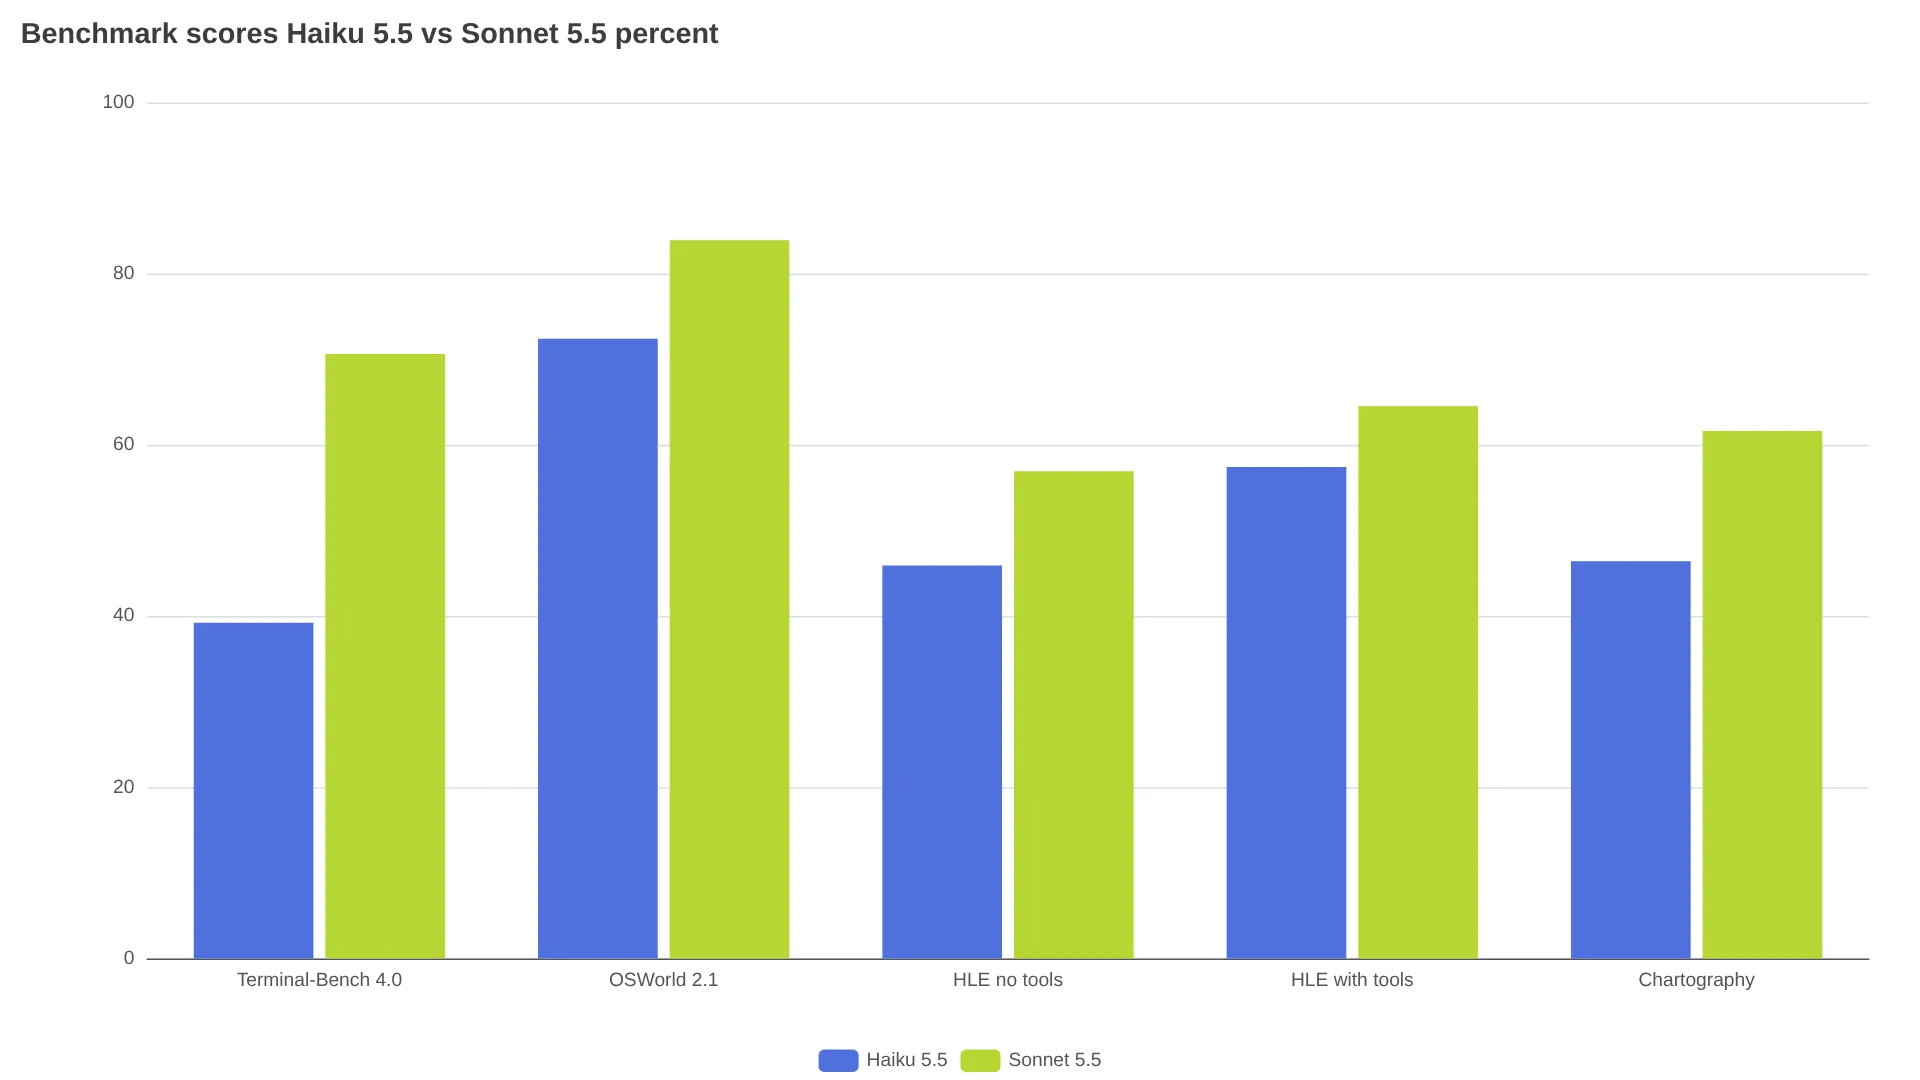
Anthropic 公開的正面對比中,Sonnet 5.5 全數領先;差距最大的場景,是 agent 要撰寫並執行程式碼的任務。代理式程式開發測試 Terminal-Bench 4.0,Haiku 5.5 為 39.2%,Sonnet 5.5 則為 70.6%。電腦操作測試 OSWorld 2.1 的差距較小,分別是 72.4% 與 83.9%。在不使用工具的 Humanity's Last Exam 中,成績為 45.9% 與 56.9%;使用工具後則是 57.4% 與 64.5%。數據來自 APIKO 彙整的比較表。
effort 設定會縮小或拉大這些差距。同一份比較引用的 Artificial Analysis 結果顯示,Haiku xhigh 與 Sonnet medium 在 Intelligence Index 都得到 41 分,Terminal-Bench 分數也幾乎相同,分別為 29.3% 與 29.8%。不過,Haiku xhigh 每項任務成本是 $0.12,Sonnet medium 是 $0.48;前者耗時 295 秒,後者則是 122 秒。在該資料集裡,沒有任何 Haiku 設定能達到 Sonnet 預設 high 的 47 分。這些成本數字未納入 Haiku 超過 100K 的級距,因此長上下文工作應把它們視為成本下限。
狹義的擷取與分類工作,不需要 Sonnet 在程式能力上的優勢;主導 agent 的程式開發、長工具迴圈與視覺推理則需要,後者在 Chartography 的成績為 46.4% 對 61.6%。不要把單一 Elo 或指數分數當成通用的品質排名。一項 Reddit 測試指出,面對混合 Rust 與舊有程式碼庫時,Haiku-medium 能以 $0.08 達到 Sonnet 的效果,而 Sonnet 成本為 $1.68;同一工作流中,Haiku-high 發出 385 次請求卻沒有帶來品質提升,詳見 r/ClaudeCode 的受控 Haiku 5.5 程式測試。
別只看模型名稱:Haiku low 與 Sonnet low 的差異
不少「Haiku 很冗長」的抱怨,其實源於預設 effort 設定。Haiku 5.5 預設為 medium,Sonnet 5.5 則是 high,兩個模型的 thinking 設定方式也不同。Haiku 可透過 {"type": "disabled"} 關閉 thinking;Sonnet 在 high effort 及以下使用 {"type": "between_tools"},在 xhigh/max 時則使用 adaptive,或省略 thinking 設定。相關細節記載於 Claude 平台文件與 APIKO 的行為說明。
APIKO 在 2026 年 10 月 10 日進行了一項透過 Messages endpoint 的評估,涵蓋 22 項任務、528 次請求。Haiku 設為 low 時,66 次執行中通過 65 次;Sonnet 視設定不同,通過 64 至 66 次。這些短任務中,Haiku 的 gateway 成本約是 Sonnet 的十八分之一。若完全關閉 thinking,Haiku 成績降至 66 次中通過 56 次,失敗多集中於推理與嚴格格式要求,例如 CSV 加總與程式碼追蹤。Haiku 預設的 medium 則通過全部 66 次,但輸出 token 是 Haiku low 的 4.4 倍,主要增加的是 thinking token。
根據上述資料與使用者回報,可整理出幾項實務規則:
- 先從 Haiku low 開始:分類、路由、擷取、短 JSON 等邊界明確的任務,優先用 Haiku
low,而非預設的 Haikumedium。 - 先提高 Haiku effort,再換 Sonnet:如果目標是在保有 Haiku 價格級距下提升品質,應先嘗試 Haiku
high或xhigh,再考慮 Sonnetlow。依 APIKO 的比較引用之 Artificial Analysis 數據,Haikumax得分 43,Sonnetlow為 36,成本約為其 60%。 - Sonnet 留給高風險長流程:除錯、多步驟實作及長工具序列,才值得使用 Sonnet
medium以上;在這些場景,Haiku-high 額外帶來的延遲未必能換得品質提升。 - 共用程式碼中要明確區分 thinking 設定:同一套模板若把
between_tools傳給 Haiku,或把disabled傳給 Sonnet,會回傳上游 400 錯誤,出自 APIKO 的 gateway 測試。
「讓 Opus/Sonnet 擔任主要協調者與審查者,Haiku 做執行工作;每個功能都使用新的 Haiku 實例。」— r/ClaudeAI 的 u/ohrajaaa
模型路由該看漏錯代價,而不是工作難度
真正該問的不是「這項工作難不難」,而是「如果 Haiku 看似合理地做錯了,又沒有人發現,會造成什麼後果?」多項引用的使用者測試都指出同一個分界:Haiku 在需要判斷的工作上可能會悄悄失誤;當驗證成本很高時,Sonnet 的價值才會真正浮現。
| 任務類型 | 主力模型 |
|---|---|
| 情緒分類、工單路由、許可文件轉 JSON、日誌摘要、OCR 與標註、SQL 選取、壓縮子 agent | Haiku 5.5 |
| 程式碼庫搜尋、單一檔案修改、單輪文件處理 | Haiku 5.5 |
| 主導程式 agent、實際除錯、多步驟重構、事實查核、文件歸因 | Sonnet 5.5 |
使用者回報指出,Haiku 特別適合單輪、高量的工作模式,速度可達 3 倍且能大幅降低用量;其中一個案例以幾美元處理了數 MB 文件,詳見 r/ClaudeAI 的「What is Haiku 5.5 best suited for?」討論。
一項比較六種子 agent 任務的測試發現,Haiku 雖然便宜,但在研究與事實判斷上明顯較不可靠,會漏掉檔案,卻產生「看起來結果很乾淨」的輸出,出自 r/ClaudeCode 的 Haiku、Sonnet、Opus 子 agent 測試。該討論串給出的防線很直接:
「只要輸出會觸發一項行動……就應該交給更大的模型,或由更大的模型檢查。」— r/ClaudeCode 的 u/vladgladi
還有一項生產環境注意事項:Haiku 的結構化輸出遵循度不是零成本取得。APIKO 的評估記錄到 low 下的一次嚴格格式失敗:標籤本身正確,卻被包在 JSON 物件中,而非要求的純陣列。r/ClaudeCode 使用者也回報,在低 effort 下會跳過驗證或忽略約束,詳見同一項受控程式測試。
能撐過正式上線的 Haiku-first 架構
根據 APIKO 在 10 月 10 日對文件化模式進行的 gateway 測試,整合程式碼必須處理模型專屬的 thinking、工具選擇與對話歷史。Haiku 可接受強制指定的 tool_choice,Sonnet 則會在上游拒絕此設定,應改用 auto 或結構化輸出。Haiku 無法讀取 Sonnet 的 thinking blocks;若歷史保持只追加,Sonnet 可以讀取 Haiku 的。重播經過修改的 Sonnet blocks 則可能回傳 400。
使用者反覆採用、且逐漸形成共識的 Haiku-first 模式如下:
- 第一輪交給 Haiku:以 Haiku 5.5 的
loweffort 執行分類、擷取與草稿;若要完全關閉 thinking,使用thinking: {"type": "disabled"}。 - 以規則驗收並升級:只接受 allow-list 中的標籤或通過 schema 驗證的 JSON;任何不確定、無效或後果重大的結果,升級至 Sonnet 5.5 的
medium。 - 讓子 agent 保持短命:每個檔案或功能使用一個新的 Haiku 實例,避免單一對話一路膨脹並跨過 100K。
- 會造成實際變更就加入審查:只要輸出會觸發行動、發送訊息或修改正式環境程式碼,就由 Sonnet 或 Opus 審查。
「只要你知道該做什麼,也知道怎麼審查品質,Haiku 就非常好用。」— r/ClaudeCode 的 u/Awric
根據 @ClaudeDevs,Anthropic 將 Haiku 5.5 定位為高量任務的子 agent,例如搭配 Sonnet 或 Opus 處理摘要。另一套分享中的架構,則讓 Haiku swarm 負責 repo 搜尋,Sonnet 保管 diff 與測試,見 @mirku21。
Haiku 5.5 與 Sonnet 5.5 常見問題
Haiku 5.5 比 Sonnet 5.5 便宜多少?
按牌價計算,prompt token 未滿 100K 時便宜 20 倍,每 1M token 的輸入/輸出分別是 $0.10/$0.50 對 $2/$10;超過 100K 後為 4 倍,分別是 $0.50/$2.50 對 $2/$10。快取讀取則是每 1M $0.01 對 $0.10。
Haiku 5.5 與 Sonnet 5.5 的上下文視窗相同嗎?
相同。依 Anthropic 與平台文件,兩者都是 1M token 上下文視窗,以及 128K token 最大輸出。
Haiku 5.5 適合正式環境 API 使用嗎?
適合,前提是任務範圍明確、量大且結果可檢查;通常建議使用 low effort,並加上 schema 驗證。至於主導 agent 的程式開發與高度依賴判斷的研究工作,使用者回報其漏失率與誤判率高於 Sonnet 5.5。
哪個模型更適合程式 agent?
主導 agent 與除錯選 Sonnet 5.5,Terminal-Bench 為 70.6%,Haiku 5.5 則為 39.2%。Haiku 5.5 適合搜尋、執行輸入操作,以及單檔案子 agent 工作,但應由 Sonnet 或 Opus 審查。
如何避免超過 Haiku 的 100K 定價門檻?
在接近門檻前先拆分文件;將子 agent 限縮在目標檔案;壓低冗長的測試輸出;每項任務都建立新的子 agent。代理式歷史大約在 20 次呼叫後就可能跨過 100K。
可以在對話中途從 Sonnet 5.5 切換到 Haiku 5.5 嗎?
不太行。Haiku 無法讀取 Sonnet 的 thinking blocks,因此應留在 Sonnet,或重新在 Haiku 開始對話。若對話歷史保持只追加,從 Haiku 升級至 Sonnet 可以保留推理脈絡。
有一項取捨,再好的路由也避不開
| 你的工作負載 | 建議選擇 | 原因 |
|---|---|---|
| 數百筆分類、擷取、摘要、JSON 正規化 | Haiku 5.5 搭配 low | 完成驗證後,短任務的通過率接近 Sonnet,成本約為十八分之一 |
| 大型程式碼庫、長工具迴圈、必須正確的除錯 | Sonnet 5.5 | Terminal-Bench 領先 31 個百分點,且較少出現無聲失誤 |
| 剛好跨越 100K 的文件 | 兩者都要估價 | Haiku 的 5 倍級距會抹去大部分價差;跨線後 Sonnet 只貴 4 倍 |
| 任何悄悄出錯就會上線的工作 | Haiku 草稿加 Sonnet 審查 | 每個經驗證成功結果的成本,比名目 token 單價更重要 |
Haiku 5.5 贏在每次嘗試的價格;但一旦審查與重跑開始主導 token 成本,Sonnet 可能反而更便宜。路由器應圍繞這個差別設計,兩個模型都不必再靠賭運氣使用。